ComfyUI 中的 MOSS-Image 控制 LoRA:Canny、深度、姿态
MOSS-Image-SFT 的七个 ControlNet 风格编辑 LoRA,每种控制图对应一个,每个都配有现成的 ComfyUI 工作流、示例网格和单个 290 MB 权重文件。
thedeoxen 于 11 月 10 日发布了 MOSS-Image-SFT 的七个控制 LoRA:canny、depth、pose、normal、lineart、scribble 和 segmentation。每个都是单个约 290 MB、rank-64 的 LoRA,自带 ComfyUI 工作流和控制图到结果的示例网格,因此你可以直接挑选与手头控制图对应的那个来运行。
它们是编辑类 LoRA,而不是新的控制模型。控制图作为引用图像输入,由提示词决定这些形状最终变成什么。
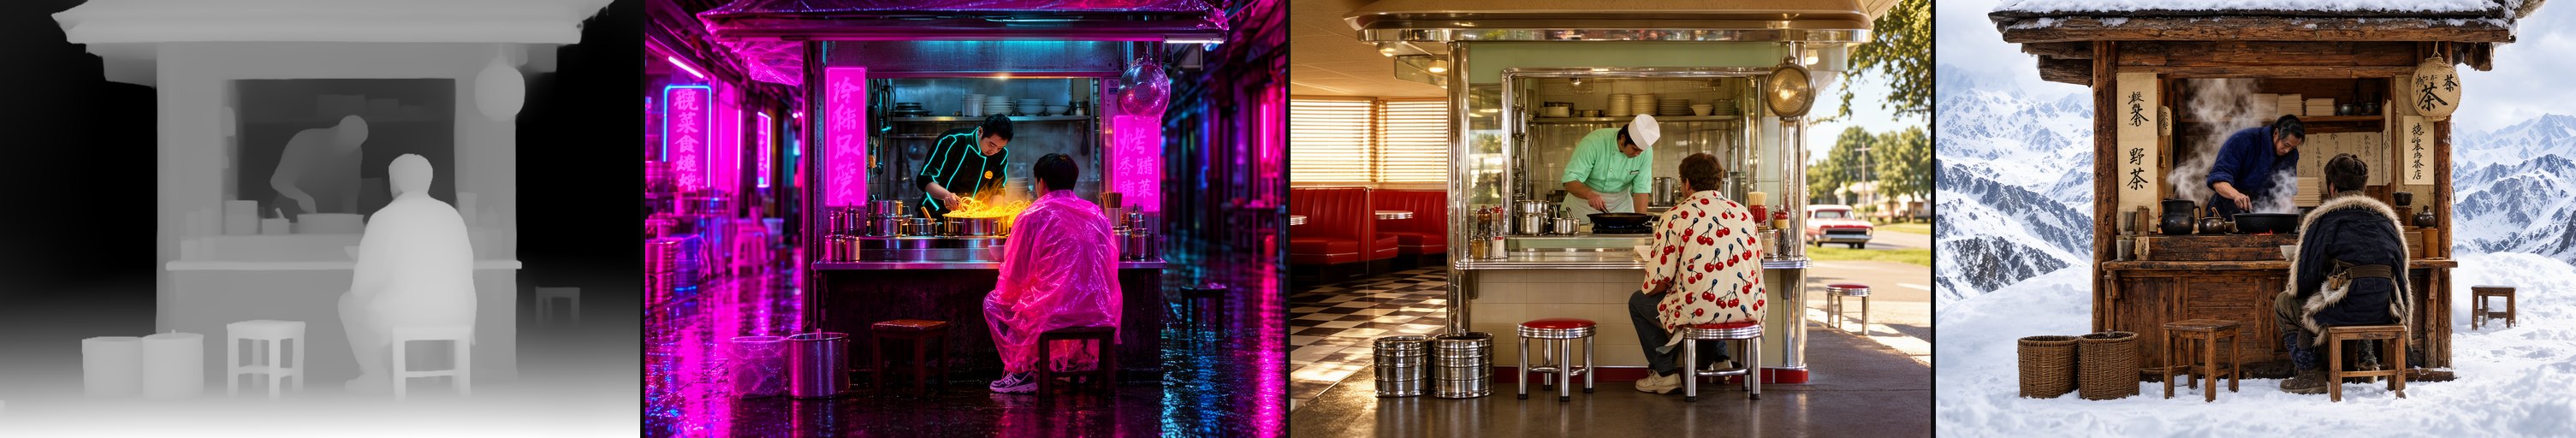
深度控制(最左侧)与不同提示词生成的结果
每个 LoRA 的输入
| LoRA | 输入的控制图 | 随附工作流中的预处理器 | 检查点 |
|---|---|---|---|
| Canny | 黑色背景上的细白边 | Canny | step 4500 |
| Depth | 灰度深度图,近处为白 | Depth Anything V2 (ViT-L) | step 5000 |
| Pose | DWPose 骨骼,黑色背景 | DWPose | step 4500 |
| Normal | 相机空间法线图 | BAE 法线图 | step 5000 |
| Lineart | 细白线条、粗线稿 | LineArt | step 5000 |
| Scribble | 随意的白色笔触 | HED | step 5000 |
| Segmentation | 纯色区域 | UniFormer 语义分割 | step 4500 |
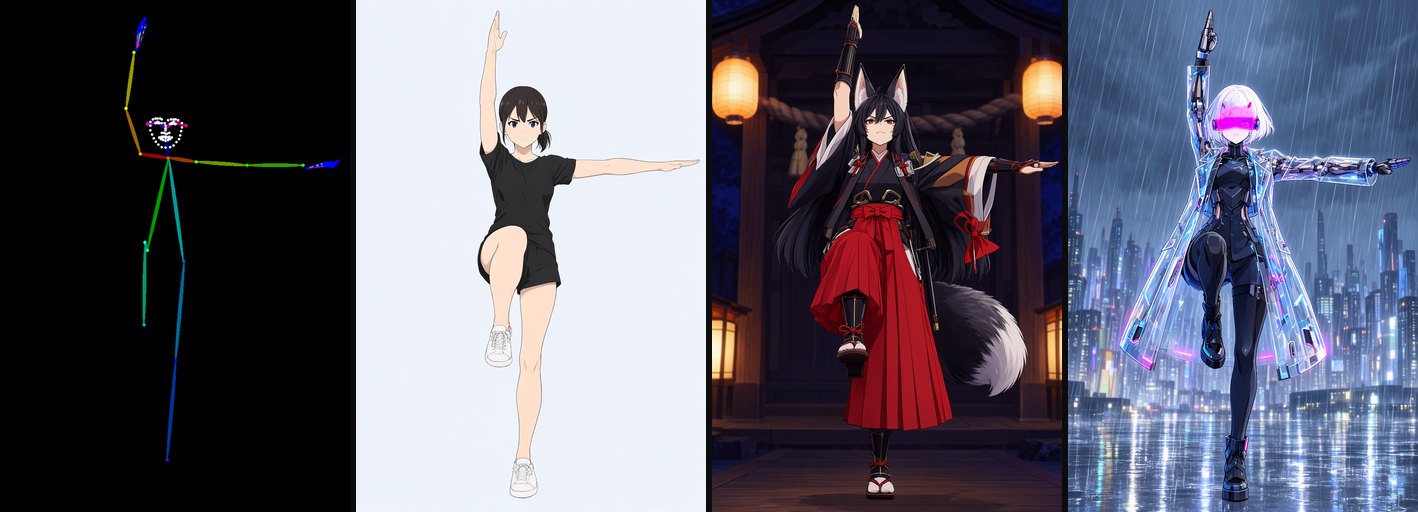 | 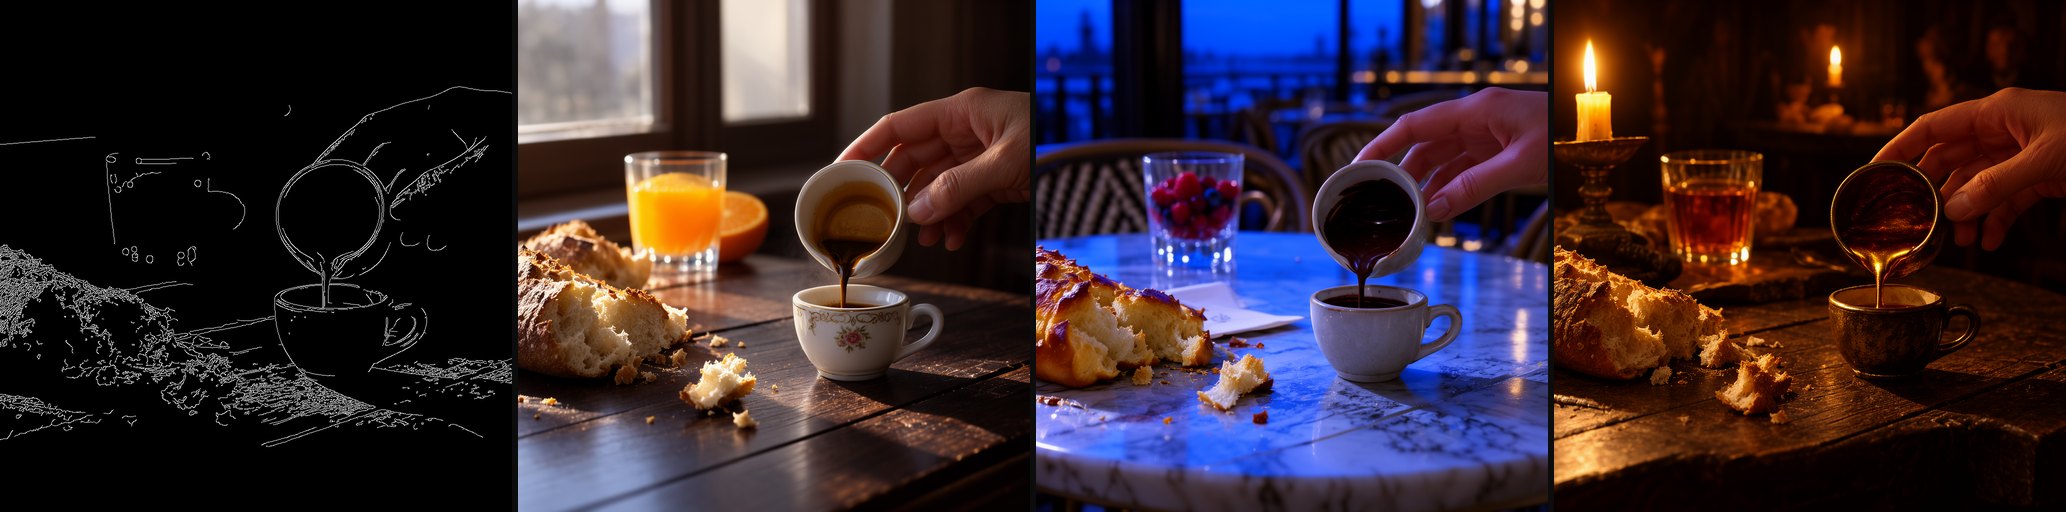 |
|---|---|
| DWPose 骨骼转为跃起的人物 | Canny 边转为新的材质与场景 |
如何运行
- 加载 MOSS-Image-SFT:U-Net
moss_image_sft_int8_convrot.safetensors,CLIP 使用qwen3.5_9b_w4a8_gptq.safetensors并把类型设为moss_image,VAE 使用flux2-vae_small.safetensors。 - 在 U-Net 上加装 LoRA,强度设为 1.0。如果控制过于僵硬,可降到 0.7 左右。
- 将控制图作为唯一的引用图像输入 文本编码 MOSS-Image 编辑 节点,并在正向和负面编码上都把
edit_format设为ai-toolkit。这些 LoRA 是在开启 kv 缓存的情况下训练的。 - 采样使用 30 步、CFG 4、
euler和simple。
工作流中的预处理器(Canny、Depth Anything V2、DWPose、BAE、LineArt、HED、UniFormer)来自 ControlNet Auxiliary Preprocessors 插件包,而非 ComfyUI 核心。如果你已经有控制图,可跳过预处理器,直接把图像接到编码节点。
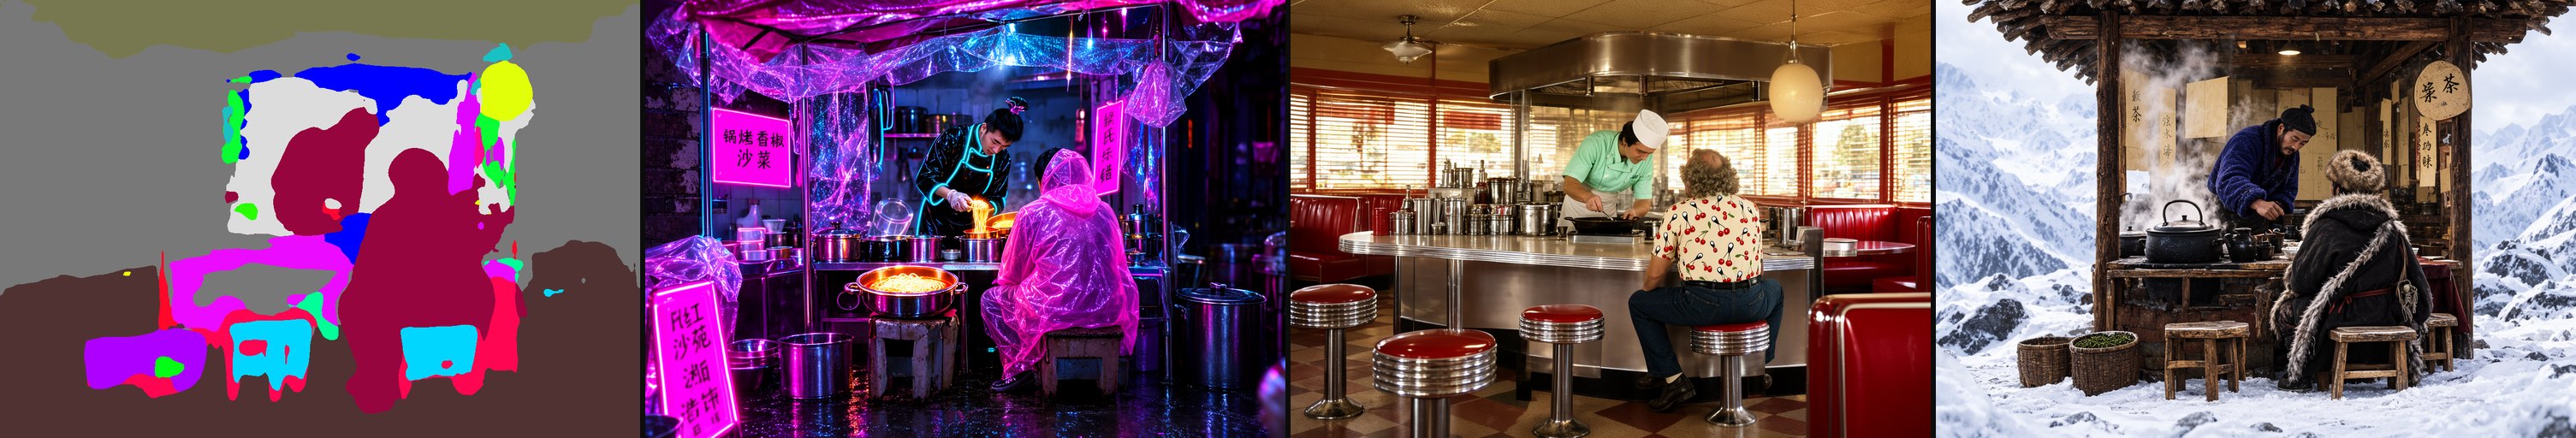
来自 UniFormer 的纯色区域,按提示词重新风格化
与官方适配器的差异
官方的 MOSS-Image 颜色/深度控制适配器 从噪波开始,把区域图和深度图作为条件输入。而这些 LoRA 则把控制图当作引用图像,因此它们适用于全部七种控制图类型,也正因如此,所有外观都由提示词决定。代价是强控制可能约束得过紧:当构图看起来被冻结时,模型卡建议把强度调到 0.7。
下载
| 控制类型 | 权重与工作流 |
|---|---|
| Canny | MOSS-Image-canny-controlnet |
| Depth | MOSS-Image-depth-controlnet |
| Pose | MOSS-Image-pose-controlnet |
| Normal | MOSS-Image-normal-controlnet |
| Lineart | MOSS-Image-lineart-controlnet |
| Scribble | MOSS-Image-scribble-controlnet |
| Segmentation | MOSS-Image-segmentation-controlnet |
基础模型:OpenMOSS-Team/MOSS-Image-SFT。每个仓库都自带 moss_image_<type>_control.json,只要三个基础文件已就位,就可以直接把它拖进 ComfyUI。
评论
使用 GitHub 登录后即可参与讨论。