ComfyUI 中的 WeVisOne-VL:一次提示词得到边界框、遮罩与透明度蒙版
腾讯的 WeVisOne-VL 现已在 ComfyUI 核心中运行。一个 Detect 节点即可将文本查询转换为边界框、遮罩、透明度蒙版、点、计数和 OCR 框。
WeVisOne-VL 是腾讯微信视觉团队的视觉模型,现已在 ComfyUI 核心中运行。该支持于 2026-11-09 通过 PR 17632 合入。你给它一张图像和一段短语,它返回边界框、遮罩、透明度蒙版、点、计数或 OCR 框。无需 SAM,无需自定义节点,也无需单独的分割后端。
2B 和 4B checkpoint 是在 Qwen3-VL 基础上微调的模型,附带一个 9.6M 参数的遮罩解码器。节点读取短语,将坐标写成普通 token,解码器再把匹配的 token 转换为像素级输出。
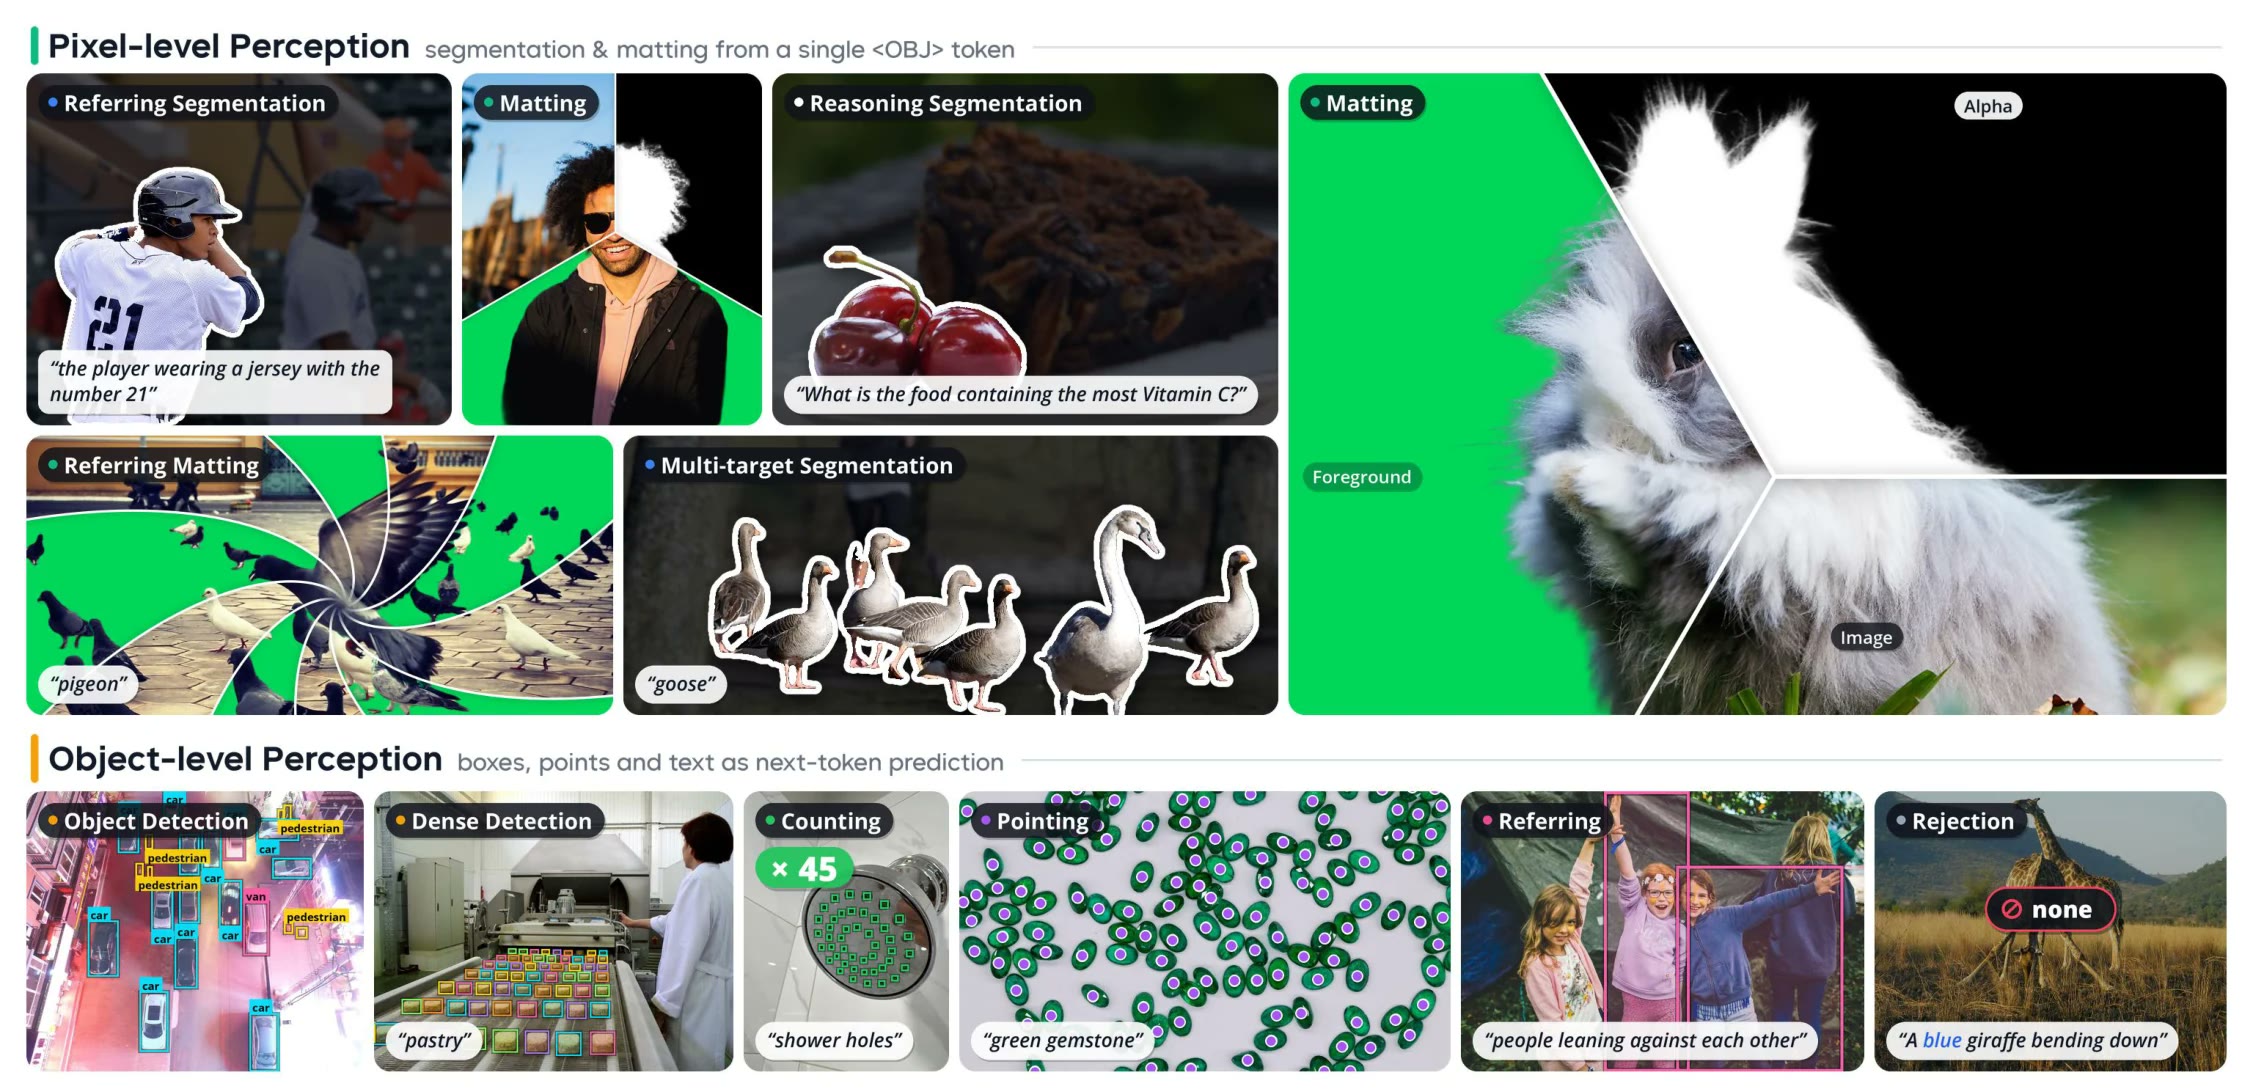
一个模型即可覆盖点、边界框、二值遮罩和连续透明度蒙版。来源:项目主页
节点返回什么
WeVisOne-VL Detect 位于 image/detection 分类下,有四个输出:masks、bboxes、points(像素坐标的 JSON)以及原始回答文本。你得到什么取决于所选的任务。
| 任务 | 输入内容 | 输出 |
|---|---|---|
segmentation | 一段短语,例如 person | 边界框加上每个实例的透明度蒙版 |
detection | 每行一个标签 | 边界框,可直接用于 Draw BBoxes |
referring | 描述性短语 | 匹配对象的边界框 |
point | 每行一个标签 | 以 JSON 表示的点坐标 |
count_box / count_point | 被计数的主体,例如 cars | 计数,以及边界框或点 |
ocr | 留空 | 每个词作为一个边界框 |
ocr_grounding | 文本字符串 | 该文本所在的位置 |
visual_prompt | 来自另一次运行的引用边界框 | 与引用相似的对象 |
freeform | 你的完整提示词 | 原始回答 |
开启 individual_masks 可为每个边界框保留单独的遮罩,而不是合并成一张遮罩。如需抠图,将 masks 和图像接到 InvertMask + JoinImageWithAlpha。
每个坐标都是从 <0> 到 <1000> 的一个 token,因此一个边界框消耗四个 token。来源:项目主页
如何运行
-
更新 ComfyUI。 该节点在主分支上,最新的 tag(v0.44.2)尚未包含它。
-
下载权重,从 Comfy-Org/WeVisOne-VL 下载到
ComfyUI/models/text_encoders/。该重打包版本包含四个文件:文件 大小 wevisone_vl_4b_bf16.safetensors9.7 GB wevisone_vl_4b_int8_convrot.safetensors5.3 GB wevisone_vl_2b_bf16.safetensors4.9 GB wevisone_vl_2b_int8_convrot.safetensors2.9 GB -
加载一个
CLIPLoader,类型选择stable_diffusion,挑选上述任一文件,然后将其连接到节点的clip输入。
PR 中的三组示例:人物透明度蒙版、检测和 OCR。把三个 LoadImage 节点换成你自己的图像即可。
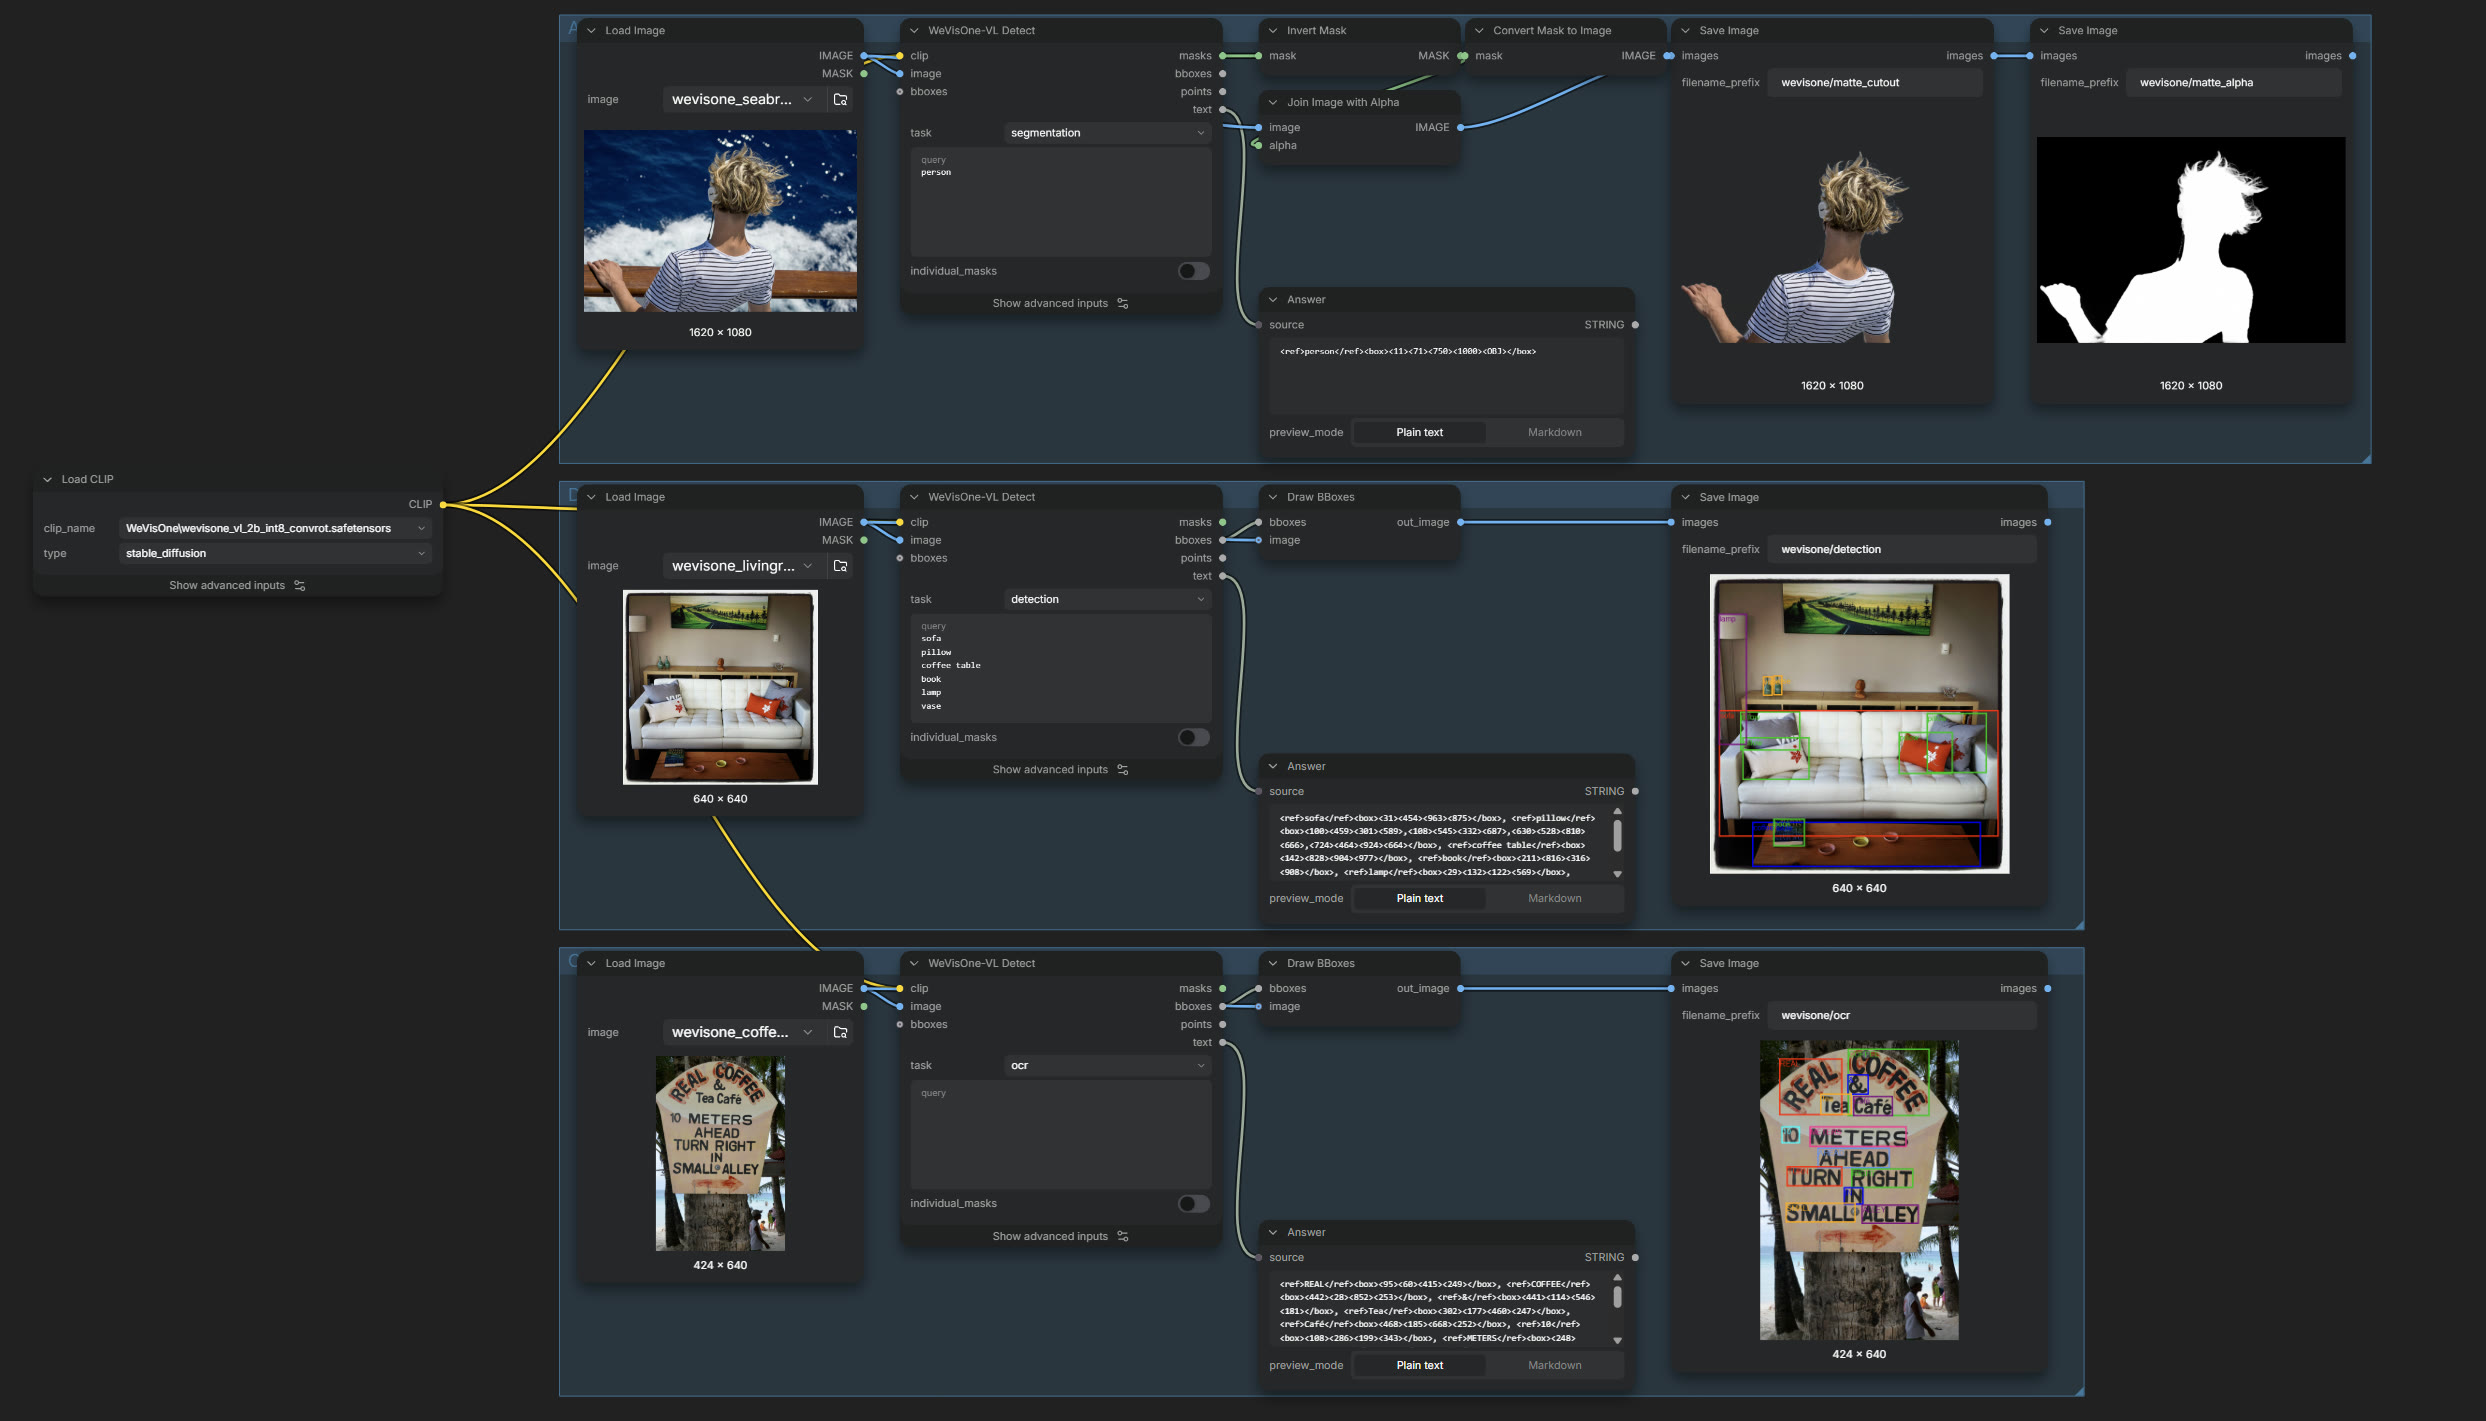
透明度蒙版、检测和 OCR 同在一个画面中。来源:PR 17632
效果如何
以下是 4B 模型在各基准上对比最强开源基线的主要数字:
| 任务 | 基准 | 基线 | WeVisOne-VL-4B |
|---|---|---|---|
| 检测 | LVIS, F1 | 50.7 | 55.3 |
| 拒绝不存在的目标 | WeRef-Bench | 73.0 | 96.4 |
| OCR | TotalText, F1 | 43.3 | 52.0 |
| 指代分割 | ReasonSeg, gIoU | 65.0 | 71.2 |
| 边界框蒙版 | P3M-500-NP, MAD(越低越好) | 15.4 | 7.3 |
拒绝那一行在实际画面中最关键:当你要求查找画面中不存在的东西时,模型会输出 None,而不是编造一个边界框。
限制
- 仅支持单张图像。像素解码器不接受视频网格,因此这不是跟踪节点。
- 在严重遮挡或透明主体上,精细的透明度边仍会偏移,而且查询的措辞会改变结果。
detection和point要求每行一个标签;逗号分隔的列表会被当作一个短语读取。
原始权重:tencent/WeVisOne-VL-4B 和 2B。上面提到的 ComfyUI 重打包版本才是可加载的那个。
评论
使用 GitHub 登录后即可参与讨论。