Open-H3-Regenerate-2K-IC:把 H3 草稿提升到 2K,同时保住人脸和文字
NVlabs 为 Open-H3-Regenerate-2K 增加了 in-context 版本:这个 LoRA 能在 2K 或 4K 下重绘 MiniMax H3 草稿,同时让人脸、口型同步和画面文字保持不变。
Open-H3-Regenerate-2K-IC 是 NVlabs 开放版 MiniMax H3 精修器的第二个版本。它做的事情和十月发布的版本一样:用三步把 1344x768 的草稿提升到 2K 或 4K。变化在于草稿被放到了哪里。第一版对草稿重新加噪再抛光,所以人脸、嘴形和小号文字都会漂移。IC 版本把干净的草稿保留在 Ref2VA transformer 的上下文中,并在旁边从噪波绘制高分辨率视频,因此人物身份、口型同步、招牌文字和布局都跟随草稿。
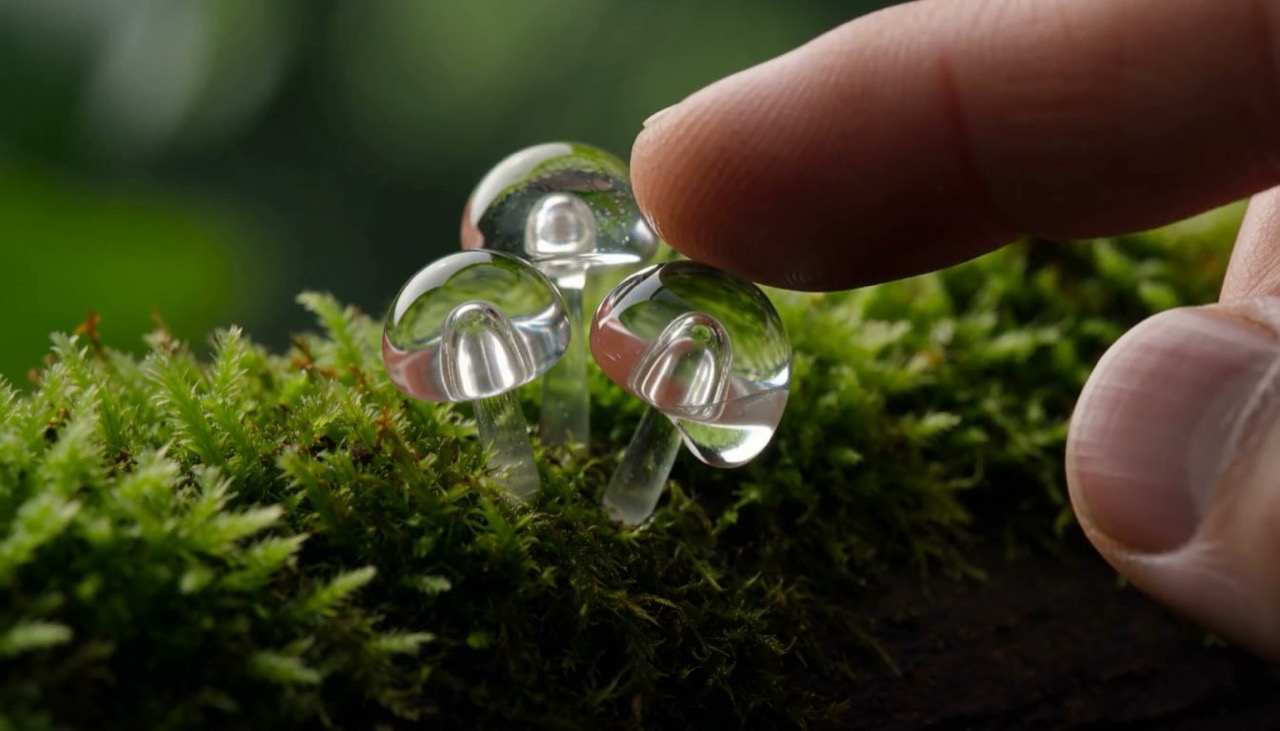 | 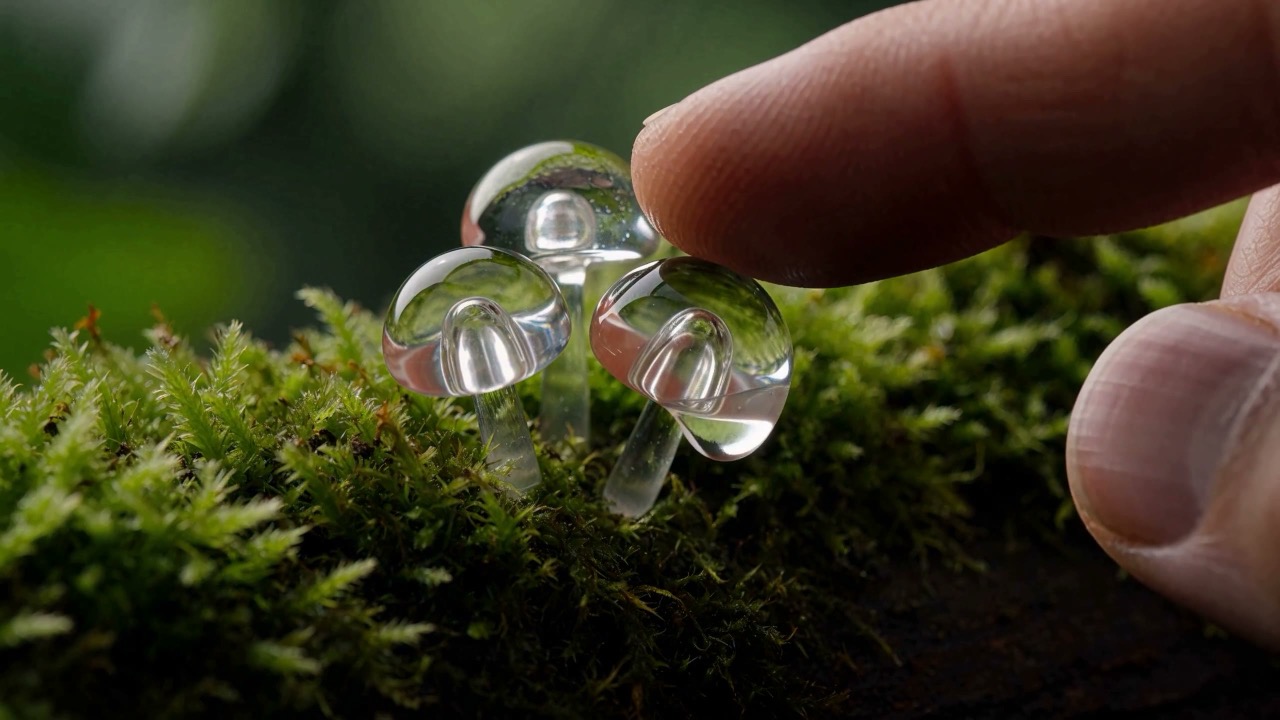 |
|---|---|
| H3 草稿,1344x768 | 经过 IC 处理后的同一帧,2560x1440 |
画面来自项目自带的对比视频。来源:项目页面
该视频在 2560x1440 下的 IC 输出,音频沿用草稿。来源:项目页面
保留了什么
与官方 H3-Regenerate-2K API 相比,项目里的停车场对比是最清楚的例子:API 把招牌渲染成无法辨认的笔画,IC 版本仍能读出 "PRIVATE CAR PARK"。与第一个开放版本相比,IC 输出新增的纹理更少,但眼睛、皱纹和嘴形都留在草稿原先的位置上。
IC LoRA 在冻结的 Ref2VA transformer 上训练,该 transformer 本来就会把参考视频作为额外的 token 读取。每个训练对都是一段真实的 768P 到 4K 视频;其缩小副本放在前面作为干净参考,而目标则从纯噪波到干净状态之间任意加噪,损失只落在目标 token 上。
运行方式
把 768P 草稿作为 <Video 1> 输入,并附上生成它时所用的文本描述,保持不变。三个采样器,全部使用 CFG 1:
up3(默认):草稿 Latent 经过 3D 卷积 Latent 放大器,加噪到 sigma 0.835,并在三次 transformer 调用内完成。up4:同样的放大起点,sigma 0.923,四次调用。hf8:纯噪波,完整的八个 HyperFlow 步骤。
输出为 1080p、2K(2560x1440,默认)或 4K(3840x2160);384P、512P 和 576P 的草稿会回到 768P。音频从草稿原样复制,权重中附带一个静音音频 Latent,2K 结果通过快速 H3 VAE 解码,4K 则使用标准 VAE。
在 ComfyUI 中
目前没有官方节点,但已经有两条社区路线:
- Kijai 把 8.3 GB 的 FP32 LoRA 压缩成一个 200 MB 的 rank-21 bf16 文件,可作为普通 LoRA 加载到 Ref2VA 模型上。
- ComfyUI-OpenH3Regenerate2KIC 提供四个节点(Prepare Draft、Official Prompt、Sigma Grid、Compose Target Latent)、全秩 5.9 GB 的转换后 LoRA,以及三个工作流:文本到草稿再到 2K、参考图像到草稿再到 2K、草稿到 2K。
权重和推理代码在 Hugging Face 上,参考 CLI 位于 NVlabs/Sana。
评论
使用 GitHub 登录后即可参与讨论。