Fizgig 9.2 将 MOSS-Image LoRA 训练缩短至 20 分钟
Fizgig 9.2 升级至 PyTorch 2.15 与更快的 Muon 步骤:在 RTX 5090 上训练 MOSS-Image LoRA 仅需 20 分钟而非 49 分钟,内存占用降至三分之一。LoRA 可在 ComfyUI 中加载。
Fizgig 9.2 于 11 月 8 日发布,让每次训练都更快、更轻,MOSS-Image 的提升尤为明显。在 RTX 5090 上,一个 MOSS-Image LoRA(94 张图像、批处理 1、Muon、70 个 epoch)现在约 20 分钟即可完成,而不是 49 分钟,相似度评分也持平或更好(发布说明)。
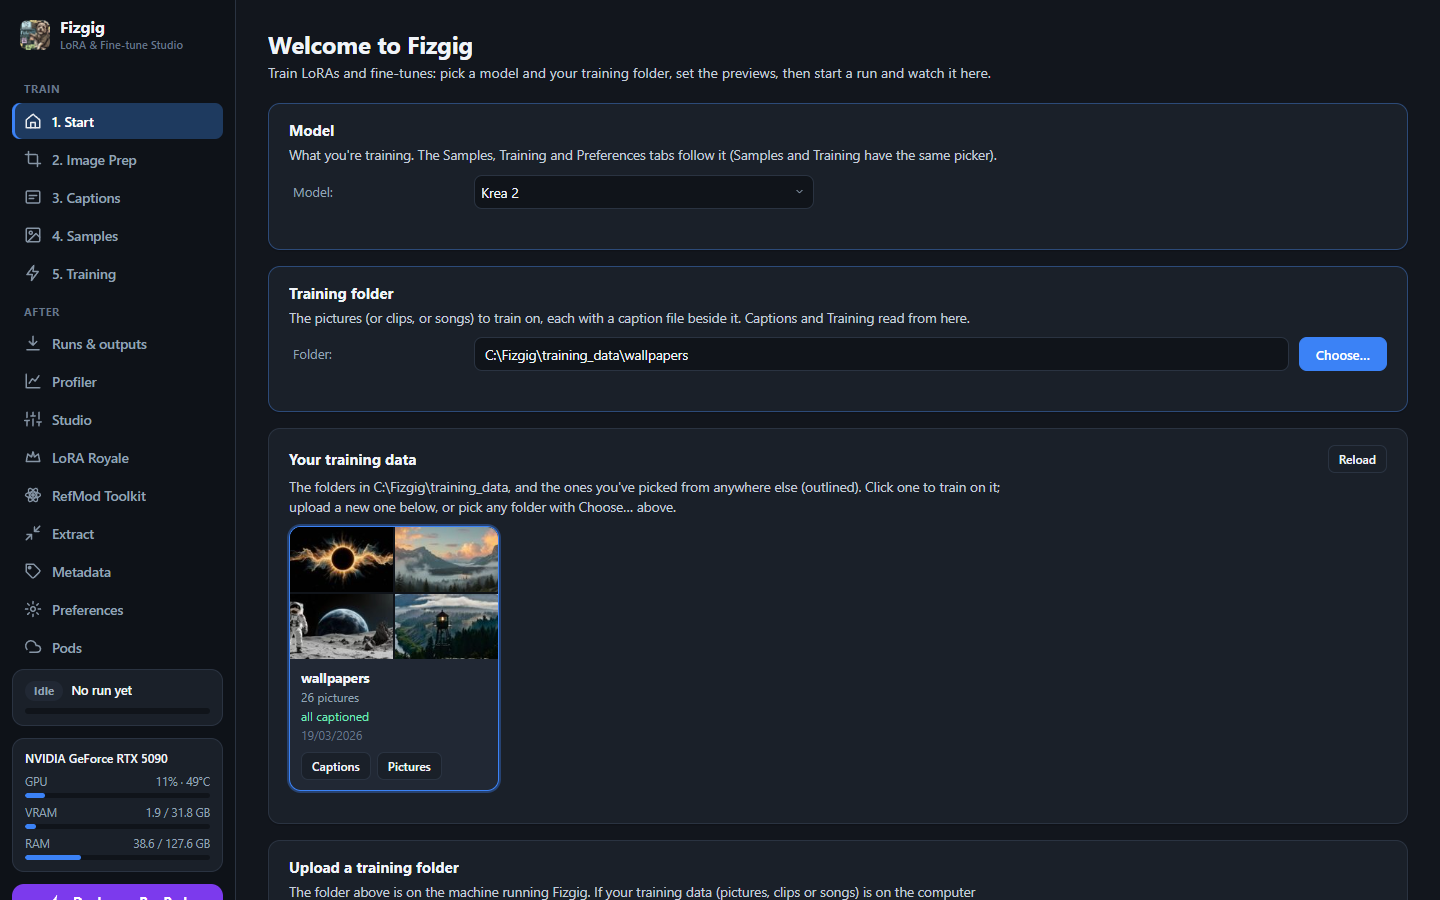
Fizgig 的启动标签页。训练器独立运行,然后保存为 kohya 格式的 LoRA 到 ComfyUI/models/loras/。
数据一览
| RTX 5090 上的 MOSS-Image LoRA | 9.2 之前 | 9.2 |
|---|---|---|
| 94 张图像、批处理 1、Muon、70 个 epoch | 49 分钟 | 约 20 分钟 |
| 内存占用,批处理 3,梯度检查点 | 21.7 GB | 7.1 GB |
在批处理 3 下,训练器现在于同一张显卡上达到 OneTrainer 每步 1.07 秒的水平,同时内存占用更低(6.9 GB 对 7.4 GB),因此批量训练已成为实用选项,而不再是妥协。
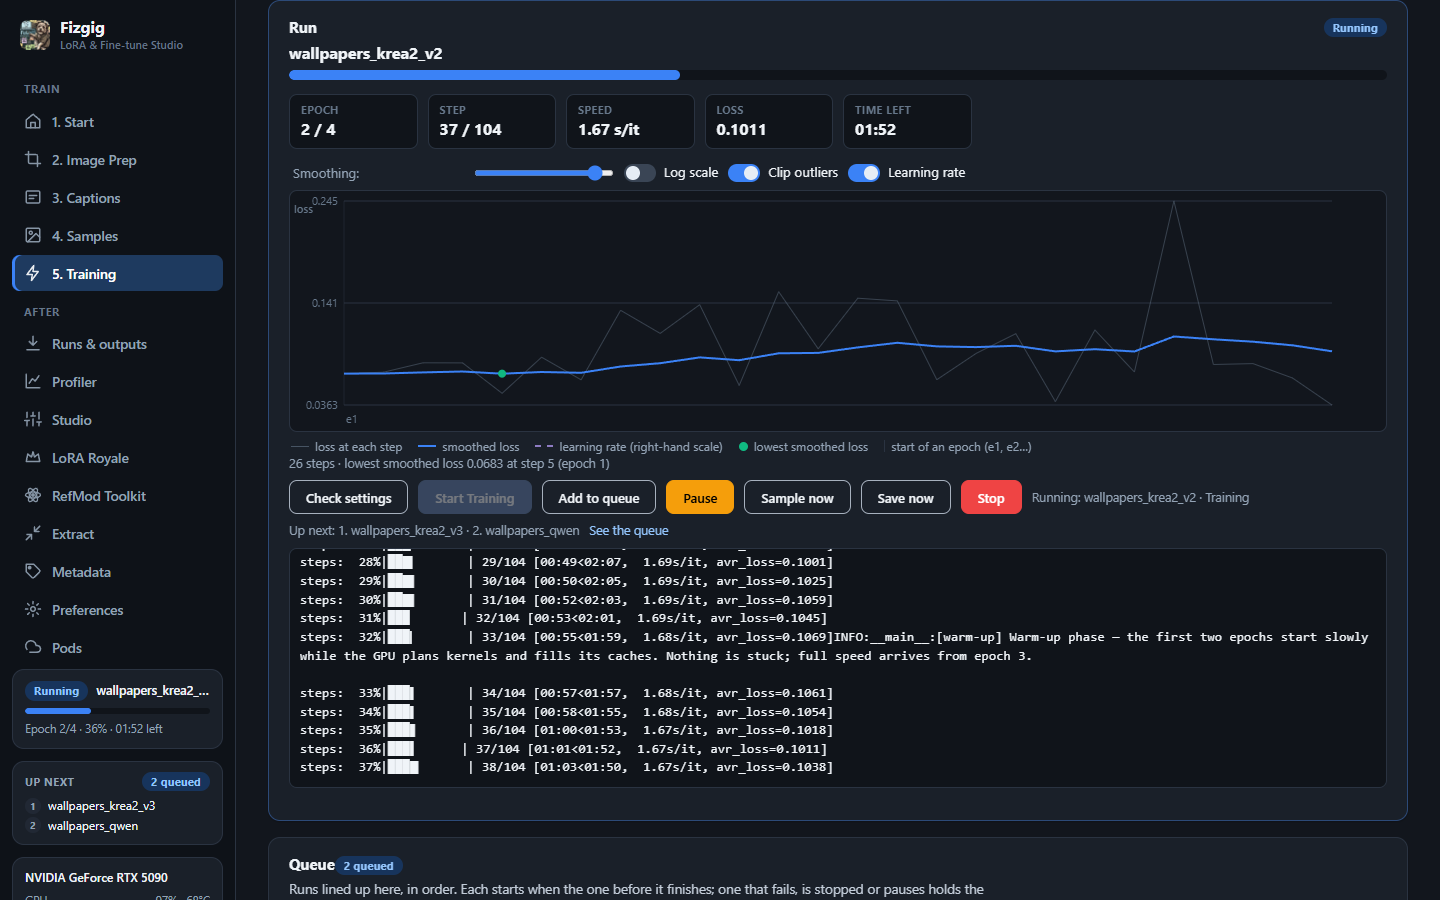
训练标签页上的运行,侧边栏中显示队列。
变更内容
- PyTorch 2.15。 开启梯度检查点后,内存大幅下降:Krea 2 在批处理 1 下从 22.9 GB 降至 14.9 GB。在 16 GB 的笔记本 4090 上,Fibo 2.0 训练速度提升 22%,Klein 提升 13%,Krea 2 提升 11%。
- 更快的 Muon 步骤。 现在它会同时处理 LoRA 的多个矩阵,而不是逐个处理:速度提升 12 倍,结果相同。LoKR 训练在所有模型上都快 4 到 6 倍。
- 更快的批处理。 不同长度的描述不再拖慢注意力:MOSS-Image 的步骤快 18%,Krea 2 快 12%,Qwen-Image 2.1 快 9%。
MOSS-Image Turbo Train
9.2.5 版本新增一个实验性 MOSS-Image Turbo Train 预设:采用 Fast 预设(rank 16、0.25 MP、Muon),自适应学习率在 2e-4 到 4e-4 之间运行,并逐图像跟踪,让每张图片拥有自己的节奏。这是在投入长时间训练前快速了解 LoRA 潜力的方式,在优质数据集上表现可靠。
MOSS-Image 的预设也已迁移到新的 Clean-end 比例 30:7:60:8:3:30% 的步骤用于接近干净的图像,直到第 7 个 epoch,之后从第 8 个 epoch 起为 60%。请重新加载预设以应用新比例,因为已保存的设置会保留旧的时间表。
更新
本次更新会下载 PyTorch 2.15(约 3 GB),并且需要 Python 3.11 或更高版本。NVIDIA 驱动必须支持 CUDA 13,即版本 580 或更新;如果更新后 Fizgig 无法识别 GPU,请更新驱动。在 AMD 平台上,捆绑的 ROCm PyTorch 未变,租用的 pod 在重新启动后会采用新版本。
.safetensors 文件,可通过 ComfyUI 自带的 LoRA 加载器加载。
评论
使用 GitHub 登录后即可参与讨论。