H3 Relay Hires 用四分之一时间完成 MiniMax H3 1080p 渲染
H3 Relay Hires 在 ComfyUI 中以 0.5 MP 渲染 MiniMax H3 生成结果,再用动漫放大模型和一步 DMAD 在 1920x1088 完成收尾:在 RTX 5090 上从 503 秒缩短到 119 秒。
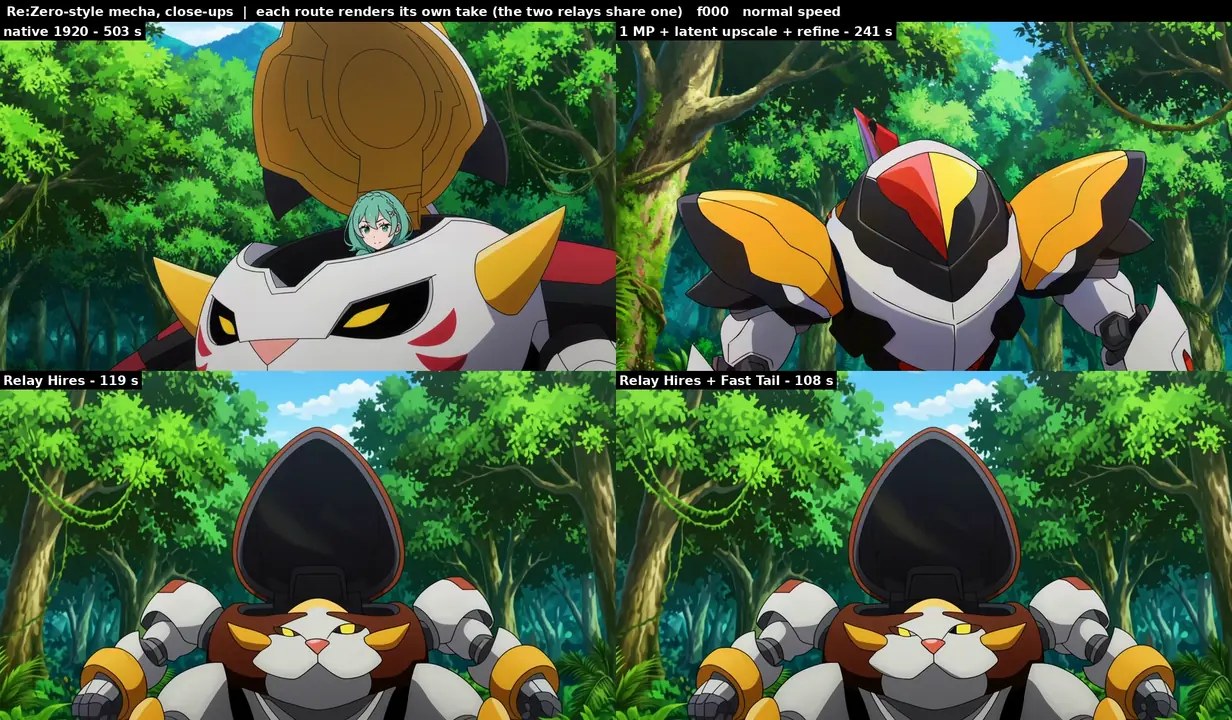
上:原生 1920 渲染。下:Relay Hires。每条路线都会渲染自己的结果,所以请比较画面绘制,而不是姿势。
同样的对比,带声音,然后以半速播放。
数据
在 RTX 5090 上以 1920x1088 渲染 5 秒片段(124 帧),端到端耗时:
| 片段 | 原生 1920 | 1 MP + Latent 放大 + 精修 | Relay Hires | + Fast Tail |
|---|---|---|---|---|
| Teen Titans 风格出拳 | 492 秒 | 240 秒 | 116 秒 | 105 秒 |
| 剑斗 | 503 秒 | 241 秒 | 118 秒 | 107 秒 |
| Edgerunners 风格火箭 | 508 秒 | 245 秒 | 121 秒 | 109 秒 |
| Re:Zero 风格机甲特写 | 503 秒 | 241 秒 | 119 秒 | 108 秒 |
| 全景,小脸 | 500 秒 | 239 秒 | 117 秒 | 106 秒 |
它是如何做到的
- 第 1 阶段在 960x544 决定布局、运动、表演和音频。大部分渲染时间都在这里:60 秒,而 1 MP 时需要 151 秒。
- AnimeSR 用约 2 秒放大解码后的帧。H3 在任何分辨率下绘制的墨线都大约 2 px 宽,所以 0.5 MP 的帧线条对 1920 来说粗了一倍,而这个 130 万参数的放大模型在 9,470 对 H3 风格图像对上训练,正是为了消除这一点。
- 在 sigma 0.60 下走一步,在 1920 重新加噪,并用单个 DMAD 步骤重绘细节,然后解码。
作者实测的设置:sigma 0.60(0.45 偏软,0.75 会重绘面部)、一步,以及窗口注意力 4、每 8 个 Latent 帧设一个锚点,这能让长片段上的 1920 步骤耗时减半。H3 Fast Tail Sampler 在第 1 阶段替换 euler,可再省约 20% 的时间,而不改变结果。Pika H3 Flex 的第 1 阶段是最快的路线,但会渲染出自己的结果。
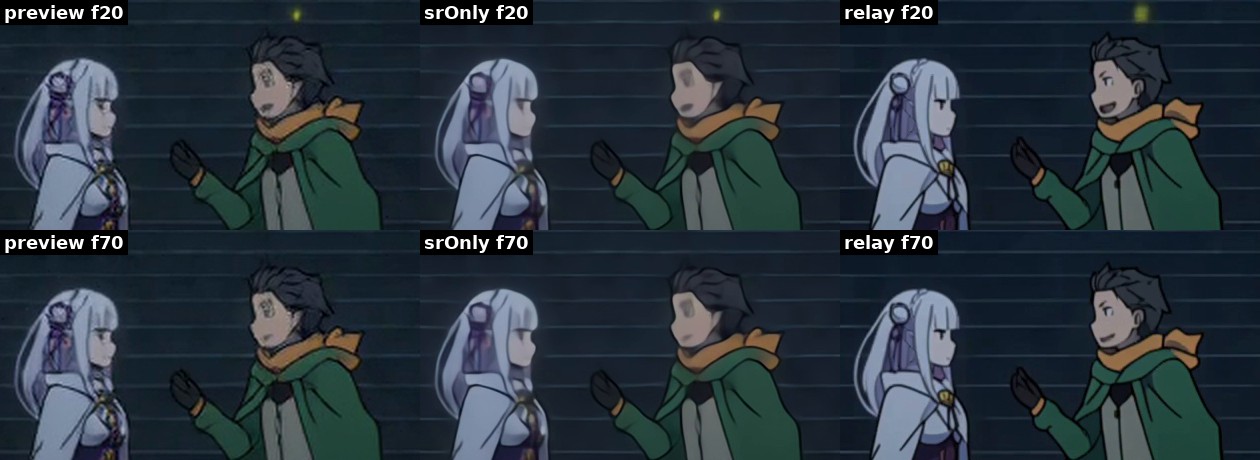
0.5 MP 预览 | 仅 AnimeSR | Relay Hires,1920 下的 1:1 裁切。
它解决不了的问题
- 墨线落在 3.1-3.9 px,而原生渲染是 2.2-3.0 px。
- 极快的动作如果在 0.5 MP 的生成结果里已经糊掉,放大后依然模糊。先用作者的 de-rope 工作流修好这些帧,再做 relay。
- AnimeSR 仅适用于动漫。 通过节点的
upscale_model输入接入任意 ComfyUI 放大模型,即可用于写实或绘画风格片段。在一次绘画风格测试中,RealESRGAN x2plus 保住了皮肤和卡片细节,而 AnimeSR 把它们变成了赛璐璐上色。 - 如果亮度每 4 帧脉动一次,可选的 Sol-H3 VAE 工作流可以在编码开销翻倍的情况下修好它。
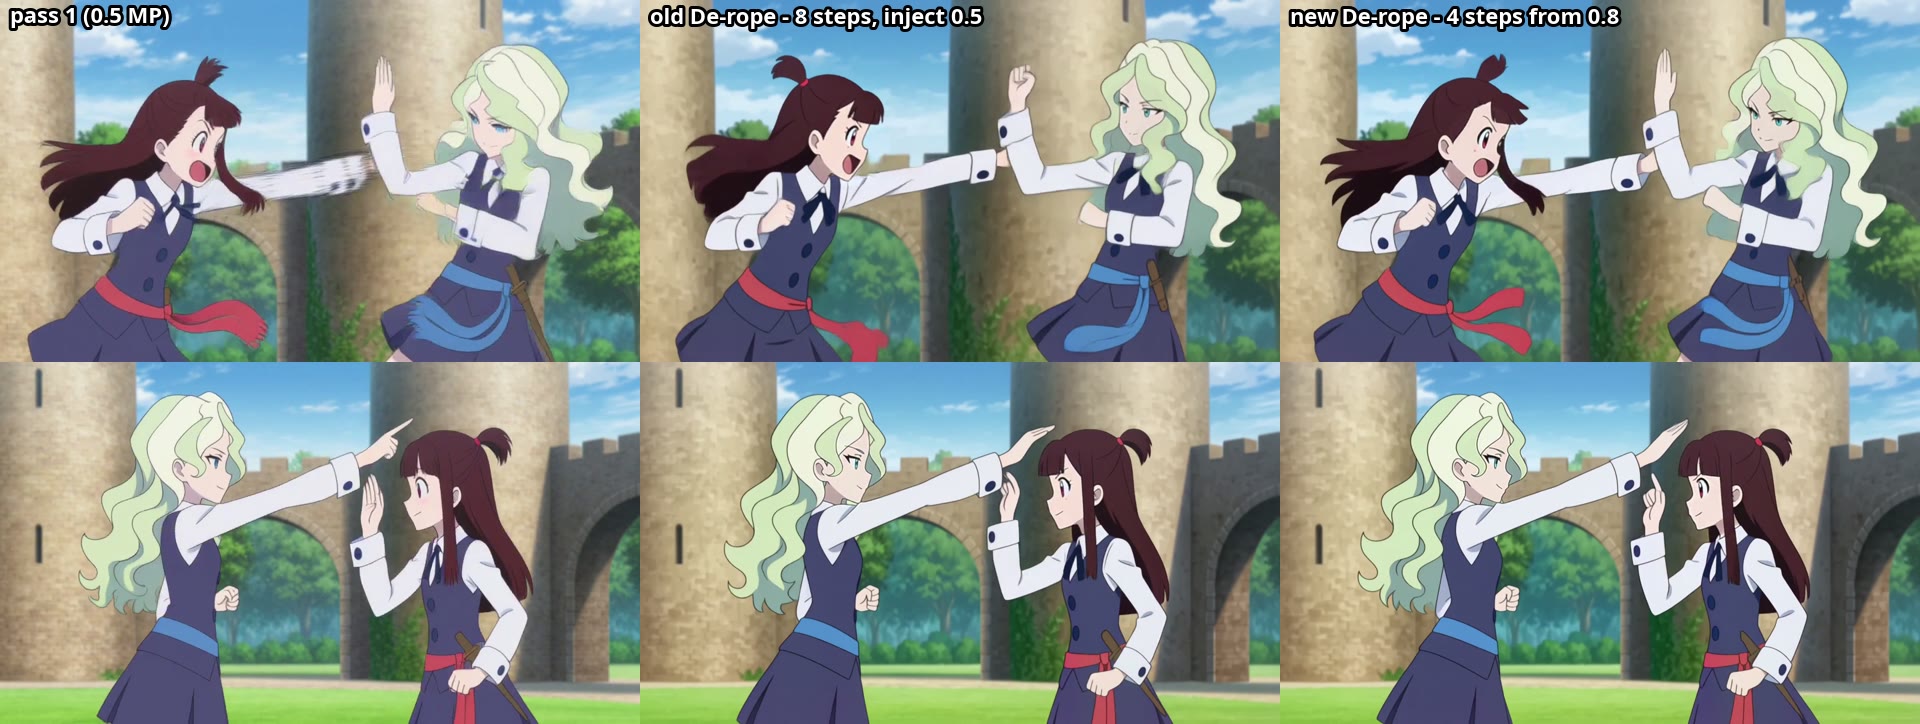
第 1 阶段 | 旧的 de-rope 调度 | 从 0.8 开始的 4 步版本,保持了第 1 阶段的构图。
安装
像安装任何节点包一样安装它(ComfyUI Manager,或克隆到 custom_nodes/)。你需要 ComfyUI 中的 MiniMax H3、DMAD 4 步 turbo LoRA,以及用于编码的 taeh3 加载器。AnimeSR 权重随仓库一起提供。
example_workflows/ 中有十二个示例工作流:先是仅 relay,然后是 Fast De-rope、FaceDetail 和 Anime Cadence,每个还配有 Fast Tail Sampler 和 Pika 变体。其中一些需要作者的其他节点包,FastDerope、FaceDetail、ResCascade 和 AnimeCadence,以及 MAINodes。
可用性
节点包位于 github.com/tazmannner/ComfyUI-H3-RelayHires(MIT,v0.3.0)。训练你自己 AnimeSR 的脚本(training/prep.py、training/train.py)在 RTX 5090 上大约需要 22 分钟。
评论
使用 GitHub 登录后即可参与讨论。