HyperFlow H3 Flash:单卡 6 步运行 14B MiniMax H3
Video Rebirth 的 HyperFlow H3 Flash 将 MiniMax H3 压缩至 13.7B,在 CFG 1 下以 4 到 8 步采样,仅凭 9.1 GB 的 GGUF 即可在 24 GB 显卡上运行,并输出立体声音频。
Q4_K_M GGUF 仅 9.1 GB,整套流程可在 24 GB 显卡上运行。Video Rebirth 在单张 B200 上测得相比 H3 基线 12.7× 的加速。
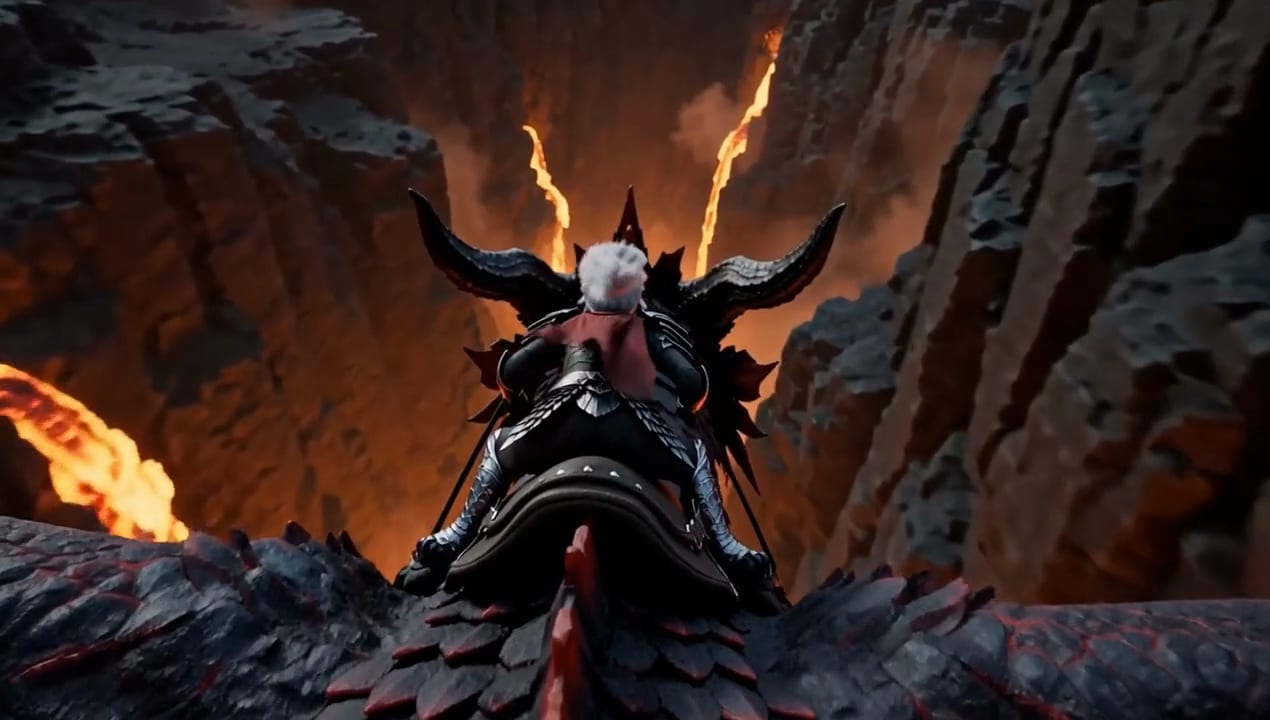
6 步的全质量输出。静帧随发布一并公布。
变化之处
体积变小来自对基础 transformer 的低秩分解,而非新的架构。其余部分全部沿用 H3:相同的文本编码器、视频 VAE、音频 VAE 以及 ComfyUI 原生 H3 节点。
- 输出: 5.2 至 15 秒、24 fps,默认 1344x768,32 kHz 立体声。
- 采样:
euler,4 步追求速度,6 步为默认,8 步追求质量。无需负面提示词:该模型在 CFG 1 下训练。 - 使用例: 文生视频、首帧、首尾帧,以及最多 9 张图像的参考生视频(Python 路径下为 12 张,还可接受视频和音频引用)。
大小与速度
6 步生成 5.2 秒片段,Video Rebirth 给出的数据:
| 硬件 | 时间 |
|---|---|
| 4x B200 | 8.7 秒 |
| 1x H200 | 36 秒 |
| 1x RTX 5090 | 92 秒 |
| GGUF 量化 | fl2va | ref2va | 适用场景 |
|---|---|---|---|
Q4_K_M | 9.1 GB | 9.2 GB | 24 GB 显卡的默认选择 |
Q8_0 | 14.9 GB | 15.2 GB | 最接近全精度 |
Q3_K_M | 7.2 GB | 7.4 GB | 体积最小 |
INT8 convrot 版本每个任务约需 16 GB,面向 H100 与 B200 级别显卡,或搭配大容量系统内存的 24 GB RTX 显卡。
在 ComfyUI 中运行
- 将 ComfyUI 更新至 0.43 或更高版本,以获得
MiniMaxH3ImageToVideo和MiniMaxH3ReferenceToVideo。 - 克隆 ComfyUI-GGUF 和 ComfyUI-HyperFlow-Flash 到
custom_nodes/。 - 将 GGUF 放入
models/diffusion_models/,并放入来自 Comfy-Org/MiniMax-H3 的 15.7 GBqwen3vl_32b_minimax_h3_nvfp4_awq文本编码器以及视频和音频 VAE。 - 打开 工作流 > 浏览模板 > ComfyUI-HyperFlow-Flash。共有四个模板:
hyperflow_t2v、hyperflow_i2v、hyperflow_flf2v、hyperflow_ref2v。
在 16 GB 或 32 GB 内存的机器上,请以 --fast-disk 启动 ComfyUI。仅文本编码器就有 15.7 GB,因此通常先耗尽的是内存而非显存。
hyperflow_t2v 模板:HyperFlow GGUF Loader 与 HyperFlow Sigmas 取代了 H3 加载器和调度器。
下载之前
- 在完整 H3 上训练的 LoRA 无法加载。 压缩后的 transformer 没有与之对应的图层,因此 31B 模型的加速 LoRA 和滑块 LoRA 都无法使用。
- 加速幅度小于参数量的差距所暗示的。 Kijai 在 ComfyUI 中实测相比剪枝后的完整模型仅约 10% 提升,因为在此分辨率下注意力开销保持不变。LukeG89 认为不值得。
- 16 GB 显卡尚未测试。 已测试的最小显存需求为 24 GB。
发布页面上的消费级显卡片段。
获取方式
权重:VideoRebirthAI/hyperflow-h3-flash(GGUF 与 INT8 convrot,v1.0.0,2026-11-06)。代码与 ComfyUI 节点:Video-Rebirth/hyperflow-h3-flash 和 ComfyUI-HyperFlow-Flash。展示页:videorebirth.com/lp/hyperflow-flash。
这是 Video Rebirth 的模型,并非 MiniMax 官方发布。它与 HyperFlow 8 步 LoRA 相互独立,后者仍在完整的 31B H3 上运行。
评论
使用 GitHub 登录后即可参与讨论。