Viggle Remake 用两个 H3 LoRA 重拍任意视频
Viggle Remake 是一对开放的 MiniMax H3 LoRA,用于替换或编辑已有素材:绘制一到四帧,保留原声,在 ComfyUI 中最低 12 GB 显存即可运行。
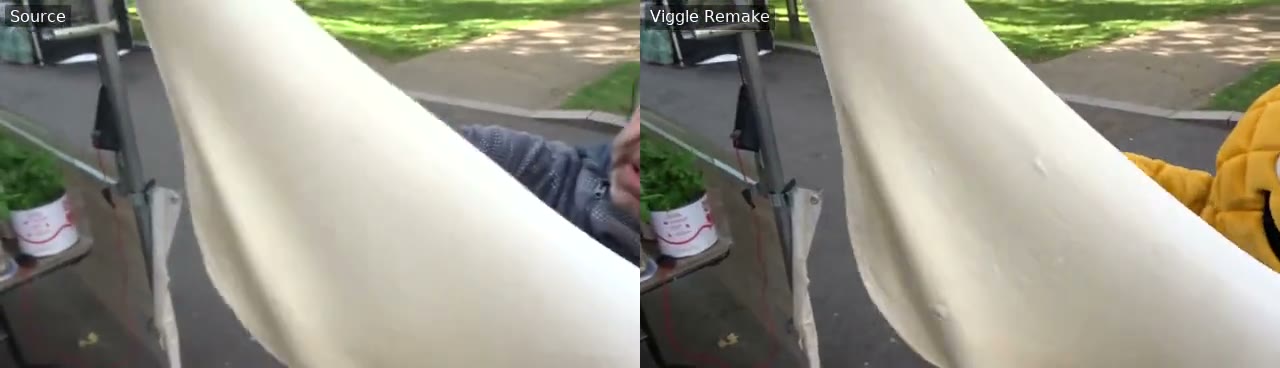
左:源片段。右:同一镜头中菠萝吉祥物被替换,运动、相机和时序保持不变。
自 8 月底的 Viggle-Animate 以来,Viggle 一直在朝这个方向推进;那次是在一个经过深度蒸馏的 H3 ref2va 微调模型上,用一帧重新绘制的画面替换镜头中的角色。Remake 就是模型卡里所说的当时预览的 "Viggle-Animate v2",它在两方面有所推进:它是作用于原生 H3 transformer 的 LoRA,而不是微调模型;并且它编辑的不只是人物。
两种模式
两种模式都接收源片段以及一到四张引用图像,在提示词中称为 <Picture 1> 到 <Picture 4>。这些引用图像由你自己绘制,可以在从片段中取出的帧上绘制,也可以从零开始画;每一张都可以固定到它被绘制时所依据的源帧上。
swap替换人物和角色,可一次替换一个或多个。edit负责其余部分:替换、移除或插入对象,改变背景、天气或光线。
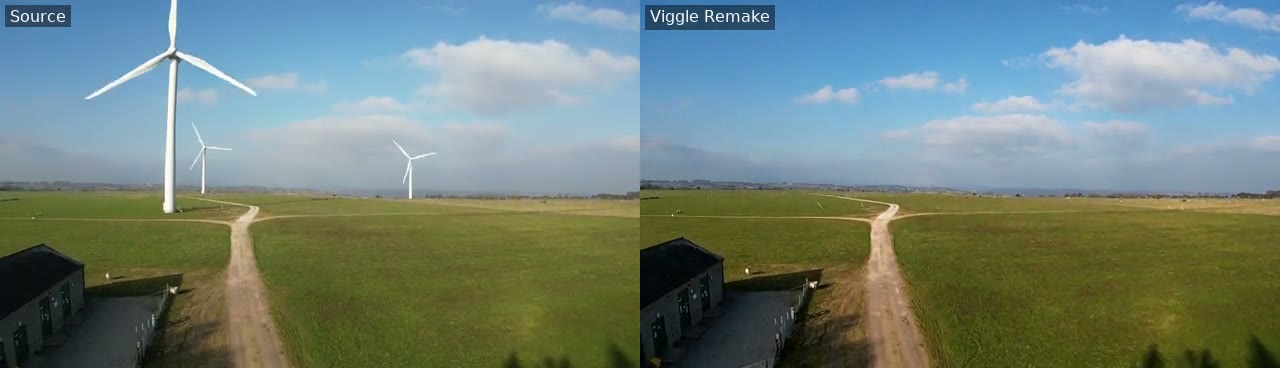
edit LoRA 从镜头中移除对象,同时相机运动和底片其余部分保持不变。
身份来自绘制出的画面,而非人脸编码器或分割遮罩。这就是该 pipeline 不需要姿态估计或跟踪的原因,也是模型卡直言无法验证授权的原因:身份唯一下决定的地方,就是你绘制的那张图。
技术细节
每种模式都是一个 PEFT LoRA,rank 256、alpha 256,覆盖 H3 的 FL2VA transformer 的 302 个线性层,以 bf16 存储,其中四个 proj_in / proj_out tensor 为 fp32。基础模型的其他部分没有任何改变;LoRA 是加载时应用的增量。仓库还附带重新打包为 ComfyUI 层名的同一份权重、合并后的 int8 和 GGUF transformer,以及 inference/sample.py 中的参考采样器。
声音是沿用而非生成的。输出会保留源片段的声音,因此无声源会得到无声结果;音频编码在末尾做了填充,因为 ComfyUI 原生音频编码会从两端把音轨裁剪到整数个 800 采样块,相对画面最多偏移 400 个采样。
ComfyUI 路径
ComfyUI 原生支持 H3,因此节点包只处理原生节点做法不同的四处。它新增了三个节点,已在 ComfyUI 0.42.0 上测试:
- Viggle Remake Conditioning:接收源帧、音频、最多四个引用、固定帧和提示词。
- Viggle Remake Keyframe Until:把固定的引用转换为关键帧,作用到采样范围的指定比例为止。
- Viggle Remake Noise:为给定随机种子复现参考采样器的起始噪声。
工作流图其余部分都是原生节点:LoraLoaderBypassModelOnly、BasicGuider、配合 euler 的 KSamplerSelect、ManualSigmas、SamplerCustomAdvanced、两次 VAE 解码、24 fps 的 Create Video。
有一项设置值得反复强调,因为它影响的是输出质量而非速度。普通的 LoraLoaderModelOnly 会把 LoRA 合并进 bf16 权重,而在 bf16 下大部分更新会被舍入掉:项目实测在注意力和 MLP 层中只有 37% 到 73% 的更新被保留,swap 示例合并后的渲染清晰度低 7%(21.2 dB 对 24.7 dB)。LoraLoaderBypassModelOnly 将 LoRA 保留为独立分支,每次渲染多花 2% 到 3% 的时间。
| swap | edit | |
|---|---|---|
| LoRA | viggle_remake_swap_comfyui.safetensors | viggle_remake_edit_comfyui.safetensors |
| ManualSigmas | 1.0, 0.990476, 0.965243, 0.923077, 0.8, 0.631579, 0.0 | 1.0, 0.983607, 0.96, 0.923077, 0.857143, 0.705882, 0.0 |
小显存显卡:int8 与 GGUF
bf16 路线需要一张 80 GB 显卡和约 144 GB 的基础模型。低于此配置时,每种模式都提供一个单独的 transformer 文件,LoRA 已在 fp32 下合并并量化,在工作流中同时替代基础 diffusion 模型和 LoRA 加载器。
| 文件 | 大小 | 加载器 |
|---|---|---|
int8/viggle_remake_{swap,edit}_pruned_int8_convrot.safetensors | 21.0 GB | Load Diffusion Model(核心) |
gguf/*-Q8_0.gguf | 22.3 GB | Unet Loader (GGUF) |
gguf/*-Q6_K.gguf | 17.6 GB | Unet Loader (GGUF) |
gguf/*-Q4_K_M.gguf | 14.3 GB | Unet Loader (GGUF) |
项目的显卡表格,以 edit 示例、226 帧、两个固定引用测得:
- 12 GB:Q4_K_M 或 Q8_0 配合
--reserve-vram 8;int8 只能跑 124 帧。 - 16 GB:832x480 下用 int8;Q4_K_M 或 Q6_K 配合
--reserve-vram 6;1280x736 下用 Q4_K_M 配合--reserve-vram 10,124 帧。 - 24 GB:832x480 下用 int8 或 Q4_K_M;1280x736 下用 Q4_K_M 或 Q8_0 配合
--reserve-vram 20。 - 32 到 80 GB:832x480 下 int8 或 Q8_0 都很从容;1280x736 下,int8 文件在 48 GB 和 80 GB 显卡上跑 226 帧会内存不足,而 Q8_0 在 24 GB 显卡上留出预留即可容纳。
相对 bf16 加 LoRA 参考的质量,以逐帧 PSNR 衡量:int8 在 swap 上为 27.2 dB、edit 上为 46.8 dB,Q8_0 为 26.9 和 49.8,Q6_K 为 24.6 和 44.6,Q4_K_M 为 20.6 和 38.3。swap 这一列波动较大:用另一种略有差异的方式对同一份 bf16 权重再做一次舍入,该渲染就已变成 29.6 dB,所以那里差几个 dB 并不构成格式排名。
速度
在单张 B200 上,832x480、226 帧、两个固定引用,模型加载完成后 ComfyUI 每次渲染约需 95 秒,六步中每步约 13.5 秒,而 sample.py 约需 58 秒。包含加载的首次渲染需要 2.5 到 3 分钟。在 1280x736 下,每步耗时 64 到 72 秒,一次渲染 510 到 585 秒。项目只测了 B200,并已说明这一点;消费级显卡会更慢。
限制
- 一次渲染覆盖 90 到 345 帧的窗口(
17n+5,24 fps);项目建议最多 294 帧,约 12 秒;更长的视频会被切分成多个窗口,由 MCP 服务器在镜头边界处切分。 - 六段式 H3 提示词为必填,其时间戳必须与帧数匹配。
- 绘制的画面决定身份和外观;固定帧还会固定该帧处的构图。
- 已知失败情况:单个长镜头中的非人形角色、精细细节上的小瑕疵,以及在没有固定的情况下渲染多镜头片段时镜头在时间上发生漂移。
ComfyUI 工作流自带的 swap 示例:226 帧,两个引用分别固定在第 12 帧和第 184 帧。
edit 示例:风力发电机从底片中消失,而摇镜和光线保持不变。
获取方式
权重、LoRA、int8 与 GGUF 文件、节点包和工作流都在 Hugging Face 上,旁边还有 COMFYUI.md、PROMPTING.md 和 MODIFICATIONS.md。仓库完整约 210 GB,因此 ComfyUI 指南只下载 comfyui/ 和 examples/inputs/ 两个子集。它于 2026 年 11 月 4 日发布,同日由 @viggleai 宣布;模型卡没有提供与其他编辑模型的对比基准,因此以上数字均来自项目自身。
评论
使用 GitHub 登录后即可参与讨论。