P-H3-Image 让 MiniMax H3 图像生成登陆 ComfyUI
PrunaAI 的 P-H3-Image 无需 CFG,8 步即可生成 8 MP 图像,并支持最多 8 张参考图编辑。ComfyUI 在发布当天即提供原生支持。
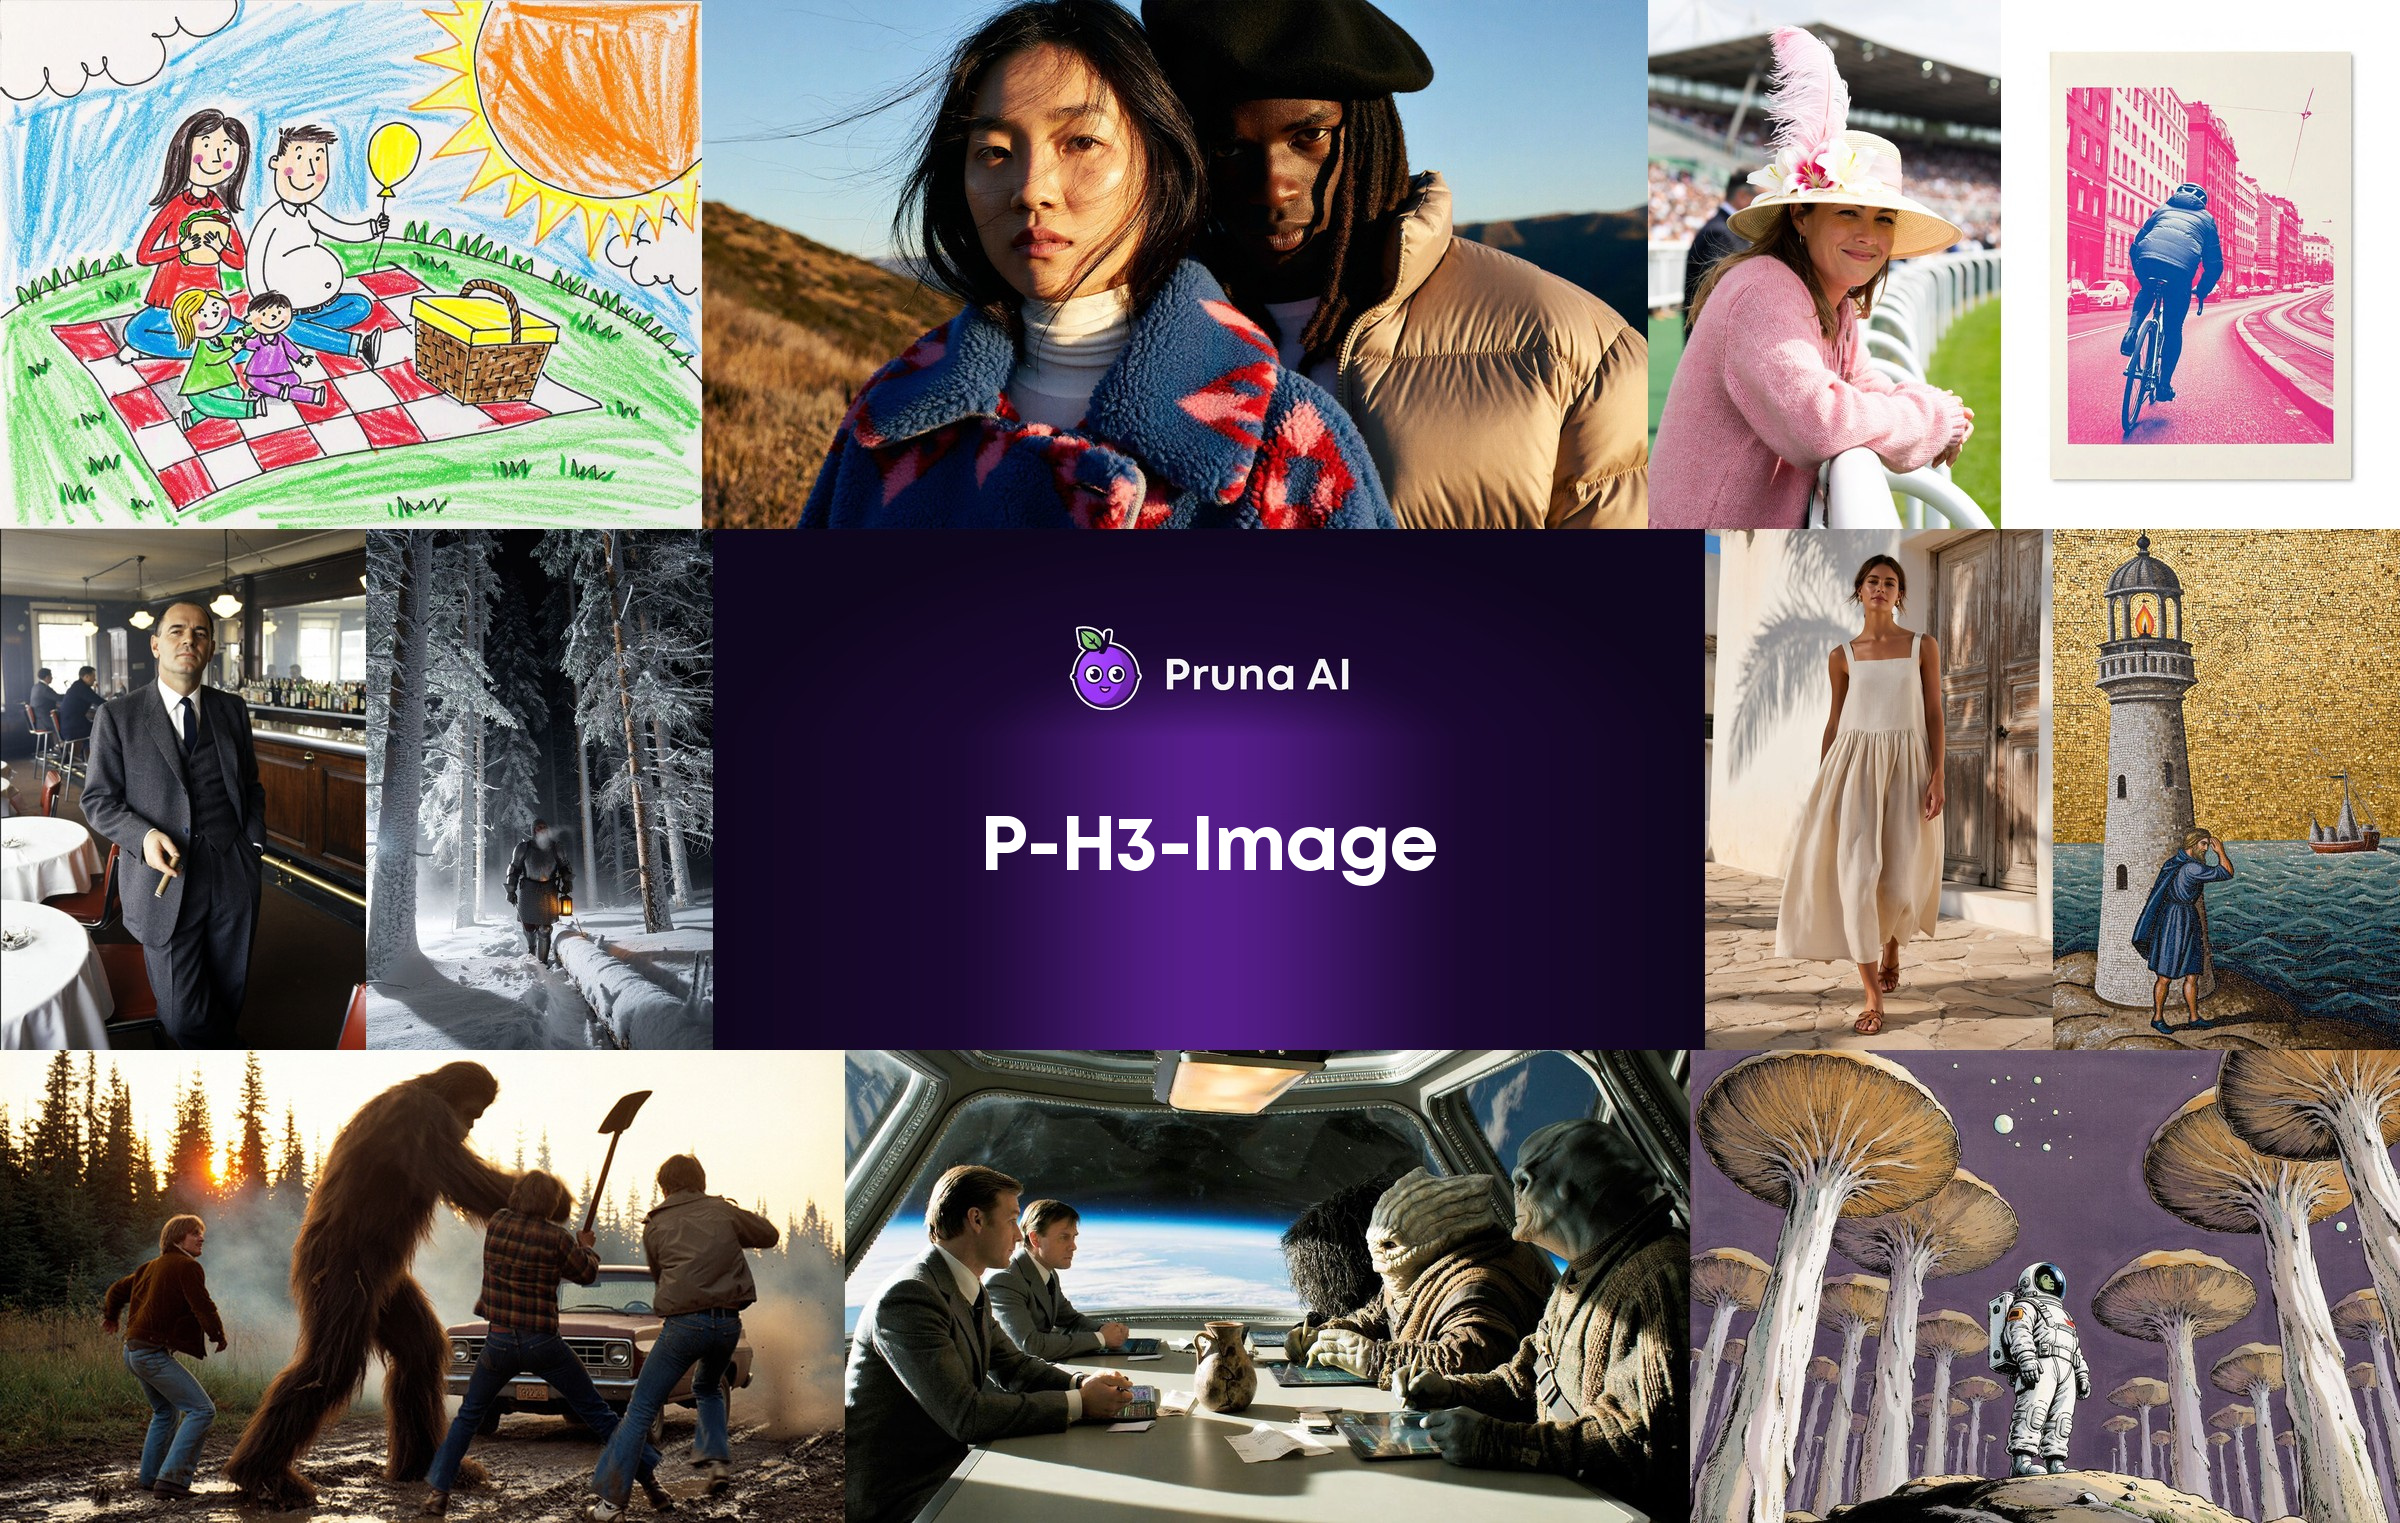
示例来自官方模型卡。模型卡将 P-H3-Image 定位为适用于照片级真实感、电影与编辑风格,以及带简短引文的平面设计风格。
模型概况
本次发布的是一个 33.1B 参数的 transformer,配套 4B 文本编码器、一个 VAE 和一个独立的提示词上采样器,bf16 下共 100 GB。它是对 MiniMax H3 的微调而非全新架构,因此继承了 H3 的 VAE 与注意力栈,并把训练预算花在静态图像而非视频上。
| 任务 | 文生图,以及使用 1 至 8 张输入图像的编辑 |
| 采样 | 8 步,无需 CFG 或负面提示词 |
| 分辨率 | 文生图为 8 MP,编辑为 4 MP 或 8 MP |
| 提示词上采样器 | 已包含,默认开启,基于 Qwen3.5-9B |
| 权重 | 33.1B transformer、4B 文本编码器、VAE、提示词上采样器 |
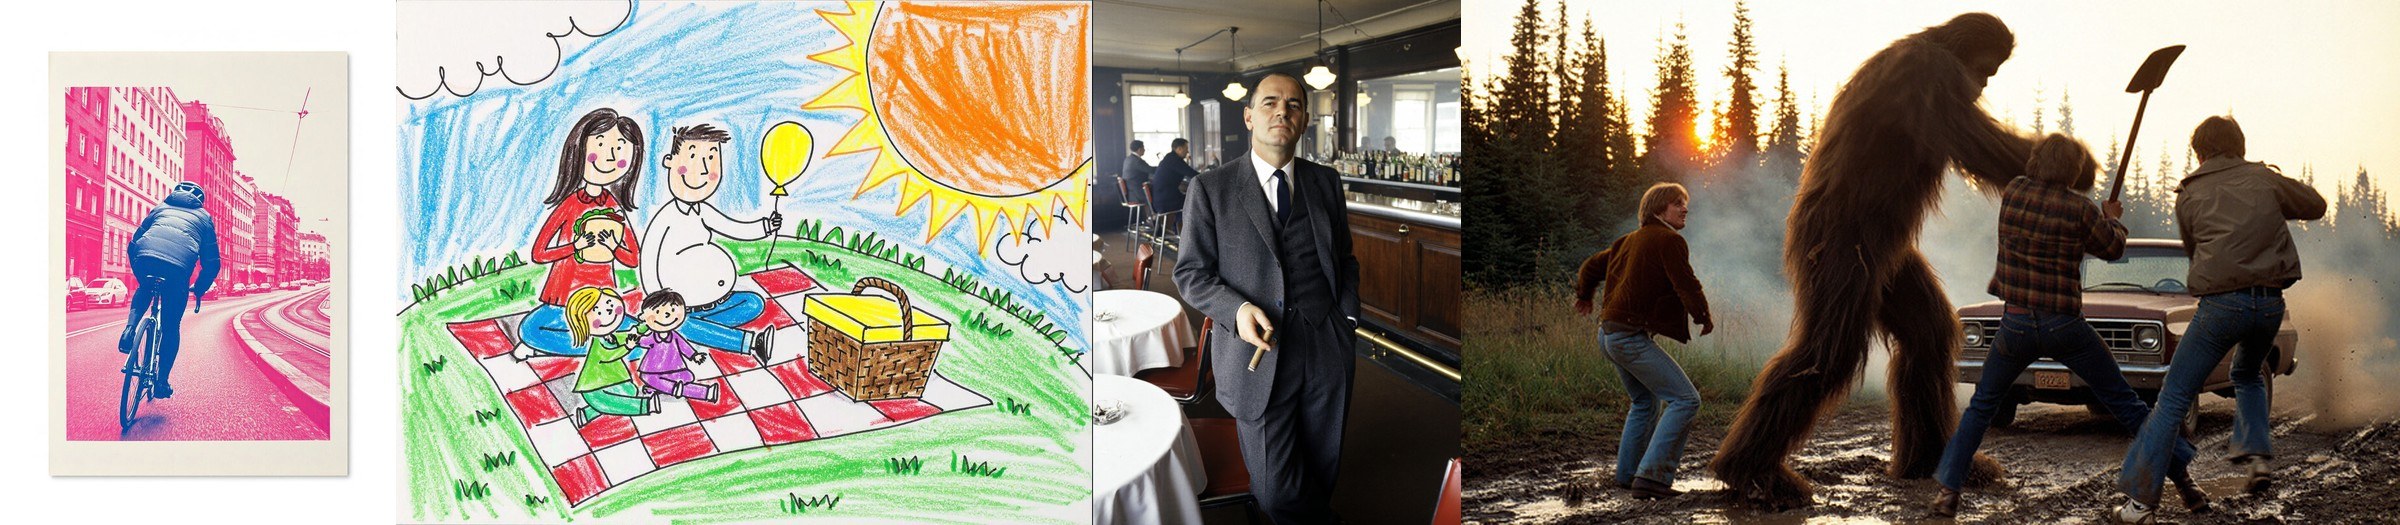
模型卡展示的风格覆盖范围,以 8 MP 渲染。
发布当天即获 ComfyUI 原生支持
ComfyUI 于 2026-11-03 通过 PR 17506(CORE-697)合并了 PH3Image 支持,同一天 PrunaAI 也将 update-for-launch 修订推送到权重。Comfy-Org/workflow_templates 中的两个官方模板都带有 minComfyUIVersion: 0.44.0,因此低于该版本的 ComfyUI 无法打开它们。
该节点图只使用内置节点:UNet加载器(Load Diffusion Model) 加载 checkpoint,MiniMax H3 Sigma Shift(ModelSamplingMiniMaxH3) 的两个 shift 都设为 1.0,类型为 minimax 的 加载CLIP(Load CLIP) 加载文本编码器,而新增的 p-h3-image 条件(p-h3-image Conditioning) 节点将提示词及任意图像转换为条件与图像 latent。采样使用 8 步网格上的 自定义Sigmas(ManualSigmas) 输入 高级采样器(Sampler Custom Advanced),搭配 基本引导器(Basic Guider) 和 euler,不使用 CFG,也不使用负面提示词。可选 LoRA 通过设为仅模型的 LoRA加载器 加载。
需要下载哪些文件
PrunaAI/P-H3-Image-Comfy 以 ComfyUI 原生格式镜像了权重,只要每个组件都取自同一行,各精度就可以自由混搭。MiniMax H3 本身的权重为 143 GB;最小的 P-H3-Image 组合是 20 GB 下载量,在 8 MP 下峰值显存为 21 GB。
| 组件 | 文件夹 | bf16 | int8 | w4a8 |
|---|---|---|---|---|
| 扩散模型 | diffusion_models/ | 40.5 GB | 21.2 GB | 13.4 GB |
| 文本编码器 | text_encoders/ | 9.1 GB | 5.1 GB | 3.6 GB |
| 提示词上采样器 | text_encoders/ | 19.3 GB | 9.7 GB | 6.7 GB |
| VAE | vae/ | 5.6 GB | 3.1 GB | 无 |
| 组合 | 下载大小 | 8 MP 峰值显存 |
|---|---|---|
| bf16 | 55 GB | 56 GB |
| int8 | 30 GB | 31 GB |
| w4a8 + int8 VAE | 20 GB | 21 GB |
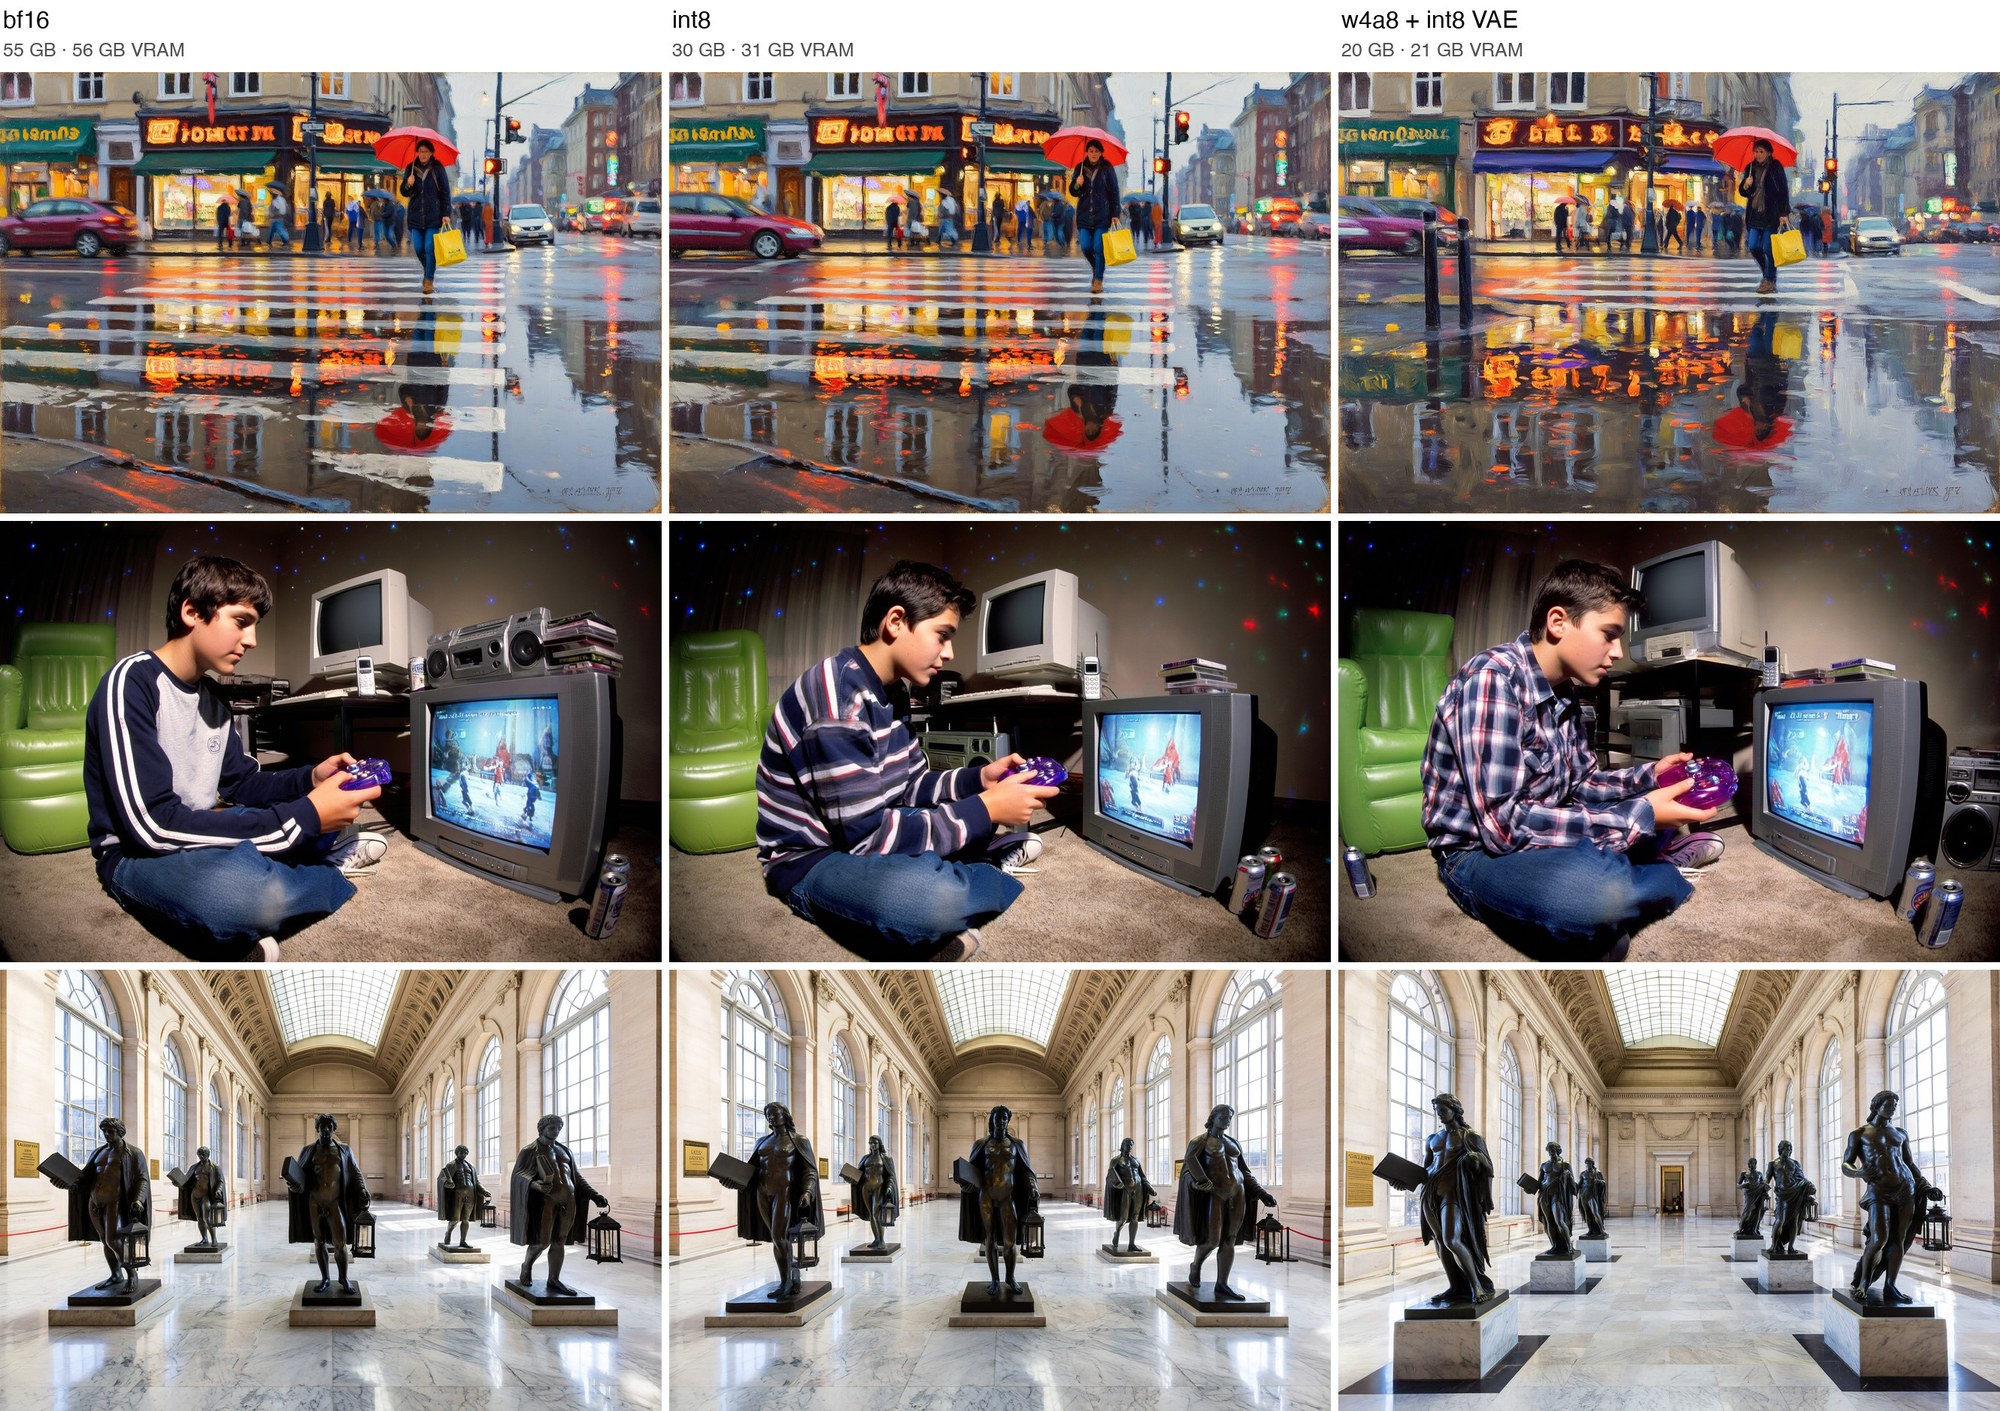
同一提示词与种子在 8 MP 下分别以 bf16、int8 和 w4a8 渲染,每个标题标明其下载大小与峰值显存。
int8 文件与 bf16 非常接近,常常几乎逐像素一致。w4a8 保留了质量,但会改变更多细节,有时也会改变构图。两者都是 ComfyUI 自有的量化格式:int8 对离群值施加分组 Hadamard 旋转,按行存储缩放系数,并在运行时量化激活值;w4a8 则将 4 位权重放在 16 级码本上,每 16 个输入配一个 FP8 缩放系数,并把敏感层保留为 int8。两者都不需要校准数据,且都运行在 comfy-kitchen 的 INT8 内核上,支持 NVIDIA Ampere 或更新架构以及 AMD RDNA3/4。
loras/ 中还有一个 2.0 GB 的 LoRA,它把相同行为应用到你自己已有的 MiniMax H3 权重上,而不是完整 checkpoint。仓库中的四个工作流里有两个就是围绕它构建的。
提示词上采样器是模型的一部分
P-H3-Image 渲染完整、具体的提示词的效果远好于简短请求,因此每个示例工作流都会先运行上采样器。在 ComfyUI 中它同样不是自定义节点:类型为 minimax 的 加载CLIP 加上使用贪心解码的 TextGenerate(Generate Text),因此同样的请求总是产出同样的提示词。
对于文生图,格式化文本(Format Text) 会在两行上组合 Aspect ratio: 1:1 和 Request: ...,并开启 thinking。对于编辑,它会为每张图像写入一个 <Picture N> 块,其中 image_1 为 1 MP,参考图通过 批量图像(Batch Images) 填充到该尺寸。把 Use prompt upsampler 的 If/Else 切换设为 false,即可将请求原样发送给模型。
上采样器在扩散模型之前运行,当 P-H3-Image 需要内存时 ComfyUI 会把它移出显存;其输出会被缓存,只有当请求或图像发生变化时才会再次运行。bf16 上采样器是推荐选择,大小为 19.3 GB,约需 21 GB 显存。
最多八张图片的编辑
一次编辑会把要修改的图像作为 image_1,再加上最多七张参考图,它们在 批量图像 中和条件节点上的顺序必须一致,并在上采样器输入中为每张图提供一个 <Picture N> 块。请求可以用任何方式指代它们,因此“第二张照片里的帽子”会解析到第二张图像。只有图片 1 会被编辑,其余仅作为上下文。
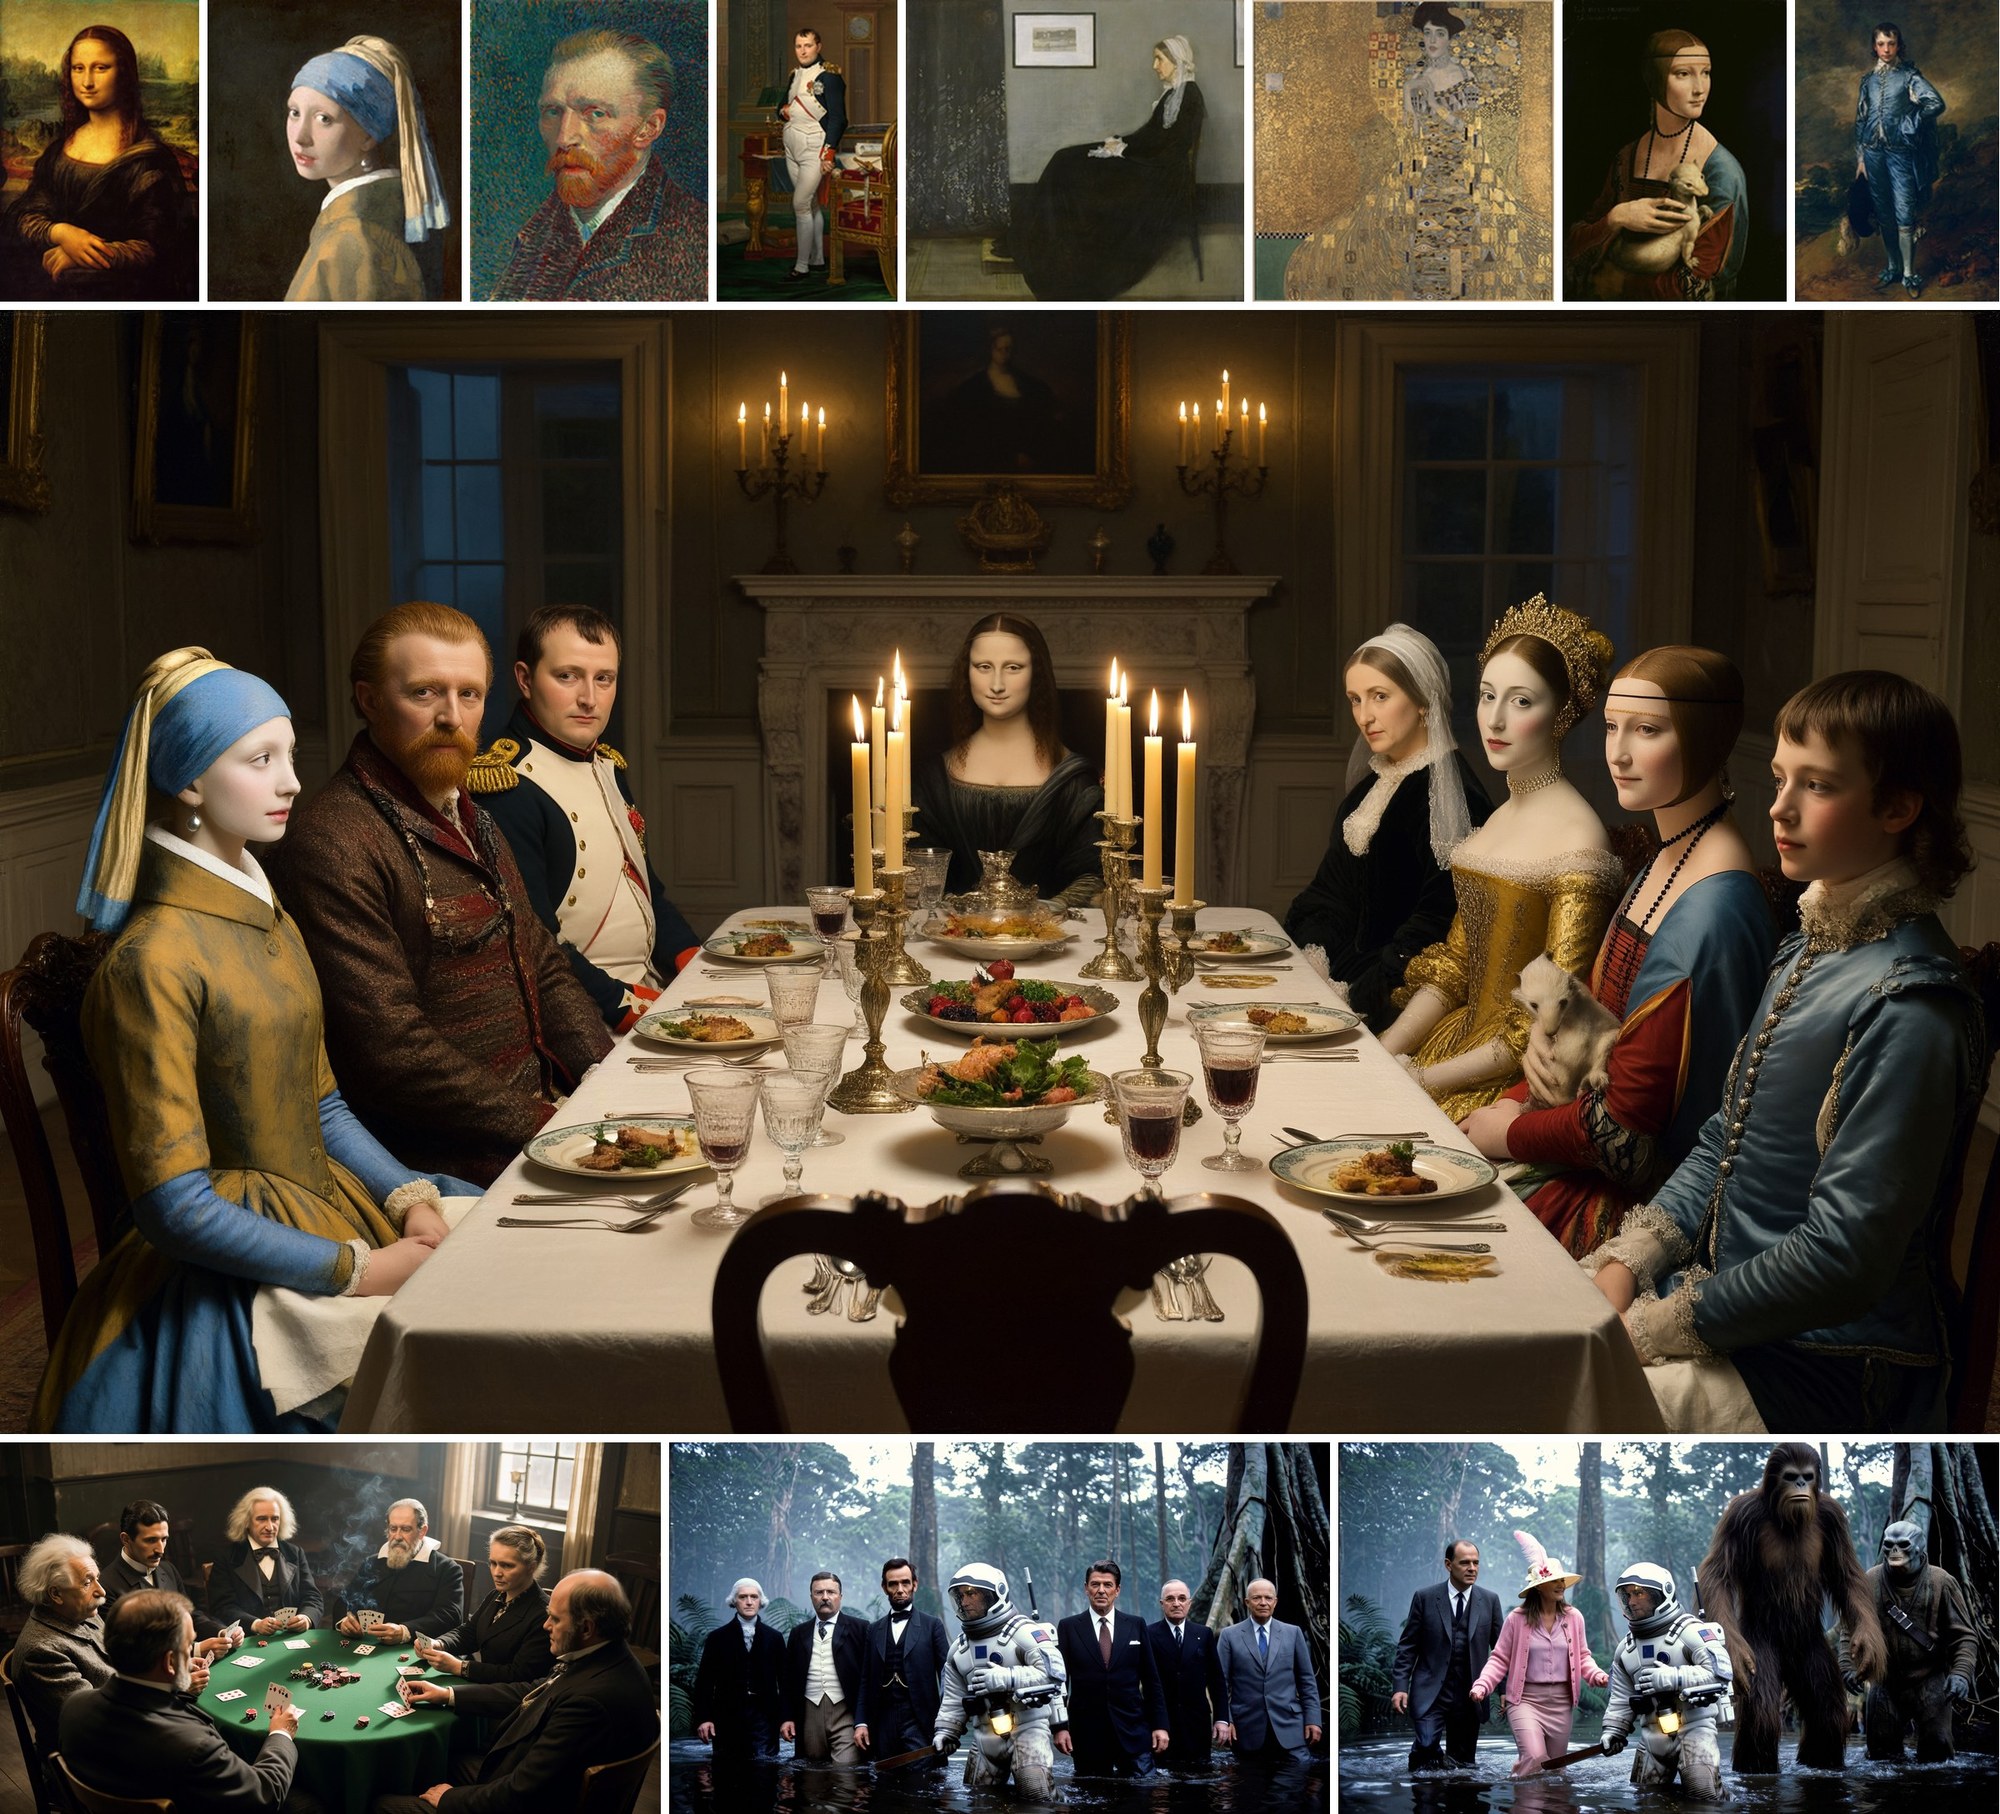
八张公有领域肖像,以及 P-H3-Image 在一次请求中由此合成的晚宴场景。
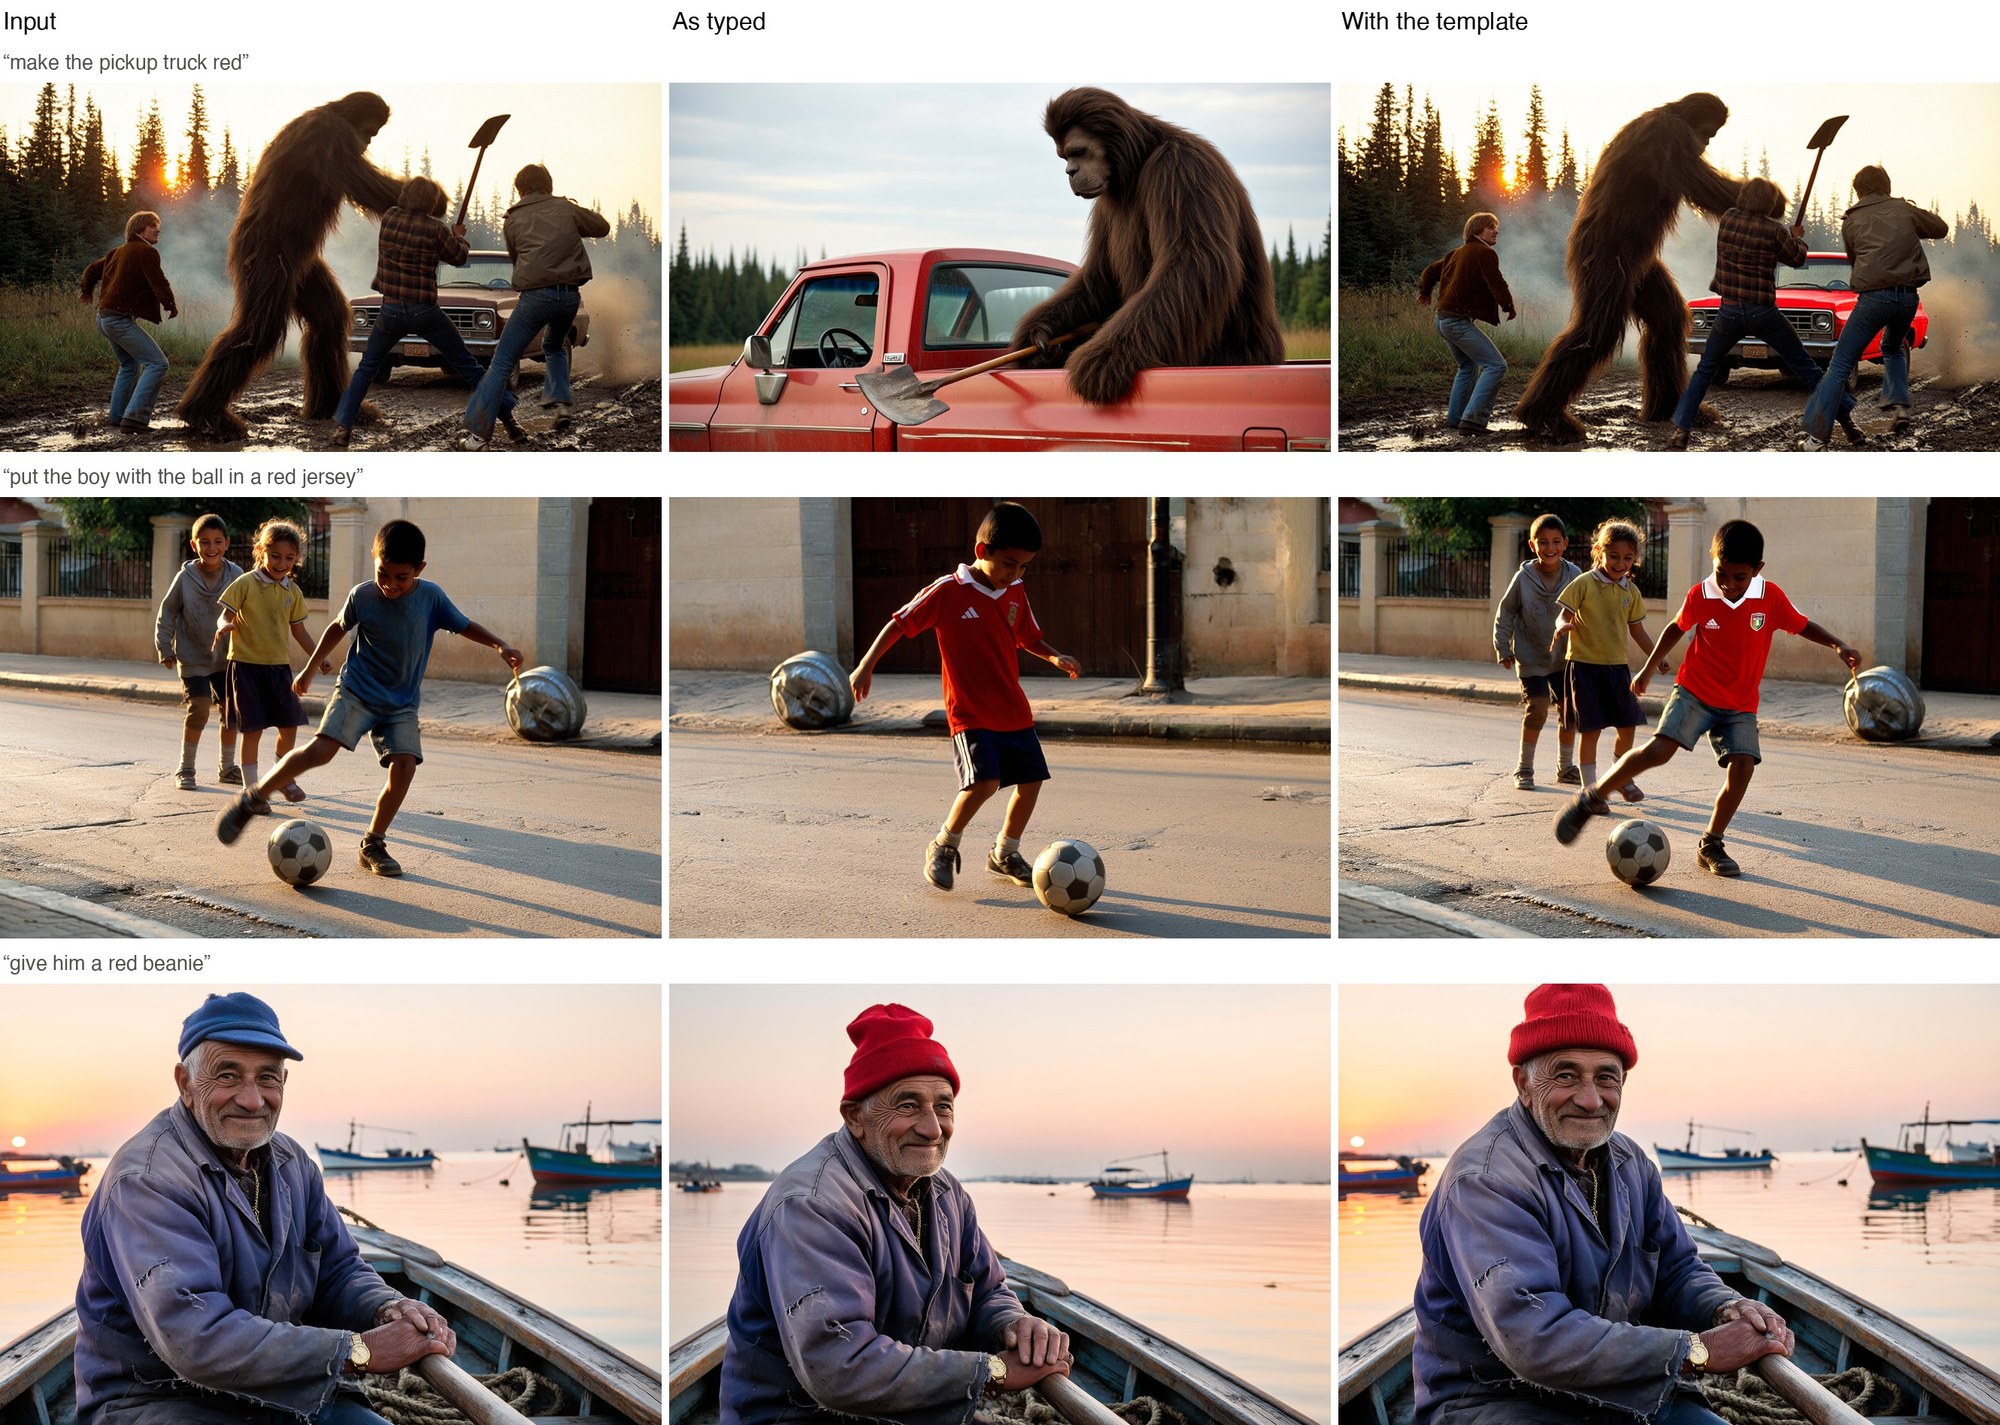
官方模型卡中的编辑输出。
8 MP 是最佳工作点
模型是按 8 MP 训练的,模型卡也直言 2 MP 和 4 MP 效果更差,瑕疵在面部、手部和小细节上最为明显。默认文生图尺寸为 2912 x 2912,各边会取整到 32 的倍数。
| 宽高比 | 8 MP(宽 x 高) | 4 MP(编辑用) |
|---|---|---|
| 1:1 | 2912 x 2912 | 2048 x 2048 |
| 4:3 | 3360 x 2496 | 2368 x 1760 |
| 3:4 | 2496 x 3360 | 1760 x 2368 |
| 3:2 | 3552 x 2368 | 2496 x 1664 |
| 2:3 | 2368 x 3552 | 1664 x 2496 |
| 16:9 | 3872 x 2176 | 2720 x 1536 |
| 9:16 | 2176 x 3872 | 1536 x 2720 |
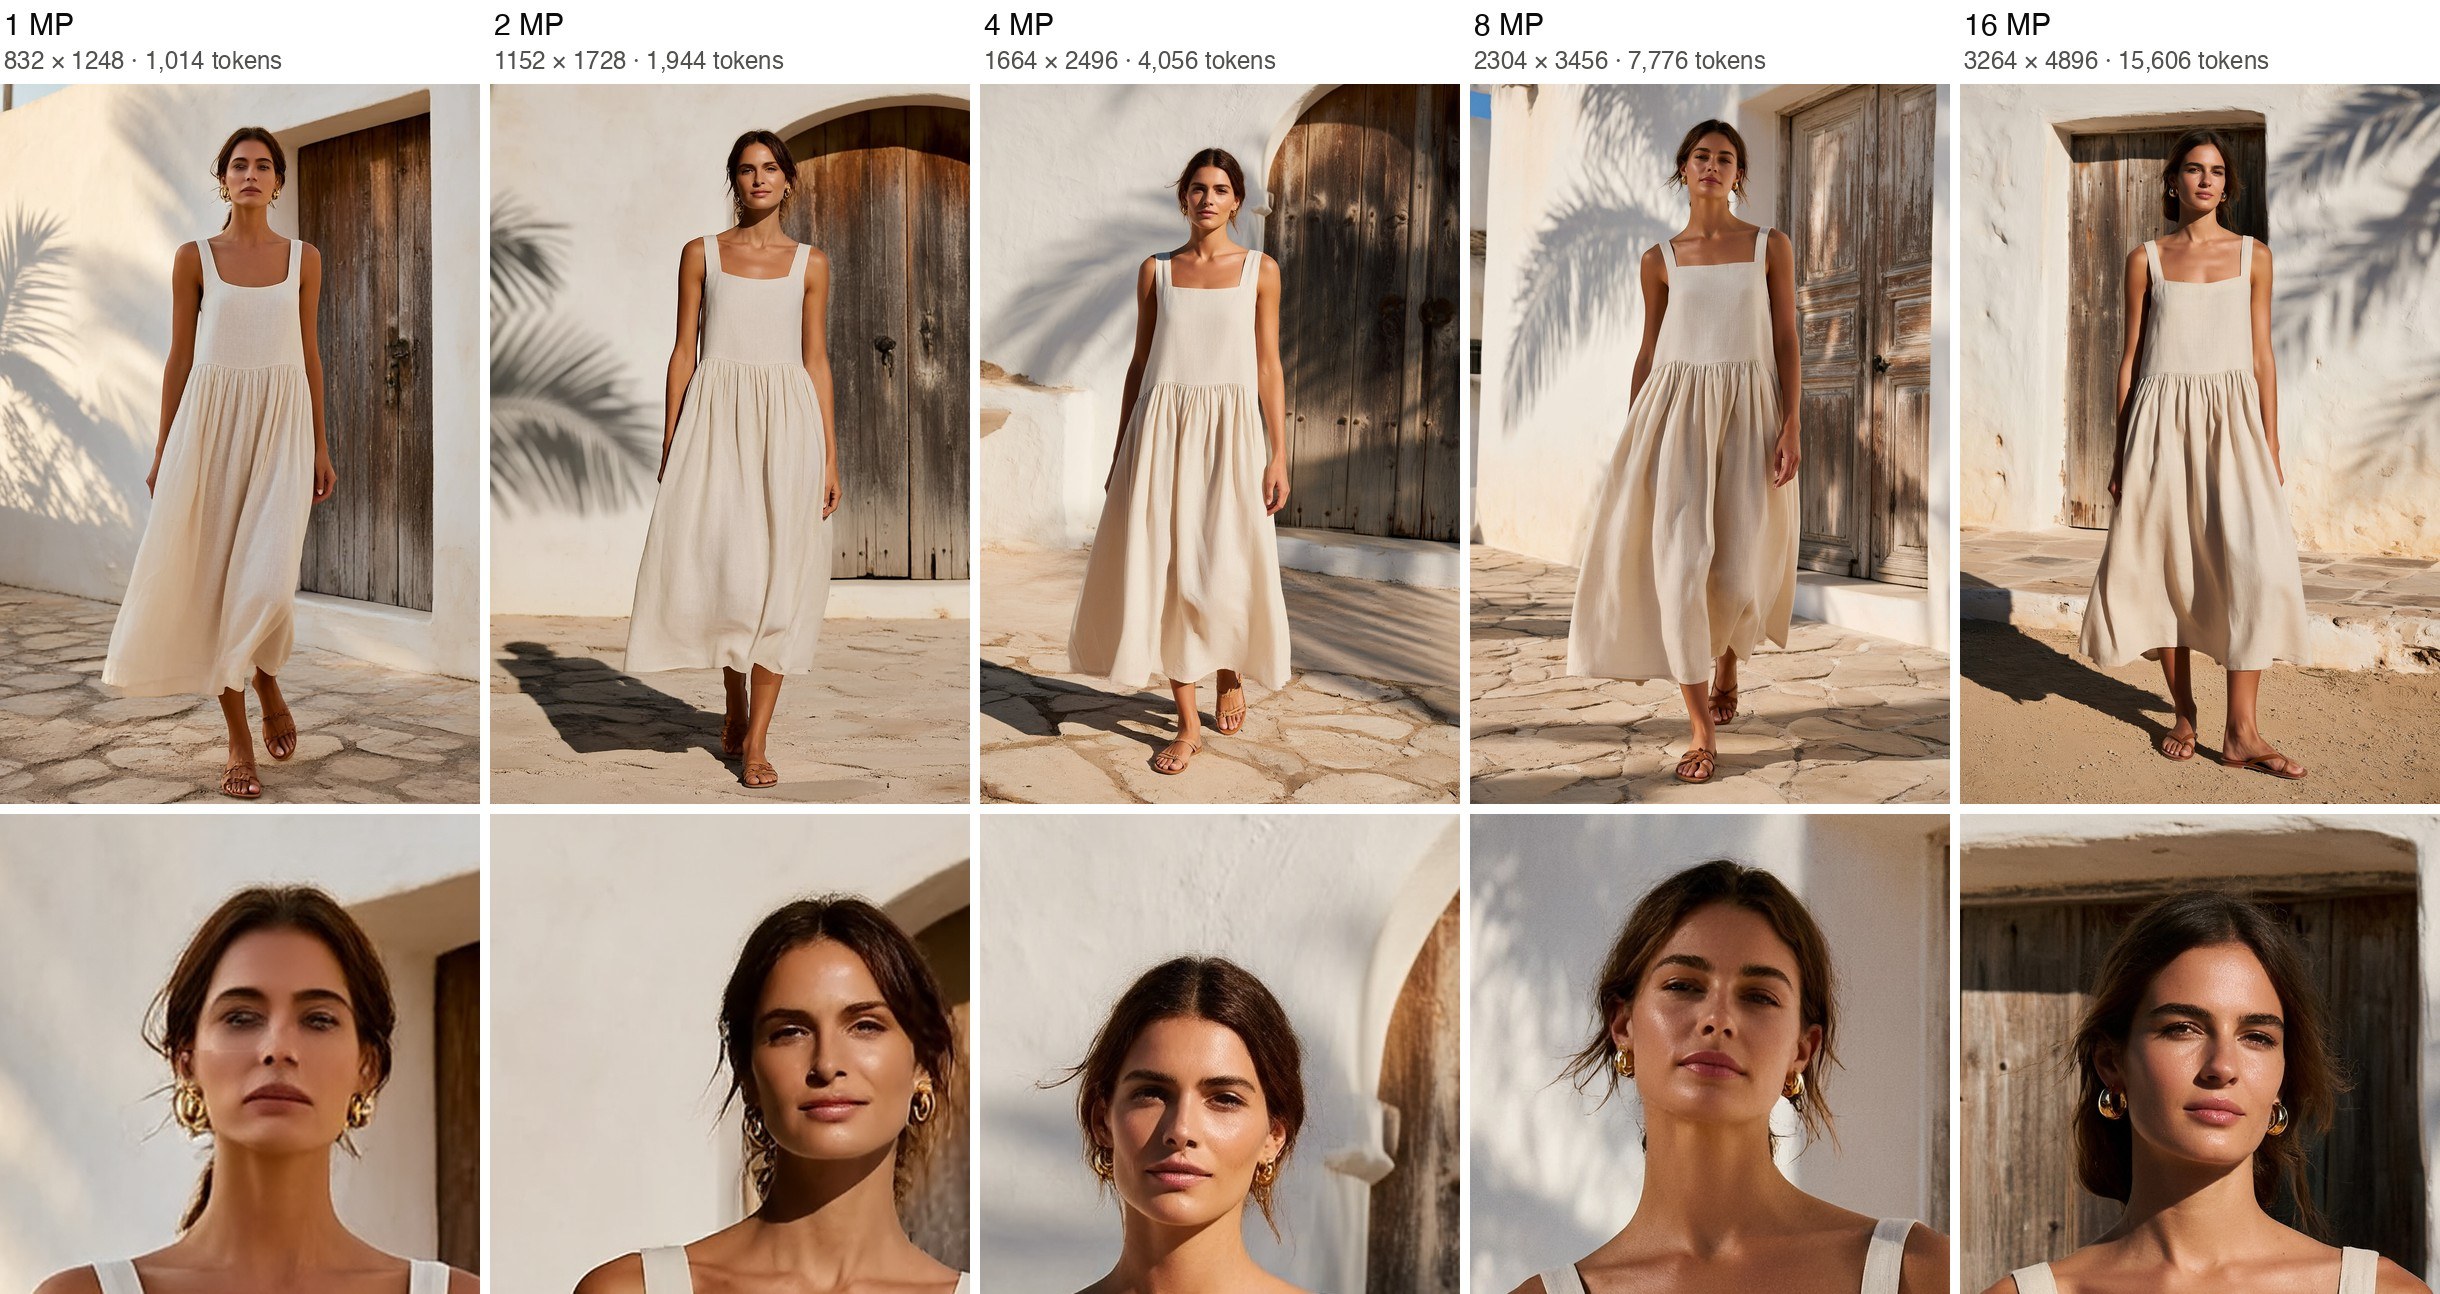
同一提示词与种子在 1 至 16 MP 下的结果,面部已放大。1 MP 时皮肤光滑如蜡;从 8 MP 起,纹理、飞散的碎发和耳环都能呈现出来。
未指定宽高的编辑会按图片 1 的尺寸生成,并放大到至少 4 MP。传入这两个尺寸改变的是画布大小,而不是画布内的图像。
获取方式
- 权重与 diffusers pipeline:PrunaAI/P-H3-Image
- ComfyUI 文件与工作流:PrunaAI/P-H3-Image-Comfy
- 浏览器演示:PrunaAI/P-H3-Image,位于 Hugging Face Spaces
- ComfyUI 支持:PR 17506,包含于 v0.44.0
评论
使用 GitHub 登录后即可参与讨论。