Krea 3 技术报告:8 张参考图编辑在 8 秒内完成
Krea 3 可基于最多八张参考图像以原生 2K 分辨率编辑图像,8 秒内完成,单张成本 $0.06。在 ComfyUI 中通过 Krea 3 Image 节点即可使用。
这是该模型首份公开的技术文档。报告涵盖模型架构、图生图训练流程、基于编辑奖励的强化学习以及推理优化,并为发布时宣称的速度与价格给出了实测数据。
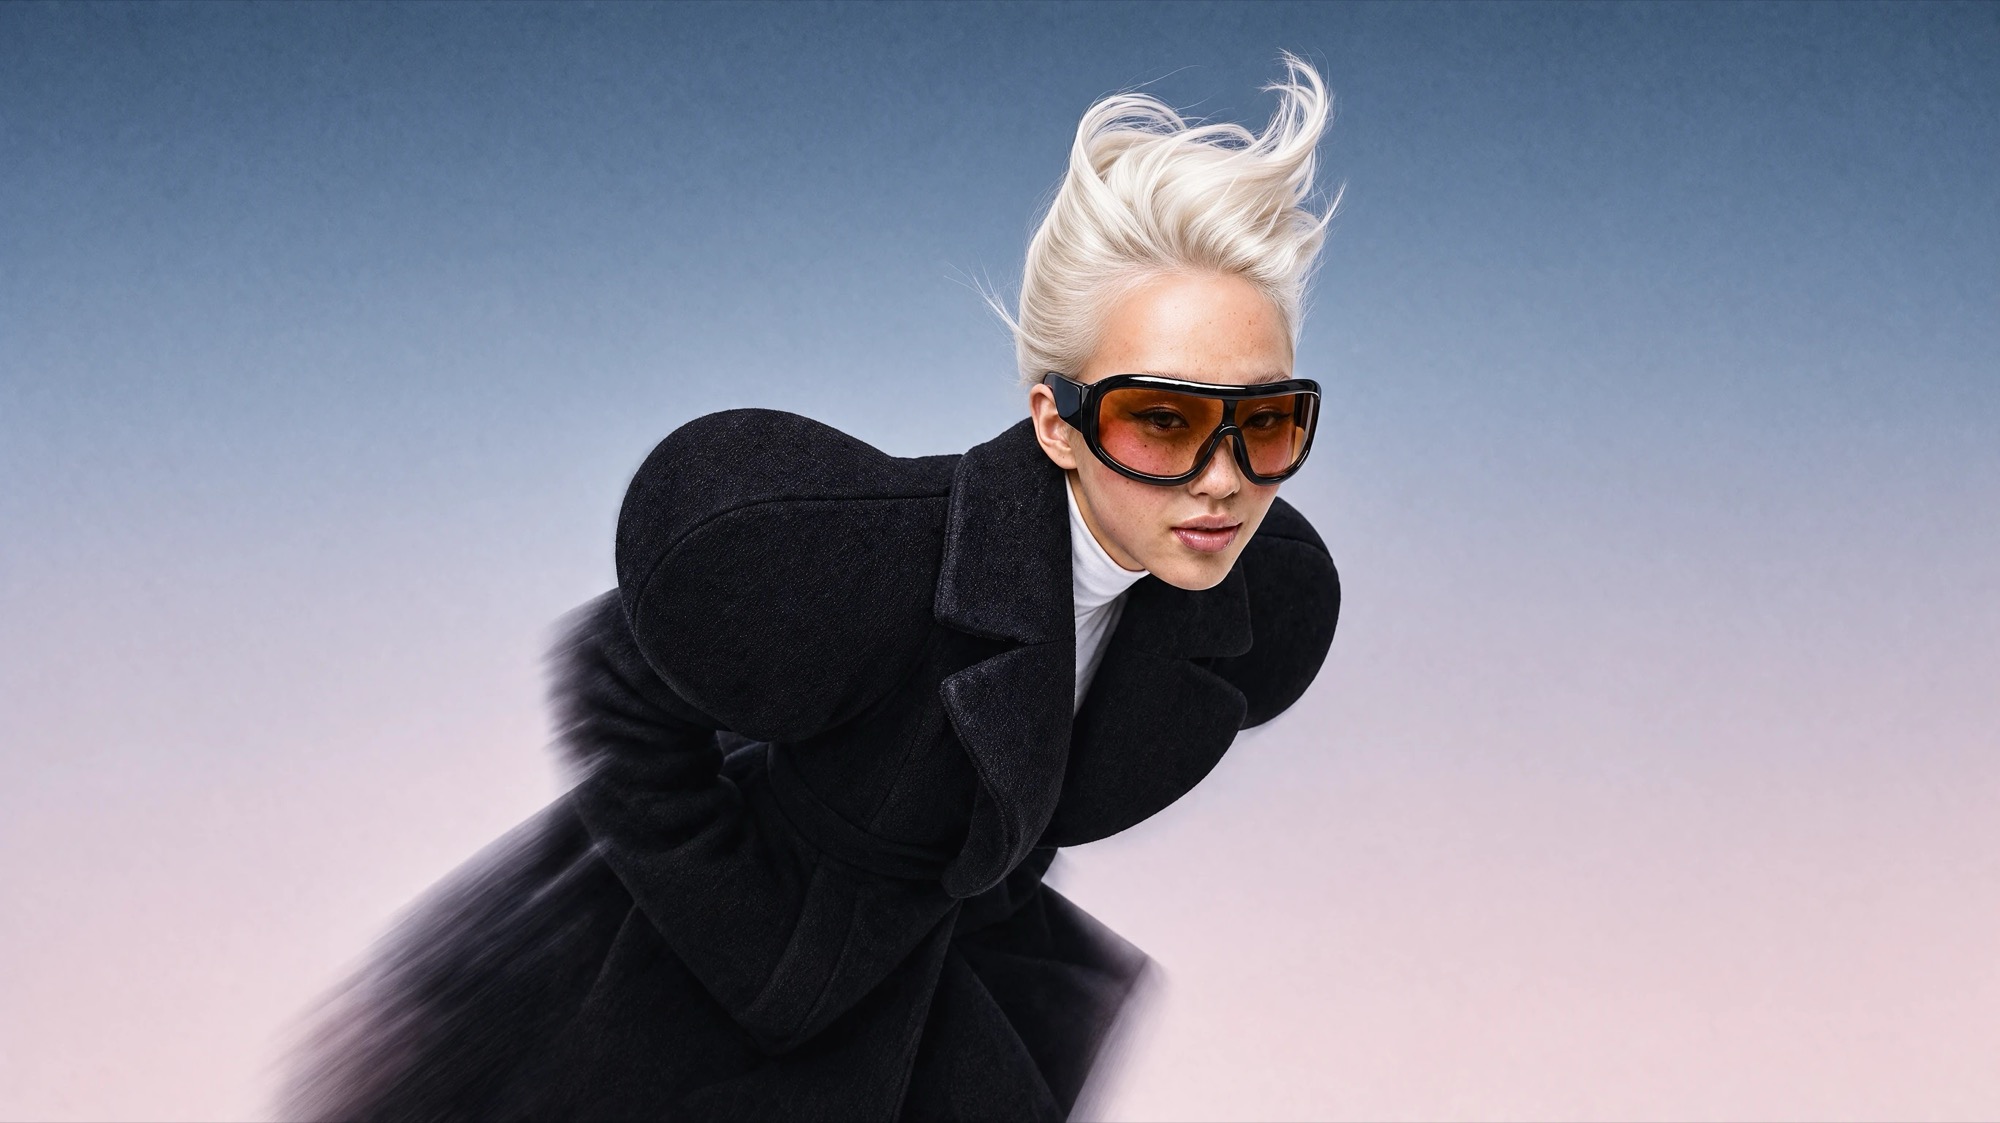
来自 Krea 模型页面的 Krea 3 输出。
关键数据
| 每次编辑耗时 | 在 Krea 生产流量中低于 8 秒;报告中给出 Nano Banana Pro 完成同类编辑需 20 到 40 秒 |
| 价格 | 每张图像 $0.06,见 Krea 定价页 |
| 榜单 | 在 Arena 的多图编辑榜上以 1,435 分位列第 4(Krea 3 Ultra),在 Artificial Analysis 图像编辑榜和 Design Arena 上同样位列第 4 |
| 参考图像 | 单次生成最多 8 张,每张图像的分辨率可独立选择 |
| 输出 | 原生 2K,可选 1K |
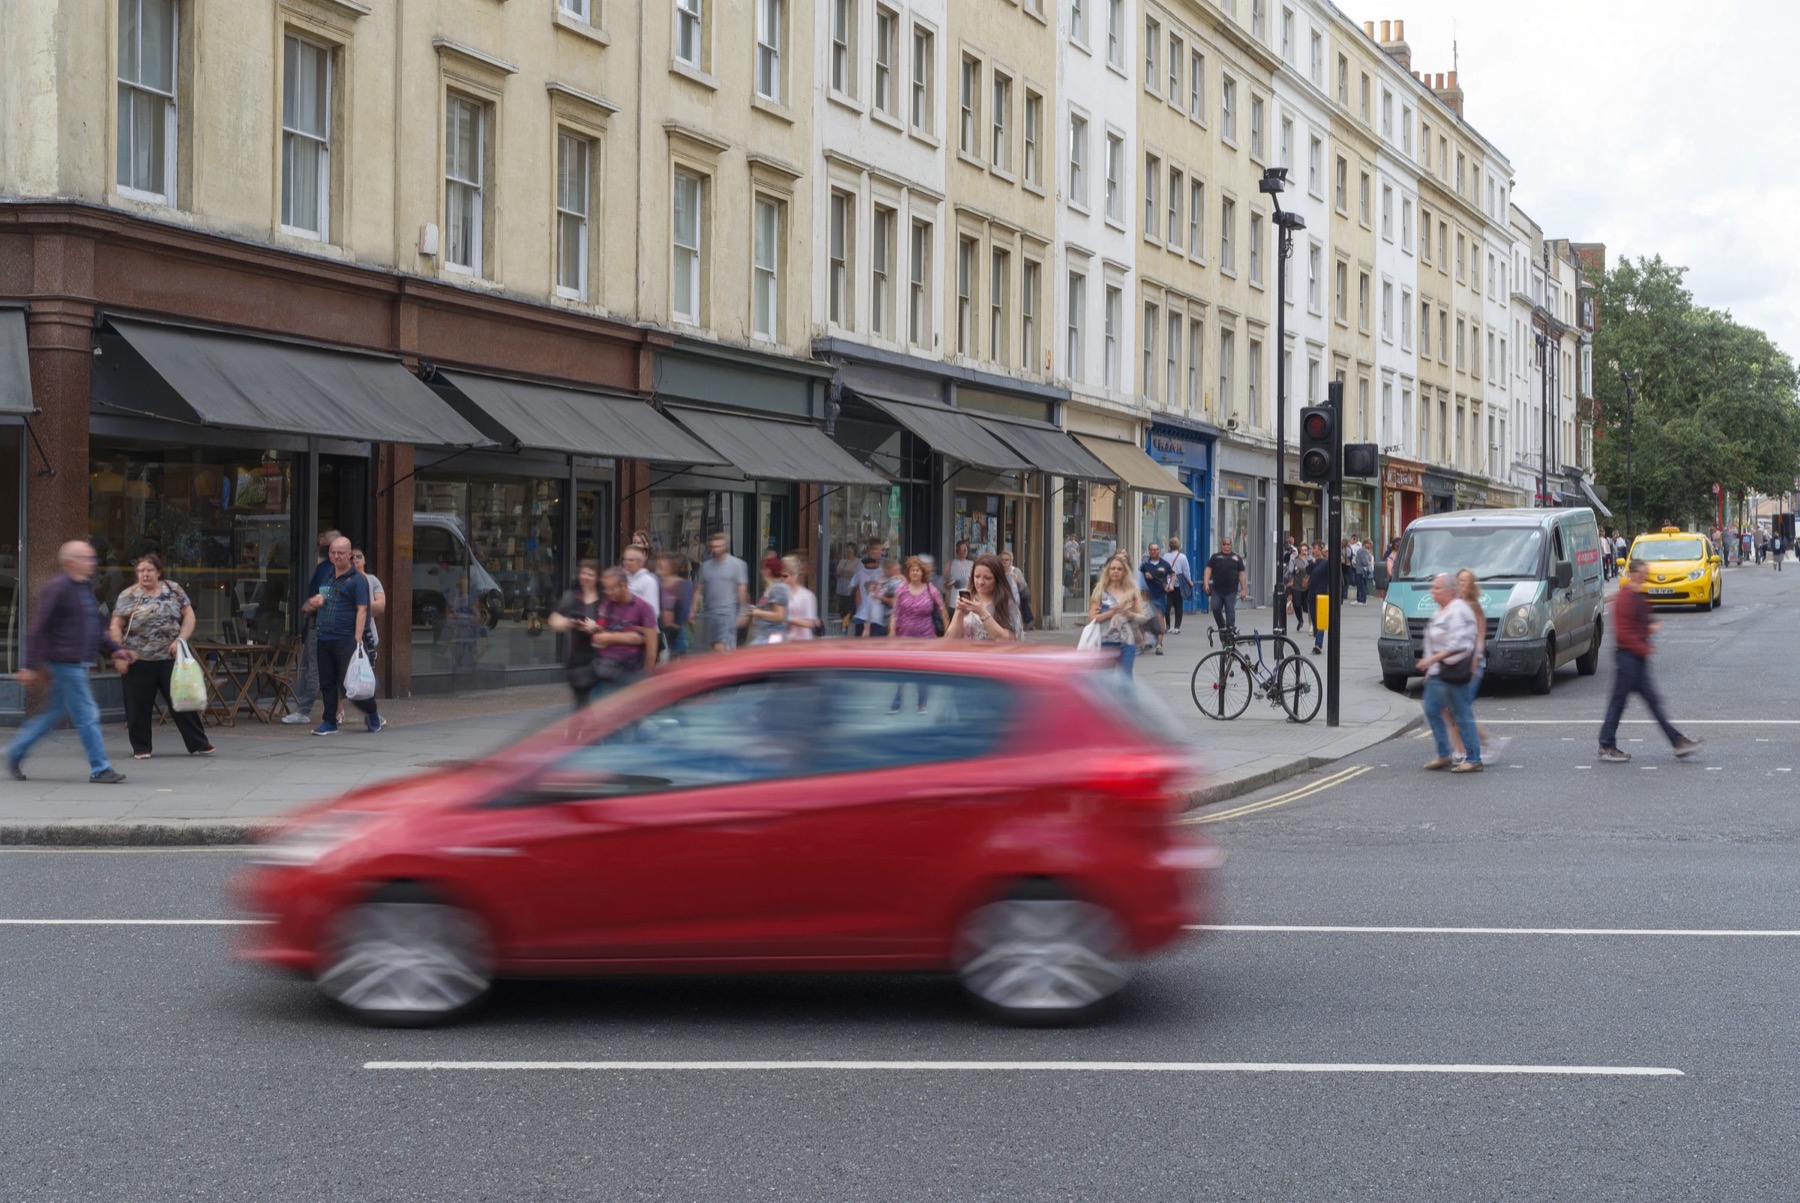 | 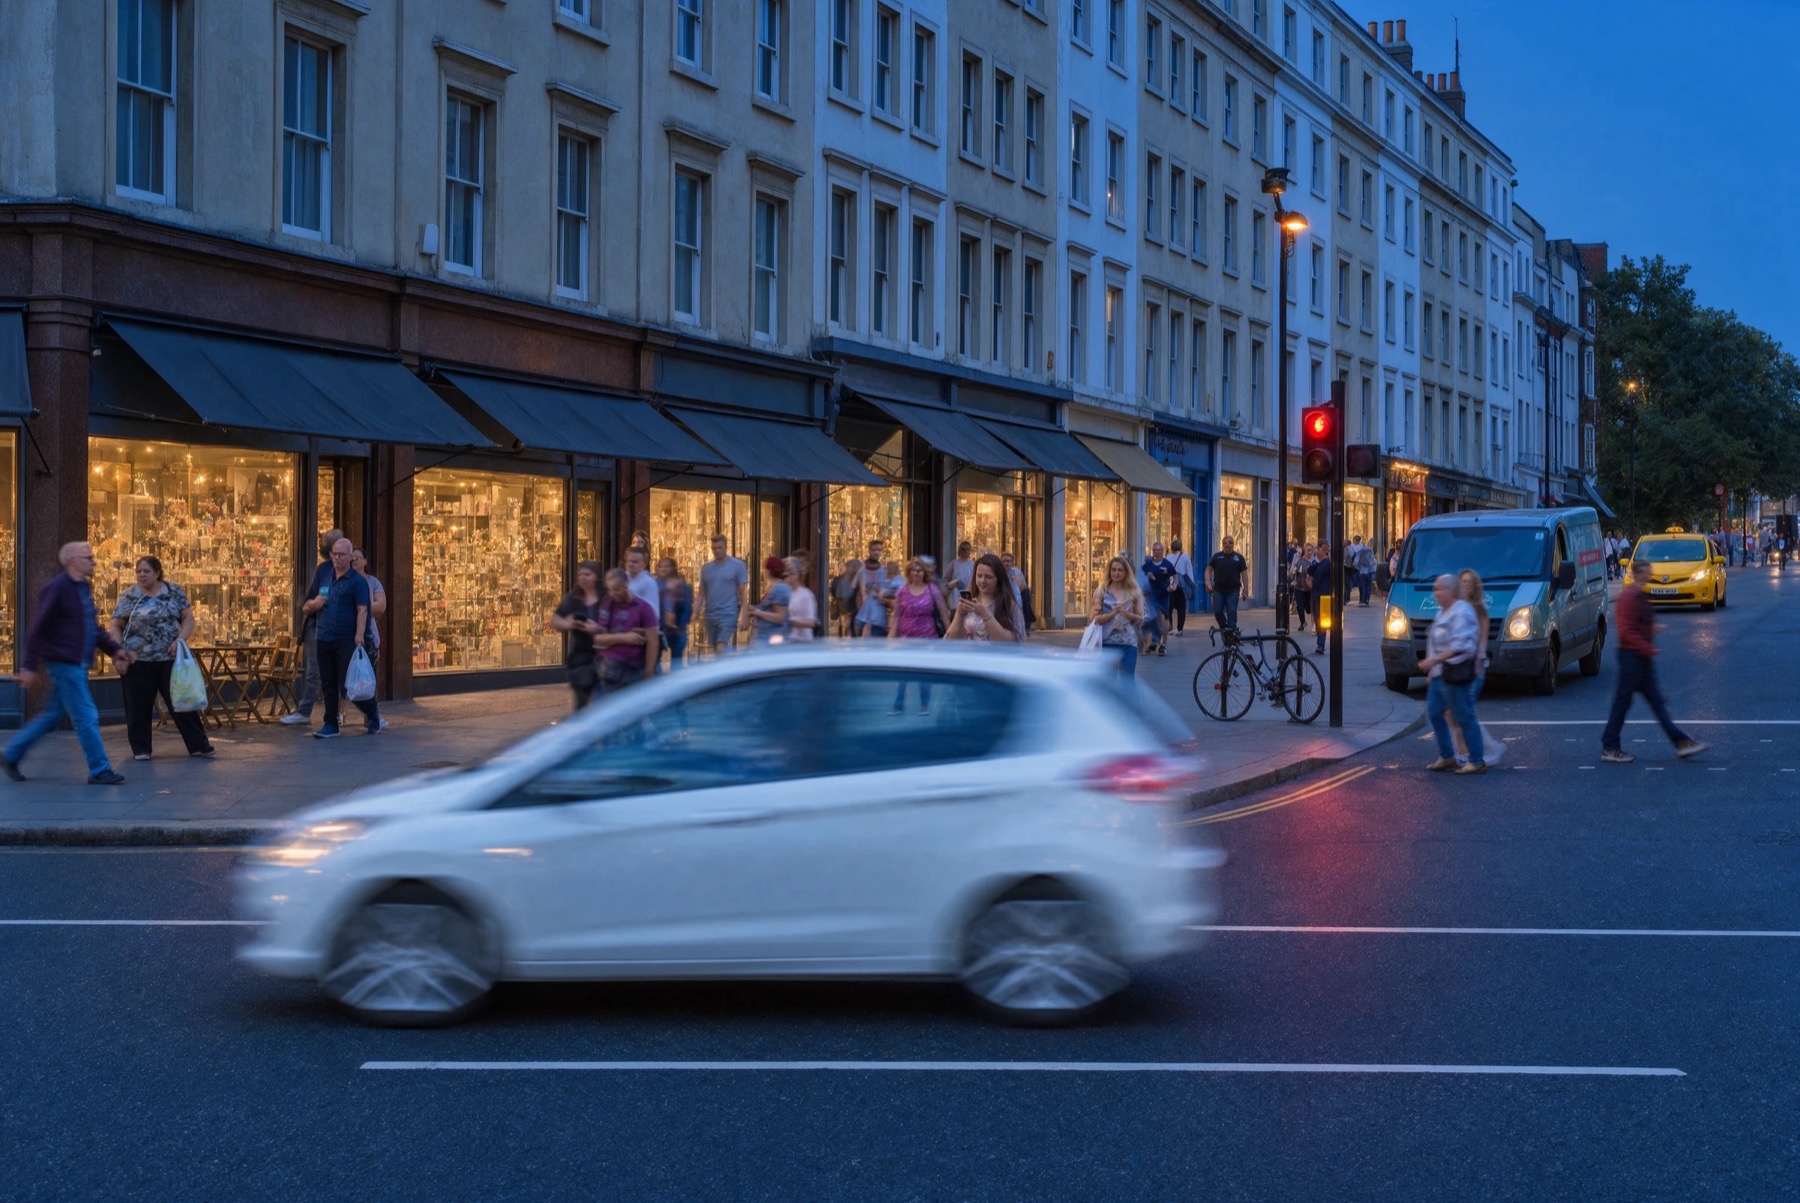 |
|---|---|
| 输入 | 一条指令:同一街道的蓝调时刻,车辆重新上色 |
构建方式
Krea 3 从 Krea 2 的预训练模型出发,将其扩展到图生图。参考图像经 VAE 编码后,作为时间步 0 的干净 token 追加到 DiT 的 latent 序列中,从而保持在分布内,并使其键值对可在推理时缓存。一个视觉语言文本编码器以 384² 分辨率同时读取参考图像与指令,只有指令 token 会进入 DiT。
训练中加入了参考分辨率与目标分辨率的解耦采样以及按长度分桶的打包,使同一批次可以混合不同的参考数量与原生 2K 目标。后训练阶段采用针对智能体式奖励框架的强化学习,随后进行偏好优化。
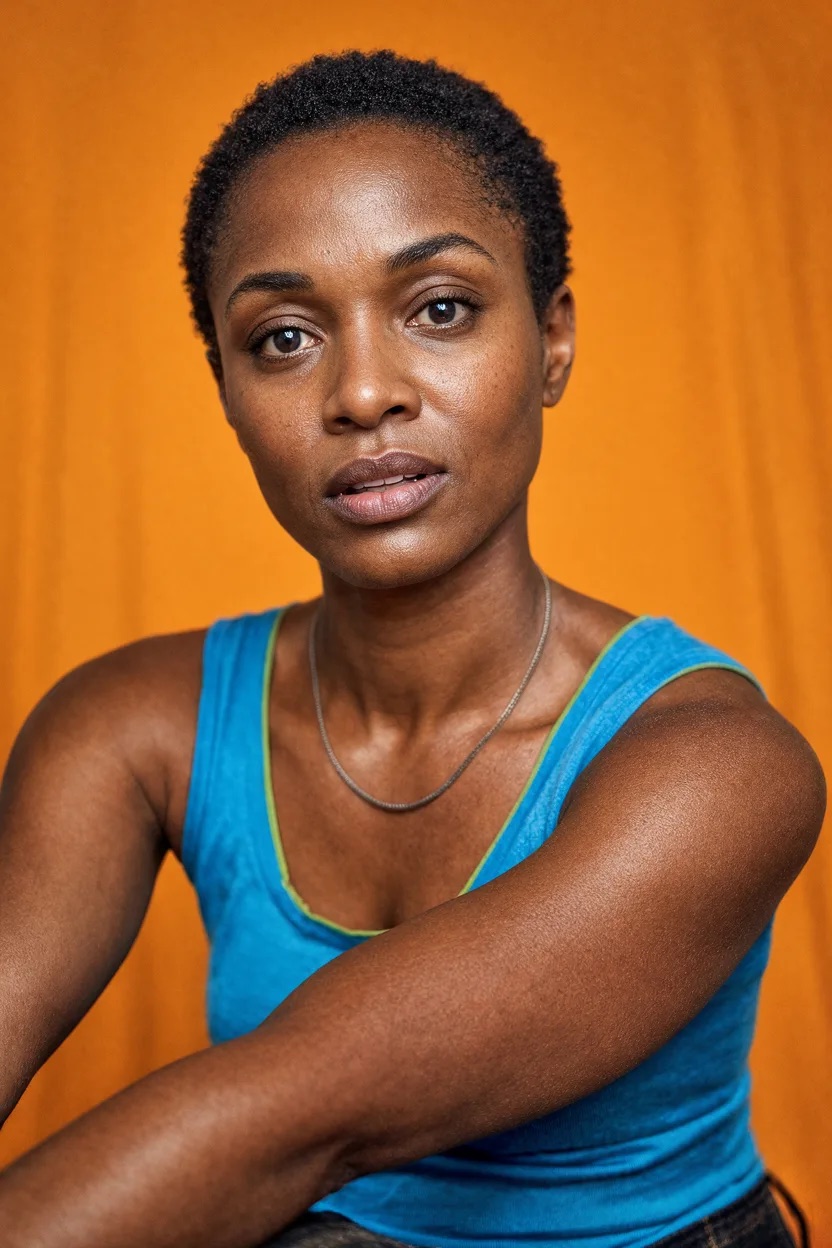 | 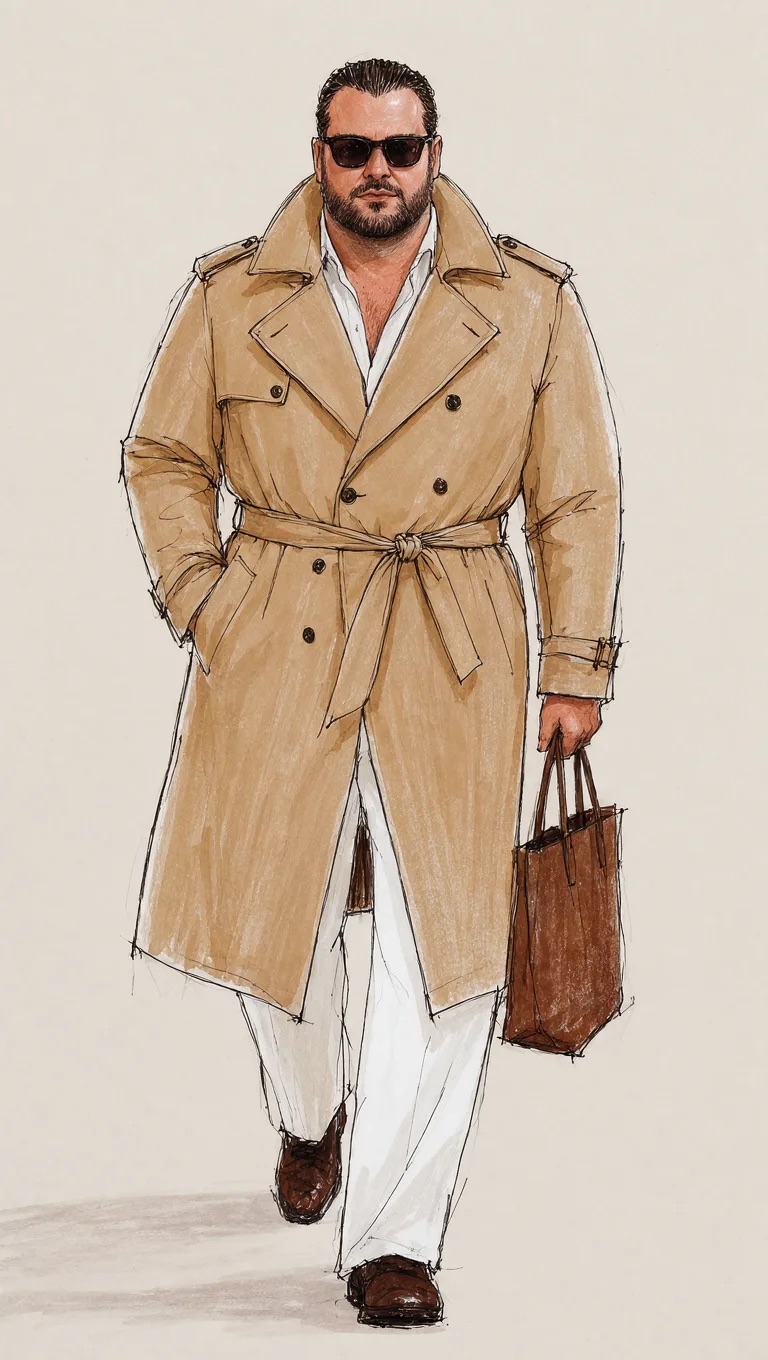 | 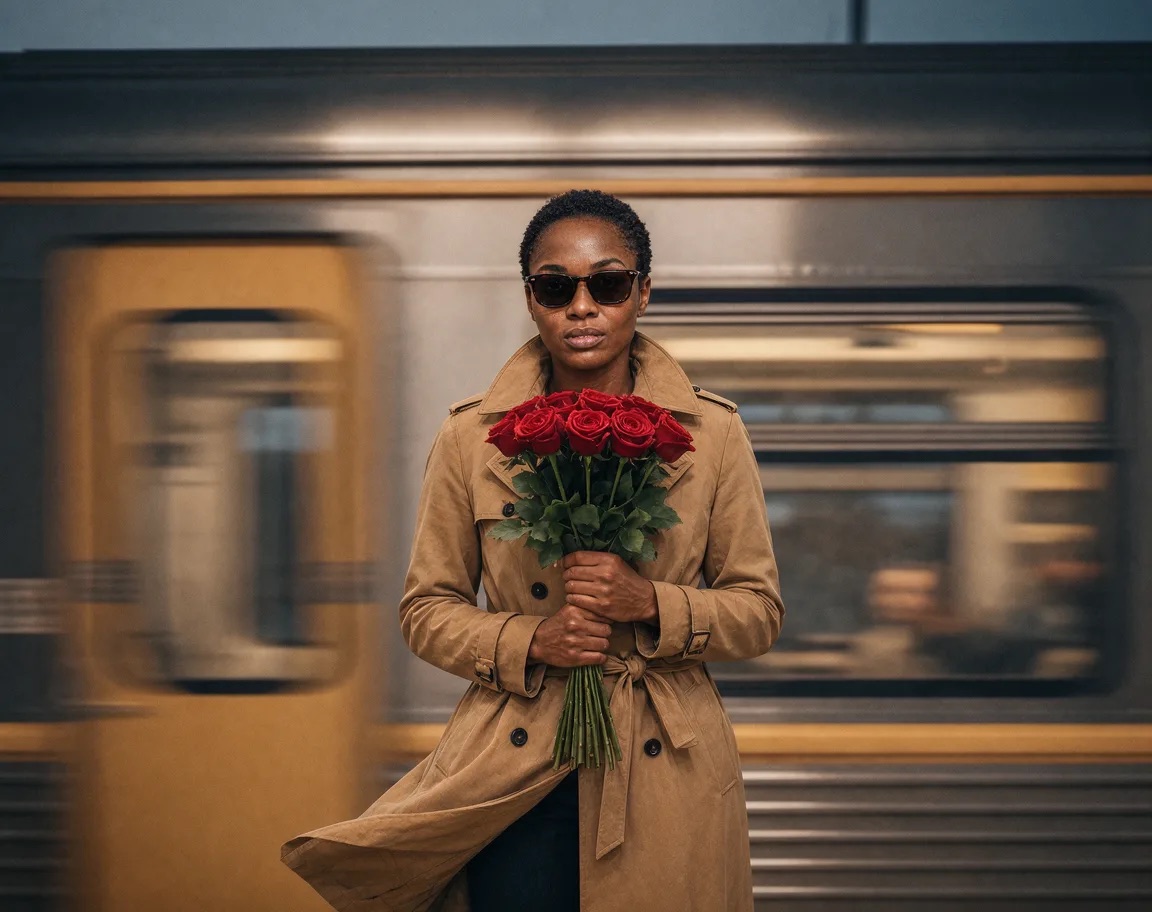 |
|---|---|---|
| 输入 1 | 输入 2 | 输出:人物身份来自输入 1,服装来自输入 2 |
在 ComfyUI 中使用
Krea 3 Image 节点已于 2026 年 10 月 15 日随 PR #17067 发布,位于 partner/image/Krea 分类下。它最多接受八张图像,按顺序连接,并在提示词中以 @Image1、@Image2 等引用。留空输入即为文生图。
| 输入 | 作用 |
|---|---|
resolution | 1K 或 2K,默认 2K |
thinking_mode | fast(Krea 推荐)、high(复杂编辑时进行更多规划)、ultra(生成多个候选并返回最佳结果;需要参考图像,始终输出 2K,不支持精确编辑) |
precise_edit | 保持编辑区域之外的内容不变;至少需要一张图像 |
aspect_ratio | auto,或从 1:1 到 21:9 的固定比例 |
seed | Krea 会在生成前重写提示词,因此相同的种子不会生成相同的图像 |
运行按图像计费,每接入一张参考图像还会额外收费:1K fast 约 $0.043,2K fast 为 $0.086,2K high 为 $0.114,ultra 为 $0.372,另外每张参考图像约 $0.03。
不足之处
报告本身指出了两个薄弱环节。密集的小号文字仍不够完美,而且身份在链式编辑中会漂移:Krea 表示计划以 LoRA 作为处理角色的主要途径,而非仅依靠提示词编辑。
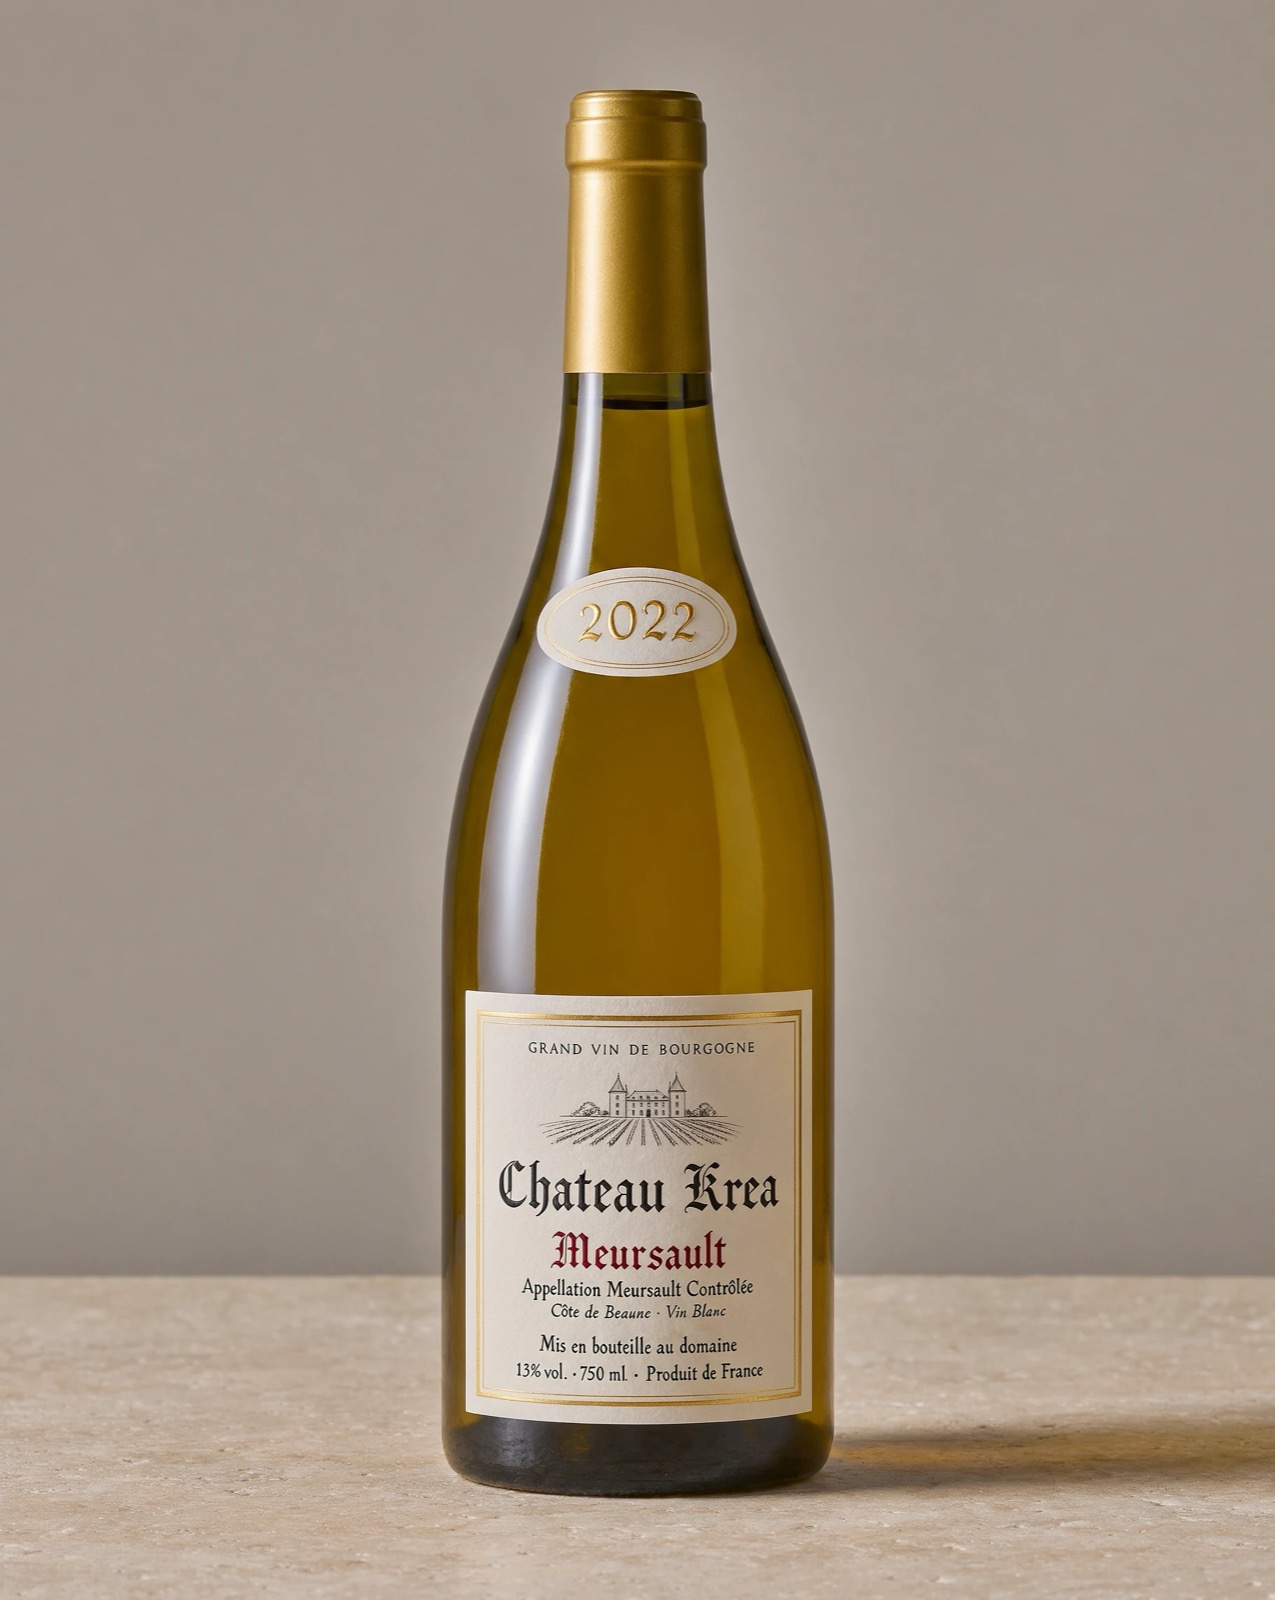
局部编辑:只有酒标发生变化,酒瓶、酒杯和光线保持原样。
评论
使用 GitHub 登录后即可参与讨论。