Idol Turbo 将图生 3D 压缩到五个无引导步骤
Idol Turbo 将 Speridlabs Idol 从 50 个引导步骤蒸馏为五个无引导步骤,网络评估次数从 100 次降至 5 次,两个分阶段 LoRA 可直接放入 ComfyUI Idol 重打包版本。
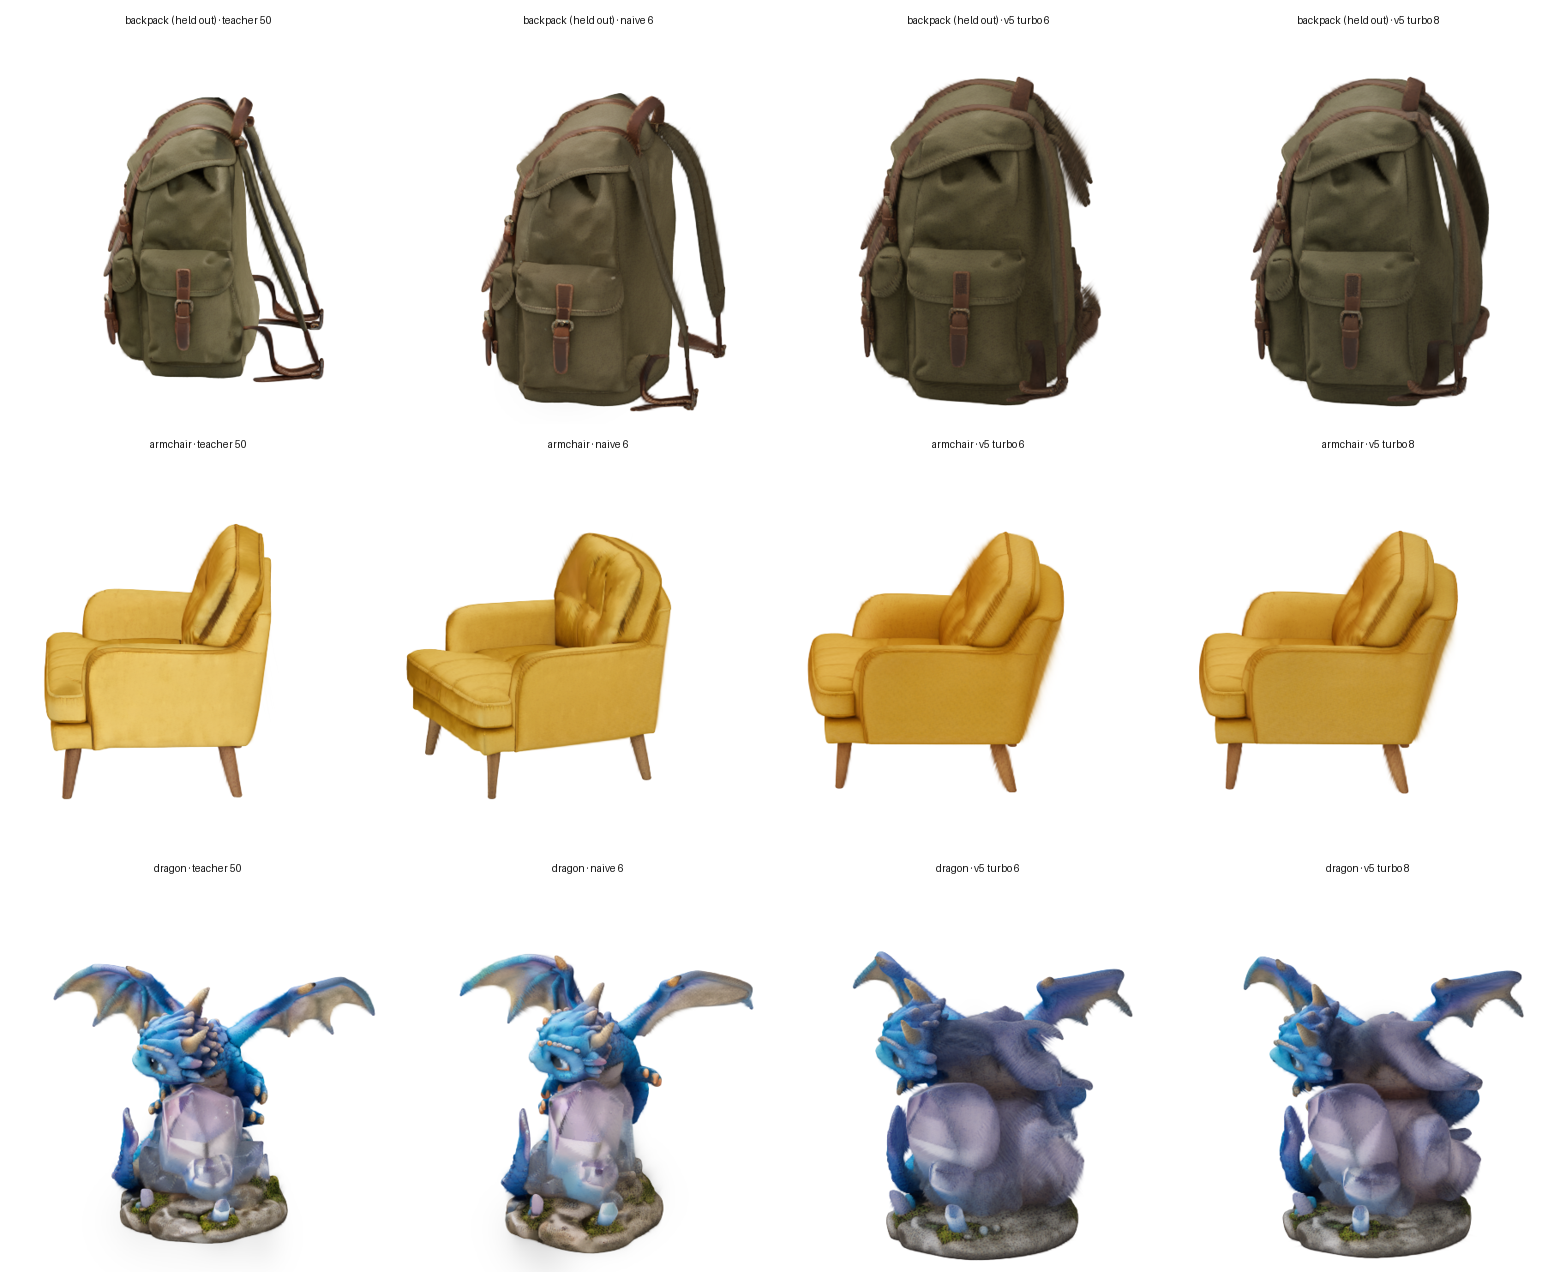
输入、带 CFG 的 6 步基础模型,以及蒸馏学生在 6 步和 8 步下的结果。相同输入、相同种子、正交 splat 渲染。
变化之处
Idol 的 flow-matching 去噪器未作任何改动。作者添加的是两个低秩专家,通过对教师模型经 CFG 合成的速度做回归训练,从而把无分类器引导折叠进权重中,第二次重复前向随之消失。大部分节省正来自这里:50 步乘以 CFG 3.0 下的两次评估等于 100 次网络调用,而学生模型只需要 5 次。
- 方案:Glance 风格的分阶段 LoRA(arXiv 2512.02899),两个 rank-32 专家,一个用于高噪波阶段的 Slow-LoRA 和一个用于低噪波阶段的 Fast-LoRA,在 t = 0.5 处切换。
- 可训练规模:两个专家合计 2940 万参数。
- 训练集(v5):4,650 条教师记录,即 93 张单对象图像上的 50 步 CFG 3.0 轨迹,2,000 步,在一块 H200 上约 25 分钟。
v5 这个标签很关键。更早的模型只用 10 张图像训练,对与该集合差异较大的对象泛化很差;更宽的分布正是本次发布的意义所在,展示中的背包在训练时被留出。
五个对象,每个三栏:输入、turbo 5 步、带 CFG 的基础模型 5 步。
在 ComfyUI 中使用
两个 ComfyUI 格式的 LoRA 已针对 Comfy-Org/Idol 验证:模块路径完全一致,权重已按强度 1.0 预先缩放。将 idol_turbo_slow_comfy.safetensors 和 idol_turbo_fast_comfy.safetensors 放入 models/loras/,与重打包版本的 diffusion model、DINOv3 CLIP vision、VAE 和解码器放在一起,然后设置 5 步、CFG 1.0。
分阶段切换有两种接线方式:
- 两阶段:在
KSampler (Advanced)中用 slow LoRA 运行五步中的前四步,开启add_noise,然后用 fast LoRA 并关闭add_noise完成最后一步。交接点位于平移后的 t = 0.5。 - 简单方式:整个运行都使用 slow LoRA。在五步中,有四步本就处于它的阶段,代价是损失一些后期细节。
作者的提醒值得保留:键兼容性已验证,但两阶段拆分尚未在 ComfyUI 内部实际运行过。如果 fast 阶段看起来不对,仅用 slow 的路径是安全的默认选择。
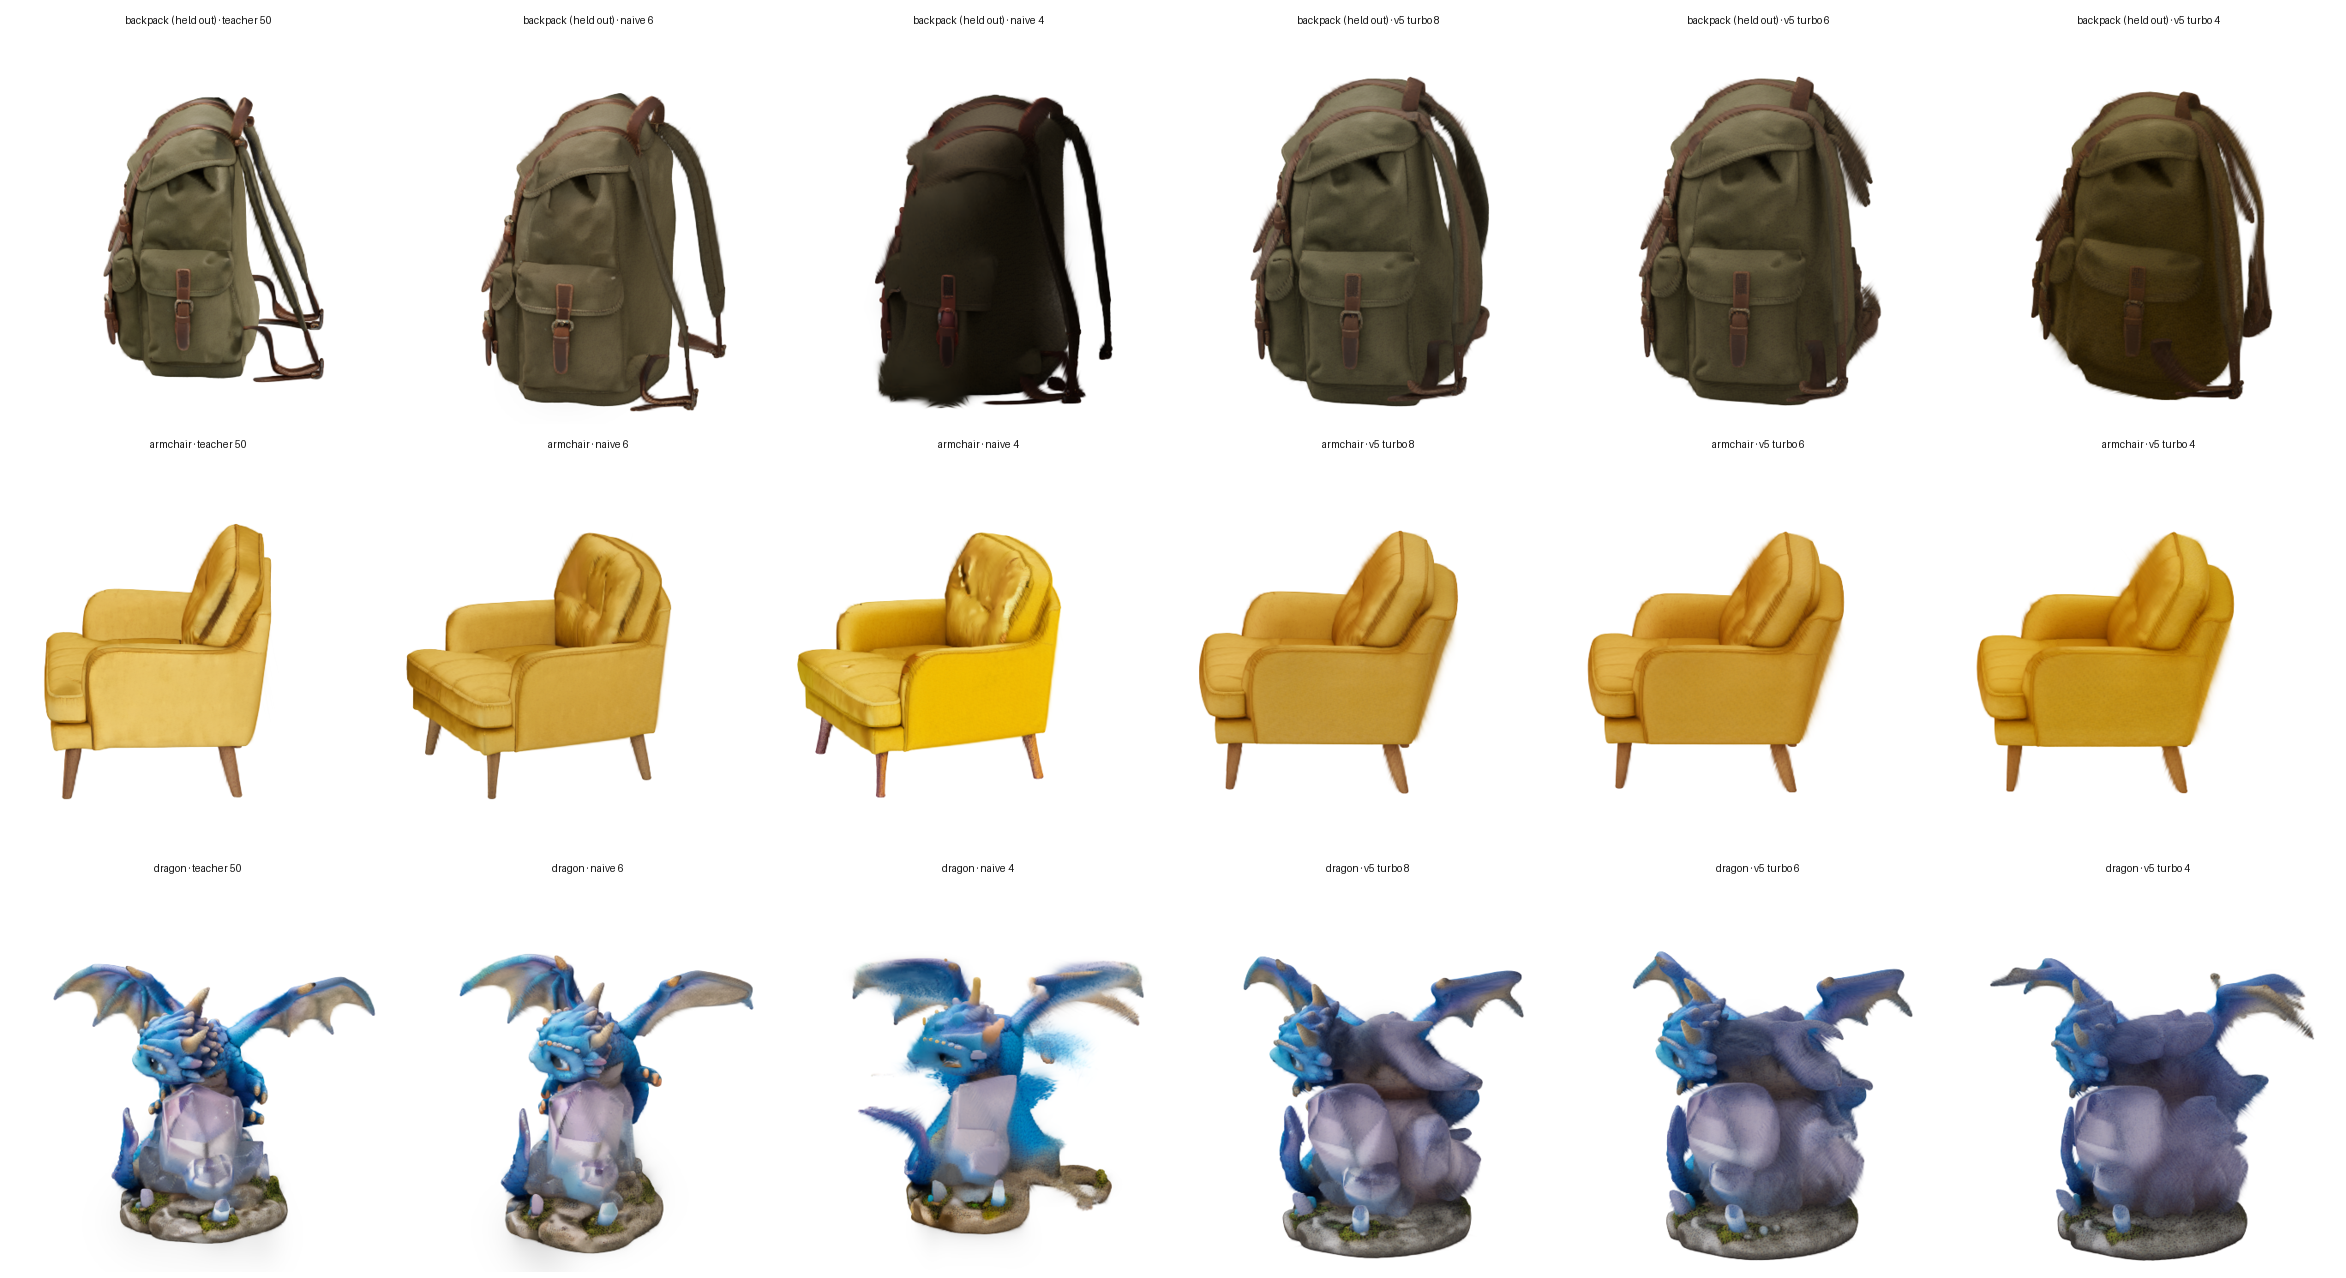
沿步数递减:朴素采样器会丢失颜色(背包在 4 步时接近全黑)和结构(龙形融解),而学生模型在无引导的情况下同时保持了两者。
推荐的默认值是 5 步,此时朴素采样与 turbo 采样之间的差距最大。在 8 步时两者看起来都不错;低于 4 步两者都会劣化,学生模型劣化得更慢。
较弱之处
模型卡片说得很明确。输出可能比 50 步的教师模型更柔和,在 4 步时颜色可能偏暖,高饱和度对象可能不如首个 10 图像模型那样鲜艳。50 步的基础模型仍是参考基准,每一次训练运行、指标和评估渲染都发布在 akhaliq/idol-turbo-runs。
对于 SDK 路径,该仓库是可直接替换的权重:去噪器、解码器、高斯解码器、背景移除器和配置与 speridlabs/idol 逐字节一致,turbo.py 增加了无引导采样器。
可用性
ComfyUI LoRA、SDK LoRA、turbo.py 以及对比网格图都在 Hugging Face 上,发布于 2026 年 11 月 3 日。它需要 Comfy-Org Idol 重打包版本才能运行,SDK 路径仍然需要 Idol 的两个受限编码器(DINOv3 和 FLUX.2-dev)。基础 Idol 需要约 7.2 GB 显存;LoRA 在此基础上增加不到 1 GB。
评论
使用 GitHub 登录后即可参与讨论。