ComfyUI SPEED 现在也能加速图像模型,不只 MiniMax H3
ComfyUI-SPEED 新增 KSampler 形态的节点,让渐进分辨率采样不仅能运行 MiniMax H3,也能运行 MOSS Image 和 Krea 2,并提供按模型校准与新的耗时数据。
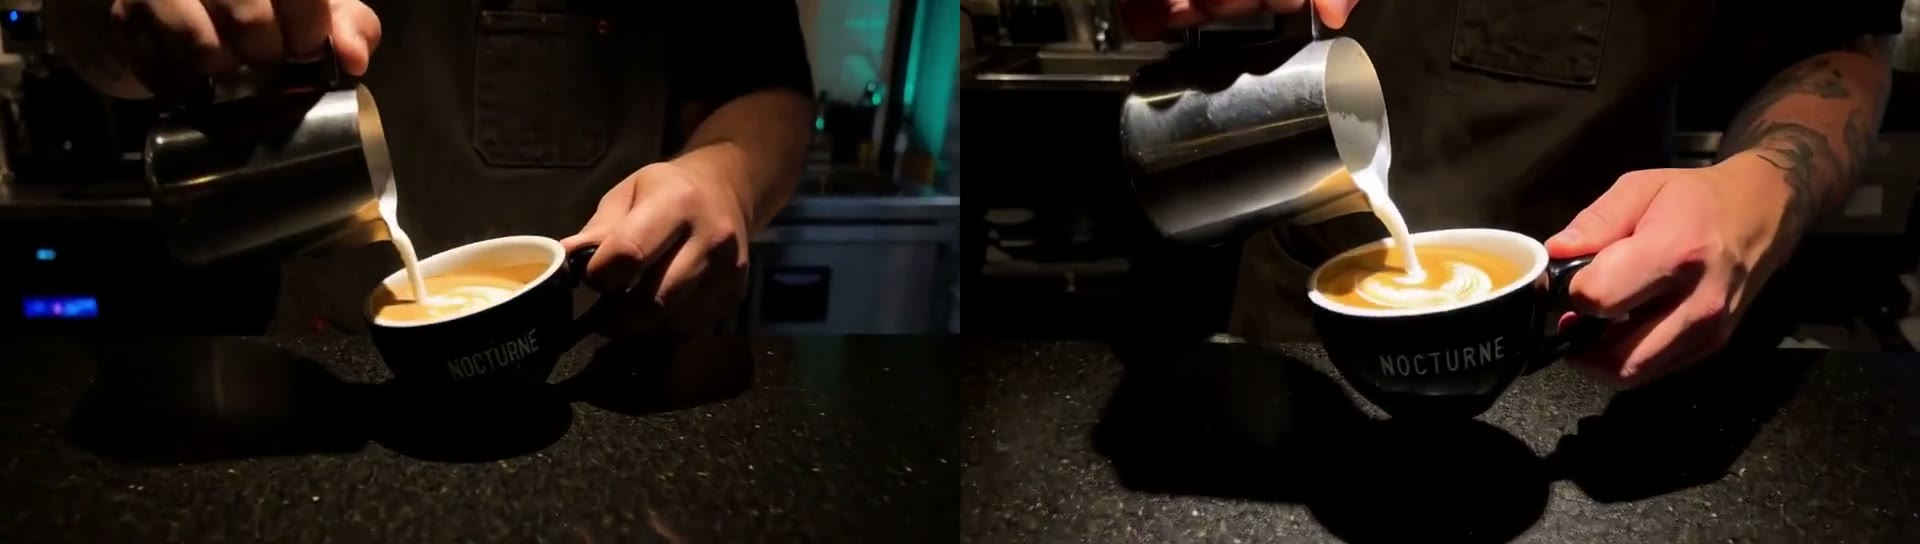
相同的种子和提示词,在 Modal L40S 上生成 5 秒 960x544 片段。左:普通采样,288 秒。右:SPEED 在阈值 0.05 下使用 4 个阶段,182 秒。
这个节点包做什么
SPEED 源自斯坦福 Howard Xiao、Brian Chao、Lior Yariv 和 Gordon Wetzstein 的论文 Spectral Progressive Diffusion for Efficient Image and Video Generation。其背后的观察是:扩散模型大致按从低频到高频的顺序构建图像,因此早期的去噪步骤主要被模型尚未解析的频段占据。以完整分辨率运行这些步骤,会把大部分算力花在噪声上。
该节点包无需重新训练即可把这一思路应用到 ComfyUI 中。一次运行从较小的网格开始,随着细节开始变得重要,再把 Latent 升到更大的网格。stages 决定阶梯:2 阶段从 0.5 到 1.0,3 阶段依次为 0.33、0.66 到 1.0,4 阶段依次为 0.25、0.5、0.75 到 1.0。Tolerance (Delta)、noise_amplitude 和 noise_decay_exponent 决定每次切换发生在哪一步,阈值越小切换越晚:更安全,但更慢。
无论视频流处于哪个阶段,MiniMax H3 的音频流始终保持完整分辨率。
重命名带来了哪些变化
仓库现在为 StanLukuvka/ComfyUI-SPEED,不再是 StanLukuvka/ComfyUI-MiniMax-H3-SPEED,更新日志将这些变化归入 2.0.0。在该节点包还只支持 H3 时,本站曾介绍过它的 V2 采样器套件。
- 两个系列共六个节点。
SPEED KSampler、SPEED KSampler (Manual)和SPEED KSampler Sigma Harvest像 ComfyUI 自带的 KSampler 一样接收model、条件和latent_image,并在内部构建噪声、引导器、采样器和 sigma 调度。高级系列保留 MiniMax H3 的 SamplerCustomAdvanced 接线。 - 流式图像模型。 MOSS Image 和 Krea 2 通过 KSampler 节点运行。该节点包会在采样器和 Harvest 中拒绝 EPS 或 v-prediction 等非流式模型,并报错。
- 图生图。
denoise的用法与 KSampler 中相同:第一阶段从编码后缩小到该阶段尺寸的图像开始,Automatic 会跳过被缩短的调度已经越过的粗略阶段。 - 编辑模型上的引用 Latent。 接收
reference_latents的编辑模型(例如 Flux 3 Klein)以前在粗略阶段只能看到引用的左上角。现在 KSampler 节点会随每个阶段缩放引用 Latent,并在最后一个阶段将其恢复。 - 不再内置默认值。
noise_amplitude和noise_decay_exponent现在从 0 开始,并且在运行 Harvest 校准之前会报错停止。对于使用 Euler 的基础 H3,README 列出的参考值为 35.4213 和 1.0126。 - 节点重命名。 更早的
MiniMaxH3*ID 仍作为弃用的子类注册,因此已保存的工作流仍可加载,并可逐个替换节点。
Sigma Harvest 负责按模型进行校准。它在完整分辨率下、不经过 SPEED 链条运行一次你的采样器和调度,测量残差功率随频率下降的情况,并拟合 P(ω) = A·|ω|^-β。随后 Automatic 根据该拟合为每个阶段边界求解,Harvest 会报告 r² 和 health 标签(r² 达到 0.7 及以上为 good,0.4 为 fair,其后依次为 weak、suspect 和 invalid),让你知道这个拟合是否值得信任。
实测加速
新的 H3 证据用一段 5 秒的拿铁拉花倒入视频(960x544)替换了此前 10 秒的片段,在 Modal L40S 上运行,并使用一次 Harvest 校准(A 35.4213,β 1.0126)。普通采样在阈值 0.01 和 0.05 的会话中耗时 288 秒,在 0.005 会话中耗时 276 秒,每个加速比都相对于其所属会话计算。
| 阈值 | 2 阶段 | 3 阶段 | 4 阶段 |
|---|---|---|---|
| 0.005 | 238 秒(1.16 倍) | 236 秒(1.17 倍) | 227 秒(1.22 倍) |
| 0.010 | 238 秒(1.21 倍) | 226 秒(1.27 倍) | 224 秒(1.29 倍) |
| 0.050 | 206 秒(1.40 倍) | 194 秒(1.48 倍) | 182 秒(1.58 倍) |
同一组并排播放:左侧为普通采样,右侧为 SPEED 在阈值 0.05 下使用 4 个阶段。
作者报告,十段 H3 片段中没有任何一段出现色彩闪烁,倒入过程、拉花和文字在每次运行中都得以保留。这低于同一仓库此前在 RTX 5080 上对其上一个 H3 片段报告的 2.41 倍,因此应把倍数看作片段、GPU 和校准的属性,而非方法本身的属性。
图像静帧的运行时间短得多,数字也更小:
| 模型 | 原生 | Automatic,3 阶段,阈值 0.05 | 手动,0.5x 至步数的一半 |
|---|---|---|---|
| MOSS Image,1344x768,20 步,CFG 5 | 22 秒 | 18 秒(1.26 倍) | 14 秒(1.54 倍) |
| Krea 2 raw,fp8,1216x832,52 步,CFG 3.5 | 283 秒 | 215 秒(1.31 倍) | 183 秒(1.55 倍) |
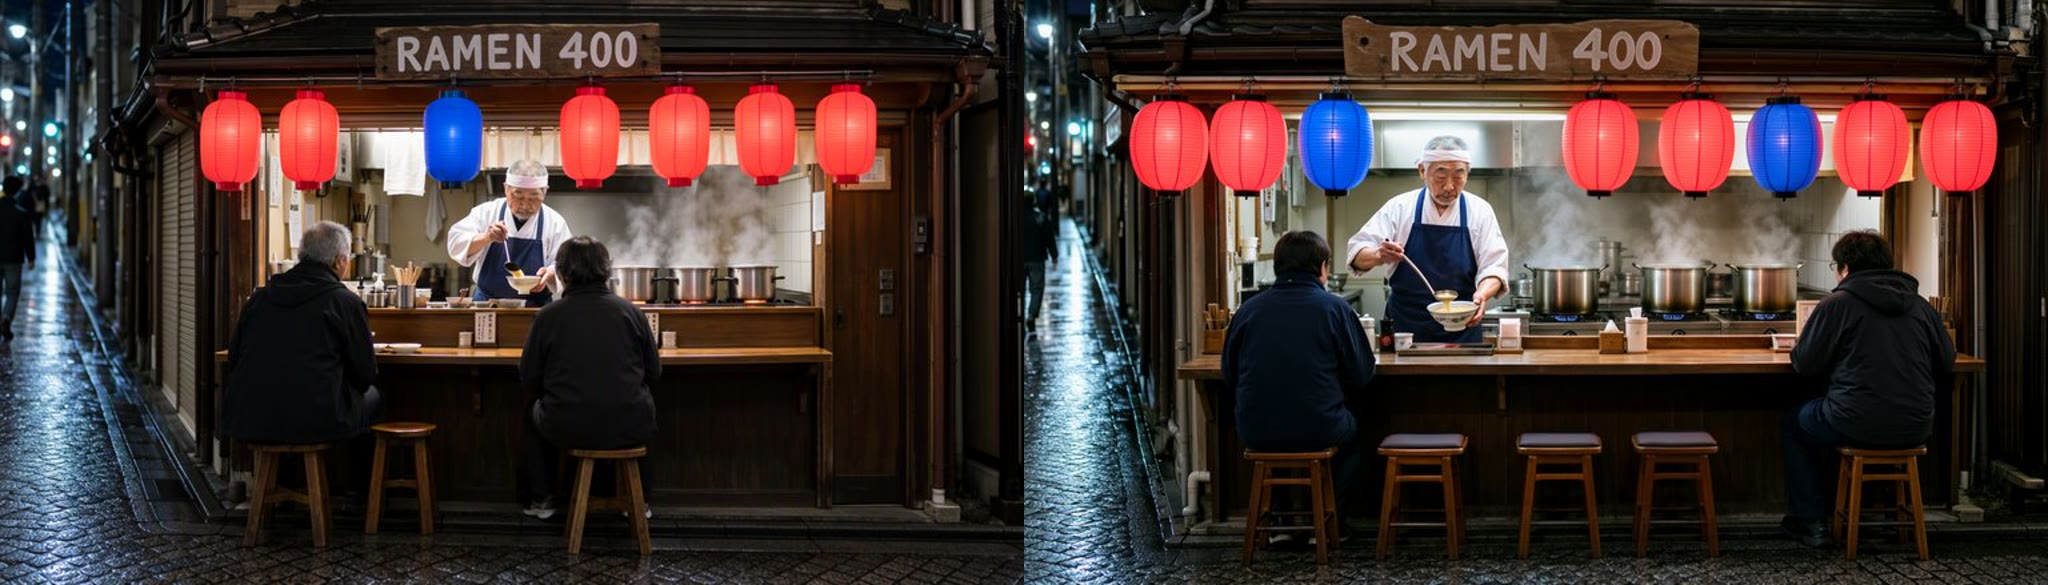
MOSS Image 在 1344x768 下,相同的种子和提示词。左:原生,22 秒。右:SPEED 3 阶段,18 秒。
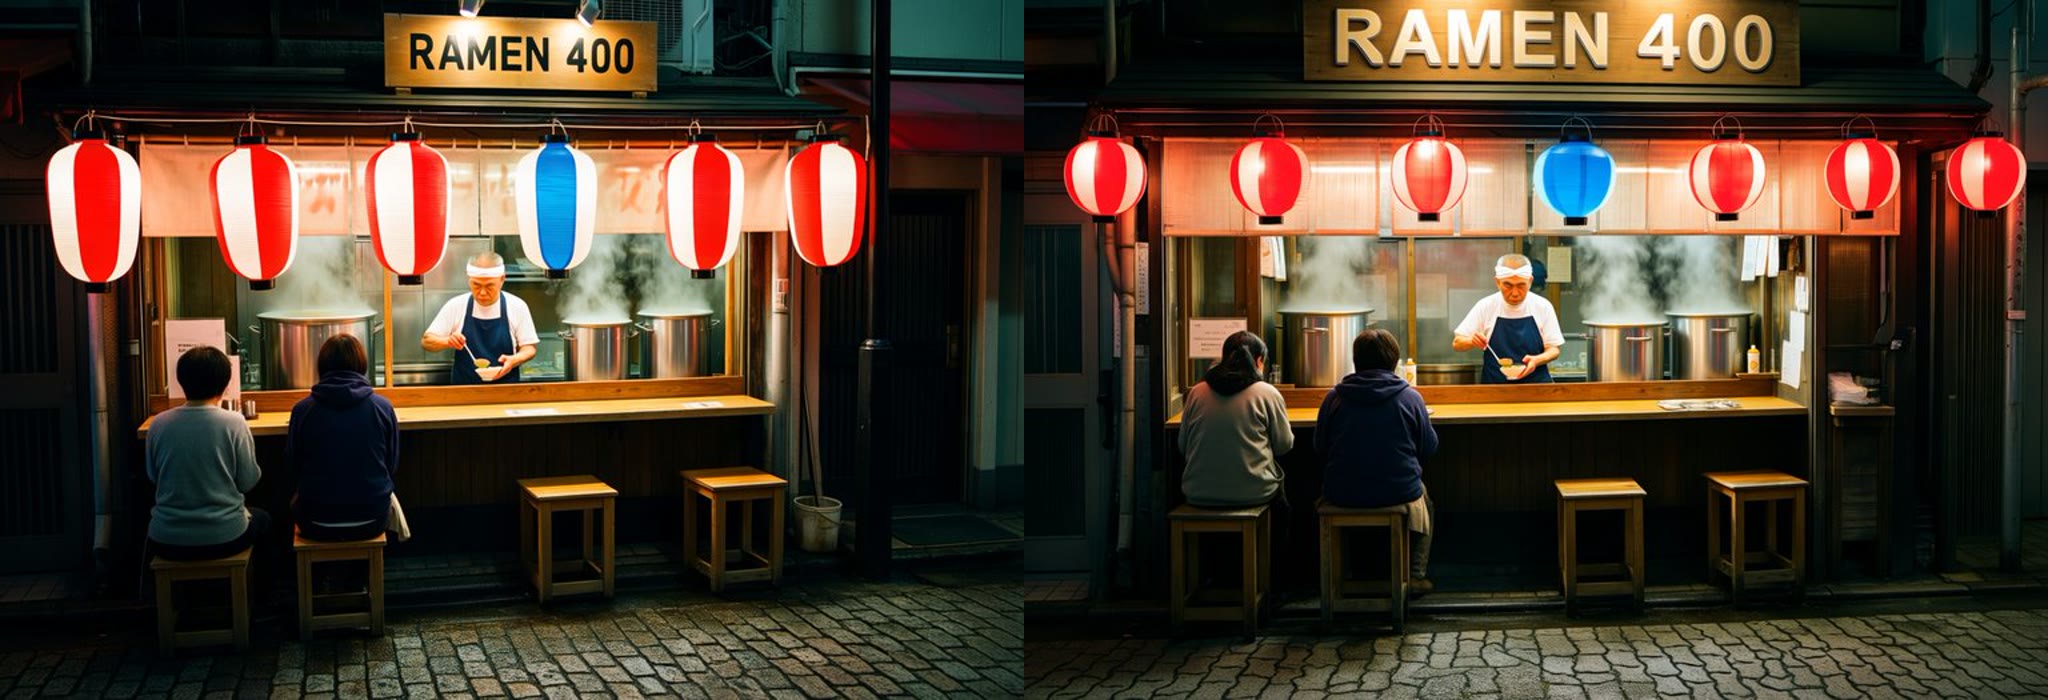
Krea 2 在 1216x832 下,52 步。左:原生,283 秒。右:SPEED 3 阶段,215 秒。作者指出,Krea 2 这几行是在 8 GB 显卡上运行 13 GB 模型的单次运行结果,因此会有数十秒的波动。
在阈值 0.005 时,采集到的边界落在图像调度的最初几步之内,几乎节省不了什么,因此图像工作流使用 0.05。
构图与速度
noise_policy 决定每次切换时额外的高频细节来自哪里。coupled_full_grid 复用普通 SamplerCustomAdvanced 运行会使用的噪声场,因此相同种子保持相同的构图,在 H3 片段上它只节省了 5% 到 10%。direct_coarse 自行绘制填充:它会改变给定种子下的画面,在同样的片段上节省了 15% 到 30%。
工作流
仓库附带三个示例图,每个图都在同一组加载器上放置 Harvest、Automatic 和 Manual 节点,且只启用 Automatic。
H3 图使用 Euler 运行高级节点,简单调度、20 步、3 阶段、阈值 0.005。两个图像图使用 KSampler 节点,MOSS Image 为 Euler 20 步,Krea 2 为 52 步,3 阶段,阈值 0.05。
限制
- 采样器和 Harvest 中都只接受流式(CONST)图像模型。
- 不支持
noise_mask和带遮罩的去噪。 - 在高级节点上,
latent_image必须以空开始;图生视频通过 H3 关键帧条件实现,节点包会自行缩放和恢复。 - 每个阶段都是一次独立的采样器调用,因此多步采样器在每次分辨率变化时都会重新启动其历史。请给每个阶段至少 2 步。
- 某些采样器在 H3 上仍表现异常:
dpm_fast和dpm_adaptive永远无法完成去噪,而uni_pc在某阶段只获得一步时会出错。
获取方式
- 节点包:StanLukuvka/ComfyUI-SPEED
- 论文:Spectral Progressive Diffusion
- 工作流:
workflows/ - 证据与原始片段:
evidence/
本文撰写时,该仓库已获得 110 个 star。该消息发布于 r/StableDiffusion;截至撰写时,尚未有对图像模型数字的独立复现。
评论
使用 GitHub 登录后即可参与讨论。