Anima RGBA 为 ComfyUI 中的 Anima 带来真正的 Alpha 通道
Anima RGBA 将 4 通道 Qwen-Image VAE 与配套的 Anima LoRA 结合,让模型无需自定义节点即可渲染透明 PNG,在留出集上 Alpha MAE 为 0.0027。
transparent background,VAE Decode 就会返回直接的 RGB 加 Alpha,再由 Save Image 写为 RGBA PNG。无需自定义节点。
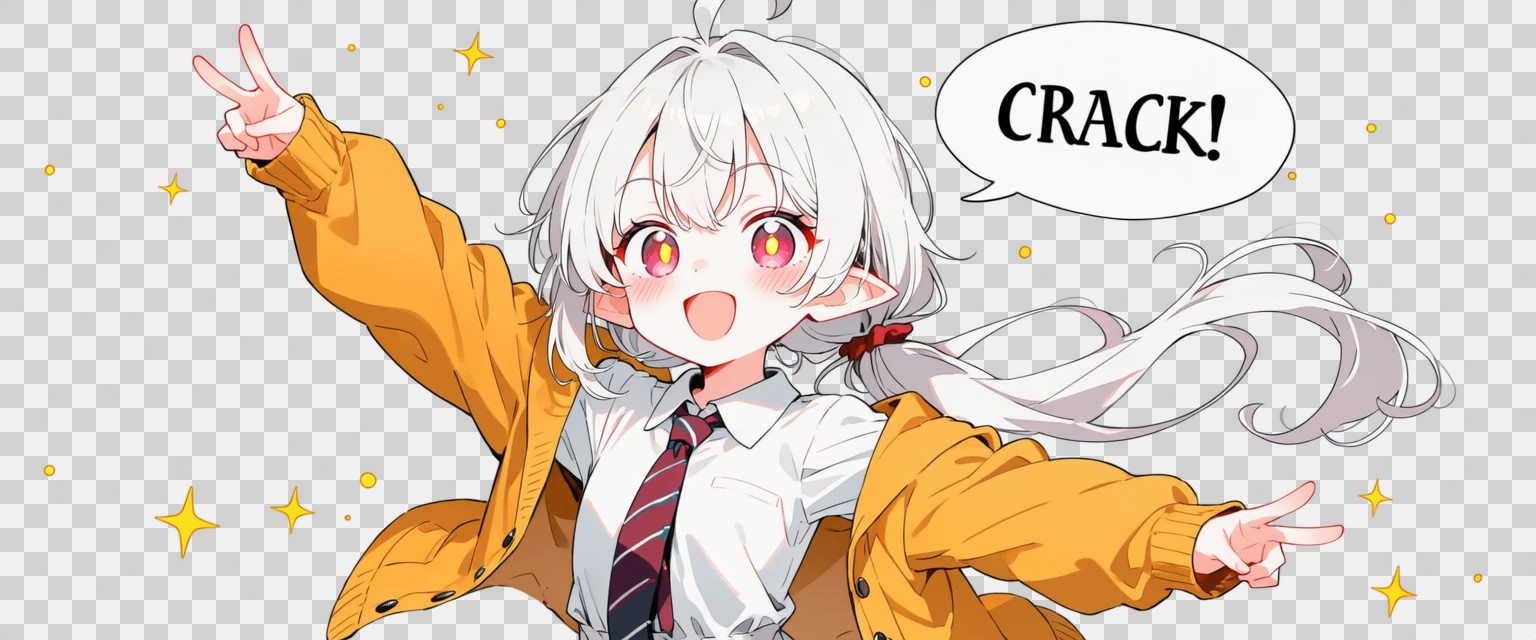
使用 RGBA VAE 和 LoRA 生成,显示在棋盘格背景上。
Anima 使用 Qwen-Image VAE,它解码为三个通道。因此,当要求模型生成透明背景时,它实际上是把主体画在一个被要求想象为空的背景上,之后再通过一次抠图(matting)处理完成裁剪。RGBA VAE 把这一步移入解码器:最后一层只是用四个通道代替三个通道。
将 3 通道 VAE 变成 4 通道 VAE
这个技巧比听起来要简单。VAE 保持其 16 通道 Latent 为 1/8 分辨率,因此 Anima 的 Latent 空间没有任何变化。编码器接收在白底上合成后的 RGB 再加一个 Alpha 通道;解码器输出直接的、非预乘的 RGB 加 Alpha。
初始化完成其余工作:复制 3 通道权重,新的 Alpha 输入列从零开始,新的 Alpha 输出行从零开始并带 +1 偏置,因此在任何训练之前,模型都能复现原始 VAE,把一切内容都解码为不透明。随后训练会在相同的白色合成下,把新编码器拉向冻结的原始编码器的 Latent,这使 Latent 空间保持在 Anima 已经工作的位置,并让 LoRA 只需学习一个很小的 Alpha 残差。
在白底上合成是有意为之的选择:当 Alpha 为零时 RGB 是无定义的,而 Anima 在透明背景提示词下本来就会绘制白色合成结果,因此 RGBA 的 Latent 与基础模型产生的 Latent 保持接近。实测漂移为 0.058 的 RMS 距离(以 Latent 标准差为单位),约一个 sigma 的 6%,而这正是 LoRA 所弥合的差距。
数据表现
该 VAE 在 512 px 裁剪图上以批处理 4 训练了 12,000 步,损失包含随机纯色背景上的 L1 合成损失、权重 0.2 的 LPIPS、Alpha L1、一个 Alpha Sobel 梯度项,以及针对原始编码器的参考 Latent MSE;每批中 15% 为不透明图像,用作正则化。在包含 200 张透明图像和 50 张不透明图像的 512 px 留出集上(均未参与训练):
| 指标 | 数值 |
|---|---|
| Alpha MAE | 0.0027(约 0.7 / 255) |
| Alpha RMSE | 0.0157(约 4 / 255,集中在边) |
| 白底合成 PSNR | 34.94 dB |
| 黑底合成 PSNR | 33.17 dB |
| 不透明 PSNR,原始 Qwen-Image VAE | 34.26 dB |
| 不透明 PSNR,Anima RGBA VAE | 34.74 dB |
不透明重建比原始略好,而不是略差,这是有用的结果:替换 VAE 在普通图像上没有任何代价。
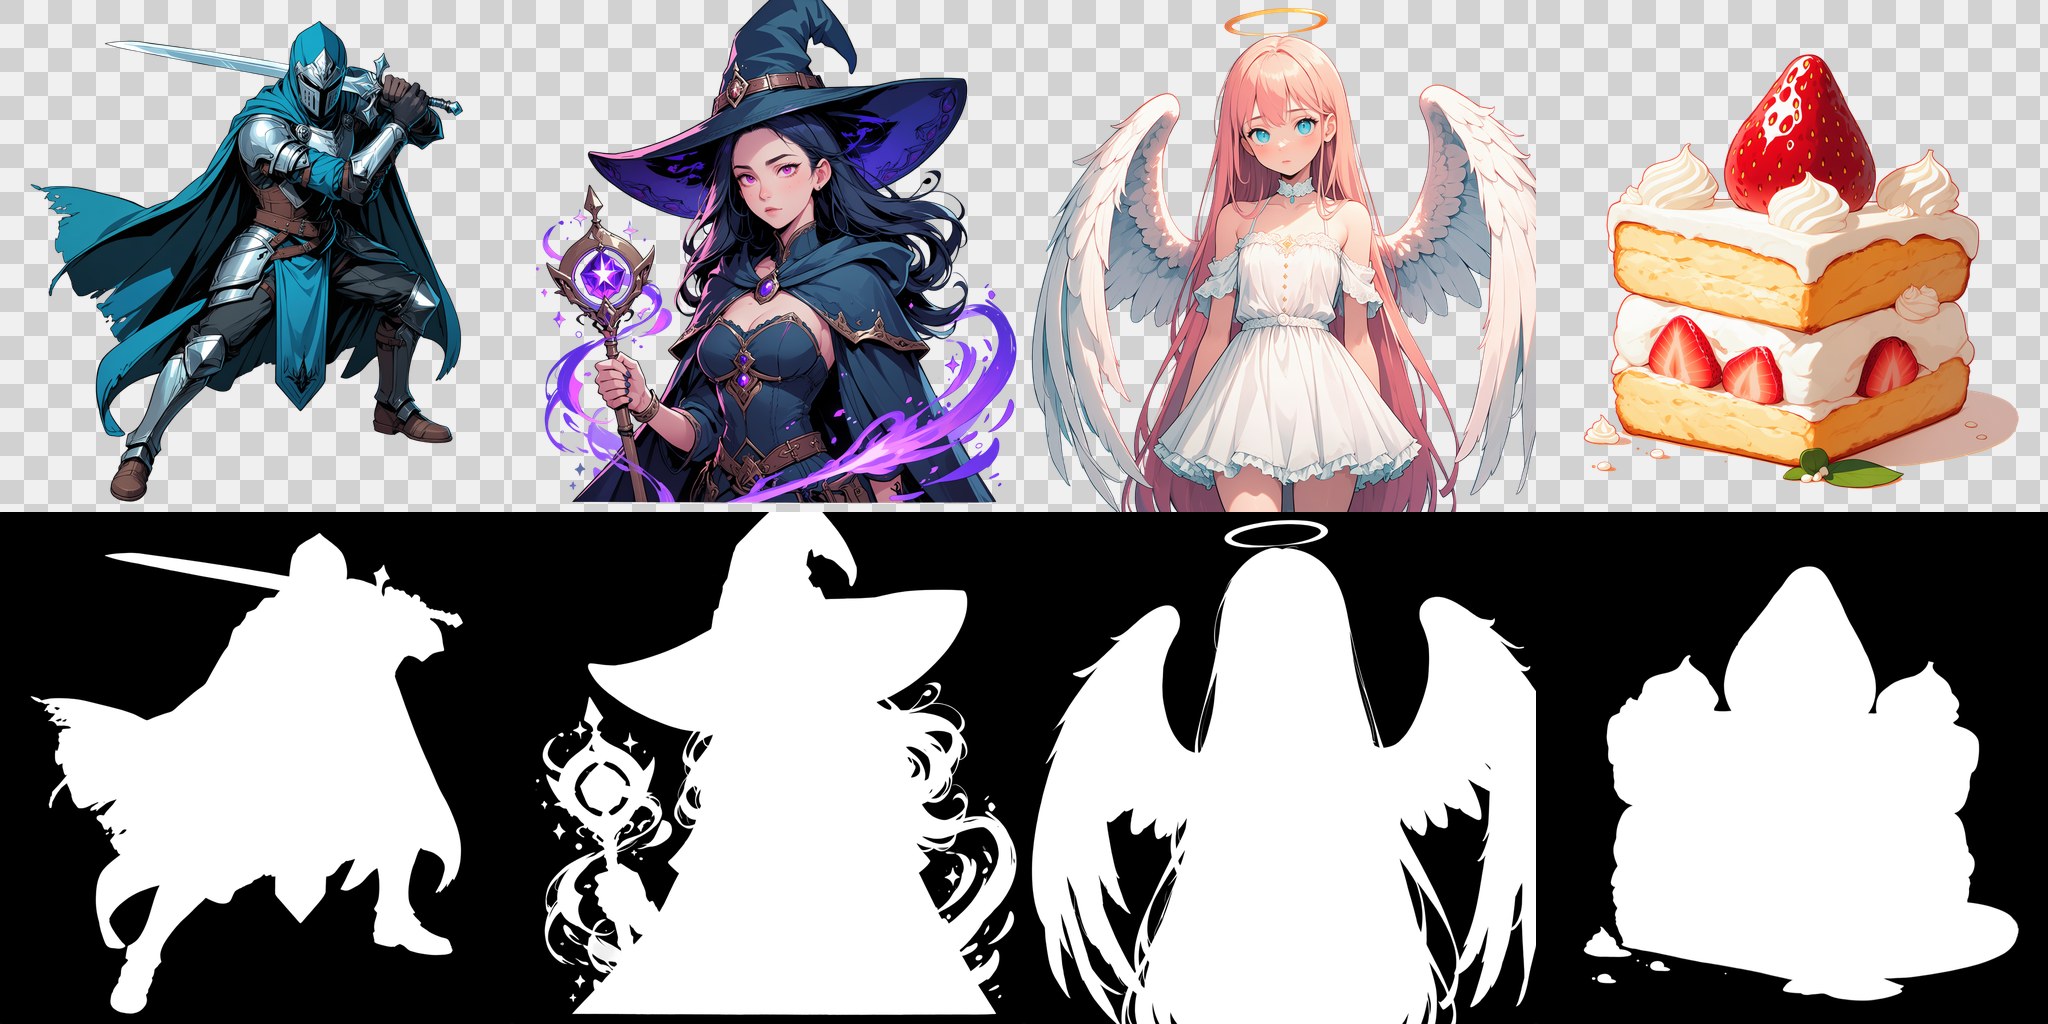
上排:棋盘格上的 RGBA 输出。下排:单独的 Alpha 通道。
为什么仍然需要 LoRA
没有它,VAE 仍会生成 Alpha 通道,但很朦胧:人物和白色衣物会部分透明,因为基础模型的 Latent 与新解码器的期望只是大致匹配。该 LoRA 以 rank 32、25,000 步在这款 VAE 产生的 Latent 上训练,使用 18,426 张图像,Qwen3 文本编码器和 LLM 适配器保持冻结。透明图像使用两种交替的触发短语标注:transparent background 和 isolated on a transparent background,而不透明正则化图像不带触发词。
模型卡片的测试表(8 个提示词 × 2 个种子,1024 x 1024)展示了调节这些参数后的效果:
| LoRA 强度 | 触发词权重 | 透明 | 半透明像素 |
|---|---|---|---|
| 无 | 1.0 | 16 / 16 | 12.8% |
| 1.0 | 1.0 | 16 / 16 | 0.9% |
| 1.2 | 1.0 | 16 / 16 | 1.0% |
| 1.5 | 1.0 | 16 / 16 | 1.4% |
| 1.0 | 1.2 | 16 / 16 | 0.9% |
| 1.0 | 1.5 | 16 / 16 | 0.9% |
每种设置都能产生透明结果,因此真正重要的数字是多余半透明像素的占比:无 LoRA 时为 12.8%,默认设置下为 0.9%。把 LoRA 推到 1.5 没有帮助,还会在主体周围添加半透明碎屑和烟雾;而提高触发词权重则让图像和 Alpha 几乎不变。这与通常的直觉相反,卡片也直接写明:提高触发词权重,而不是 LoRA 强度。
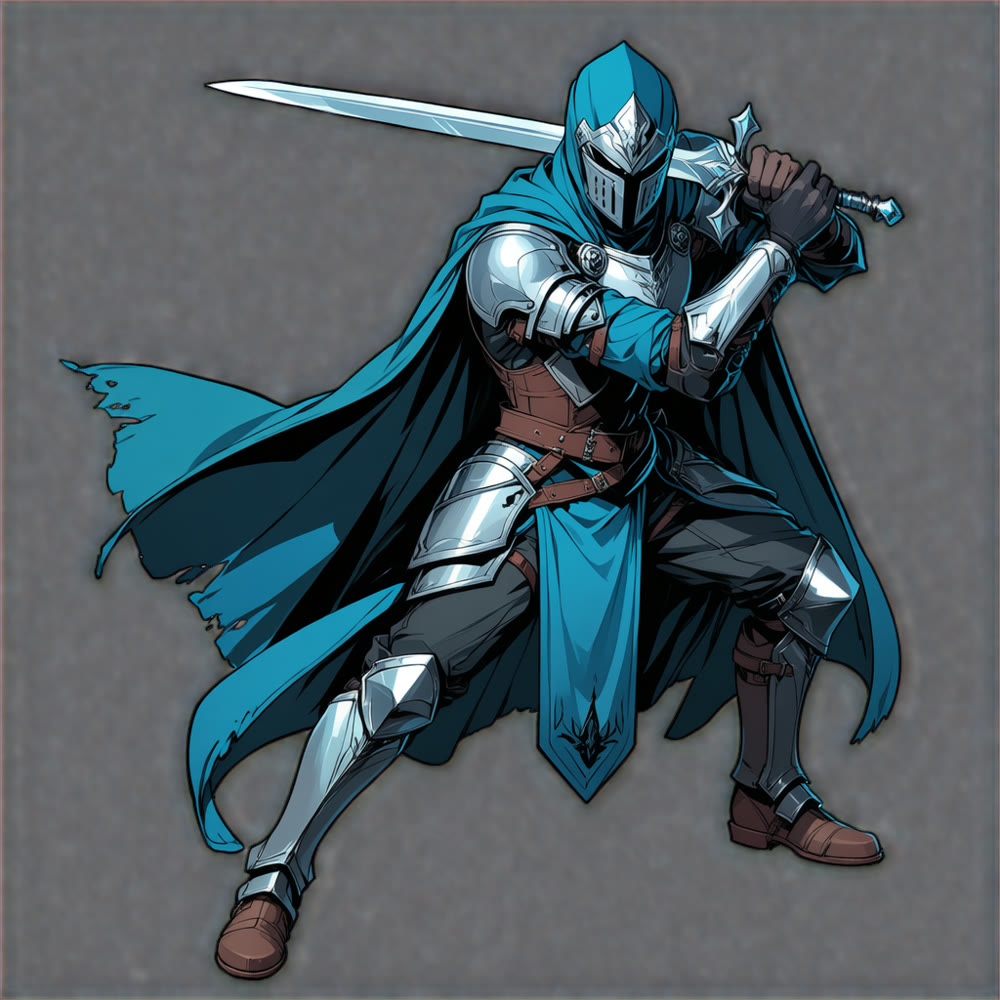
LoRA 1.0、30 步、CFG 4.5、er_sde 配 simple 生成的全身角色。
不足之处
该 VAE 在 512 px 裁剪图上训练,但可在更高分辨率下解码,而发丝、玻璃、烟雾等细微半透明细节是它最薄弱的地方。生成的 Alpha 大多是二值的,因此透视衣物通常会被输出为不透明。填满画面的特写有时会保留不透明的白色背景,叠加其他 LoRA 时更为常见。它是为动漫和插画内容而构建的,这也正是 Anima 所擅长的内容。
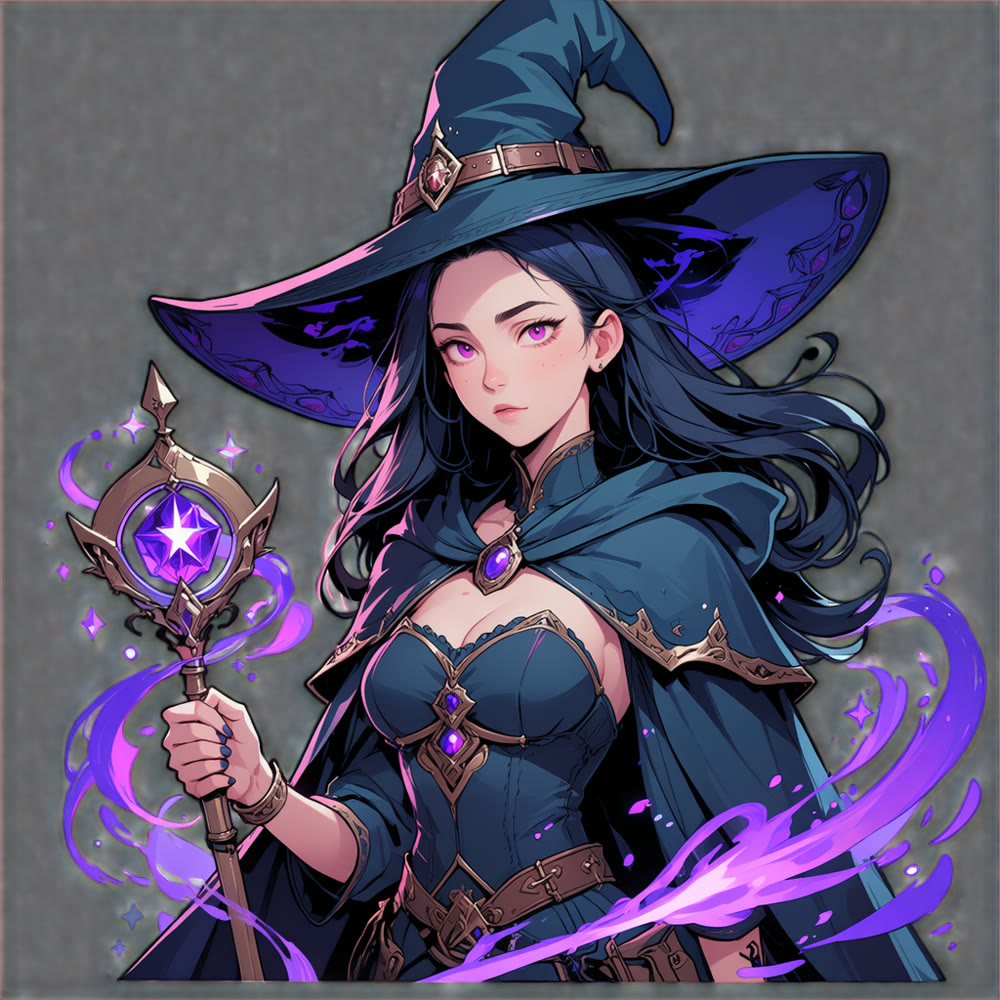
同一套方案用在不同主体上,帽子和法杖处的 Alpha 得到保留。
评论
使用 GitHub 登录后即可参与讨论。