Lightning v2 RL:4 步 Qwen-Image 2.1,经强化学习精炼
LightX2V 的 Lightning v2 RL 用完整的 Qwen-Image 2.1 transformer 取代了 67 MB 的适配器,蒸馏至 4 步,并经过强化学习精炼。
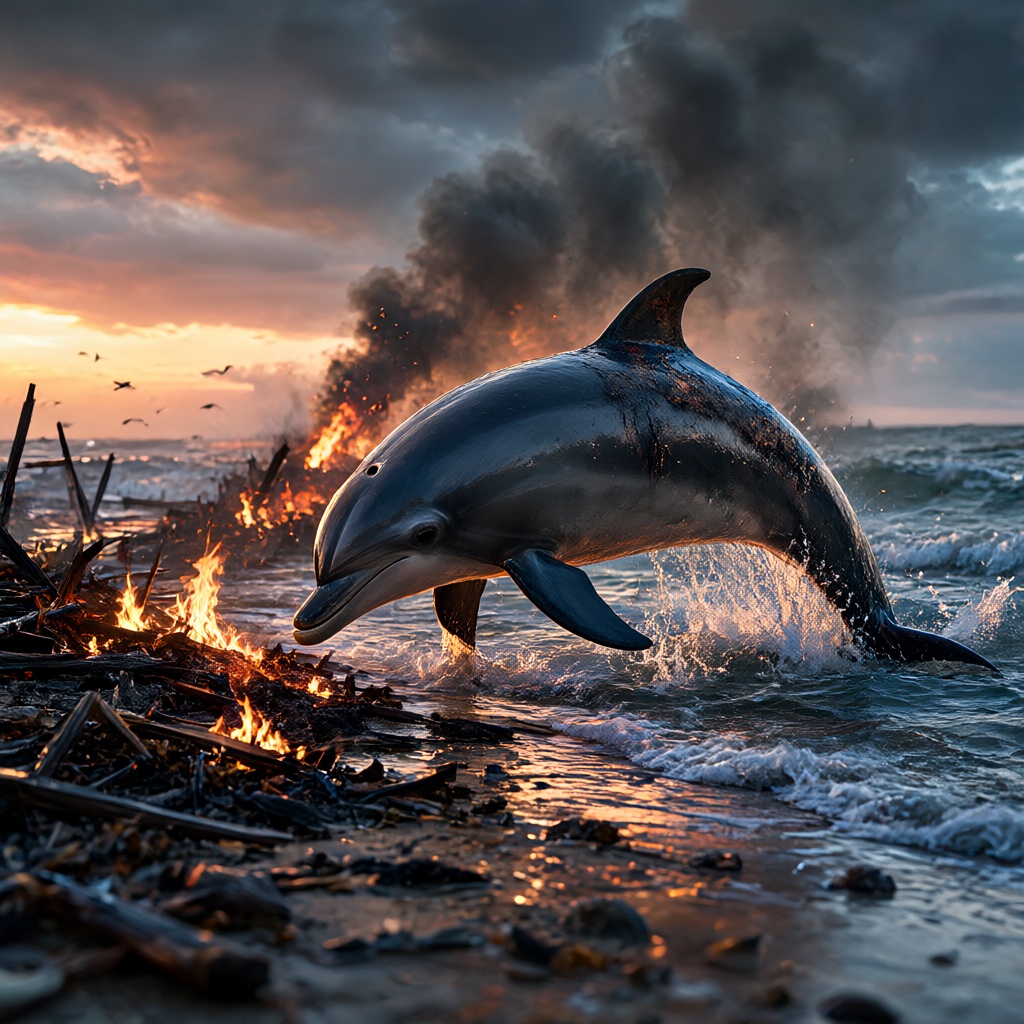
来自四步 RL checkpoint 的 1024 x 1024 渲染图,《燃烧海岸线上的海豚》。
相比 LoRA 有哪些变化
10 月的版本将一个 67 MB 的适配器挂到原版 Qwen-Image 2.1 checkpoint 上,并在采样时依赖一份固定的 sigma 列表。v2 改变了这套设置的两个部分:
- 完整 transformer 权重而非适配器:单个
diffusion_pytorch_model.safetensors以 FP32 存储(28.5 GB),并带有自己的config.json,模型卡片说明可在 BF16 下加载用于推理。没有可叠加的 LoRA。 - 蒸馏之后增加强化学习阶段。 卡片将该 checkpoint 描述为 Lightning v2 经 RL 精炼后的版本,使用 LightX2V RL 训练。仅发布了精炼后的 checkpoint,因此 RL 之前的 v2 权重无法获取,也就无法对比。
- 一个 checkpoint 覆盖三项任务:文生图、单引用编辑和多引用生成,v1 同样针对这些任务。
四步采样调度
采样配置以 inference_config.json 形式提供,它并不是 v1 LoRA 所用的那种均匀调度。v2 使用 1.0、0.95418、0.89508 和 0.704534 四个 sigma,true_cfg_scale 为 1.0,KV 缓存已启用:
pipe.scheduler = FlowMatchEulerDiscreteScheduler(
    **inference_config["scheduler"],
)
image = pipe(
    prompt=prompt,
    width=1024,
    height=1024,
    sigmas=SIGMAS,                    # 1.0, 0.95418, 0.89508, 0.704534
    num_inference_steps=len(SIGMAS),
    true_cfg_scale=1.0,
    use_kv_cache=True,
)
其中三步位于 0.89 以上,第四步从 0.895 降到 0.705,随后调度器再追加终端零,因此大部分去噪发生在前期。README 明确指出,仅设置 num_inference_steps=4 无法复现这一调度,并且存储的 sigmas 已经过偏移,所以动态偏移必须保持关闭。
四步对四十步
仓库为每个示例都配了一组原始 Qwen-Image 2.1 权重的 40 步运行结果,提示词、种子、CFG 1.0 和 1024 x 1024 输出均相同。
| 基础模型,40 步 | Lightning v2 RL,4 步 |
|---|---|
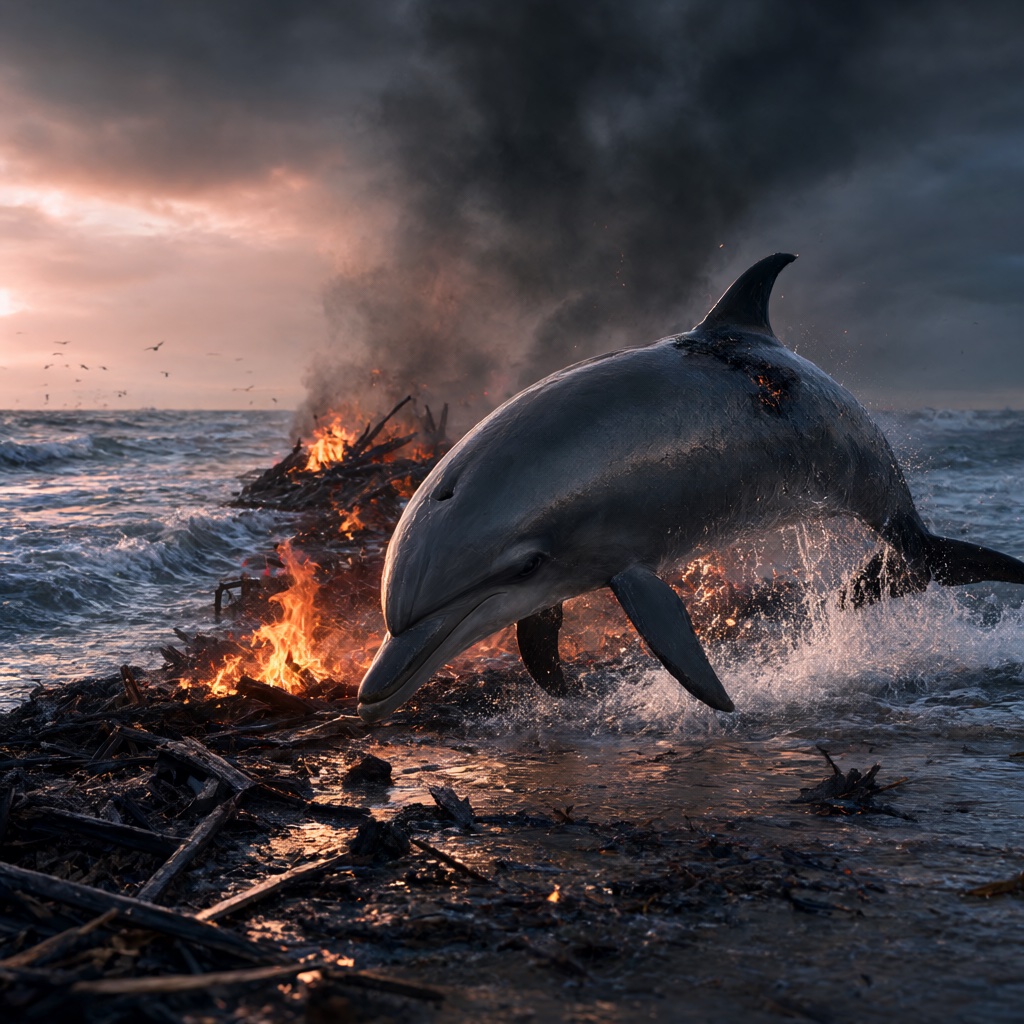 | |
| 燃烧海岸线上的海豚 | 燃烧海岸线上的海豚 |
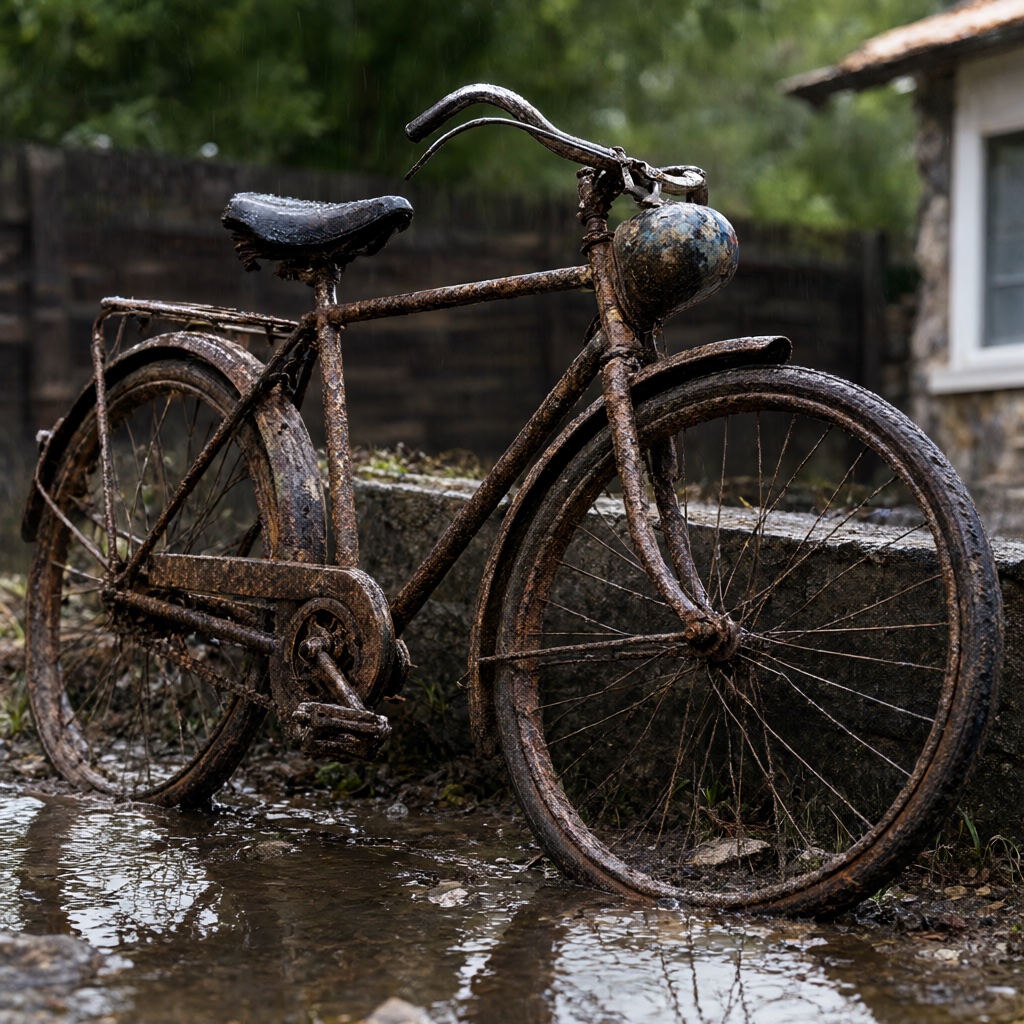 | 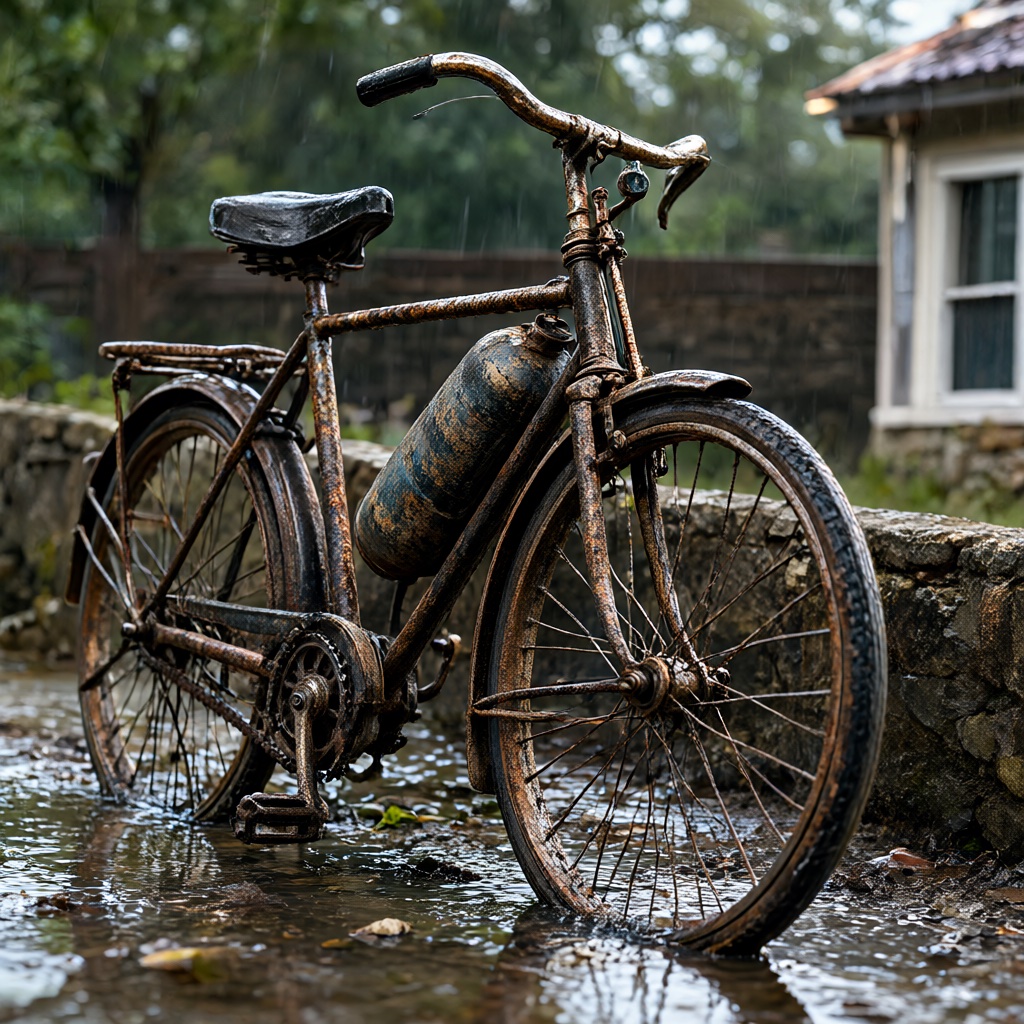 |
| 雨中斑驳的自行车 | 雨中斑驳的自行车 |
这两条提示词都是长篇的结构化场景描述:海豚那条依次描述云的颜色、烟柱、烧焦的横梁、余烬位置和背鳍受光,然后才结束;自行车那条则描述每根车架管的锈迹、辐条数量和雨痕。卡片将这些作为已选择的验证示例呈现,而非基准测试,并提醒精细文字、人体结构、对象数量和精确的引用保持仍可能需要检查。
编辑单张引用图
进行编辑时,引用图像作为 pipeline 的 image 参数传入,与指令在同一次调用中提交:
| 引用 | 基础模型,40 步 | Lightning v2 RL,4 步 |
|---|---|---|
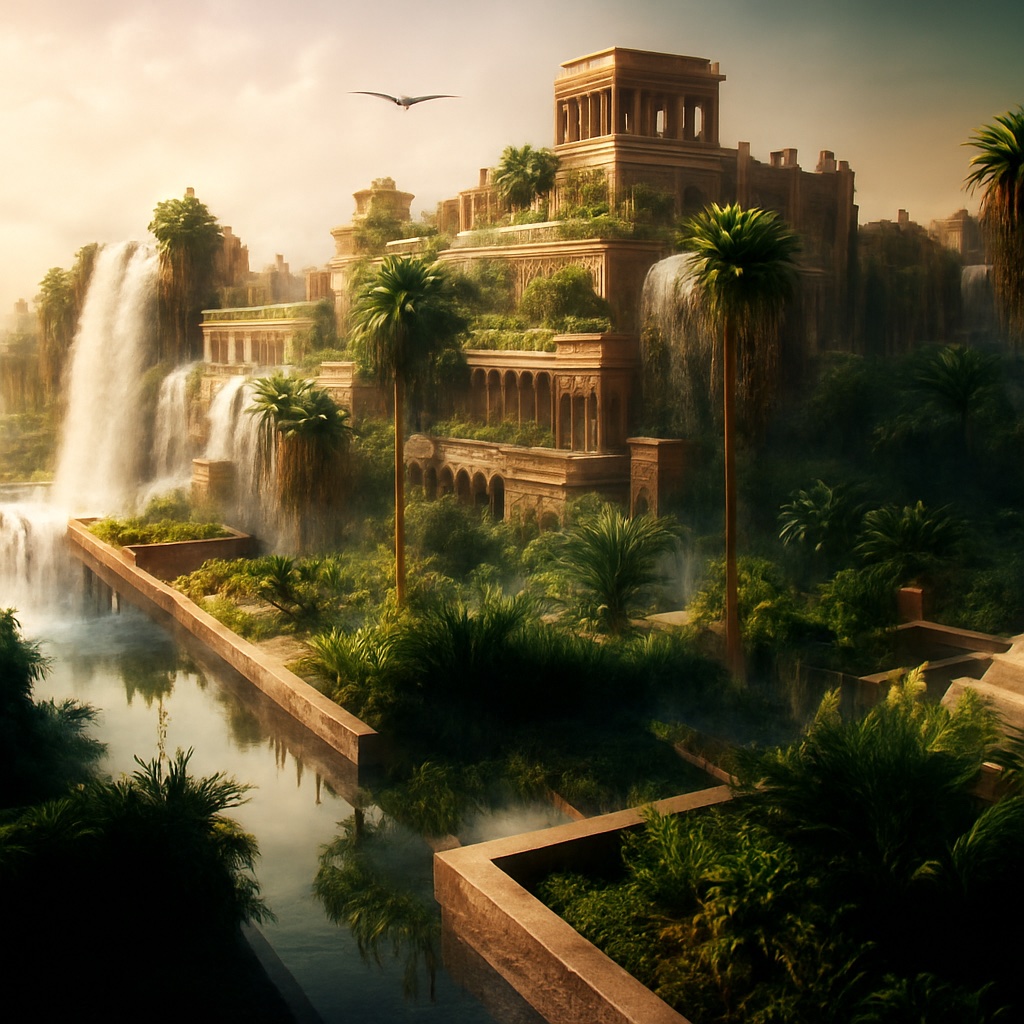 | 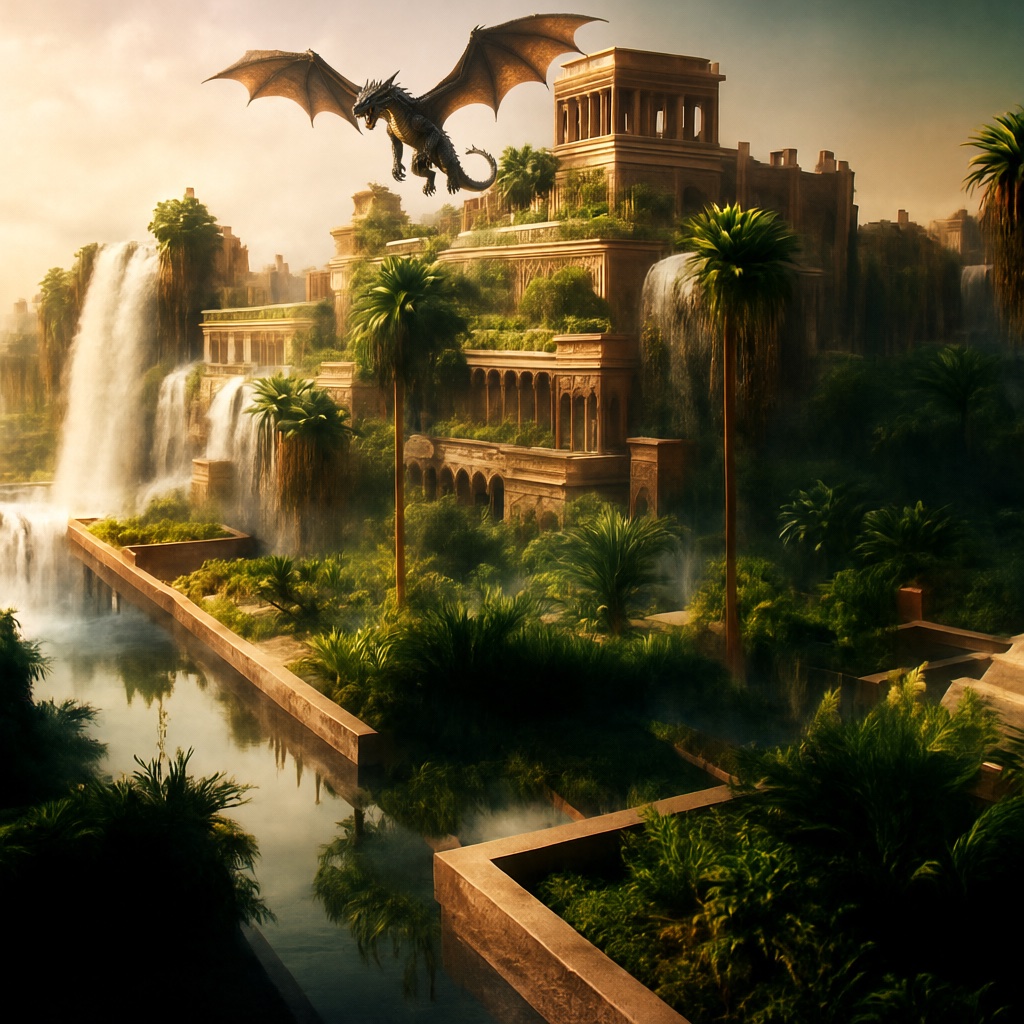 | 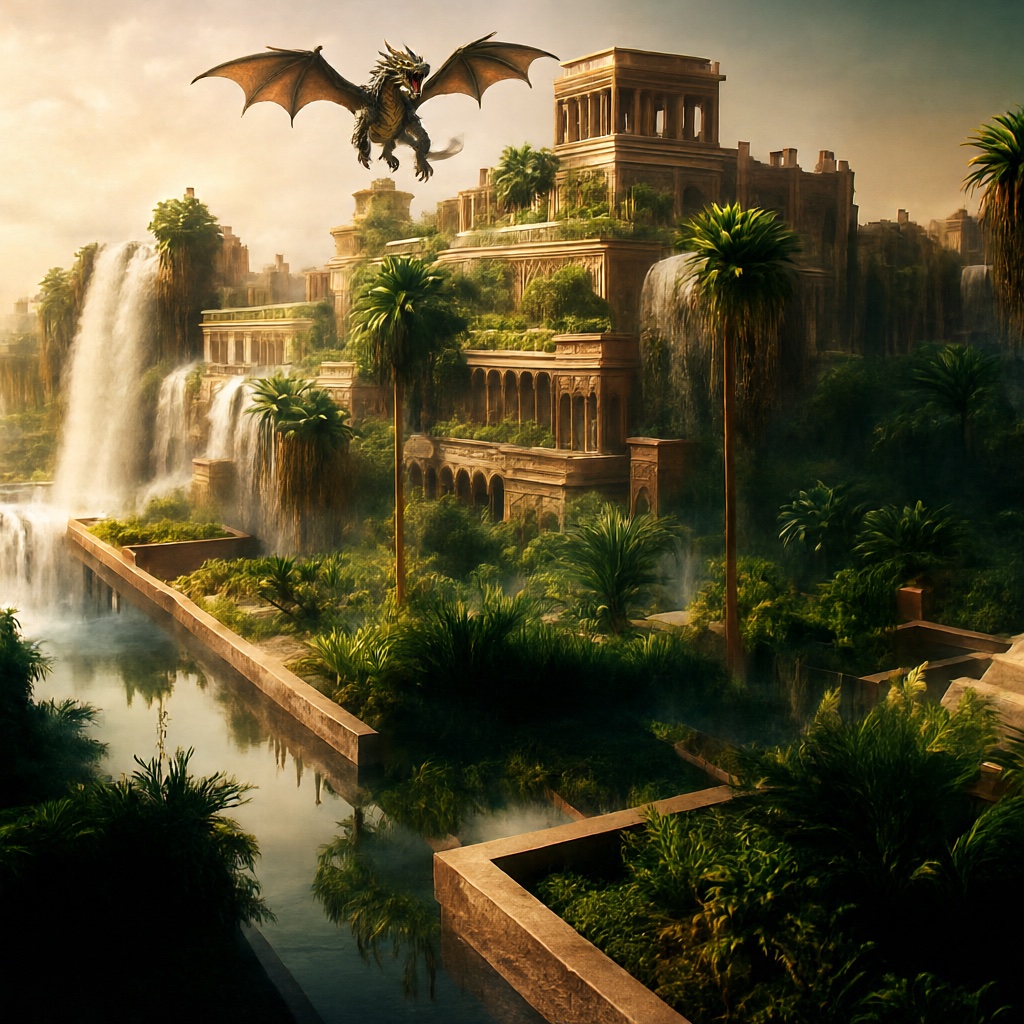 |
“将上方天空中部飞翔的鸟替换为一条在同位置、同距离翱翔的飞龙。……其余一切保持完全不变:层叠的石制建筑……层层跌落的瀑布……”
这条提示词把龙固定在鸟的飞行方向上,然后列出不得移动的内容:石制画廊、屋顶花园、瀑布、棕榈、薄雾和朦胧的天空。仓库中的第二个编辑示例则替换了一位吉他手所在的场景。
多引用生成
多引用路径一次接收多张图像,并在提示词中按索引引用它们(<image1>、<image2>),卡片正是用这种方式区分两张引用图:
| 引用 | 基础模型,40 步 | Lightning v2 RL,4 步 |
|---|---|---|
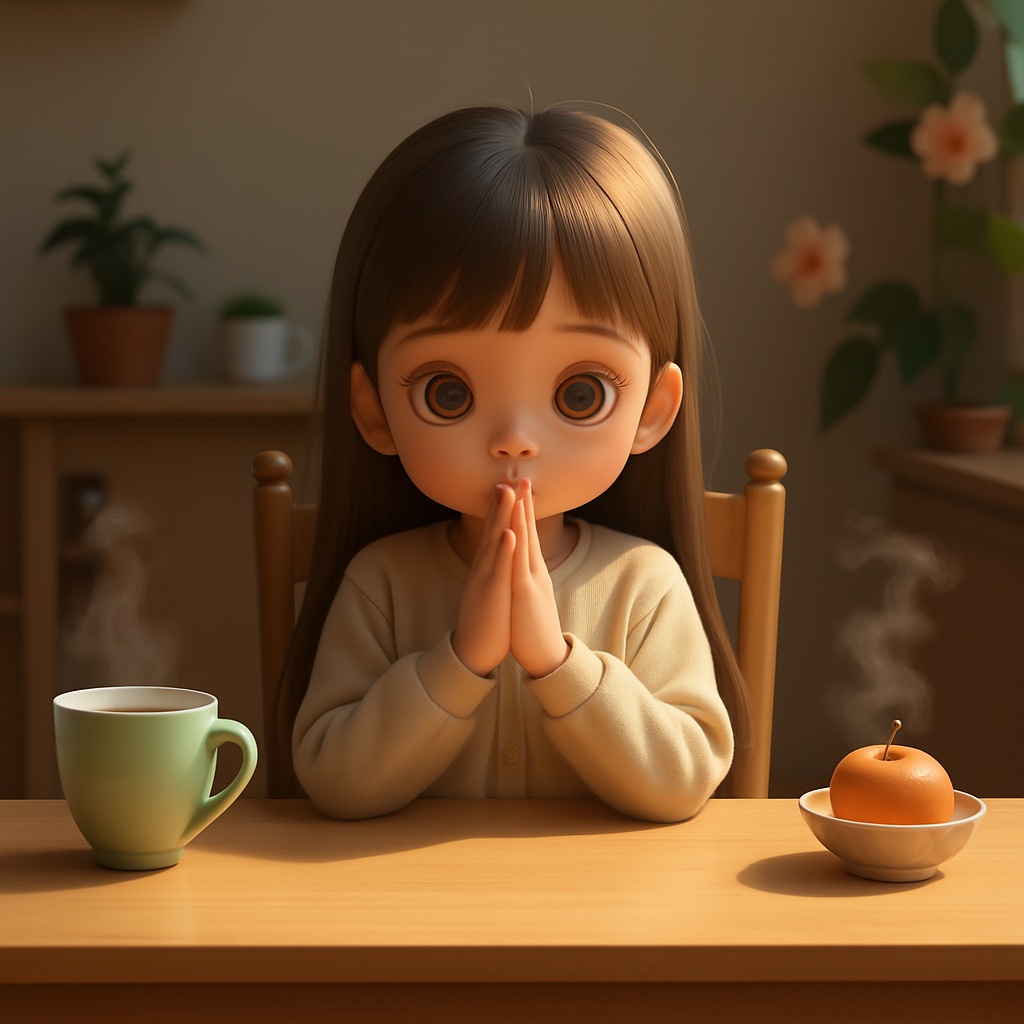 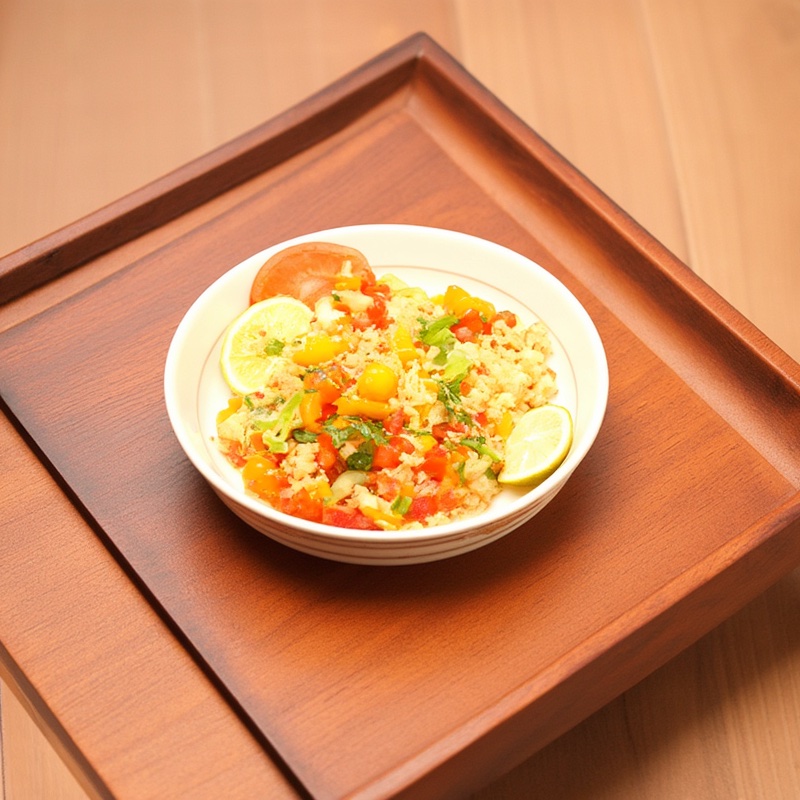 | 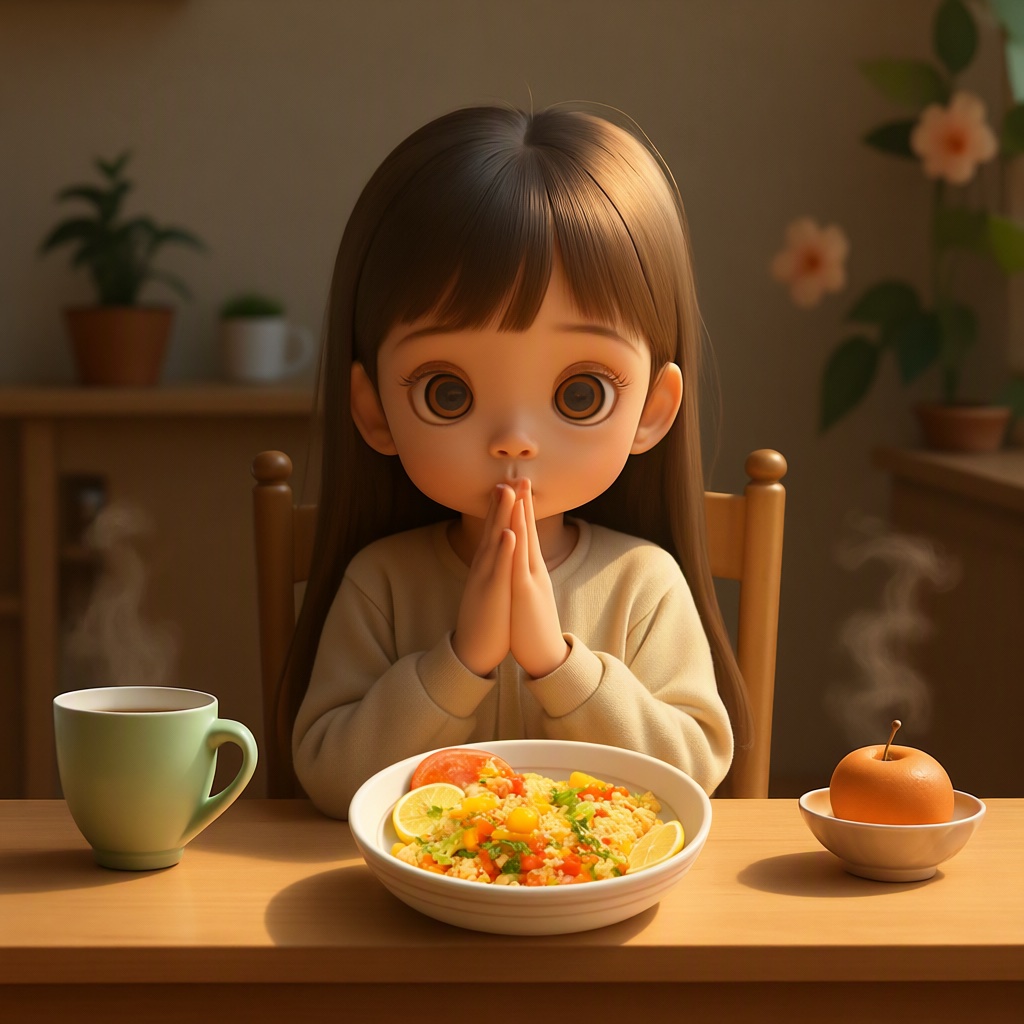 | 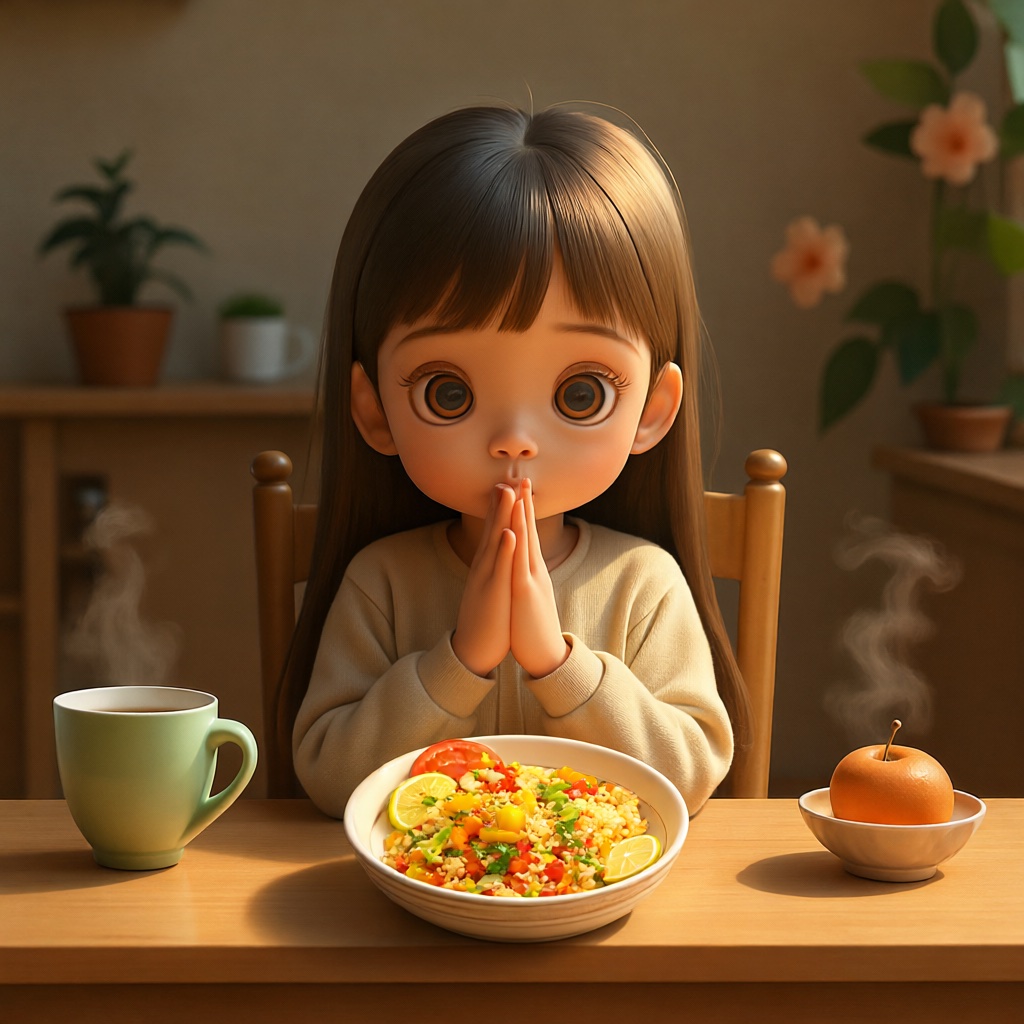 |
“在 <image1>(画布)上,把从 <image2> 中提取的食物碗放到木桌上……以与 <image1> 相同的柔和 3D 插画风格渲染新增的碗和食物,而不是 <image2> 的写实照片风格。……”
该指令包含缩放、透视、光照方向和阴影方向,并明确列出需要从画布中保留的内容:女孩的脸、她的开衫、冒热气的杯子、水果碗以及她身后的架子。第二个多引用示例将花卉瓷图案迁移到肖像场景中的茶壶上。
获取方式
权重:lightx2v/Qwen-Image-2.1-Lightning-v2-RL,位于 Hugging Face。基础模型:Qwen/Qwen-Image-2.1。训练与推理框架:ModelTC/LightX2V。
发布的文件采用 Diffusers 布局(QwenImage21Transformer2DModel,32 层,32 个注意力头),卡片的快速开始通过替换 pipeline 的 transformer,用 QwenImage21Pipeline 加载它们。仓库不包含 ComfyUI 格式的权重,发布时也没有转换后的 checkpoint、GGUF 构建或对应的加载器,因此 Lightning 在 ComfyUI 中的路径仍然是 v1 LoRA。
评论
使用 GitHub 登录后即可参与讨论。