Pika H3 Flex Turbo:2、4、8 步 H3 LoRA 合并于单个文件
akhaliq 将 Pika H3 Flex 与 H3 少步蒸馏融合成七个单文件 LoRA:2 步草稿、4 步提速、8 步高清,以及 rank-32 精简版本。
Pika 将 Flex 作为两个 LoRA 适配器发布在 H3 基础模型之上,而少步领域早已有面向同一基础模型的 turbo 蒸馏。把两者叠加,就能得到作者想要的效果:Pika 后训练得到的运动表现,推理次数却只有一半。在 ComfyUI 节点图中叠加两个 LoRA 是可行的,但需要两个加载器、两个强度控件,以及一个本可以只要一个文件的文件夹,因此这里的每个文件都是单个融合适配器。
无需自定义节点,也无需模型补丁。把一个文件放进 ComfyUI/models/loras,在现有 H3 工作流中用 LoraLoaderModelOnly 以强度 1.0 加载,然后选择该文件对应的步数即可。
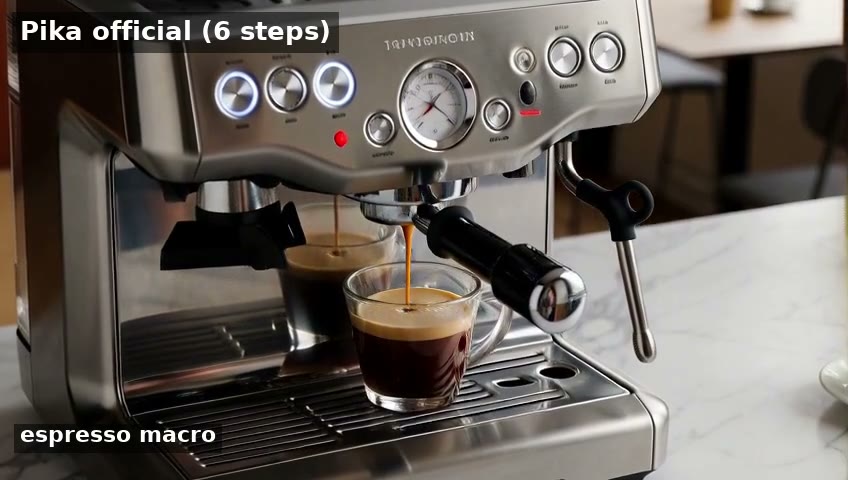 | 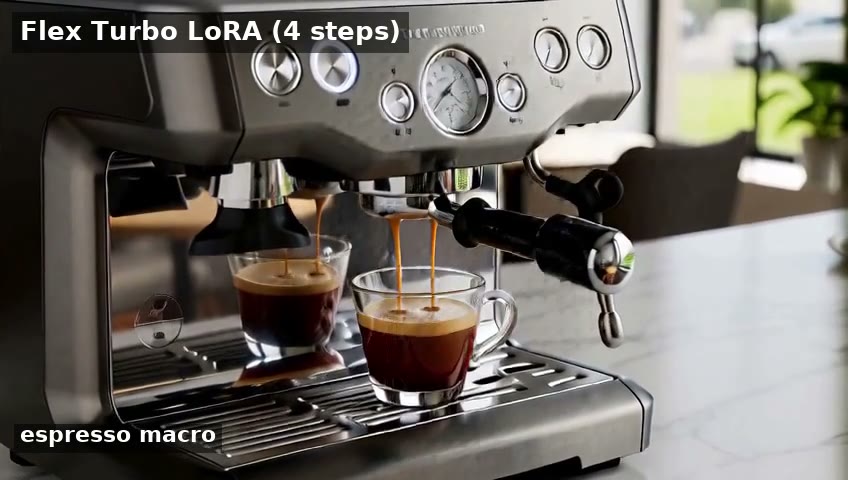 |
|---|---|
| Pika 官方适配器,六步 | 四步 turbo LoRA,相同种子 |
项目对比视频中的一个提示词,运行在原版 int8 H3 上,拆分为左右两个面板:左侧为官方六步,右侧为四步 LoRA。
五个提示词,相同种子,848x480 并带立体声音频:官方六步(左)对比四步 LoRA(右)。
每种速度一个文件
该系列按 transformer 和步数划分,因为 H3 的两个视频 transformer 承担不同任务。参考生视频文件用于参考工作流和画质向合并模型,FL2VA 文件用于默认的文本与图像转视频路径。
| 文件 | Transformer | 步数 | 大小 |
|---|---|---|---|
pika_h3_flex_turbo_2step_draft_ref2va.safetensors | Ref2VA | 2 | 3.9 GB |
pika_h3_flex_turbo_4step_fl2va.safetensors | FL2VA | 4 | 3.9 GB |
pika_h3_flex_turbo_4step_ref2va.safetensors | Ref2VA | 4 | 3.9 GB |
pika_h3_flex_turbo_8step_hd_fl2va.safetensors | FL2VA | 8 | 3.9 GB |
pika_h3_flex_turbo_8step_hd_ref2va.safetensors | Ref2VA | 8 | 3.9 GB |
pika_h3_flex_turbo_4step_fl2va_lite_r32.safetensors | FL2VA | 4 | 0.31 GB |
pika_h3_flex_turbo_4step_ref2va_lite_r32.safetensors | Ref2VA | 4 | ~0.3 GB |
4 步这一半中,FL2VA 使用 lightx2v v1.2 768p,Ref2VA 使用 ref2v v0.1,这是作者明确选择的结果,而非 v1.3,因为作者称 v1.3 存在已被确认的叠加回退问题。2 步文件则融合了 pDMD 2-NFE。Flex 风格已按比例烘焙进去:2 步和 4 步文件为 0.5,8 步高清对为 0.6,这正是 H3 社区在少步蒸馏之上叠加风格适配器时所确定的强度范围。
两个 lite_r32 文件是 rank-32 压缩版本:采用精确的 QR 乘积截断,在 0.31 GB 下保留了融合后 96.1% 的频谱能量,比完整的 3.9 GB 适配器小 12.6 倍。
精确融合,而非近似合并
对两个 LoRA 做朴素的加法合并会在输出侧 B 矩阵中发生冲突,作者引用了一篇 2026 年关于 LoRA 组合的论文来说明这一点。拼接则不会冲突,因此每个文件都是逐层的 rank 拼接:
B_fused @ A_fused == s·(B_flex @ A_flex) + 1.0·(B_turbo @ A_turbo)这使得融合文件在功能上等同于叠加加载两个适配器,而且是由构造保证的,而非通过拟合得到。作者在上传前逐层做了数值验证,经过一次 bf16 往返后最大相对误差约为 2.6e-7,随后又用下面的视频在 GPU 上做了端到端复验。
实测速度
相同基础模型、相同种子、相同提示词,CFG 1,848x480,121 帧,带立体声音频:
| 硬件 | 配置 | 步数 | 每 5 秒视频片段 | 相对官方 |
|---|---|---|---|---|
| H200 | Pika 官方适配器 | 6 | 60 秒 | 1 倍 |
| H200 | 本 LoRA | 4 | 40 秒 | 快 1.5 倍 |
| H200 | 本 LoRA,草稿档 | 2 | 约 25 秒(采样 14 秒) | 快约 2.4 倍 |
| H200 | 本 LoRA,高清档 | 8 | 70 秒 | 0.86 倍,画质优先 |
| A100 | Pika 官方适配器 | 6 | 109.3 秒 | 1 倍 |
| A100 | 本 LoRA | 4 | 66.0 秒 | 快 1.66 倍 |
| 基础 H3 | 无适配器 | ~40 | 约 500 秒 | 慢约 8 至 12 倍 |
在同一张卡上每步开销完全相同,H200 上约为 7 秒/步,A100 上约为 12.5 秒/步,因此全部节省都来自所需推理次数更少,而不是单步变得更便宜。
局限与失效场景
- 2 步文件是草稿工具。 在作者的第一批测试中,5 个镜头里有 4 个可用。用它来反复调整构图和运动,再用 4 步或 8 步渲染成片。
- 低于六步时音频会劣化,这对所有 H3 turbo 都成立。2 步时最严重,所以如果声音很重要,请用 4 步或更多。
- 步数不可互换。 4 步文件针对恰好 4 步调优,8 步高清对在 6 到 8 步时效果最佳。
- 不要在其上再叠加更多强适配器。 在 2 步和 4 步文件上以高强度加入重型风格或运动 LoRA,会抵消融合的意义。
作者还将这些文件用于 Singularity 等画质向合并模型,其中推荐搭配 4 步 Ref2VA 文件,并表示在下面的视频中,该组合比官方 Pika 六步既更快也更耐看。
高强度动作压力测试:武术和滑板跑动,官方六步(左)对比四步 LoRA(右)。少步模型在快速运动上最弱,因此这段视频最值得参考。
在 ComfyUI 中使用
- 将匹配你所使用 transformer 的文件复制到
ComfyUI/models/loras。参考工作流和画质向合并模型用 Ref2VA 文件,默认的文本与图像转视频用 FL2VA。 - 加载你常用的 MiniMax H3 工作流,添加
LoraLoaderModelOnly,强度设为 1.0。 - 按文件对应的步数进行采样,即 2、4 或 8 步,CFG 为 1.0,采样器用
euler、lcm或res_multistep,调度器用simple。FL2VA 的 Flow shift 为 6.0,Ref2VA 为 12.0,音频 shift 为 3.0。
仓库还附带 scripts/,其中有用于生成上述对比的五路渲染与采样器扫描脚本,以及 sampler_sweep_results.json,方便你复现某个特定面板。这些文件可以通过任何兼容 H3 的加载器加载,因此 Diffusers 也可以,同样的适配器也能运行在 int8 和 GGUF 的 H3 版本上。
获取方式
- akhaliq/Pika-H3-Flex-Turbo-LoRA 位于 Hugging Face,包含七个适配器、六段对比视频和渲染脚本
- 基于 Pika H3 Flex、lightx2v/Minimax-h3-Turbo 和 pDMD 2-NFE,构建于 MiniMax H3 基础模型之上
- 本文中的画面取自项目自带的对比视频
评论
使用 GitHub 登录后即可参与讨论。