Krea 2 Turbo 3步蒸馏 LoRA:细节超越 8 步教师模型
一个 rank-64 LoRA 在 cfg 1.0 下将 Krea 2 Turbo 从 8 步压缩到 3 步,精细纹理测量值为教师模型的 1.11 倍,并附带仅用原生节点的 ComfyUI 工作流。
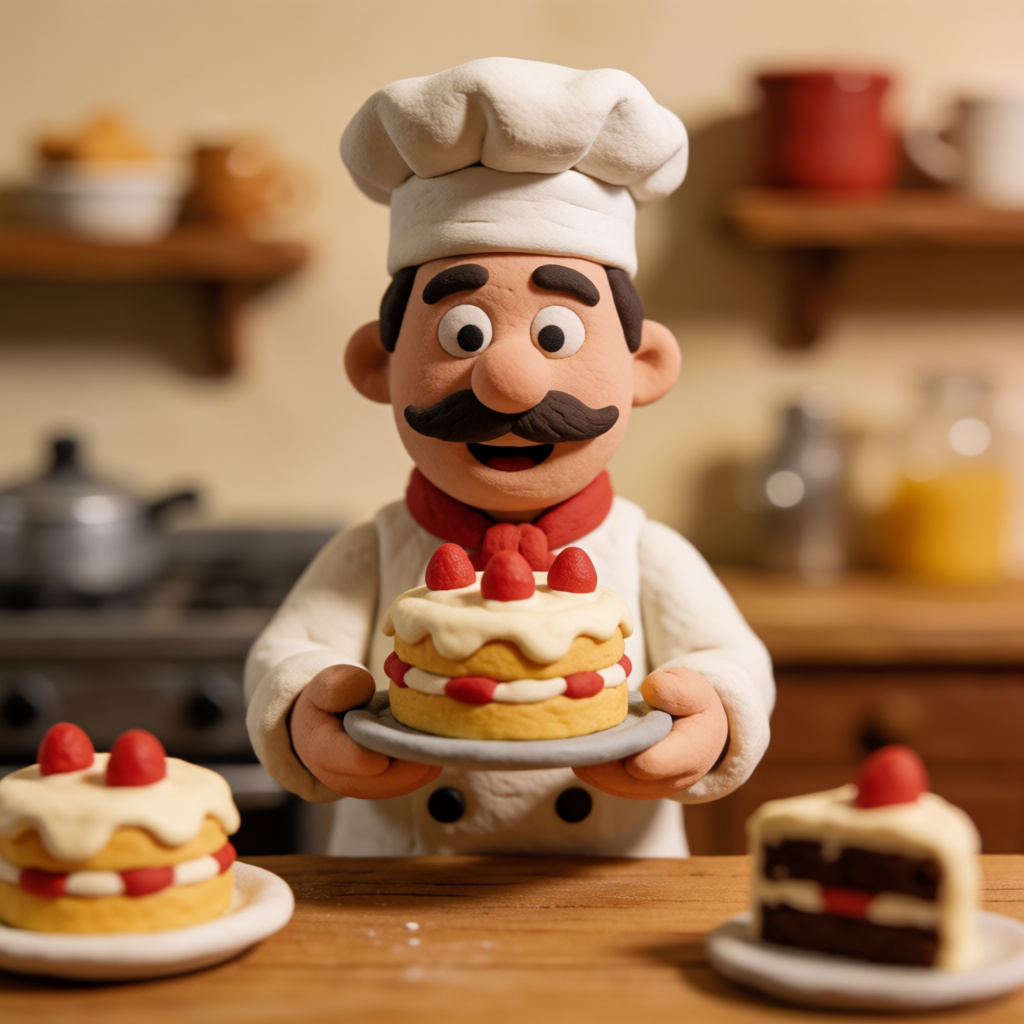
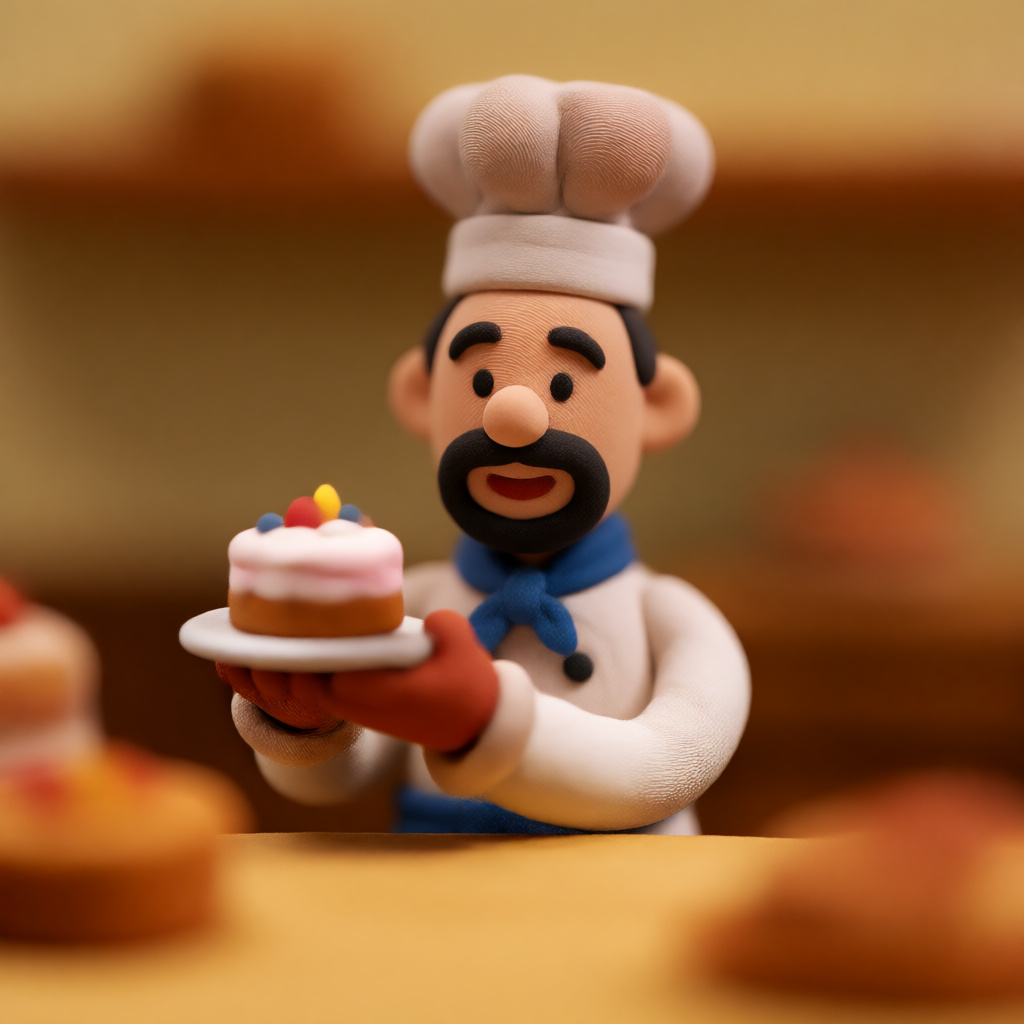
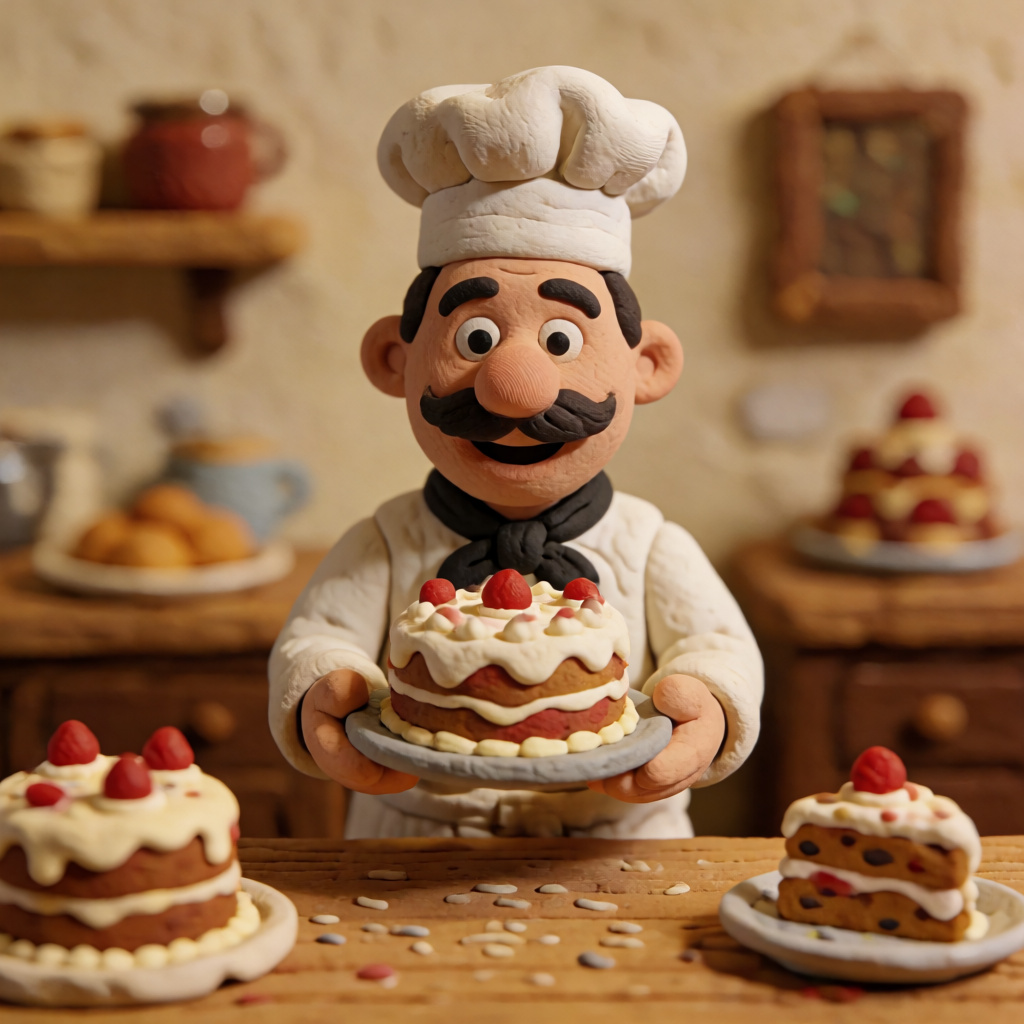
这位作者此前已经把 Krea 2 Turbo 从 8 步降到 4 步,随后又降到 2 步,现在补上了中间的空档:这个适配器让模型以 3 步运行,去噪速度约快 2.6 倍(1024x1024、float16 下从 65.4 s 降到 24.9 s,不含文本编码与 VAE 解码),同时在作者的 22 条测试提示词上测得精细纹理为 8 步教师模型的 1.11 倍,而 4 步适配器为 1.04 倍。原生 Turbo 在 3 步时只有 0.58 倍,这个 LoRA 正是要补上这段差距。
 |  |  |
|---|---|---|
| Turbo,8 步:质量基准 | Turbo 3 步,无 LoRA:发软且平淡 | 3 步加 LoRA:细节恢复 |
该项目仍在训练中:目前分享的 checkpoint 是 chk00030000,取自稳定后的权重,最后 600 个样本将学习率退火至零,作者预计还会有更多 checkpoint。仓库中的两个权重文件保存的是同一个 checkpoint,只是分别使用 diffusers 和 ComfyUI 的键名。
在 Turbo 自身的调度表上走三步
学生模型在 Turbo 自身的 3 步 Sigmas [1.0, 0.8633, 0.6123] 上做三次调用,使用模型标准的 mu 值 1.15,且不启用引导。训练从已发布的 4 步适配器权重开始,并保持其形状:在同样的 228 个模块上使用 rank 64。约 30,000 个样本取自记录的教师轨迹,覆盖 11 种分辨率,从 512x768 一直到 1440x1440 和 1824x1024。
有两点与更早的适配器不同。基础模型以 bf16 在单张 H100/H200 上运行(4 步和 2 步项目是在一张 RTX 3090 上针对仅权重的 int8 基础模型训练的),30,000 个样本耗时约 91 小时。另外,目标依然是分布匹配而非轨迹模仿:学生模型由八个评判器打分,这些评判器附着在冻结基础模型自身的中层网络特征上,覆盖伪影、真实照片可信度、首次调用的构图、内容、提示词一致性、文字、大尺寸人脸以及整个三次调用的展开过程。匹配教师模型可能产生的结果,而不是它的精确路径,正是这一点让三步采样不至于平均成模糊和重影边缘。
实测频段也印证了这一点:精细纹理为教师模型的 1.11 倍,16 像素与 8 像素频段分别为 1.10 倍和 1.12 倍,色彩则与教师模型持平。
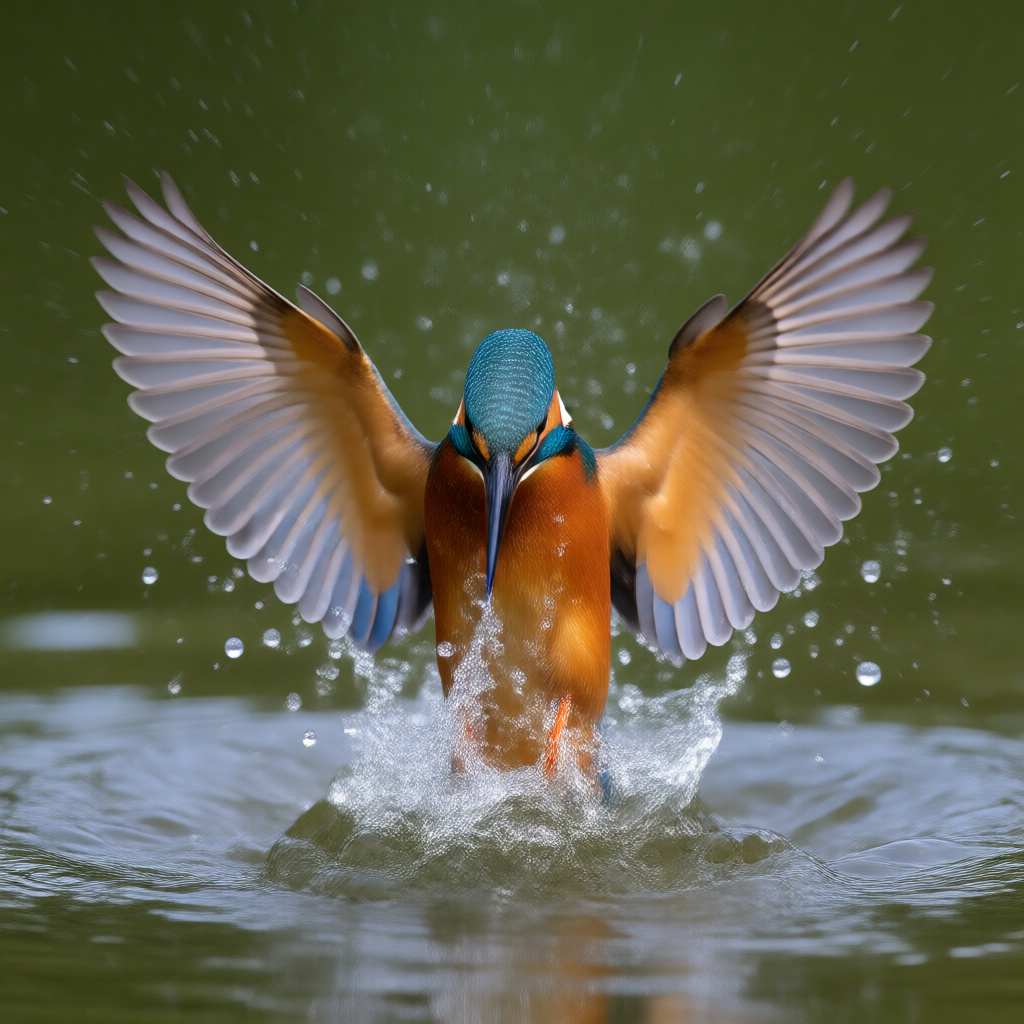
Turbo 在翠鸟提示词上以 3 步生成,未使用适配器。同一随机种子和提示词下 LoRA 的版本即封面图。
代价是什么
作者在公布收益的同时也公布了代价,在换用之前值得一读:
- 与教师图像的距离比 4 步适配器更远:距离 0.401 对 0.320,细节一致性 0.26 对 0.39。同样的噪波下三步是更短的路径,因此同一种子下的构图、姿态或某个小元素可能与 8 步渲染不同。教师图像是质量参照,而不是要复现的目标。
- 纹理比教师模型更强:平坦区域的颗粒感测得为教师模型的 1.57 倍,高于早前版本的 1.29 倍。水彩纸纹、皮肤毛孔和胶片颗粒更明显;强度低于 1.0 可以将其柔化。
- 轻微的重影边缘出现在头发、雨丝和细长肢体上,最常出现在 768x1024 和 1024x768:重影指数为教师模型的 1.14 倍,而 4 步适配器为 1.02 倍。
- 人群中的小尺寸人脸依然是一切少步适配器的弱项。
可用的 LoRA 强度窗口在 1.0 附近很窄,因为三步时适配器要独立完成把粗糙调用变成成品图像的全部工作。当与教师自身渲染的接近程度比速度更重要时,4 步适配器是更好的工具。
ComfyUI 使用情况
仓库提供了使用 ComfyUI 键名的 krea2_turbo_3step_rank_64_lora_comfyui.safetensors,以及 krea2_turbo_3step_lora_t2i.json,这是一个仅由原生节点搭建的工作流。
| 文件 | 放置位置 |
|---|---|
krea2_turbo_3step_rank_64_lora_comfyui.safetensors | ComfyUI/models/loras/ |
krea2_turbo_bf16.safetensors(来自 Comfy-Org/Krea-2) | ComfyUI/models/diffusion_models/ |
qwen3vl_4b_bf16.safetensors(同一仓库) | ComfyUI/models/text_encoders/ |
qwen_image_vae.safetensors(同一仓库) | ComfyUI/models/vae/ |
设置:步数 3,cfg 1.0,采样器 euler / simple,LoRA 强度 1.0。
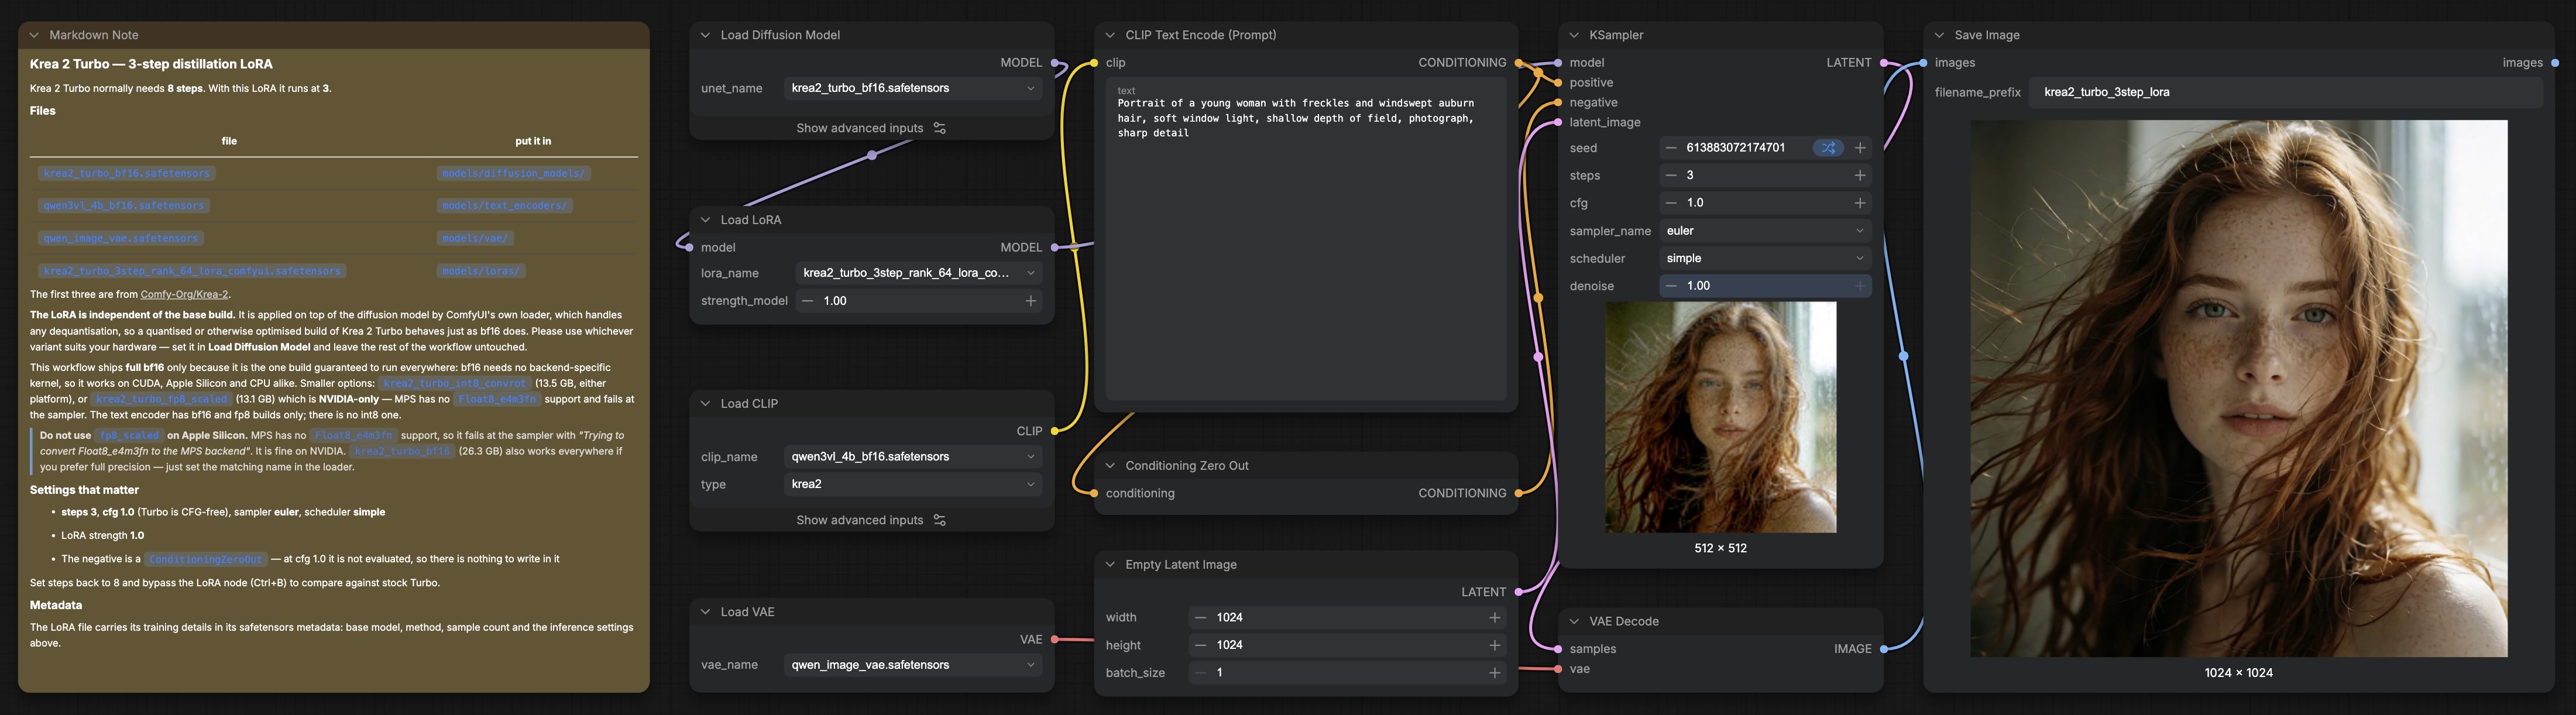
随附工作流:Krea 2 Turbo 加 3 步 LoRA,仅使用原生节点。
guidance_scale=0.0 就是同一设置的 diffusers 写法。
模型卡片还给出两点注意事项。量化基础模型会用细节换内存:在 Comfy Cloud 的 4-bit(nvfp4)Turbo 上,该适配器的精细纹理测量值比完整 bf16 渲染低约五分之一。另外在 Apple Silicon 上,fp8_scaled 版本无法加载,因为 MPS 没有 Float8_e4m3fn;仓库中另有一个 MLX 工作流,通过作者的 LVNodes Krea 2 MLX 节点运行同一个 LoRA。
作为额外福利,它也能加载到架构相同的 Krea 2 Raw 上:在 Raw 上以 13 步、CFG 3.5 运行,它保留 Raw 的构图,并补上 Raw 在该步数下缺失的细节。作者明确指出这属于未经训练的场景,而非受支持的模式。
获取方式
- Hugging Face:lvladikov/Krea2-Turbo-Distill-3step-LoRA,包含 22 张对比图以及
DETAILED-README.md中的完整训练记录 - 4 步 LoRA 仍是最接近 Turbo 8 步输出的选择;2 步 LoRA 则仍是预览选项
- 以上所有测量数据均来自作者本人,基于 22 条测试提示词;模型卡片按出现频率排序列出了已知问题
评论
使用 GitHub 登录后即可参与讨论。