Tessera:MiniMax H3 分块 4K/8K 视频超分
Tessera 是 ComfyUI 节点包,把 MiniMax H3 视频逐块精修到 2K、4K、8K,具备逐块条件与流式 VAE 编解码。
H3 擅长生成 544p 的短视频片段,而超过这一分辨率时成本高昂。现有的更高分辨率路线,要么以更大尺寸重新生成画面帧,并接受更慢、更不稳定的处理过程,要么直接放大像素从而损失细节。Tessera 走的是第三条路:将来源片段保留为模型已经理解的引用,用中性的重采样器放大画面,再让 H3 在精确的局部条件下重新渲染这块底板的每一片分块。
该包以纯 ComfyUI 节点形式发布,无额外依赖关系,版本为 1.0.0,其 pyproject.toml 中包含一个 [tool.comfy] 块(DisplayName = "Tessera"、PublisherId = "hashu786"),用于发布到 Comfy Registry。
 | 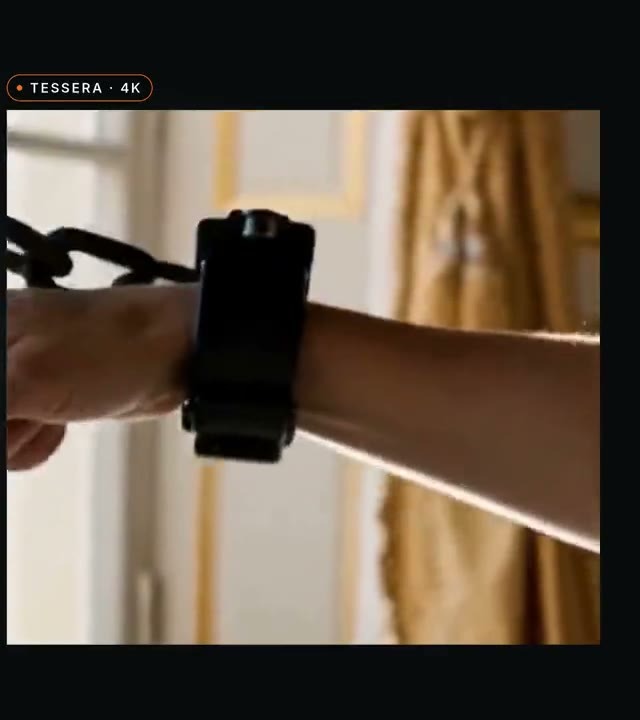 |
|---|---|
| 544p 的来源片段 | 来自该项目宣传视频的 3840x2176 渲染 |
分块锚定于整幅底板,而非彼此锚定
分块细化大型 Latent 的直观做法是按顺序遍历各分块,让每个分块继承相邻分块已完成的边界。Tessera 的作者测量了这种方法在 H3 上失败的原因:配准漂移会沿一行累积,四个分块分别达到 +1.5、-2.1、-9.3 和 -15.5 px,因为每个分块的条件化依据都是上一个分块的猜测,而不是来源。
Tessera 反转了这种依赖关系。每个分块都基于同一真值中属于自己的裁剪区域进行去噪:
- DiT 引用会裁剪到该分块窗口,并映射到该窗口的 Latent 网格上,因此视频引用和可选图像引用展示的是该分块在画面中的补丁,而不是整个镜头。
- 接入
clip输入时,文本会从该分块自身的裁剪区域重新编码。若未接入,内置引用节点会把整帧交给 Qwen,于是每个分块都会被告知一个它可能并不包含的主体,笔记中称之为幽灵主体失败。 - 引导保持在底板的精确网格上,若不匹配,节点会快速失败。
各分块还共享一个全局噪波场,而不是为每个分块单独抽取噪波;接缝处的条带会由两侧相邻分块在 32 px 的 seam_regen 带内共同生成,然后通过权重归一化累积进行混合。两个都看到同一条带的分块会产生精确的渲染到渲染交叉淡化,而不是重影式混合。
调度为一步头部加两步尾部
默认 Sigmas 为 1.0, 0.7, 0.4, 0.0:先用蒸馏 turbo 头部执行一步,再在精细尾部执行两步 euler。带内引导被视为频谱钳制,因此只对尾部加噪(guide_release 0.8),而非在整个运行过程中加噪。头部在完整证据下决定结构,尾部在自由度下补充纹理,到交接时已提交足够多的信号,内容无法再移动。
在作者的参考片段上实测,该组合在接近基线的闪烁水平下,相比冻结边框基线带来 +67% 的分块局部细节;而将完全相同的调度从 LMS 换成 euler,细节提升 +56%,同时闪烁降低约三分之一。两步头部更差而非更好:它会让状态收敛到柔和引导上,损失 21% 的细节;并且在一次实测运行中,蒸馏 turbo 模型以中间 Sigmas 走两步时会向 Latent 输出 NaN。
无特征的分块会被跳过而不采样。平坦底板的裁剪给模型零证据和完全自由,作者发现它会把引用中的人脸画进空白的天空与烟雾里,开启逐分块文本重编码后情况更严重。flat_skip(默认 4.0)会在这些窗口中保留原底板,并把采样时间还回来。该判定按分块、按块基于来源像素能量做出,因为连续两个 Latent 空间指标都被证伪。
流式处理放不下的部分
在 4x 下,一段 15 秒的片段以 float32 的 ComfyUI IMAGE 表示时,每份复制约为 36 GB,而普通节点图会占用三份复制,外加两次整段片段编码。这会在任何 GPU 上 OOM,因此 Tessera 将工作拆分:
- 流式编码 会在 H3 的 17-px 块网格上按时间窗口对来源进行放大和 VAE 编码,每个窗口还会进行一次 22-px 的预热重编码,随后丢弃。在一次经验证的 544p 到 4K 运行中,编码侧像素缓冲区峰值约为 5.2 GB,而让普通节点图 OOM 的整段片段复制则为 57.6 GB。
- 流式解码 通过一次流式解码组装输出,并在超过 4 GB 时使用磁盘后备缓冲区。此前,一个 124 帧的 8K 画布在单体解码中分配 49.7 GB 时失败。
- 磁盘预检 会在第一个分块采样之前运行,因为解码的暂存需求在计划阶段即可得知。有一次 8K 采样运行在分配 67.6 GB 缓冲区失败之前,已经耗费了 8 小时 49 分钟。
- 崩溃保险:如果输出阶段仍然失败,精炼后的 Latent 会保存为
tessera_rescue_<timestamp>.latent,节点图仍会返回一个 Latent,因此 LoadLatent 加上流式解码器无需重新采样即可恢复渲染。
快速运动的长片段会经过 Temporal Dilate / Decimate,它会提高每个时间跨度的帧率,并在返回时重新调整输出时序。分块窗口按真实内容秒数来编制预算:膨胀会把每个窗口中的内容切分,因此时间窗口会随膨胀系数缩放,以使每个窗口保留相同数量的运动结构。规划器还会将每个跨度中段的窗口起点对齐到 5 个 Latent 的倍数,匹配 H3 自身的 token 时序,即一个 head token 后每 token 四帧;此前一项 15 秒测试显示,在每个未对齐的分块中都会出现 17-px 帧的闪烁节拍器。
实测运行
作者给出的 544p 到 4K 路径参考运行:一段 15 秒视频片段、617 个时间膨胀帧、18 个窗口、在 3 个对齐分块中共 24 个 tile,单张 GPU 上总计 3 小时。帧间振荡落在 均值 2.44%、峰值 16.1%,而同一视频片段的 2 倍参照结果为 2.32% 与 12.3%,自相关中也不再残留 17 帧的特征信号。
发布次日,非作者本人在 Banodoco Discord 中发布的运行结果:
- LDWorks David,使用 BF16 权重的 RTX 6000 Pro:121 帧,2K 到 4K,84 步 refine,每步约 32 秒,44 分钟完成 93%。
- seitanism:1344x768、362 帧,经时间膨胀至 583 帧,在 2688x1536 下渲染耗时 46:58;第二段视频从 1920x1088 到 3840x2176,耗时 53:08;第三段以 Qwen-Image 2.1 生成的静帧作为帧锚点,耗时 27:48。他的评价是:它并不能修复所有运动伪影,但表现依然可靠。
- mdkb:在 12 GB 的 RTX 3060 上,对照自己 20 分钟的时间预算进行了测试,并询问是否有低显存方案。作者的回答是这类方案尚未推出:当前发布的默认配置面向高显存显卡。
ComfyUI 使用方法
将仓库克隆到 ComfyUI/custom_nodes/ 即可安装。当所有内容注册成功后,启动控制台会打印 [Tessera] loaded 9 node(s)。
| 节点 | 功能说明 |
|---|---|
| Tessera Tile Plan | 试运行:在消耗 GPU 时间之前,先预览网格、分块布局与开销 |
| Tessera Streamed Encode | 将来源转换为 plate Latent 以及引导条件,按时间窗口分段处理 |
| Tessera Refine | 分块精修器,支持逐块条件、分块处理、hero 块、平坦块跳过以及防崩溃输出 |
| Tessera Streamed Decode | 独立的流式解码器,同时也是被救援 Latent 的恢复路径 |
| Tessera Guide Anchor | 将一张细节丰富的静态图拼接进引导的精细频段,并做位移校正与光流传播 |
| Tessera Temporal Dilate / Decimate | 按跨度进行帧率扩张与精确重定时 |
| Tessera Guide Grain | 为引导匹配颗粒感 |
| Tessera Extra Options | 专家级参数开关,附带经过验证的默认值 |
随附的工作流会将来源片段作为 H3 引用、使用按所选缩放比例生成的 Lanczos plate、可选的 Qwen-Image 2.1 首帧锚点,以及作者作为惯用配方的一组 LoRA(来自 Alissonerdx 的 H3 包 的 LMS 细节 LoRA 和一个 3 步 turbo LoRA)。它以 544p 的来源为目标实现 4 倍放大,最终输出 3840x2176。
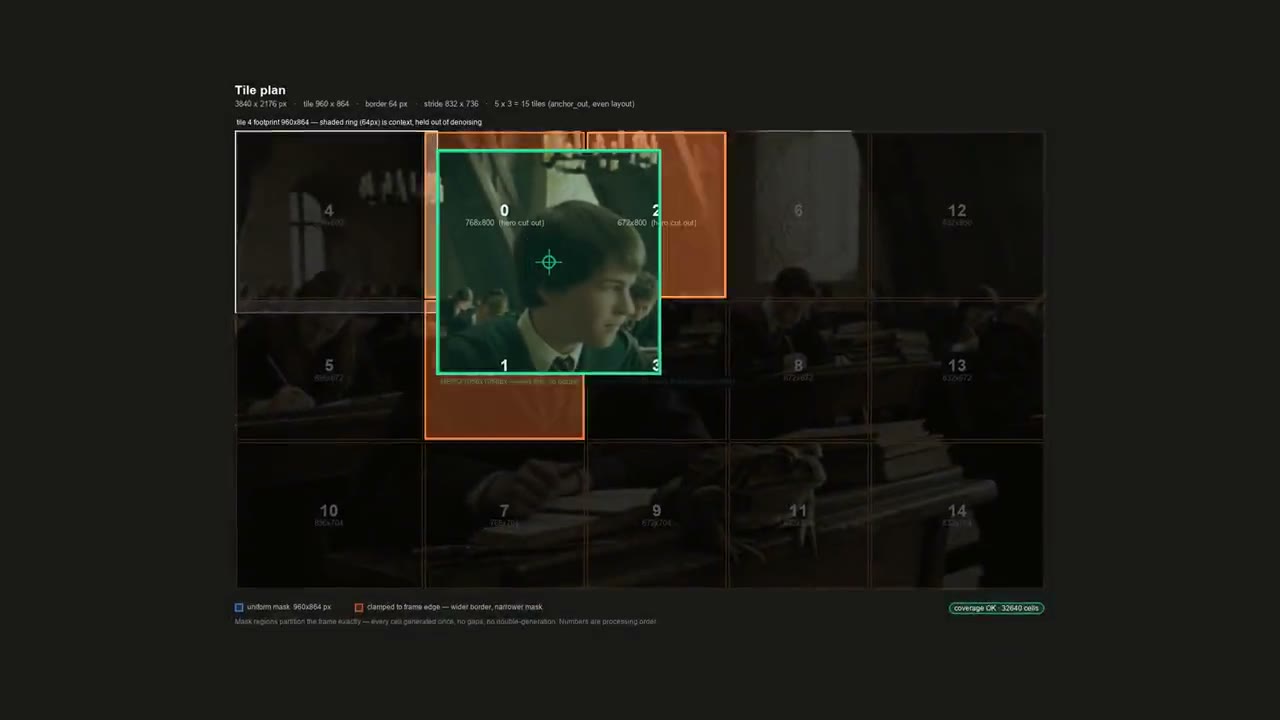
宣传视频中的 Tile Plan 节点:运行之前的网格、分块与预估开销。
示例使用的模型:MiniMax H3 ref2va(作者配置中的剪枝 int8 版本)、H3 视频与音频 VAE、Qwen3-VL 文本编码器,以及用于锚点静态图的可选 Qwen-Image 2.1 checkpoint 及其 turbo LoRA 和纹理修复 VAE。该工作流还需要 SAM3 与 KJ 节点包,以支持可选的 hero 遮罩和预览节点。
需要了解的局限
- 示例只针对一个目标进行接线。 预期输出大小和缩放系数是两个独立的控件;两者都必须与你加载的片段相匹配。一位 Discord 测试者把随附的工作流用在另一段片段上,期望 2x,结果得到了一块 4K 画布,他认为效果比原素材还差。
- 静帧锚点是一个 2x 工具。 在 4x 及以上时,说明建议不接入它,让模型渲染头部,因为拼接会在同一纹理的两种不同渲染结果之间做交叉淡化。
- 来源闪烁会被继承。 低分辨率来源自身在细频段上的抖动,放大后会变成放大的“游动”感:细化能把一致性提升到大约 0.75,但无法超过这个值。
- 场景切换只是建议性的。 切点判定器会打印它找到的帧,并建议在那里切分片段;同一个窗口内的短镜头无法同时满足头部时序规则和内容时间预算。
- 第二次跳转会以较低的 sigma 进入,例如
1.0, 0.923, 0.55, 0.0,并且第二跳的底板应该是第一跳的输出,而不是重新软化的中间结果。
可用性
- hashu786/ComfyUI-Tessera 托管于 GitHub,包含
example_workflows/tessera_upscaler.json,以及docs/LAWS.md中的完整工程笔记 pyproject.toml中带有供 Comfy Registry 使用的[tool.comfy]配置块(DisplayName = "Tessera");在扫描时该包尚未上架注册表,因此请从仓库安装- 本文中的引用帧取自该项目的宣传视频,视频将 544p 来源与 4x 渲染结果进行对比
评论
使用 GitHub 登录后即可参与讨论。