Primal VAE:2 倍下采样,匹配 Flux Latent 形状
Ostris 发布了 Primal VAE,这是两个约 8000 万参数的自编码器,仅做 2 倍下采样,把 8 倍 patchify 留给 DiT,并且不携带任何缩放因子或偏移因子。
2x1 下采样 2 倍并输出单通道,2x2 输出两个通道。
大多数现代 VAE 会把图像压缩 8 倍,然后交给扩散模型一个需要用实测缩放因子、偏移因子或批归一化统计量重新缩放的 Latent。Primal VAE 走的是另一条路:VAE 只做 2 倍空间压缩,剩下的 4 倍由 DiT 自身的 patchify 步骤提供。一个 2 倍分辨率下的单通道 Latent 经 4 路 patch 后变成 8 倍分辨率下的 16 通道,与 Flux.1 VAE 产生的形状相同;双通道变体则落在 8 倍分辨率下的 32 通道,即 Flux.2 VAE 的形状。
| 模型 | Latent | 4 路 patch | 形状等同于 |
|---|---|---|---|
2x1 | 1 通道 @ 2x | 16 通道 @ 8x | Flux.1 VAE(16 通道 @ 8x) |
2x2 | 2 通道 @ 2x | 32 通道 @ 8x | Flux.2 VAE(32 通道 @ 8x) |
两个模型都约 8000 万参数,图像边长需要是 16 的倍数。
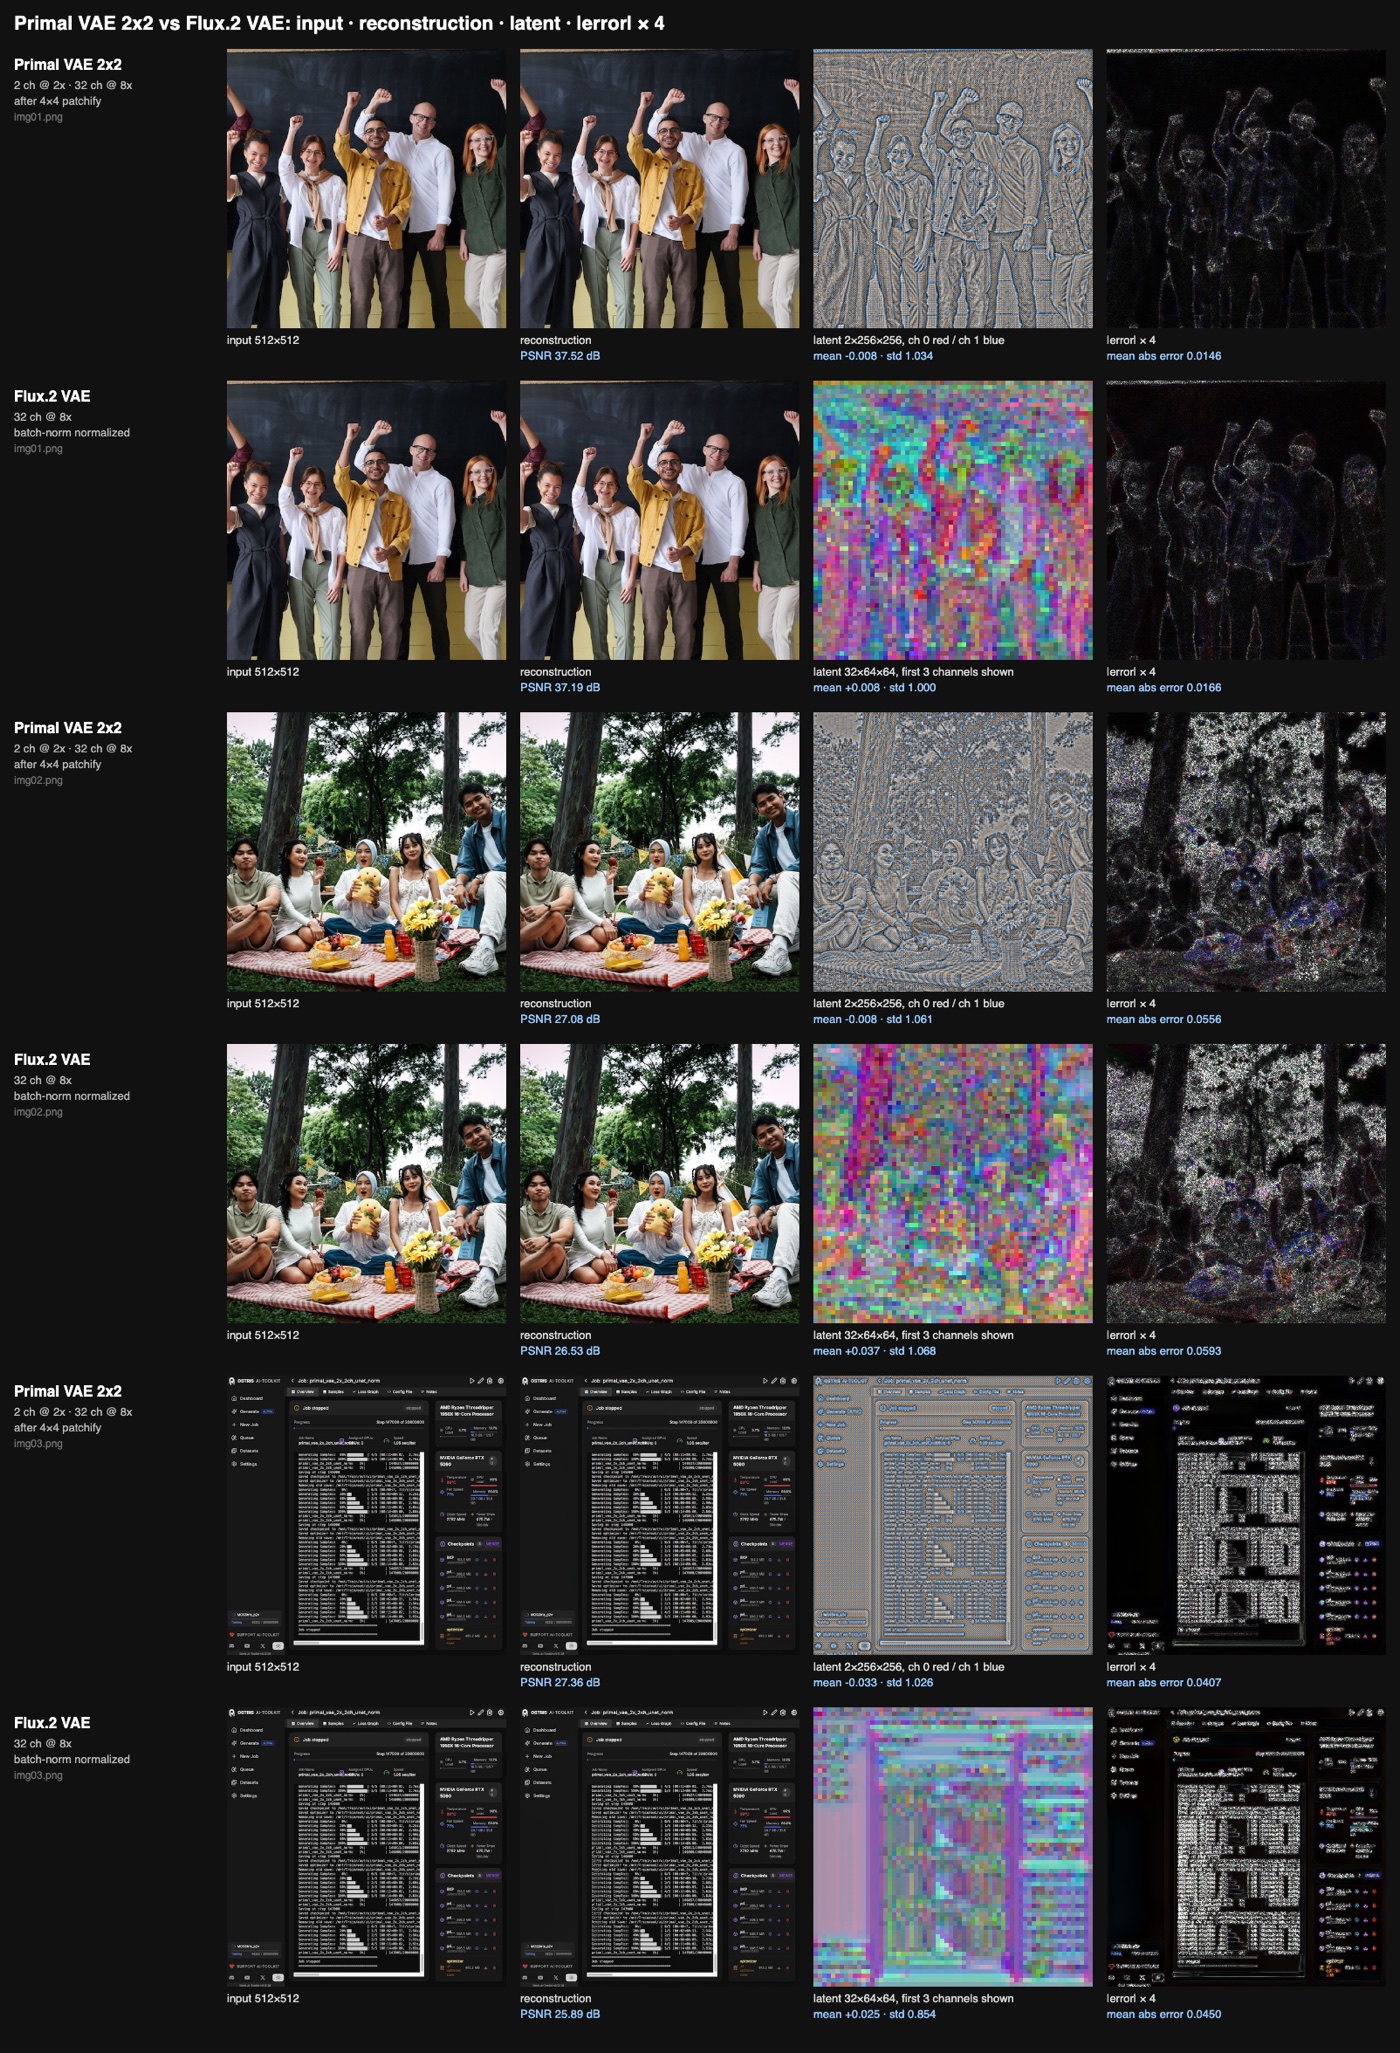
每一行依次是输入、重建结果、Latent 和 |error| x 4。每个 Primal VAE 行的下方是采用相同 Latent 布局的 Flux VAE,作用于同一张图像。Latent 按 3 sigma 绘制;双通道 Latent 的通道 0 显示为红色,通道 1 显示为蓝色。
仓库中三张 512 px 图像的重建质量,单位为 dB:
| 图像 | Primal 2x1 | Flux.1 VAE | Primal 2x2 | Flux.2 VAE |
|---|---|---|---|---|
| img01(人物、影棚) | 32.1 | 35.7 | 37.5 | 37.2 |
| img02(野餐、枝叶) | 22.0 | 24.2 | 27.1 | 26.5 |
| img03(UI 截图) | 21.3 | 24.7 | 27.4 | 25.9 |
作者明确表示,三张图像和 PSNR 并不构成基准测试,而且 KL VAE 的后验噪声会带来重建代价,这是确定性 VAE 所没有的。在每 8x8 像素块 32 个数值的相同信息预算下,2x2 变体与 Flux.2 VAE 持平或更优。2x1 变体在纹理丰富的内容上落后于 Flux.1 VAE:2 倍分辨率下的单通道是 12:1 的压缩,没有任何余量,而且它获得的训练步数不到 2x2 版本的一半(62k 对 147k)。
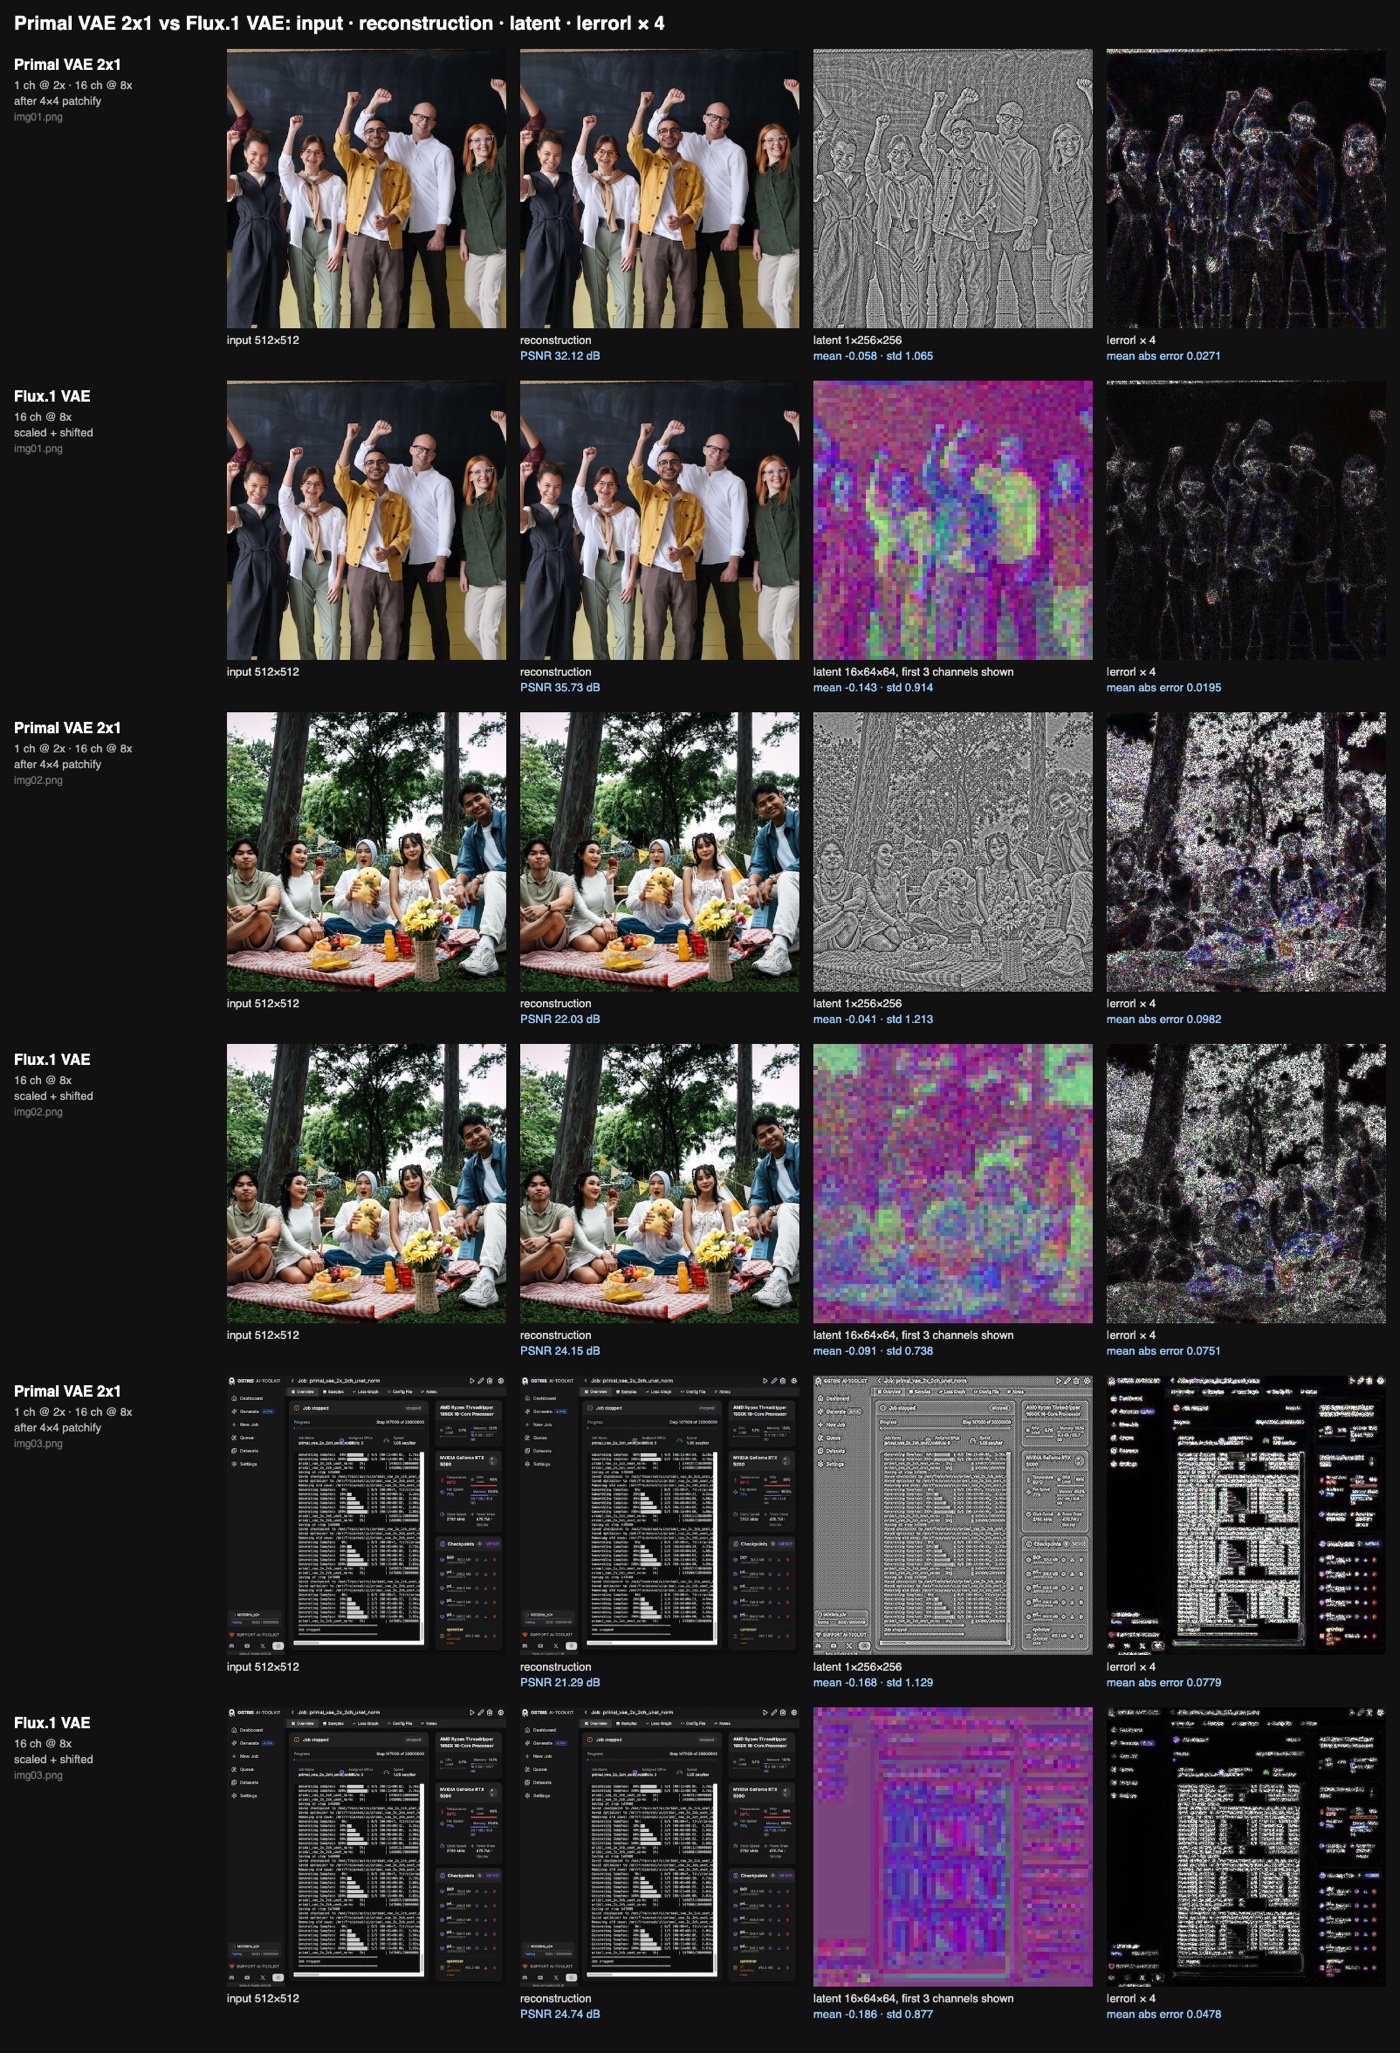
单通道对比。单通道 Latent 以灰度显示,其逐图像标准差仍会漂移,从 1.07 到 1.21,因为它只在最后 9k 步接受了逐图像归一化。
架构
两个变体是同一个网络,只有输出通道数不同:
- 输入经过
pixel_unshuffle(2),因此 RGB 变成半分辨率下的 12 通道。所有计算都在 Latent 分辨率或更低分辨率下进行,这让 Latent 保持为图像在空间上忠实的映射。 - 编码器和解码器是镜像的卷积 U-Net,在图像尺寸的 1/2、1/4、1/8 和 1/16 处共有四个层级,宽度为 96 / 192 / 384 / 384,残差块的膨胀率按 1、2、4 循环。
- 归一化是每个位置上跨通道的 RMSNorm。没有空间统计量,也没有注意力,因此在给定一定重叠的情况下,一个图块的编码解码结果与完整图像一致。
- 编码器以普通的 3x3 卷积结尾,输出 1 或 2 个通道。没有后验,没有 KL 项,也没有量化卷积。
让 Latent 与噪声保持一致
扩散模型是针对高斯噪声训练的,因此 Latent 本身就应该看起来像高斯噪声。这里不添加 KL 项再事后测量缩放因子,而是直接把统计量写进编码器输出上的损失:
- 矩损失:
mean^2 + (std - 1)^2,权重 0.1,按图像和通道分别计算,因此每张图像都以均值 0、标准差 1 输出,而不是只有数据集整体平均如此。 - 高斯顺序统计损失:对每张图像、每个通道的 Latent 值排序,并与同尺寸标准正态分布的期望顺序统计量匹配,使用 Blom 近似。这固定的是整个分布形状而不只是前两阶矩,因此一张纯灰图像编码后仍会接近噪声,而不是一个常数。
正因如此,不需要携带任何缩放因子、偏移因子或 Latent 归一化,编码返回的是普通张量而不是分布:encode 给出 [B, 1, H/2, W/2],没有 .latent_dist,也没有采样步骤。
训练
重建损失为权重 0.5 的 MAE 和权重 1.0 的 LPIPS,另外加上对数幅度二维频谱上的 L1 项(权重 0.1),用于推动高频能量而不要求精确相位。在此基础上,还有若干技巧旨在让 Latent 更易于扩散:
- 取自 EQ-VAE 的 Latent 翻转与旋转:在 50% 的步骤中,Latent 被翻转或旋转 90 度,并与同样变换后的图像一起解码,因此 Latent 必须是图像的写照,而不是任意编码。
- 噪声扰动的解码:在 20% 的步骤中,解码器接收
z + sigma * noise,其中sigma按图像从U(0, 0.5)中抽取,并且仍要重建干净图像,这让解码器学会容忍扩散误差。 - 5% 的图像被替换为随机纯色,因为平坦区域正是逐图像归一化 Latent 的难点。
- 2x1 变体在最后 9k 步引入了判别器:一个冻结的 SigLIP2 NaFlex ViT 在原生分辨率下从真实图像和重建图像的第 4、8、12 层提供 patch 特征,小型谱归一化卷积头以 hinge 损失加 R1 训练,解码器接收权重 0.1 的生成器项。2x2 版本训练时没有判别器。
发布的权重文件就是训练检查点本身,未作改动,为 fp32。推理时以 torch_dtype=torch.bfloat16 加载大约损失 0.05 dB。
可用性
Primal VAE 目前还无法在 ComfyUI 内使用。没有自定义 VAE 加载节点,没有 Comfy-Org 重新打包,也没有核心支持:仓库提供的是 diffusers AutoModel 实现,需要 trust_remote_code=True(modeling_primal_vae.py 加 config.json),文档给出的路径是先 AutoModel.from_pretrained("ostris/primal_vae", variant="2x1"),再用 patchify / unpatchify 得到 Flux.1 或 Flux.2 的 token 布局。
10 月 31 日开启的一个仓库讨论直接询问它能否在 ComfyUI 中运行,目前还没有可行的答案;另一个社区讨论提供了一个单文件 Rust 构建,用于在 GPU 或 CPU 上本地推理。
其他一切都还在 Python 范畴:vae.encode(x) 返回 Latent,vae.patchify(latent, compression=8) 将其转换为 Flux.1 形状或 Flux.2 形状的 token,vae.decode(vae.unpatchify(tokens)) 再把它还原,两侧都不施加缩放或偏移。架构是从张量形状读取的,因此从 ai-toolkit 导出的微调可以用 weights_name="my_finetune.safetensors" 加载。
评论
使用 GitHub 登录后即可参与讨论。