RelayVSR X2:基于 H3 片段训练的 2 倍视频超分模型
LightX2V 团队重新训练 RelayVSR,使其成为原生 2 倍视频超分辨率模型:在 H100 上达到 45 FPS,具备闪烁抑制能力,并提供两个模型权重。
scripts/relayvsr 运行,目前尚无对应的 ComfyUI 节点。
768x1344 的 H3 片段翻倍到 1536x2688 恰好干净利落,这是常见的成片分辨率。而 RelayVSR 只支持 4 倍,同一片段会被推到 3072x5376,为多数镜头并不需要的输出付出四倍的像素计算量。X2 直接以 2 倍计算,而不是先算 4 倍再缩小。
先抑制闪烁,再谈锐度
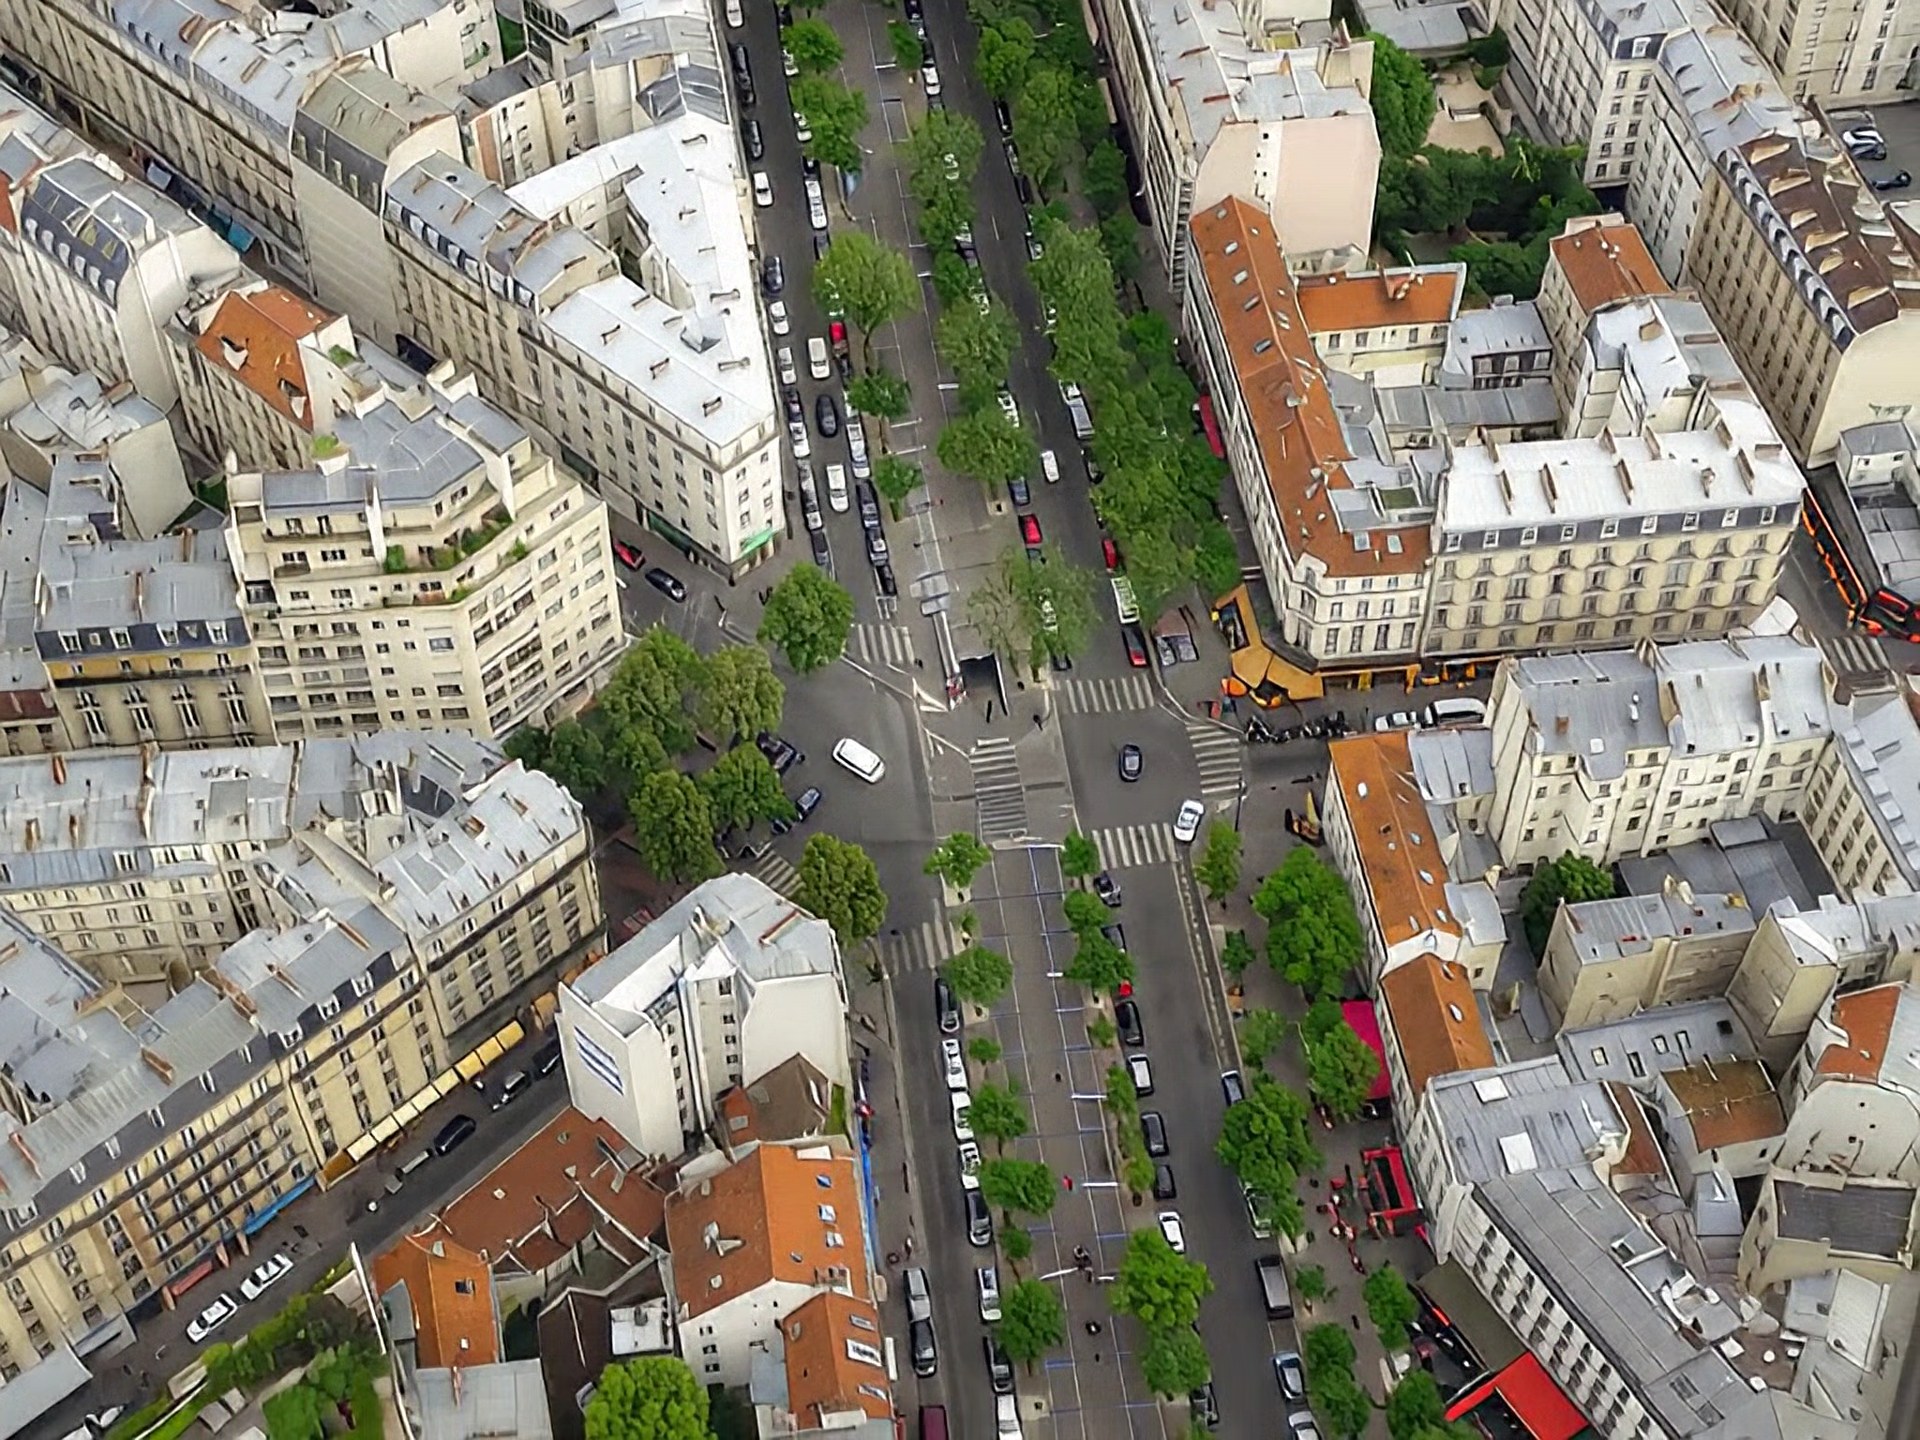
超分辨率模型往往会放大生成视频本身已有的轻微时间闪烁,因此即便单帧看起来更锐利,放大后的片段在运动中可能反而比原始素材更差。RelayVSR 的设计正是针对这一点:大型生成模型只为稀疏关键帧生成引用 latent,小型 VSR 网络则把这些引用传递到每一帧;在 LightX2V 的实现中,还带有有限前瞻和帧环 KV 缓存。
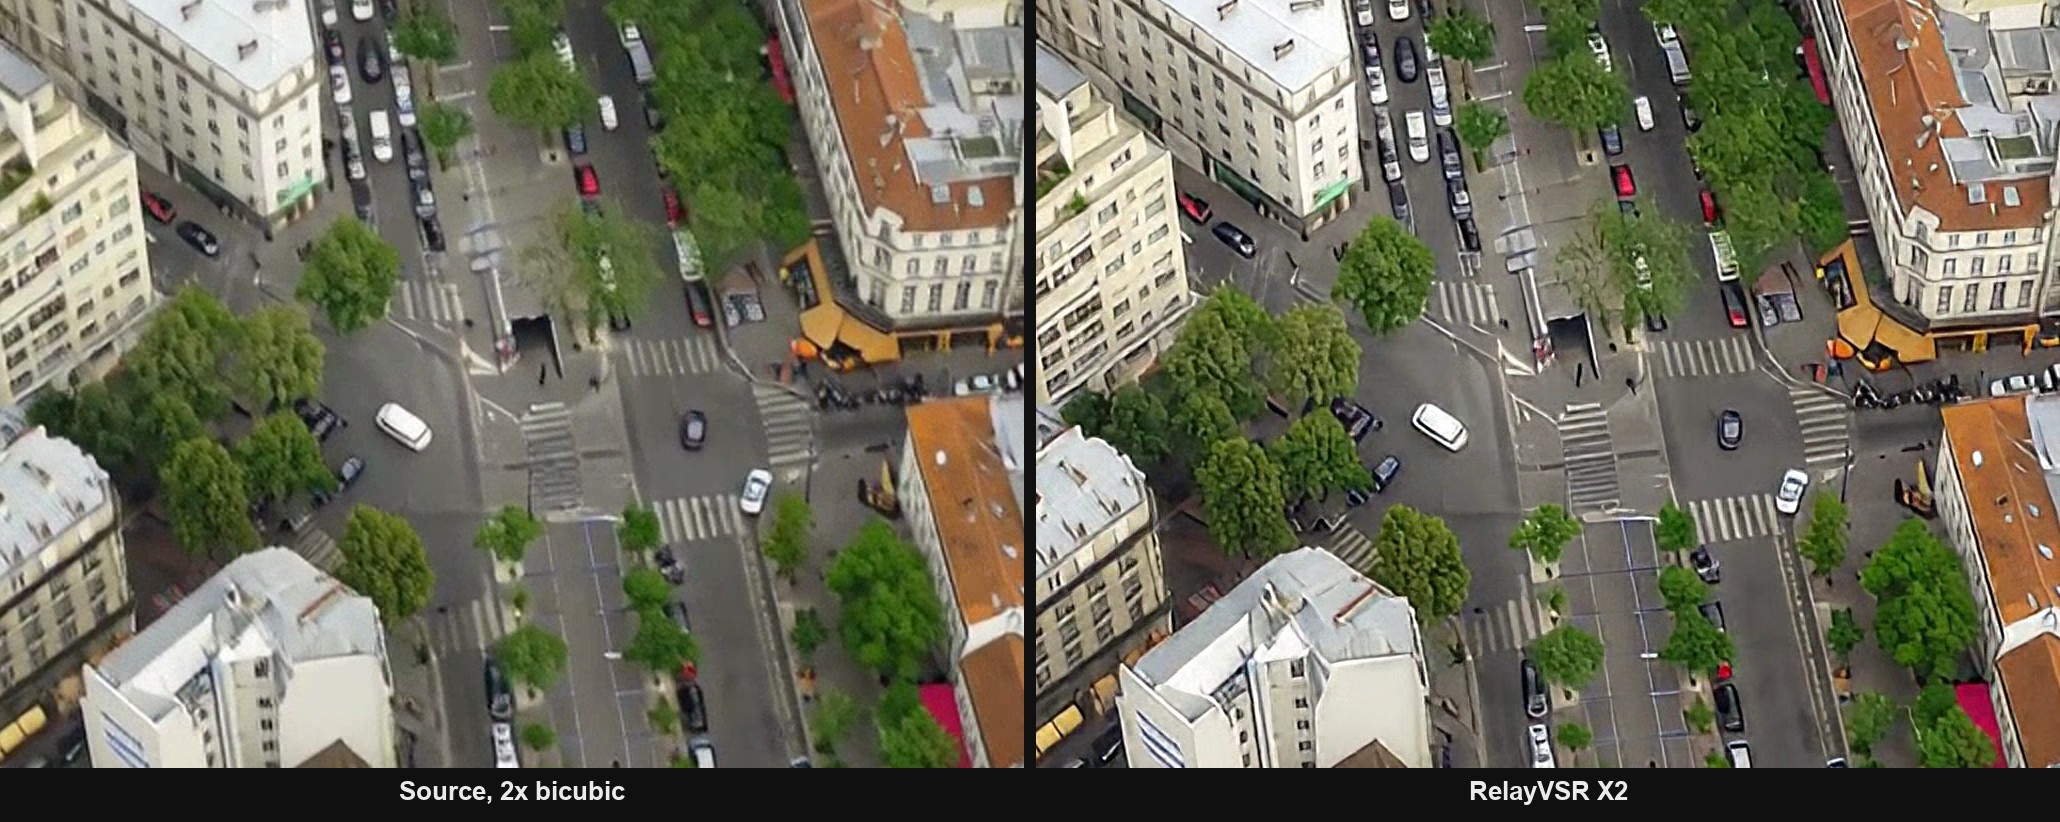
已发布的基准输入本身就是 H3 的输出:一段 1024x768、24 fps 的无人机屋顶镜头,原本就带有轻微闪烁,因此对比网格展示的正是模型训练所针对的场景,而不是干净的相机素材。
两个模型,一个倍率
X2 版本以两个文件发布,必须下载到同一目录:
wan_x2.safetensors(10.1 GB),基于 Wan 的模型,负责生成稀疏关键帧引用。flash_x2.safetensors(127 MB),紧凑的条件解码器,负责对其余帧做超分辨率。
LightX2V 运行器会校验缩放倍率与架构,并拒绝混用 2 倍与 4 倍权重,而不是加载不匹配的组合。输出尺寸不是用户可设置的选项:它由输入尺寸和 sr_ratio 决定,而在 X2 模型上 sr_ratio 必须为 2。旧的 4 倍模型同样接受 sr_ratio=2,但它在内部按 4 倍计算再缩小,而这正是本次发布要避免的开销。
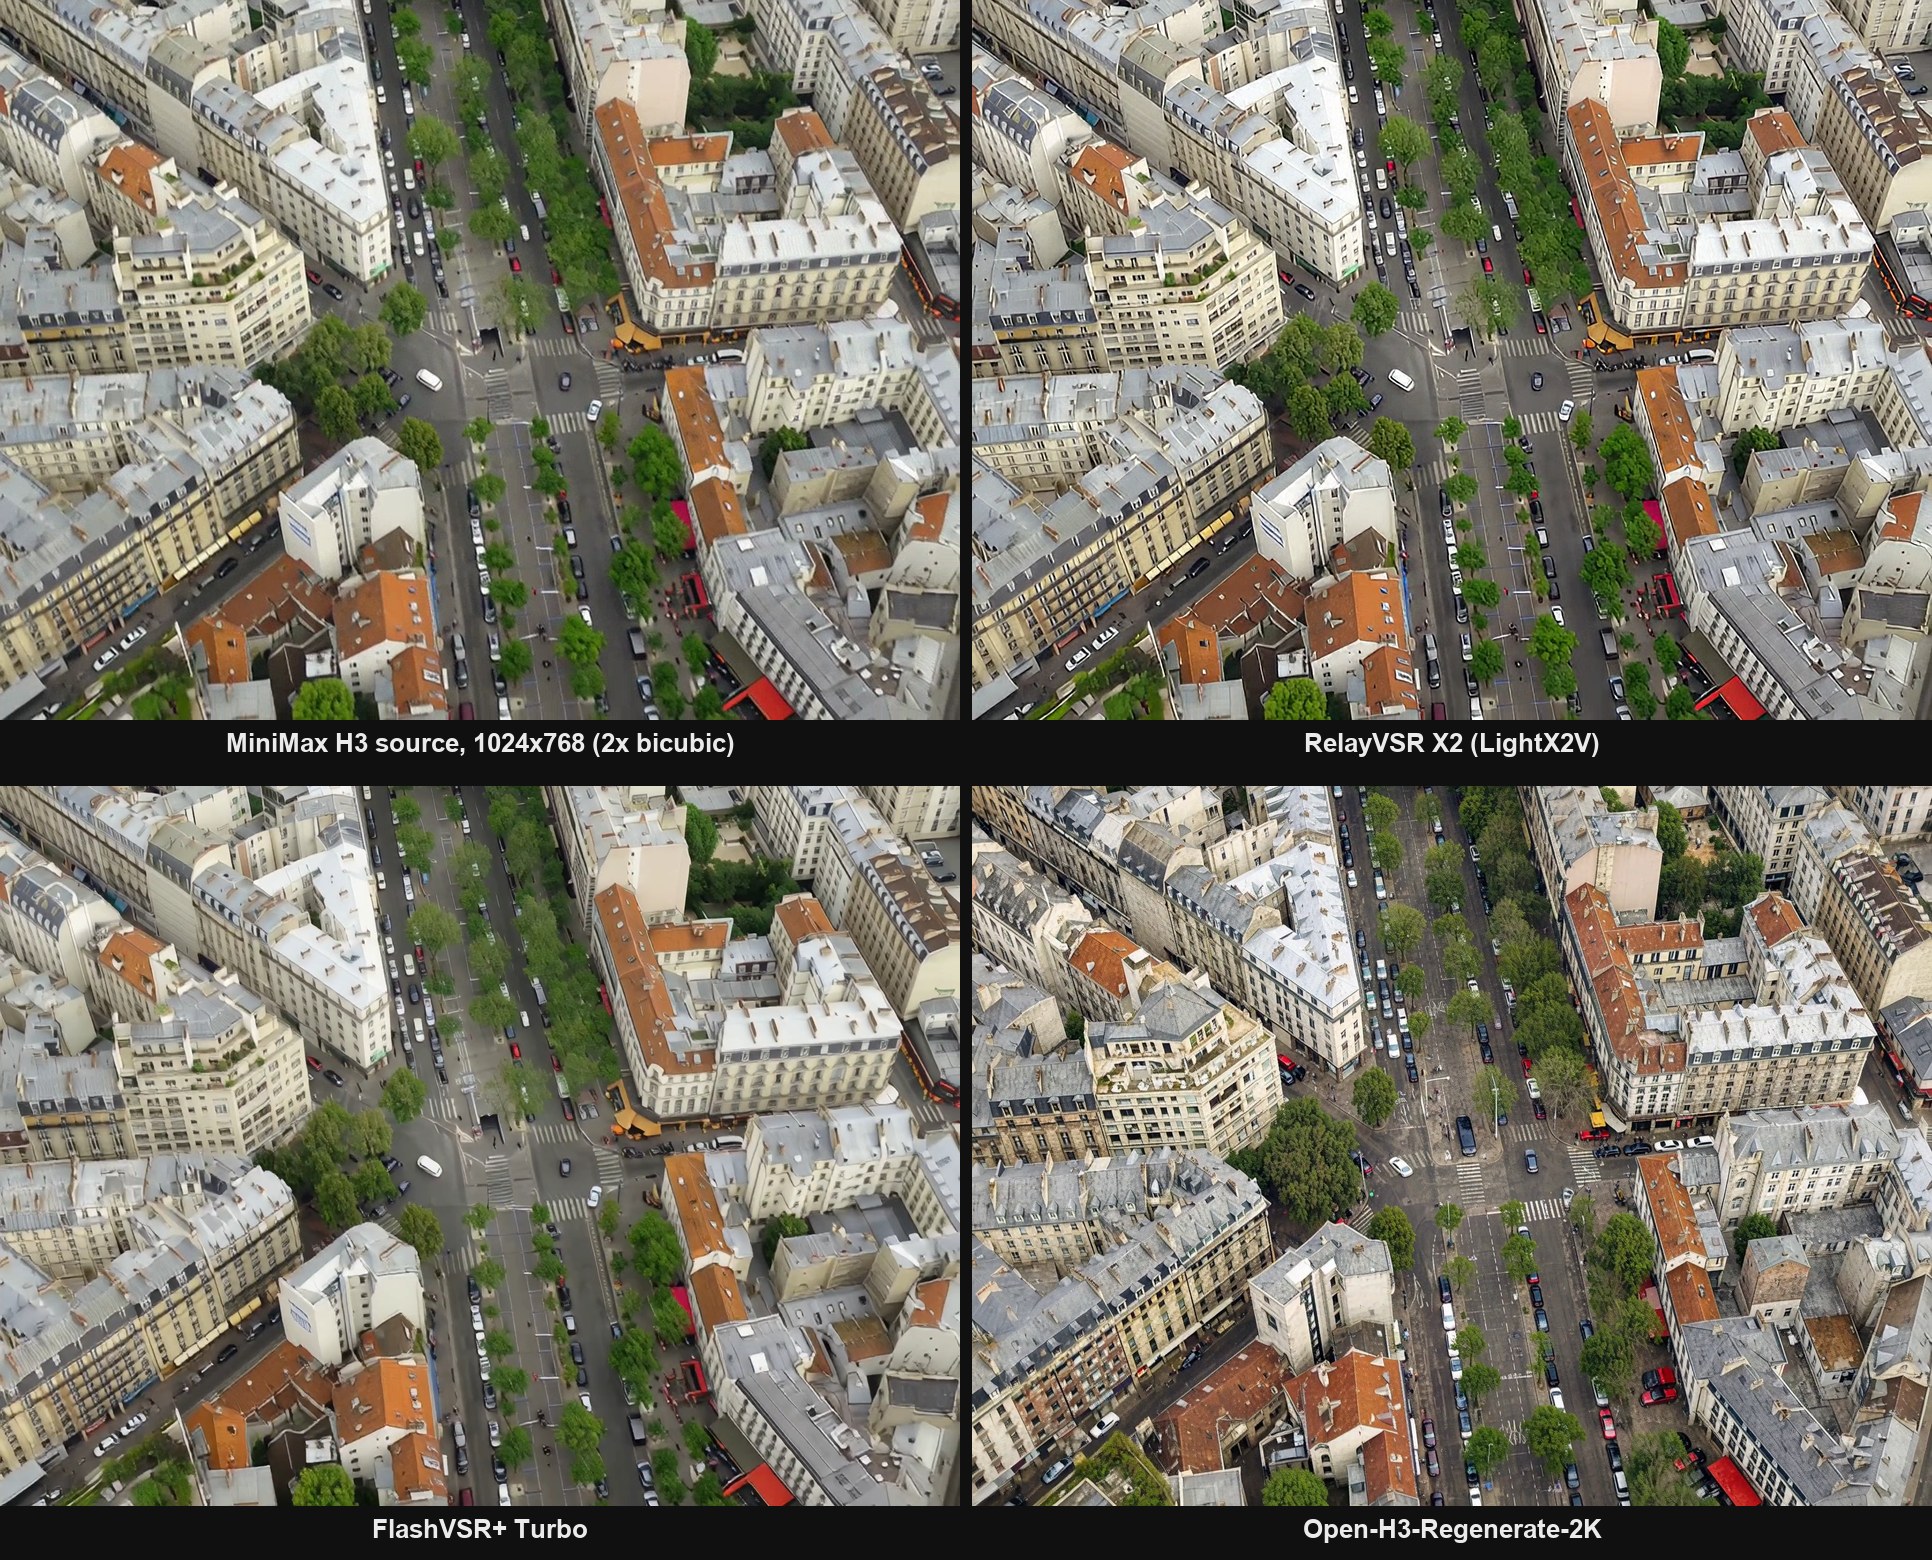
同一帧,960x720 显示尺寸:H3 源视频经 bicubic 2 倍放大(左上)、RelayVSR X2(右上)、FlashVSR+ Turbo(左下)、Open-H3-Regenerate-2K(右下)。帧取自已发布的基准片段。
在单张 H100 上的实测
卡片报告的是每个模型在同分辨率预热后的一次实测运行,在单张 H100 80GB 上顺序执行,环境为 PyTorch 2.11.0 与 CUDA 13.0,输入为 1024x768、24 fps 的 243 帧:
- RelayVSR X2(LightX2V):5.348 秒,45.44 FPS,输出 2048x1536
- SwiftVR(LightX2V):6.399 秒,37.98 FPS
- SwiftVR:7.252 秒,33.51 FPS
- RelayVSR 4x(LightX2V):19.304 秒,12.59 FPS,输出 4096x3072
- RelayVSR 4x:26.332 秒,9.23 FPS,输出 4096x3072
- FlashVSR+ Turbo:54.024 秒,4.50 FPS
- SeedVR2-3B:352.820 秒,0.69 FPS
- Open-H3-Regenerate-2K:784.954 秒,0.31 FPS
这些是 10 秒片段在 H100 上的数据。原始 4 倍模型背后的论文报告称,在 A100 上 1080p 可达到 29.29 FPS、峰值内存 13.82 GB,而 FlashVSR-Tiny 为 7.80 FPS、24.447 GB,可见该架构的目标是留在单张 GPU 内运行,而非在跑分平台上取胜。
Banodoco 上一位早期用户的测量表明,消费级硬件上的差距也落在同一区间:JohnDopamine 从一次运行的时间戳中读出,Relay 的收尾阶段约耗时 85 秒,而 FlashVSR+ 记录为 331 秒(消息)。同一片段、他们自己的 GPU 与配置,因此应把这看作比例关系,而不是绝对速度。
运行方式
推理集成在 LightX2V 中,而不是独立包:
git clone https://github.com/ModelTC/LightX2V.git
cd LightX2V
hf download lightx2v/RelayVSR_X2 \
    wan_x2.safetensors flash_x2.safetensors \
    --local-dir ./models/RelayVSR_X2
将 scripts/relayvsr/run_relayvsr_x2_sr.sh 指向克隆目录、权重、输入视频和一张 GPU,保留 --model_cls relayvsr_x2、--config_json configs/relayvsr/relayvsr_x2.json 以及 --sr_ratio 2,然后在仓库根目录运行它。默认配置让两个模型权重常驻内存,并开启编译与预热;relayvsr_x2_block_offload.json 会卸载 Wan 块以降低显存占用,relayvsr_x2_sp.json 则把单个片段拆分到两张 GPU 上。
若需反复处理,还有常驻服务器模式:启动 python -m lightx2v.server --model_cls relayvsr_x2 --task sr,然后为每个片段向 /v1/tasks/video/ 提交输入路径、sr_ratio、输出路径和种子,这样权重只需加载一次。
可用性
RelayVSR X2 是 LightX2V 的发布:需要 Linux 与 NVIDIA GPU,通过 CLI 或服务器运行,目前尚未发布 ComfyUI 节点或封装,仓库中也没有 diffusers pipeline。LightX2V 的更新日志列出了异步编码与保留原始音频,因此 H3 片段能保留生成时自带的音轨。目前想在节点图里使用它的人只能自行封装运行器。
评论
使用 GitHub 登录后即可参与讨论。