Pika H3 Flex 将 MiniMax H3 变成六步 ComfyUI LoRA
Pika 通过后训练将 MiniMax H3 改造为 Pika H3 Flex:一个六步模型,以两个 ComfyUI LoRA 的形式发布,附带三个官方模板和 12 个引用控制。
Pika H3 Flex 是 Pika 对 MiniMax H3 做后训练的成果:同样是 33B 全模态模型,在自建音视频语料库上重新训练,从 50 步教师模型蒸馏到 六步采样,再用奖励学习和偏好优化精修。Pika 在 Hugging Face 上发布了权重,在 GitHub 上开源了推理包,并于 2026 年 10 月 29 日随发布博文一同发布了技术说明。
对 ComfyUI 来说,关键在于 Flex 并不是一种新架构。它以 两个 LoRA 适配器的形式提供,采用原生 MiniMax H3 模块布局,因此可以通过内置的 LoraLoaderModelOnly 节点加载到你已有的 H3 基础模型之上,模板库中还有三个官方模板工作流。
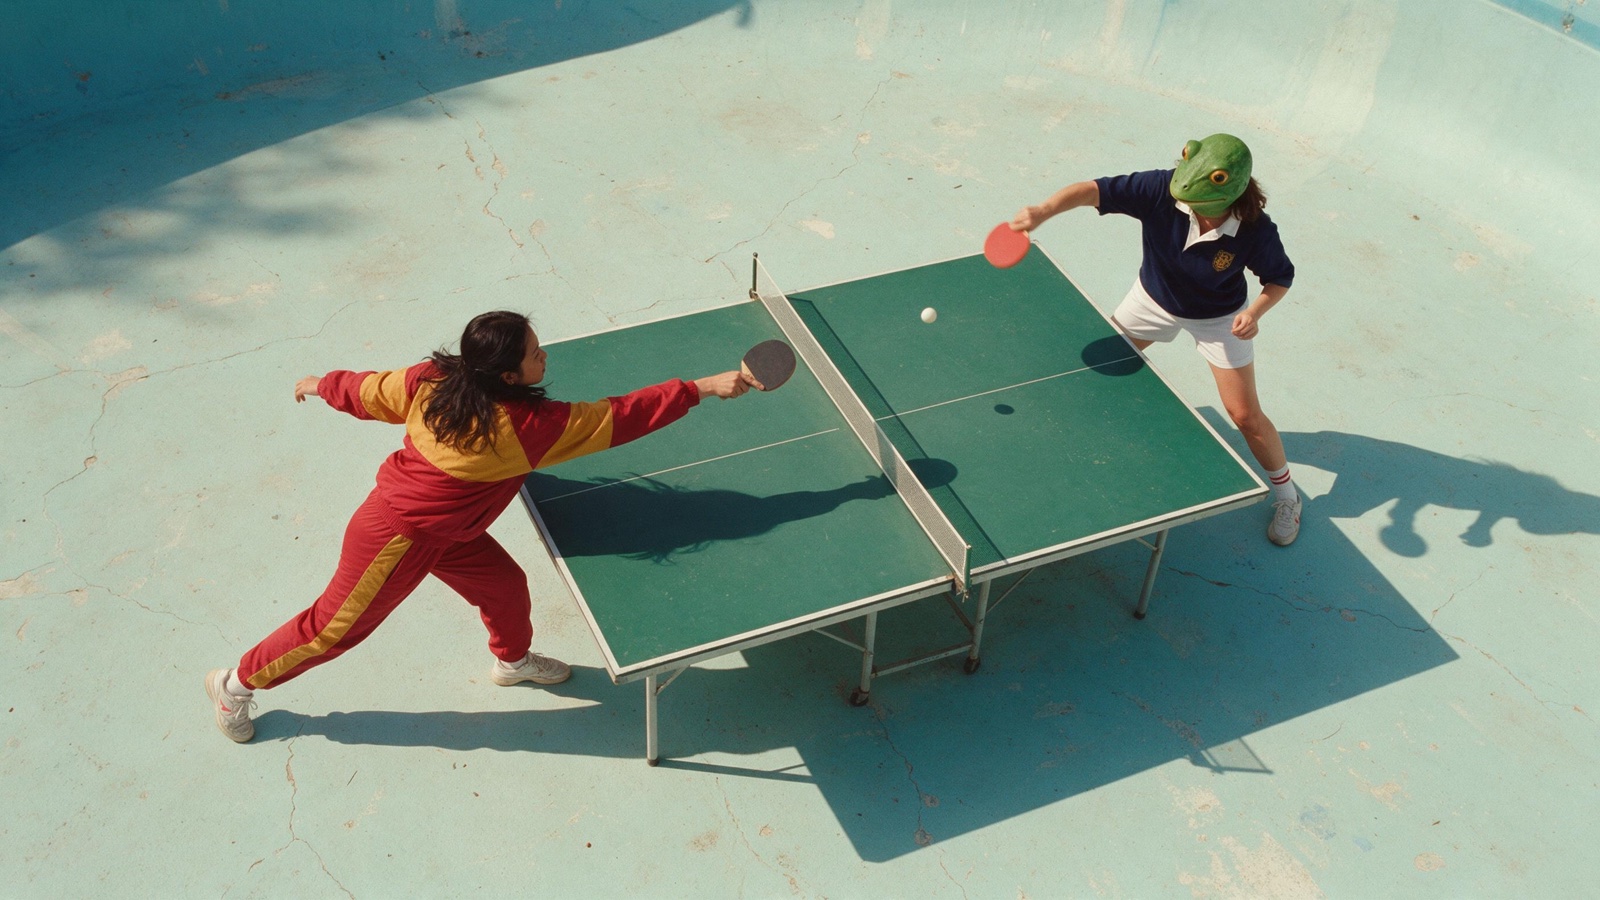 |  |
|---|---|
| 首帧参考 | 六步输出的其中一帧 |
乒乓球演示:输入一张静帧,提示词要求在 15 秒的镜头内完成五次预设的相机运动(俯拍、摇臂下降、甩镜、180 度环绕、低角度推轨)。来源:Pika H3 Flex 模型卡
完整的相机运动片段及其生成的配乐,取自 Pika 模型仓库中的展示集。
两个适配器,一套六步调度
Flex 将 H3 的两条条件路径拆分为独立的适配器,与基础模型自身的拆分方式一致:
| 适配器 | 条件输入 | 任务 |
|---|---|---|
| FL2VA | 文本,加上可选的首帧和/或尾帧 | 文生视频(T2V)、首帧(I2V)、尾帧、首尾帧 |
| Ref2VA | 文本,加上有序的图像、视频和音频引用 | 引用生视频、运动迁移、角色替换、引用引导编辑 |
Ref2VA 最多接受 9 张图像、3 段视频和 3 段独立音频片段,引用文件总计 12 个,并且至少要有一个图像或视频。每段引用视频或独立音频片段时长须为 2 到 15 秒,且这两类分组的合计时长上限为 15 秒。视频自带的音轨会保留在该视频上,不计入额外的音频文件。
输出原生为 480p 或 768p,覆盖 11 种宽高比,24 fps,文件内混入 32 kHz 立体声音频,请求时长为 5 到 15 秒。H3 的帧网格会向上取整:5 秒请求返回 124 帧,15 秒请求返回 362 帧。
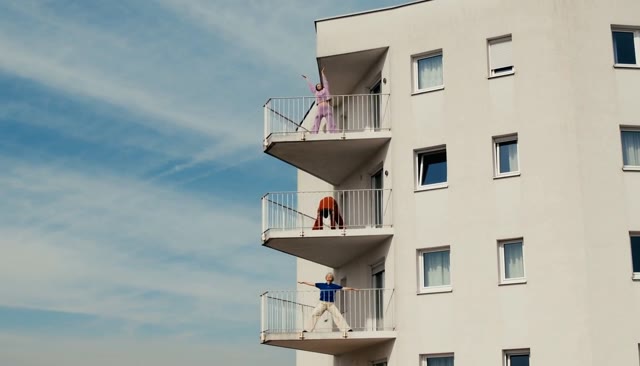
单条提示词驱动三层阳台上三个独立动画的人物,完成环绕、推进、竖直升降和反向环绕,全程无剪切。
ComfyUI 版本发布
ComfyUI 模板库在 Video 分类下提供了三个模板:video_pika_h3_flex_t2v.json、video_pika_h3_flex_fl2va.json 和 video_pika_h3_flex_ref2va.json,全部记录在 ComfyUI 教程页面。每个模板都将剪枝的 int8 H3 diffusion 模型与对应适配器配对,并运行 Pika 公布的调度方案:使用 ManualSigmas 的 LCM 采样器,通过 BasicGuider 设置 CFG 1.0,适配器强度固定为 1.0。
如果你不加载模板而是自行搭建节点图,有两个细节很重要:
- sigma 网格是 checkpoint 约定的一部分。 Pika 的清单列出的节点值为
1000/750/500/250/100/40/0,视频 shift 为 12,音频 shift 为 3,并使用新的中间噪声。在通用采样器里选择六步并不能复现该约定。 - 不要再叠加第二个加速 LoRA。 该适配器已经蒸馏到六步,教程指出在其上再加 turbo 或 Lightning LoRA 会破坏输出。
这些连接器是普通的 BF16 转换版本,并非新的 checkpoint:普通模块保持 rank 128,而融合的 Q/K/V 投影被合并为 rank 384,转换过程还重排了 SwiGLU 的两半以匹配原生 H3 布局。Pika 自己的适配器 readme 明确说明,文件完整性和 tensor 转换已验证,但上传过程中并未验证端到端的 ComfyUI 渲染。因此与参考推理包相比可能会出现一些偏差。
来自 #pika-h3-flex-early 的早期上手反馈与此相符:测试者 NebSH 将六步 960x544 一遍送入 Latent 放大,再加四步 1920x1088 一遍,用时 3 分 17 秒得到 2560x1440 的结果;而 WAS 指出在四步时远处鸟群这类高频细节上会出现闪烁,建议保持六步。
Pika 如何做到六步
技术深度解析描述了在已发布的、经过引导蒸馏的 H3 之上进行的三个后训练阶段:
- 监督微调:在自建的、经美学筛选的音视频数据集上进行,覆盖生成与编辑任务,仍使用教师模型的 50 步。
- 投影分布匹配蒸馏(PDMD,Wang 等,2026),将采样从 50 步减少到六步。Pika 报告称标准 DMD 在他们的实验中不稳定,而 PDMD 训练更可靠且输出质量更好。
- 蒸馏后的奖励学习:通过 ReFL(美学与清晰度)和 DPO(指令遵循、真实感、视觉质量)进行,作为两个独立 LoRA 训练再合并为一个适配器,因此合并后的行为不会增加额外采样步数。
其余工作由一套独立的推理服务栈完成:缓存的与时间步相关的 AdaLN 投影、融合算子、FlashAttention-4,以及带压缩通信的块稀疏注意力。在八块 B300 GPU 上,以 5 秒 768p 带音频运行时,这将完整推理从 3.409 秒缩短到 2.129 秒,加速比 1.60 倍,且 checkpoint 与六步调度保持不变。
数据说明了什么,又没说明什么
Pika 在相同提示词集上以 768p 将 Flex 与官方 MiniMax H3、Fal H3 Max 和 HeyGen Video(质量)进行对比评测,并报告在全部五项视觉与音频质量指标上得分最高:
| 指标 | Pika H3 Flex | MiniMax H3 | Fal H3 Max |
|---|---|---|---|
| 视频技术质量 | 12.3 | 11.7 | 10.6 |
| 视频美学 | 5.41 | 5.28 | 5.00 |
| 音频美学 | 7.02 | 6.85 | 6.89 |
| 音视频对齐 | 0.212 | 0.208 | 0.216 |
音视频对齐和文本视频对齐与对比对象大致持平,而这些数字来自 Pika 自己的评测。在他们的盲测成对比较研究中,Flex 在文本与图像条件生成的解剖结构、复杂构图和音频同步上领先,在引用条件生成的视觉风格、构图取景和相机运动上领先。Pika 同时表示,在其他系统中,物理表现、多场景叙事、光照与材质,以及动作密集的引用任务仍然更受偏好。
目前社区的 A/B 测试规模不大,但与一个可用的六步模型相符,而非免费的午餐。Kijai 用同一个 T2V 示例提示词分别以六步运行 DMAD 和 Flex,报告称 DMAD 在该案例中失败;djbfilmz 将六步 Flex 与不带适配器的二十步运行进行比较,表示他会用 Flex 迭代、最终成片再做完整的二十步渲染。教程自身的说法是在单张显卡上约一分钟生成 5 秒 1344x768 片段。
 |  |
|---|---|
| 多镜头产品广告 | 角色与环境引用加一段运动片段 |
另外两个展示案例:仅凭一个产品引用生成九镜头广告;以及一次运动迁移,从视频中提取动作编排,而身份与风格来自两张静帧。
可用性
仓库中存放了供 Pika 推理包使用的两个 FP32 适配器(fl2va/adapter.safetensors、ref2va/adapter.safetensors,各 2.77 GB),comfy/loras/ 下的 BF16 ComfyUI 转换版本(各 1.96 GB),以及 Diffusers 格式的 H3 基础组件,Pika 称其总计约 210 GB。每个 ComfyUI 模板只加载它所需的 transformer 分区。
Pika 的托管扩展不在下载范围内:从 768p 草稿上采样到 1080p、2K 和 4K,五条分离音频轨(对白、配乐、音效、拟音、环境声),提示词增强以及加速推理服务栈都属于 API 功能。本地开放权重推理覆盖 480p 和 768p。
评论
使用 GitHub 登录后即可参与讨论。