ComfyUI 核心新增 H3 Latent 放大与 Sol-H3-VAE 支持
ComfyUI 核心合并的两个 PR 可加载 MiniMax H3 Latent 放大器与蒸馏版 Sol-H3-VAE 解码器,把 2K H3 解码时间从 14.5 秒缩短到 0.89 秒。
ComfyUI 于 2026 年 10 月 28 日合并了两个核心 PR,把 MiniMax H3 的高分辨率路径从自定义节点搬进了核心。PR 17412 新增了 Latent 放大模型支持以及一个专用的 H3 节点,PR 17411 则让 VAE 加载器能够打开 Sol-H3-VAE,即来自 NVIDIA Efficient-Large-Model 团队的蒸馏快速解码器。两个 PR 均由 Kijai 编写,且都在 v0.43.1 标签之后合入,因此它们出现在 master 和每夜构建中,而不在当前 0.43.x 版本里。
这一组合针对的是 2K H3 任务中最耗时的两个环节:在不做 VAE 往返的情况下放大 Latent,以及解码生成完成的片段。
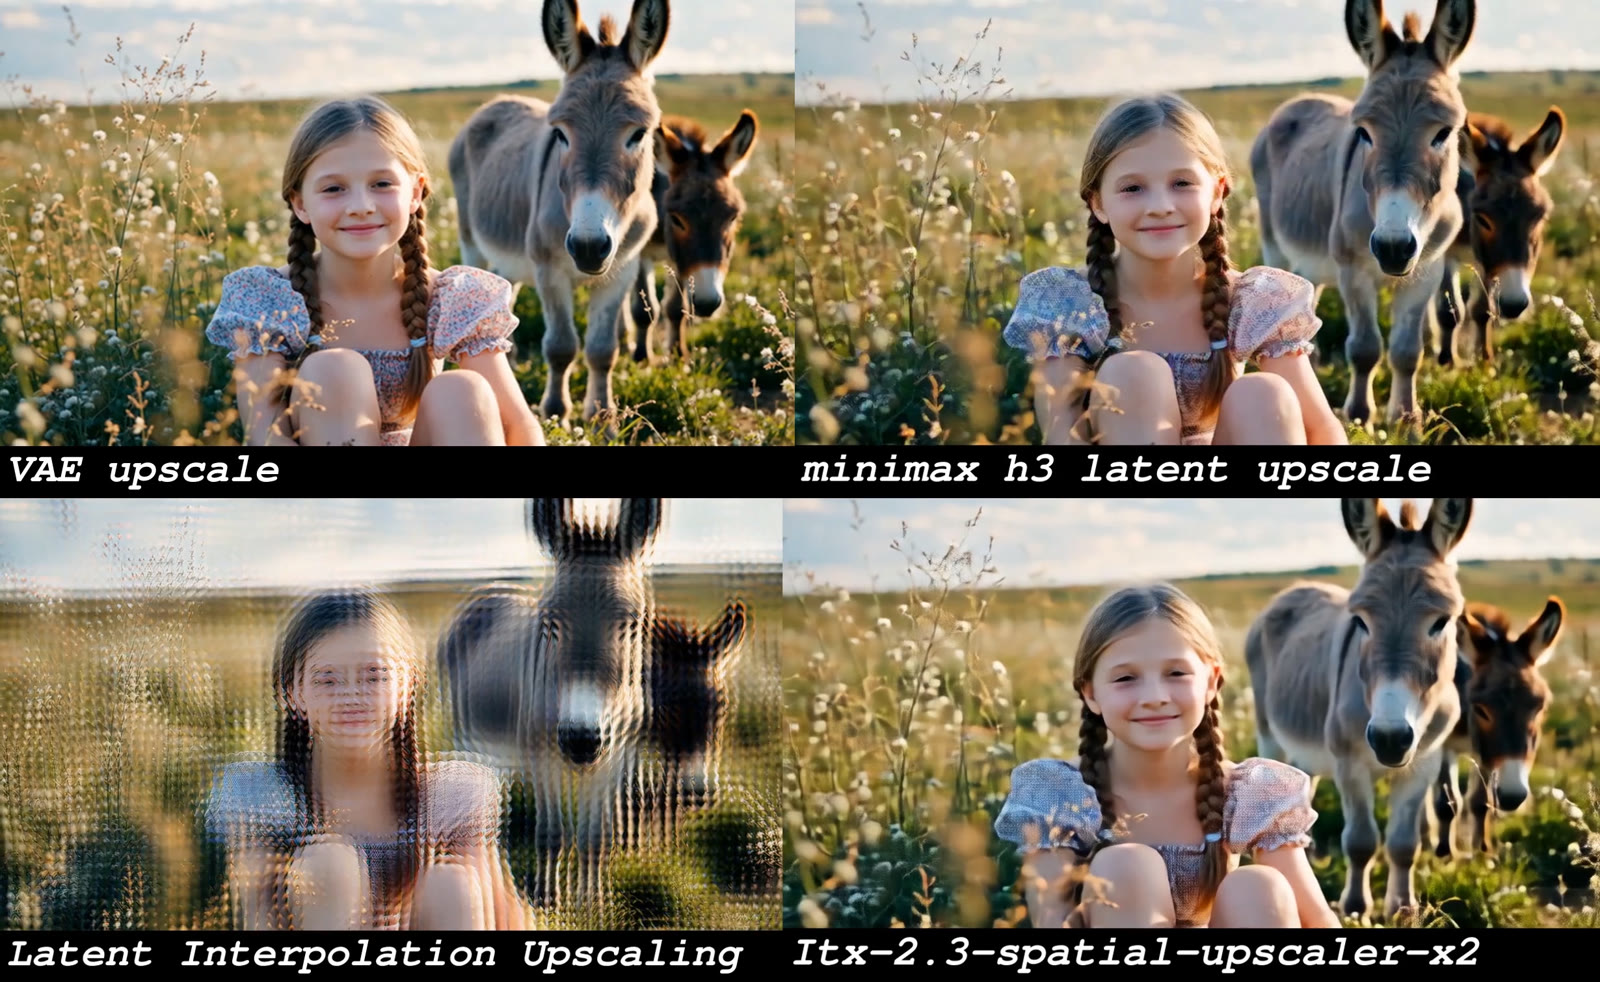
使用 H3 Latent 放大器在 Latent 空间中对低分辨率结果进行放大,图片来自其模型卡。
同一仓库中的视频对比。
核心中新增了什么
| PR | 合并时间 | 变更内容 |
|---|---|---|
| 17412 | 2026-10-28 20:05 UTC | 新增 comfy/ldm/minimax/latent_upscaler.py 模块、Load Latent Upscale Model 中的 H3 分支,以及新节点 MiniMax H3 Latent Upscale With Model |
| 17411 | 2026-10-28 23:46 UTC | VAE 加载器中的 Sol-H3-VAE 检测与键重映射、非因果解码器路径、int8 量化解码器支持、解码器内存估算 |
两个 PR 都不附带模型文件。它们让现有的社区权重可以用原生加载器加载,因此原本需要节点包的 H3 放大器现在只靠核心节点就能运行。
在 Latent 内部放大
H3 的 Latent 带有 24 个通道以及一条独立的音频流。来自 LBH-123-AI 的 Latent 放大器使用 3D 卷积主干直接作用于视频 Latent:345,280,216 个参数,输入输出均为 24 通道,512 个基础通道,12 个输入块和 12 个输出块,每两个块之间插入一个卷积核大小为 5 的时间卷积。
其意义在于跳过经过 H3 VAE 的 decode -> pixel upscale -> encode 流程,模型卡称该 VAE 约有 5B 参数。作者还指出,对 H3 Latent 直接做双线性或双三次插值会产生重影,而这个学习式放大器经过训练正是为了避开重影。训练使用了约 80,000 组配对样本,大致分为 70,000 组视频对和 8,000 组 2K 图像对,其中 2 倍是最主要的放大倍率。
核心直接从 state dict 读取架构,因此块数、通道宽度和时间卷积核都来自权重本身,而不依赖额外的配置文件。节点输出保留 H3 的嵌套 Latent,这意味着音频部分会原样通过,生成的配乐在放大后依然保留。输入 Latent 上的噪声遮罩会被丢弃。
有两处与配套节点包不同,值得注意:
- 核心节点接收的是目标尺寸,而不是缩放倍率。
MiniMax H3 Latent Upscale With Model默认 2560x1440,步进为 32,并沿用通常的分辨率上限。社区节点则提供 1.0x 到 4.0x 的连续缩放。 - 单纯放大并不会增加细节。 它只是调整 Latent 尺寸,因此要在新分辨率下进行第二次采样,细节才会被补回来。如果这一步的步数太少,结果会偏软。
如果请求的尺寸与 Latent 尺寸一致,核心节点会直接返回输入,而不运行模型。
可直接替换的解码器 Sol-H3-VAE
Sol-H3-VAE 是 H3 的快速视频解码器,它用一个 1.62B 参数的 24 层非因果解码器替换原本 36 层的 VAE 解码器,并从后者蒸馏而来。它使用窗口注意力整帧解码,而不是按空间分块,并对每个原生的 5-Latent 块进行双向解码。根据其模型卡,它接收相同的归一化 Latent、返回与 H3 VAE 解码器相同的帧,并且不改动音频解码器。
| 一个 5 秒片段 | H3 VAE | Sol-H3-VAE |
|---|---|---|
| 768p,RTX 5090 | 12.5 s | 5.0 s |
| 720p,GB200 | 6.16 s | 0.34 s |
| 2K,GB200 | 14.5 s | 0.89 s |
模型卡报告,在覆盖 720p 到 2K 的留出 Latent 上,相对 H3 解码器的 PSNR 为 45.4 dB;在生成的 768p 片段上为 38.2 dB。GB200 的数据来自捕获的 CUDA graph,RTX 5090 的数据为 eager 模式。
在核心中打开该模型文件,远不止新增一个文件名匹配模式:
- 发布文件存储解码器时不带
decoder.前缀,因此加载器会在运行时重映射键,并在缺失时填入 H3 的 Latent 均值与标准差。 - 非因果解码器改变了帧数计算。其输出为每个 Latent 对应 4 帧,且每 5 个 Latent 组成的块中第一个 Latent 只保留 1 帧:
t个 Latent 得到4t - 3 * ceil(t/5)帧,编码时则有对应的逆运算。 - 由于整段片段一次性解码而非分块解码,该 PR 增加了单独的内存估算,使加载器能在解码开始前规划显存。
- 量化的 Sol VAE 版本同样可以加载:加载器会检测带 conv-rotation 权重的 int8,并切换到混合精度算子。
发布文件是单个 fp32 的 sol_h3_vae.safetensors,约 6.5 GB。
接入工作流
- 把放大器模型文件放到
ComfyUI/models/latent_upscale_models/。H3 版本提供 bf16 和 fp16,各约 691 MB,另有一个 1.38 GB 的 fp32.pth。 - 把
sol_h3_vae.safetensors放到ComfyUI/models/vae/,并用常规 VAE 加载器加载。 - 在低分辨率采样与 2560x1440 或更高分辨率的第二次采样器之间,把
Load Latent Upscale Model接到MiniMax H3 Latent Upscale With Model。 - 用 Sol VAE 解码精修后的 Latent。
放大器权重采用 Apache-2.0 许可。ComfyUI 的模板库目前仍只包含托管的 H3 API 模板,因此这一组合还没有官方的 2K 本地模板;上述耗时也来自模型卡自身的测量,而非 ComfyUI 基准测试。
获取方式
- 放大器:LBH-123-AI/Minimax_h3_latent_Upscaler(Apache-2.0,含 bf16 / fp16 / fp32 模型文件,仓库中还有两个示例工作流)
- 快速解码器:Efficient-Large-Model/Sol-H3-VAE,参考 Python 包位于
code/,更完整运行时的 ComfyUI 阶段位于 NVlabs/Sana 的 Sol-Engine 分支 - 核心改动:PR 17412、PR 17411
评论
使用 GitHub 登录后即可参与讨论。