Krea 2 BBOX:面向漫画与文字的布局控制微调模型
Krea 2 BBOX 是 Krea 2 的社区微调模型,可将分镜、角色与逐字文本放入显式指定的框中,提供 ComfyUI 单文件、LoRA 与 HF Space 三种形式。
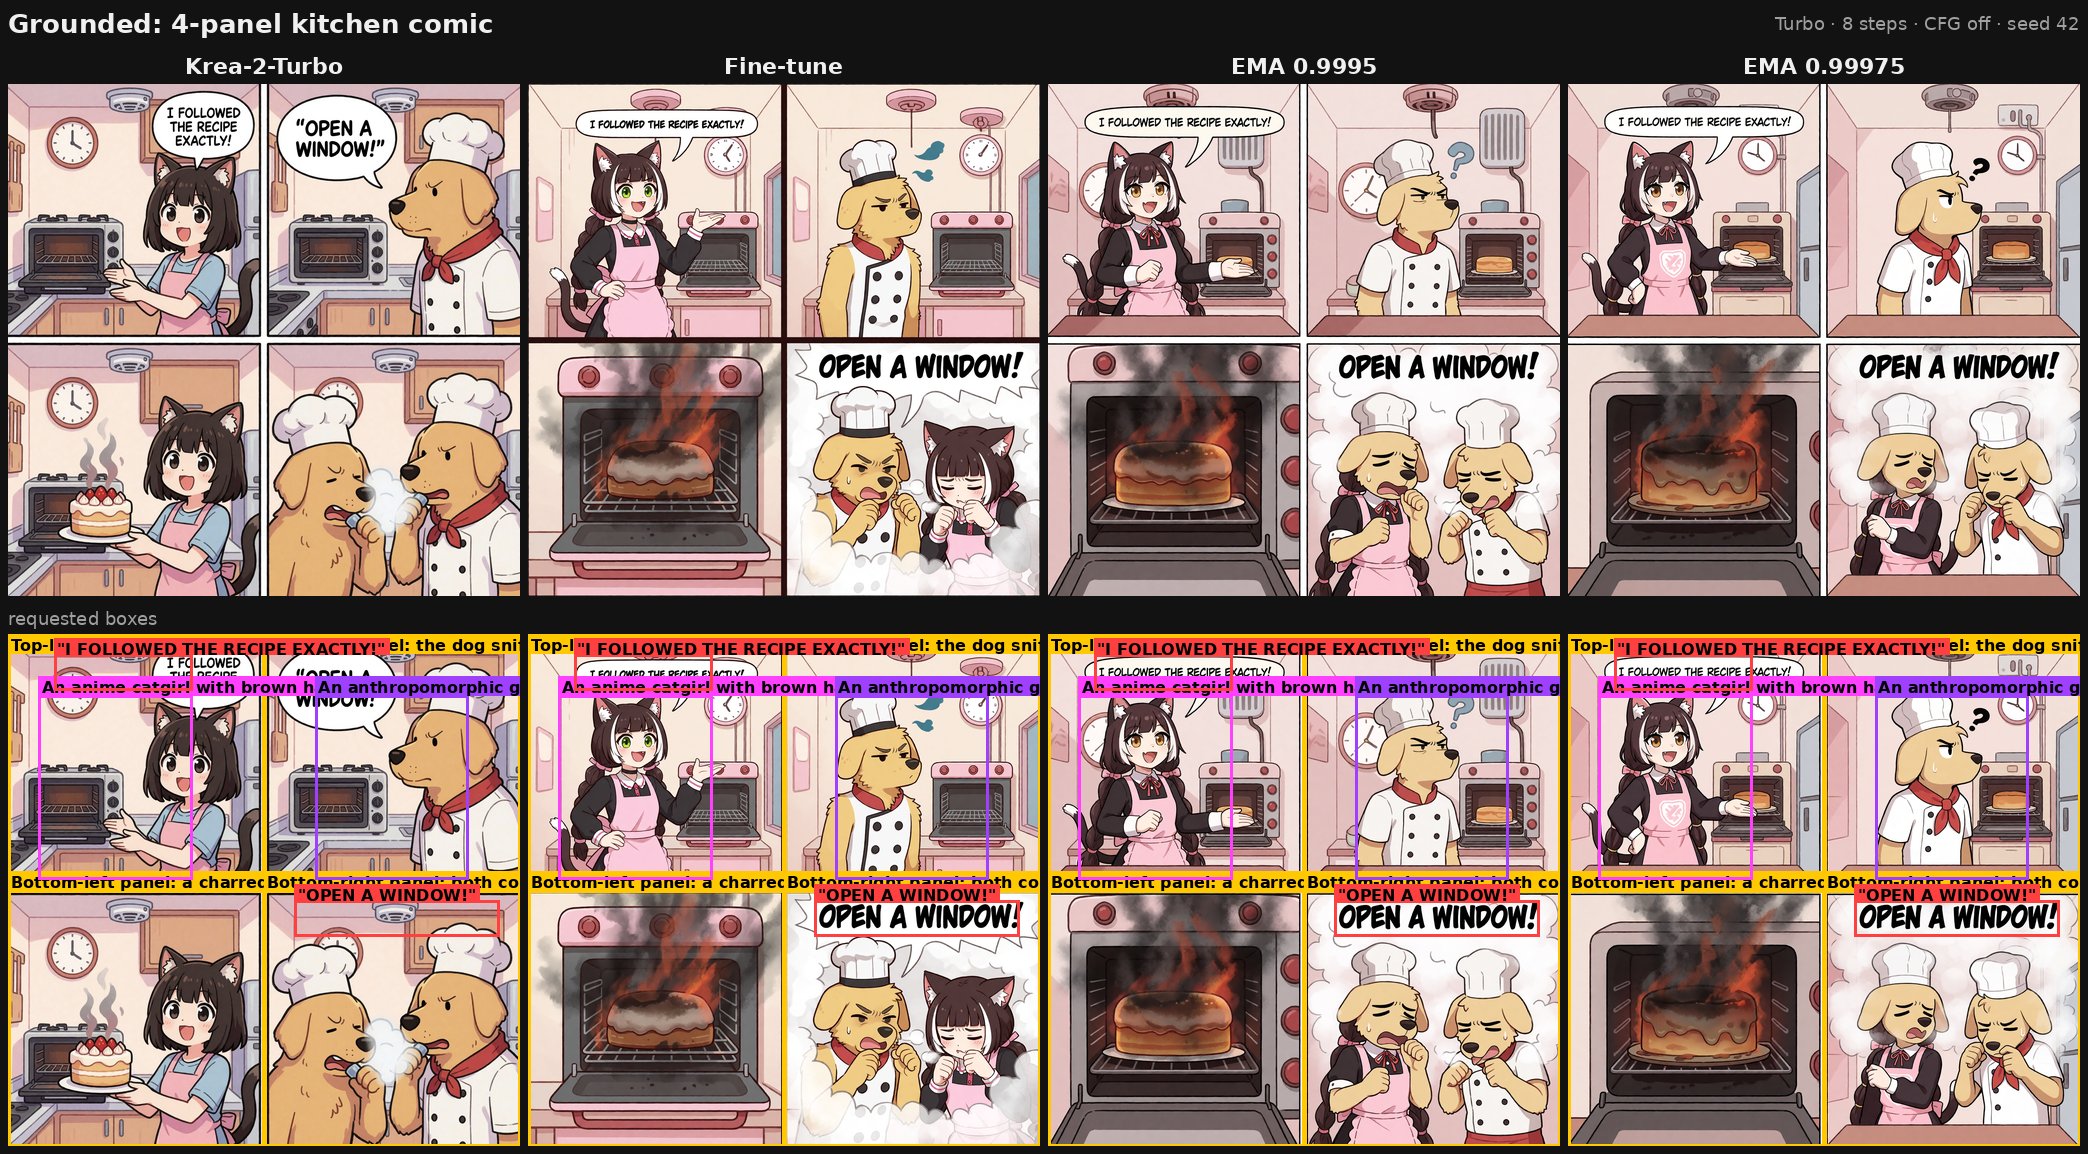
一个有明确构图要求的四格提示词。各列分别为:原生 Krea 2 Turbo、微调模型、EMA 0.9995、EMA 0.99975。
文字与布局通常是文生图模型只能大致近似处理的两件事。你要求一个带有一句台词的对话气泡,得到的往往是大致正确位置上的字母状噪点;你要求四个分镜,模型则会自行拼出一张拼贴画。该微调模型直接针对这一问题,通过教会模型一种为每个元素命名并为其指定方框的提示词格式来实现。
两种版本,每种三份权重
该微调模型基于 Krea 2 Raw 训练,并提供两个变体。Turbo 是合入了 base-to-turbo 蒸馏增量的微调版本,因此可在 CFG 关闭的情况下以 8 步采样。Raw 是按原样训练出的微调版本,50 步、CFG 5.5。
每个变体还附带两份权重的 EMA 影子版本,衰减率分别为 0.9995 和 0.99975。作者对此的说明是:平滑处理可能提升图像质量,但也可能让模型在方框定位上变得不那么精确。
| 变体 | 采样 | 权重 |
|---|---|---|
| Turbo 微调 | 8 步,CFG 关闭 | 微调权重加两份 EMA 影子权重 |
| Raw 微调 | 50 步,CFG 5.5 | 微调权重加两份 EMA 影子权重 |
epoch 1 到 19 的训练模型保留在仓库中供参考,它们已被 epoch 20 的发布版本取代。
提示词就是一份布局规范
约 90% 的训练使用了紧凑的 grounding DSL,而非自然语言描述。它是纯文本,每行一个元素,每个框由 0 到 1000 网格上的四个数字组成,x 在前:
A four-panel comic in which an anime handywoman and an anthropomorphic tabby cat assemble a flat-pack shelf and fail completely.
@clean line art, flat colors, light cel shading; Digital illustration
~A bare apartment living room with cardboard packaging and loose screws on a pale wood floor.
p[0,0,500,500] Top-left panel: the handywoman holding up the instruction sheet, confident.
p[500,0,1000,500] Top-right panel: the cat batting a single screw off the floor.
p[0,500,500,1000] Bottom-left panel: a lopsided half-built shelf wobbling.
p[500,500,1000,1000] Bottom-right panel: the shelf collapsed, the cat sitting smugly on the wreckage.
ac:1[60,80,340,470] A young woman with short dark hair in blue overalls, holding an instruction sheet, confident grin.
fc:2[560,90,880,470] An anthropomorphic tabby cat in a tool belt, one paw raised mid-swat, innocent expression.
t[80,40,420,120]"SOME ASSEMBLY REQUIRED." black text in a rounded speech bubble
t[540,530,960,610]"IT HAS FIVE LEGS NOW." black text in a rounded speech bubble
前缀中 p 表示分镜,o 表示对象,t 表示逐字文本,pe / ac / fc 分别表示真人、动漫角色和兽人角色。@ 开头的行承载风格标签,~ 开头的行承载场景描述。模型卡中提醒,把坐标写成 y 在前是最常见的错误,而且这种错误是静默发生的:图像看起来依然合理,只是不在你要求的位置上。
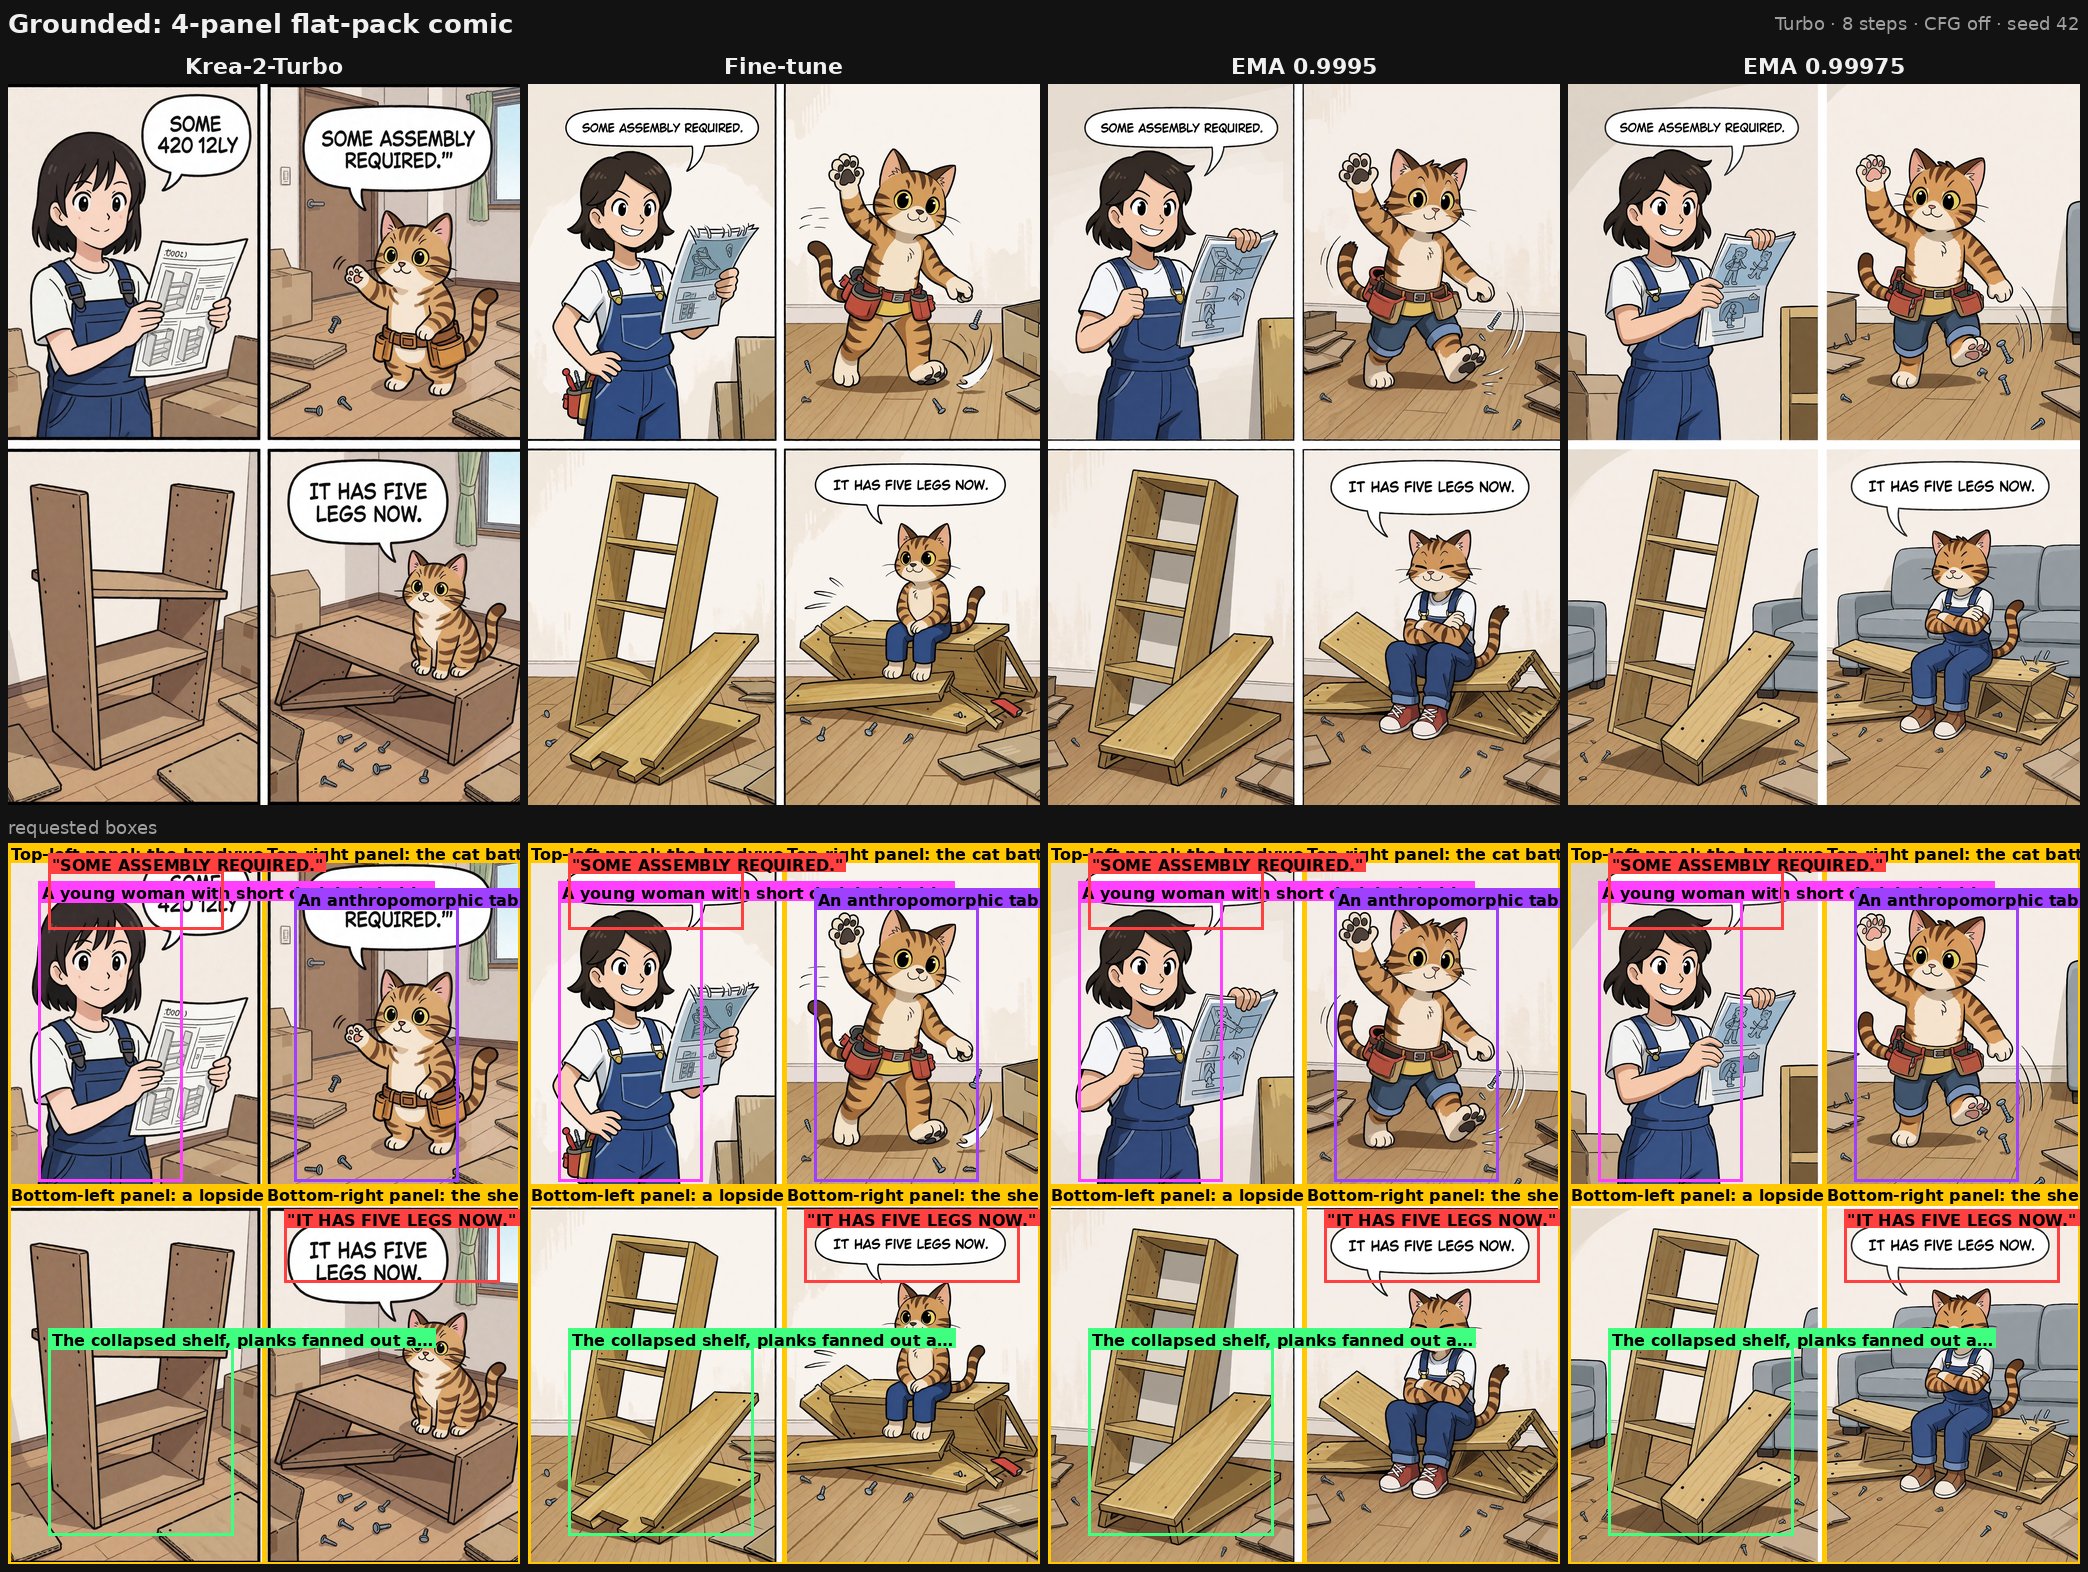
与上方相同的提示词。带 grounding 的样本会额外显示一行叠加了所要求方框的图像。
自然语言提示词仍然可用,因为纯文本占据了训练数据的另外 10%。DSL 才是让布局精确到真正可用的关键,PROMPTING.md 是完整的规范文档,附有可直接复制的示例。
在 ComfyUI 中使用
每个变体都以 Krea 原生布局的单文件形式发布,这正是 ComfyUI 加载所用的布局。共六个文件覆盖 Turbo、Raw 及两份 EMA 影子权重:
| 变体 | 文件 | 采样 |
|---|---|---|
| Turbo 微调 | krea2-bbox-turbo-comfy-latest.safetensors | 8 步,CFG 1.0 |
| Turbo EMA 0.9995 | krea2-bbox-turbo-ema_0.9995-comfy.safetensors | 8 步,CFG 1.0 |
| Turbo EMA 0.99975 | krea2-bbox-turbo-ema_0.99975-comfy.safetensors | 8 步,CFG 1.0 |
| Raw 微调 | krea2-bbox-raw-comfy.safetensors | 50 步,CFG 5.5 |
| Raw EMA 0.9995 | krea2-bbox-raw-ema_0.9995-comfy.safetensors | 50 步,CFG 5.5 |
| Raw EMA 0.99975 | krea2-bbox-raw-ema_0.99975-comfy.safetensors | 50 步,CFG 5.5 |
这些文件放入 ComfyUI/models/diffusion_models/。其他都不需要改动:文本编码器和 VAE 使用 Krea 2 原版,取自 Comfy-Org/Krea-2,只要替换 diffusion 模型,内置的 Krea 2 文生图模板即可直接使用。
此外还有一个运行 turbo 模型的 Gradio 画布演示,可以在下载任何文件之前先试一下提示词格式。
LoRA 是一种近似
发布内容还包含 rank 为 64、128 和 256 的 LoRA,供那些只能叠加适配器、无法替换 26 GB transformer 的用户使用。作者明确指出这些是近似版本,并在留出的训练样本上测量了它们承载了完整微调效果的多少:
| Rank | 占完整微调效果的比例 | 在高噪波步上的比例 |
|---|---|---|
| 64 | 约 12% | 约 16% |
| 128 | 约 18% | 约 24% |
| 256 | 约 28% | 约 38% |
原因是这是一次全秩微调,改动分布在几乎每个权重矩阵的每个方向上,而 LoRA 完全无法承载 norm、bias 或 modulation 表。在 ComfyUI 中,LoRA 文件放入 ComfyUI/models/loras/,以强度 1.0 通过 LoraLoaderModelOnly 应用到原生 Krea 2 模型(Raw 或 Turbo)之上,并使用各自对应的 sigma 设置。
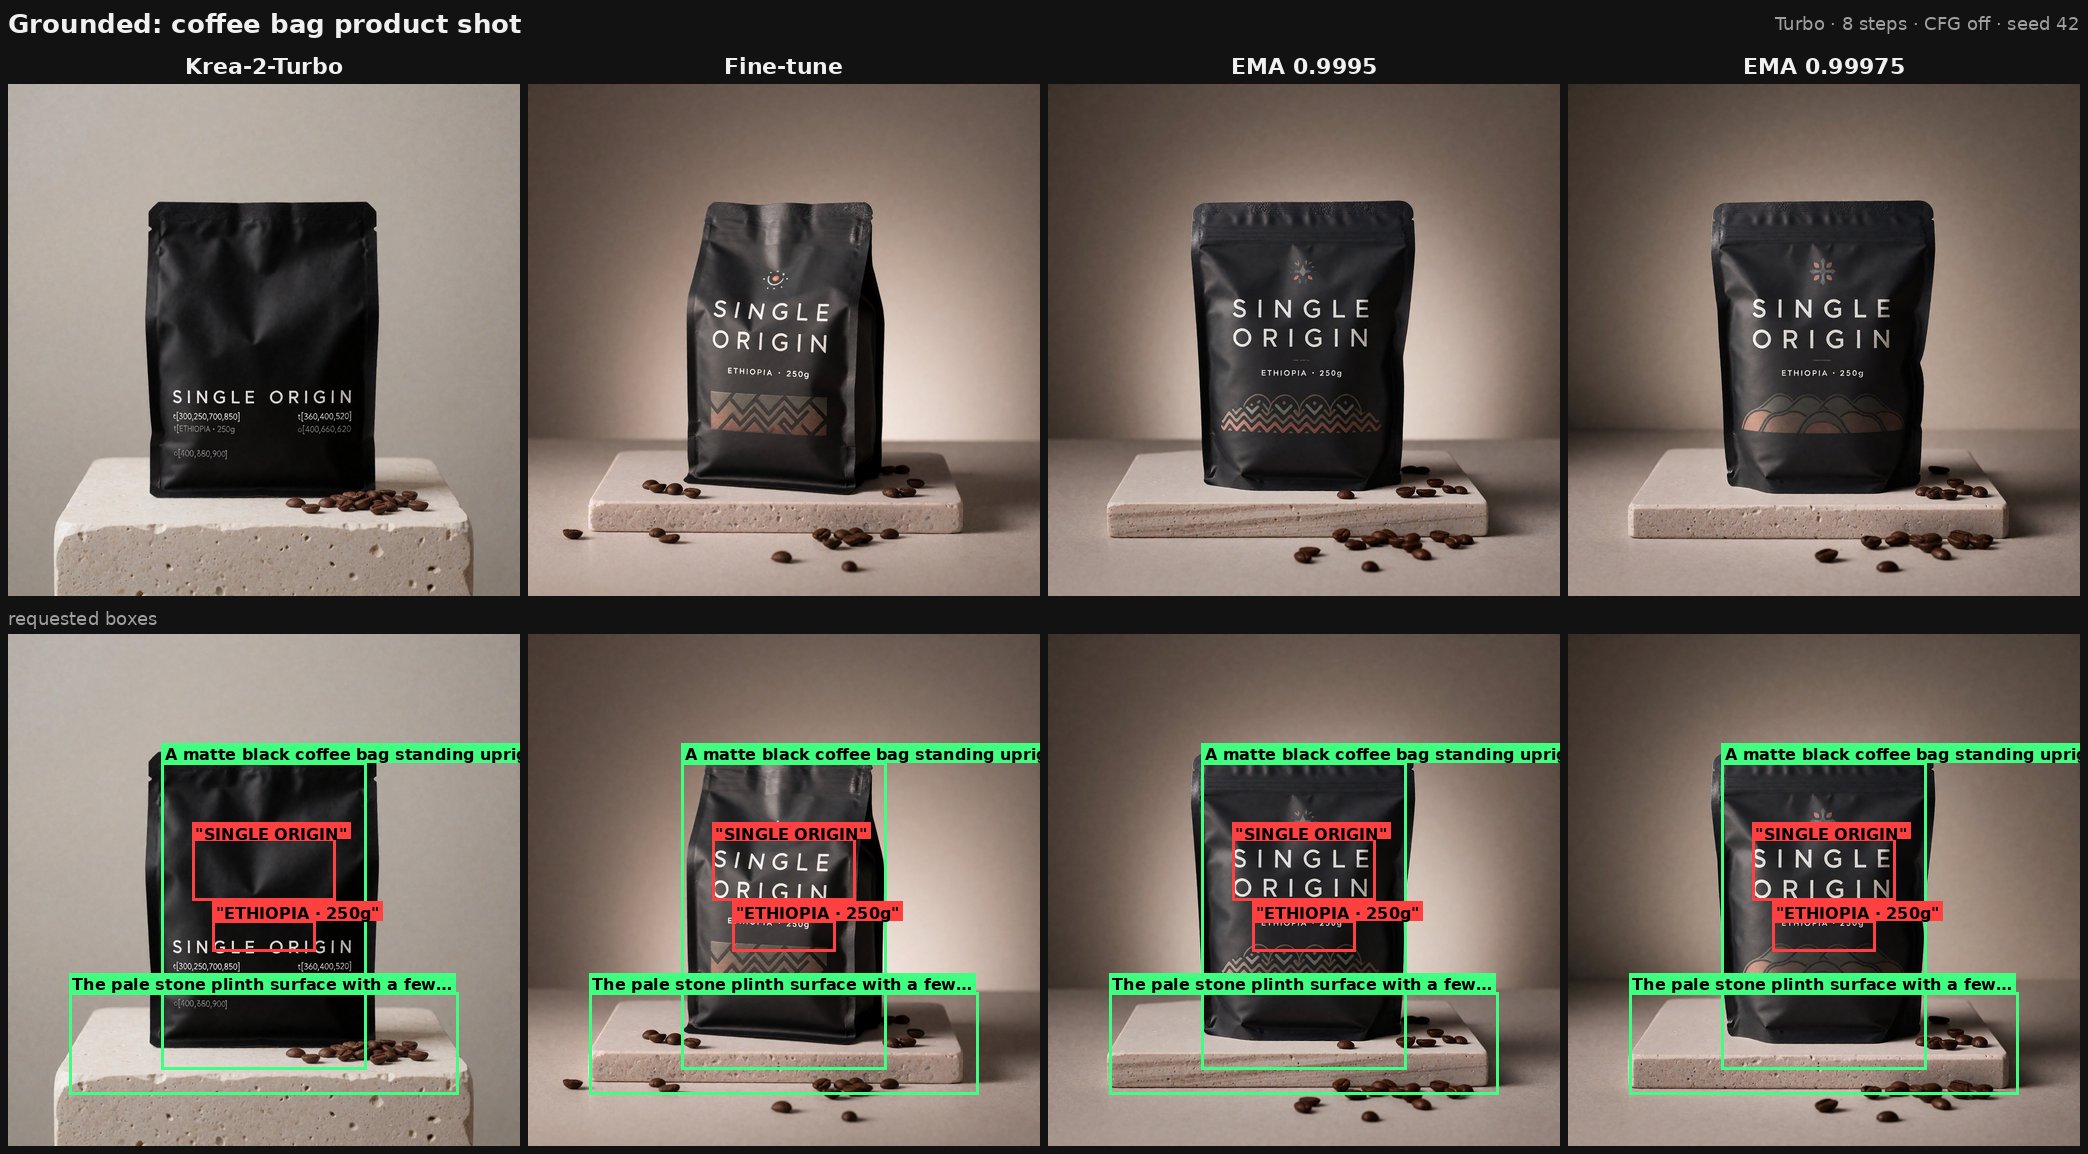
一张产品图示例。文字按方框放置,而不是碰运气。
训练数据
布局能力来自数据层面。一个包含 3000 万张图像的 pre-AI 图库先用 DINOv3 和 SigLIP2 进行聚类,并按美学评分排序;凡是包含绘画艺术或漫画的内容,还会额外用 wd-tagger 和 JTP 打标签,并按多样性重新排序。
最终数据集为 40,000 张图像:20,000 张普通照片、10,000 张漫画和 10,000 张艺术图像。全部 40,000 张都通过基于 gemma-4-31B-it 和 LocateAnything-3B 的定制标注流程完成方框标注,生成的提示词被压缩为 DSL 格式,最多 512 个 token。
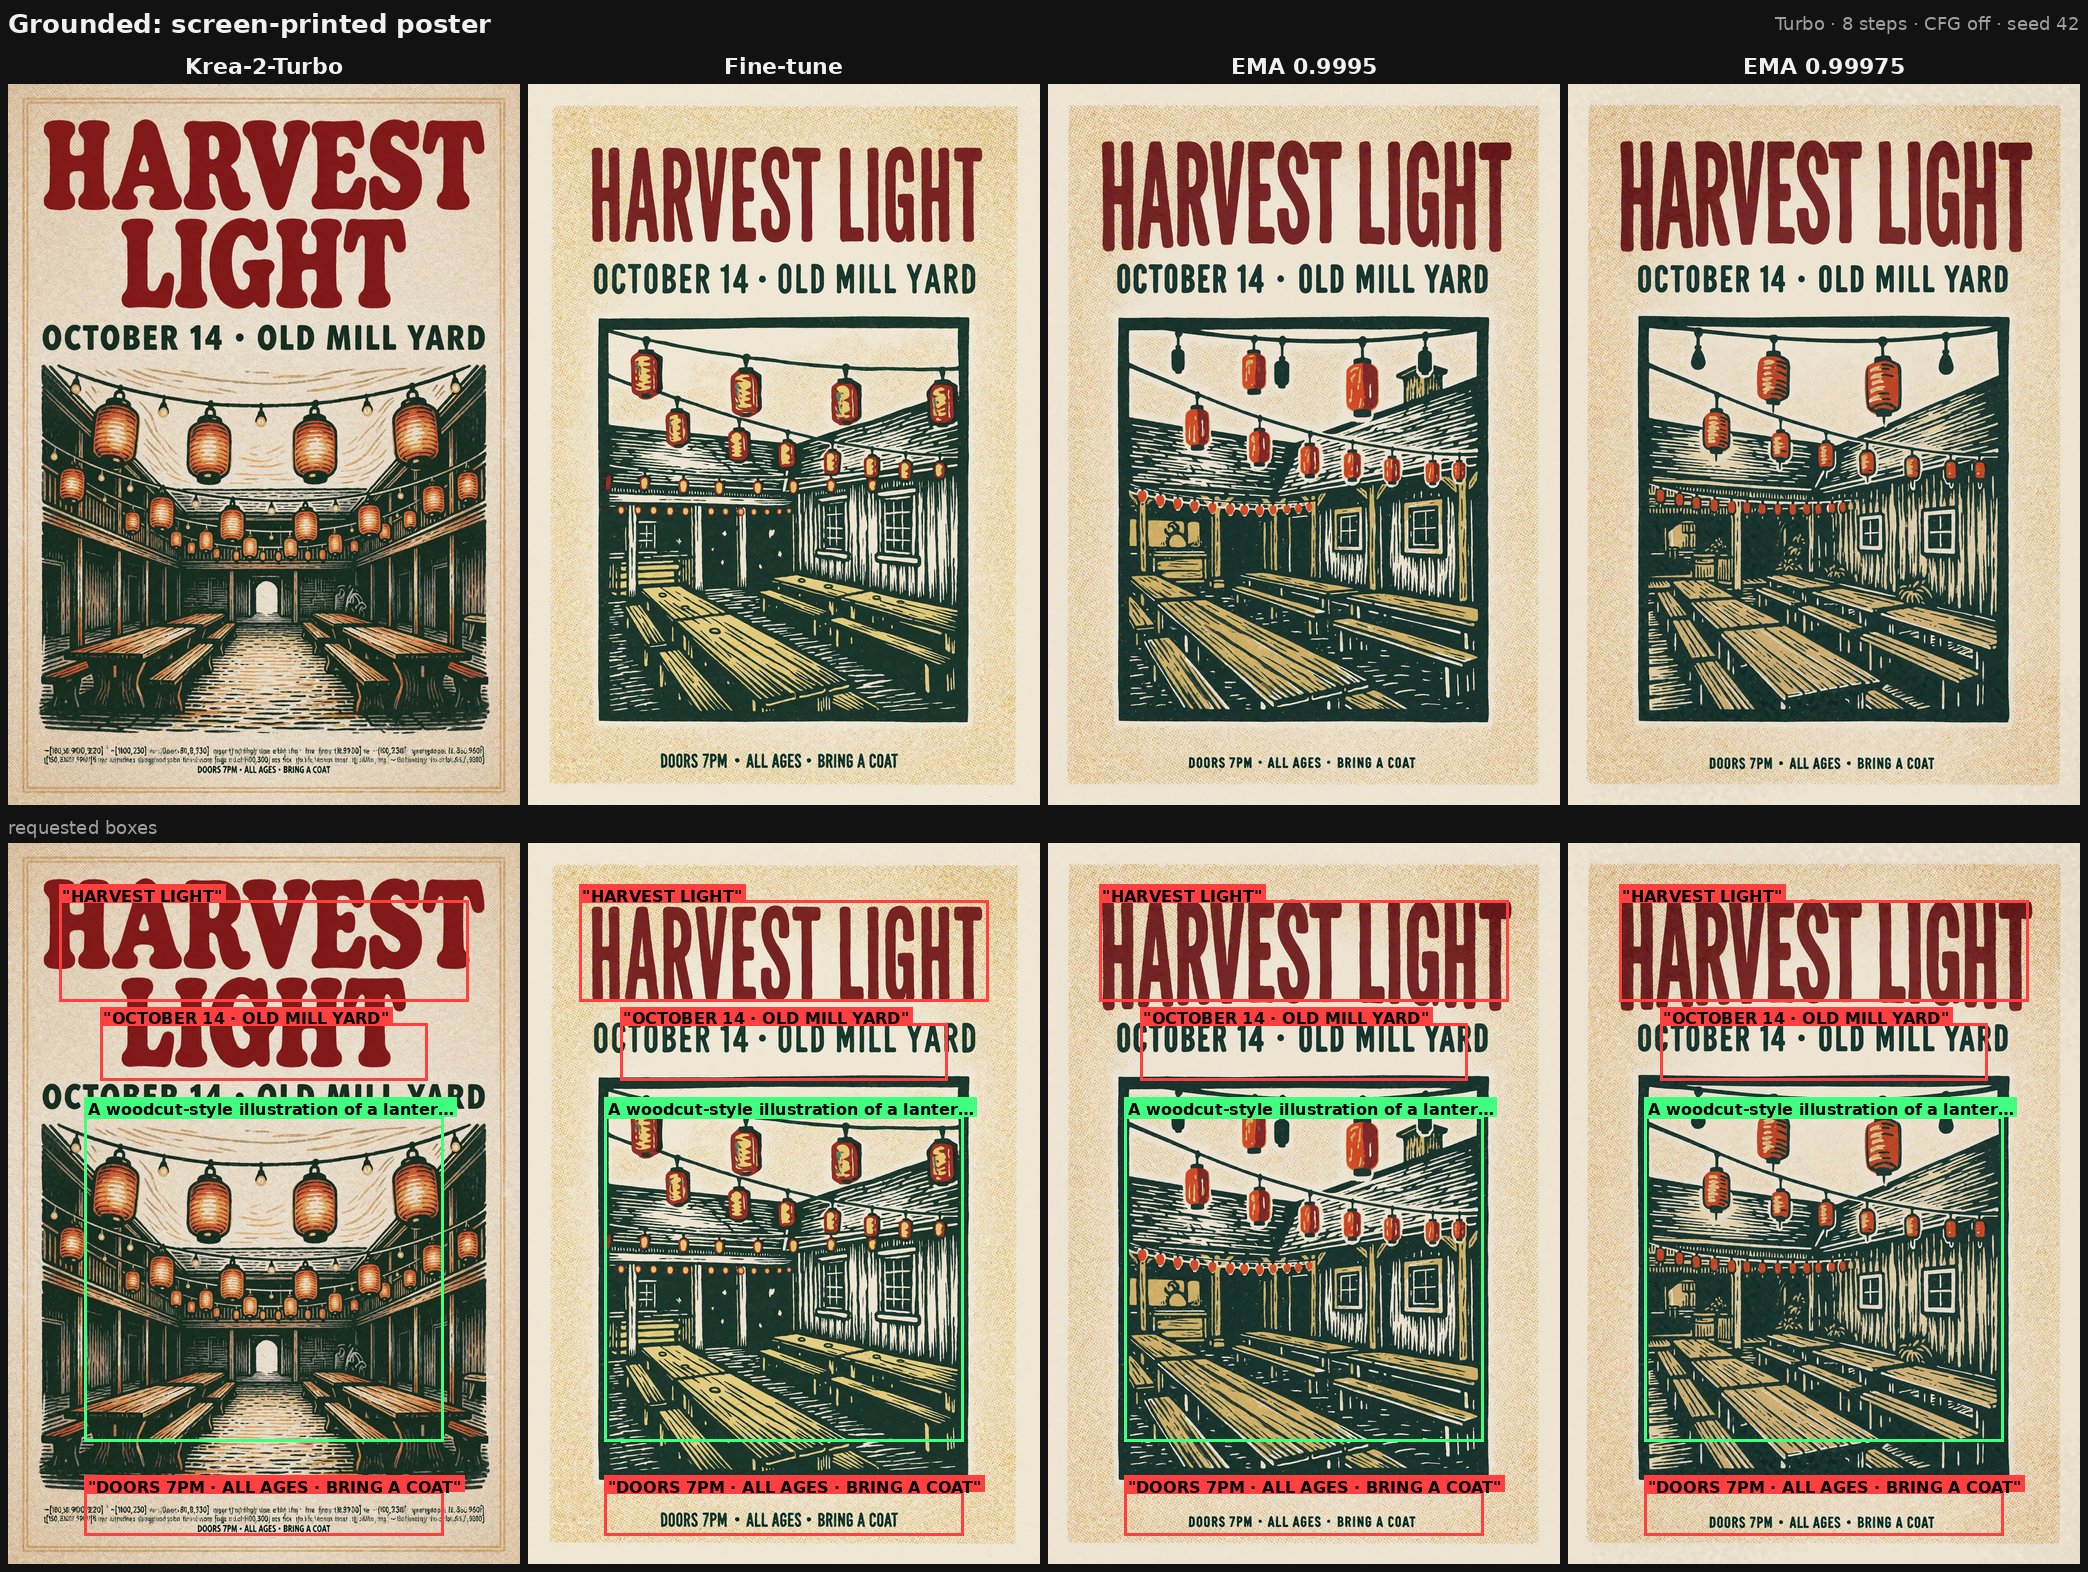
一张丝网印刷海报示例,这是同一能力的另一个应用方向。
局限
- DSL 必须被正确书写或生成。坐标顺序、元素字母和方框尺寸都是提示词的一部分,错误的一行会产出错误的图像,而且不会报错。
- 带 grounding 的提示词很长。512 个 token 是训练提示词压缩后的上限,因此内容非常密集的页面会超出模型见过的范围。
- EMA 影子权重可能同时具备更好看的画面和更不精确的方框定位,这一取舍需要按具体用途测试。
- LoRA 只承载一小部分效果。对于分镜网格和精确定位的文字,完整微调才是生成示例所用的版本。
- 它是 Krea 2 的社区微调模型,因此仍然需要 Krea 2 的文本编码器和 VAE,并且会继承基础模型在字母和短对话方面的所有不足。
评论
使用 GitHub 登录后即可参与讨论。