Anima Reference Adapter:一张图像,在 ComfyUI 中生成全新场景
Anima Reference Adapter 可从一张图像中保留角色及其绘画风格,同时由提示词设定姿势与背景。rank-32 LoRA,三个 ComfyUI 节点。
标签驱动的动漫模型只有在提示词逐一列出每一项特征时才会画出你指定的角色,而且仅限于模型已经认识的角色。参考适配器把这件工作从文本中拿走:只需给它一张图像,提示词便可自由描述姿势、构图和地点。
从视频模型借鉴来的大多数参考条件方式并不做这种取舍。ComfyUI-Cosmos-Reference 将参考 Latent 作为片段的额外一帧追加,这在编辑方面效果很好,但也会复制参考的姿势和布局,因为视频先验会把该帧理解为上一个镜头。Anima Reference Adapter 要求的恰好相反:保留画的是谁以及怎么画,丢开在哪里和以什么姿势。
参考是如何接入的
Anima 运行在 Cosmos-Predict2 MiniTrainDIT 之上:28 个块、宽度 2048、16 个注意力头,在 16 通道 Wan 2.1 VAE Latent 上使用 2×2 空间分块,并配有 Qwen3-0.6B 文本编码器以及 shift 为 3 的 flow matching。这让它在 (t, h, w) 上具备 3D 旋转位置嵌入,而适配器正是以此为杠杆。
参考图像会被加黑边适配进输出分辨率,进行一次 VAE 编码,然后作为第二个 Latent 帧追加。与普通视频式参考相比,有三处改动:
- 干净的参考帧。 参考帧以 timestep 0 输入,目标帧以 σ 输入。参考一侧不加任何噪声。
- 偏移 RoPE。 参考帧的高度坐标被平移到目标网格之外(偏移一个目标高度,训练时再加一点抖动),因此不会保留任何像素级对应关系,模型也无法把参考当作镜头继续延续。
- 训练好的读取器。 一个 rank-32 LoRA,α = 32,作用于每个块的自注意力、交叉注意力以及两个 MLP 层(280 个模块,45.9M 参数),学会读取这个被位移的帧。它通过 forward hooks 应用,且只在携带参考的模型调用期间生效,因此已加载的基础模型仍可执行无参考的推理。
引导同样被拆分。当参考同时存在于 CFG 的两个分支时,只有文本会被放大;引导器改用独立的文本缩放与参考缩放,因此 ref_guidance 可以在不触碰 cfg 的情况下把结果推向参考。较高的参考引导会过饱和,所以该节点会在其上叠加自适应投影引导或 CFG rescale。
留出角色的表现
训练数据是合成的,由 Anima 自身生成:600 个「同一角色、同一风格」的分组,每组六次渲染,构图、相机、姿势、表情、背景和光照均独立采样,共 3,600 张图像,涵盖 300 个角色和 427 位画师,在单张 RTX PRO 6000 Max-Q 上耗时 4.25 小时。12 个角色被完全留出;剩余 576 个分组产生了 17,280 个有序的参考-目标配对,其中 70% 从目标提示词中去掉了所有外观和服装标签。
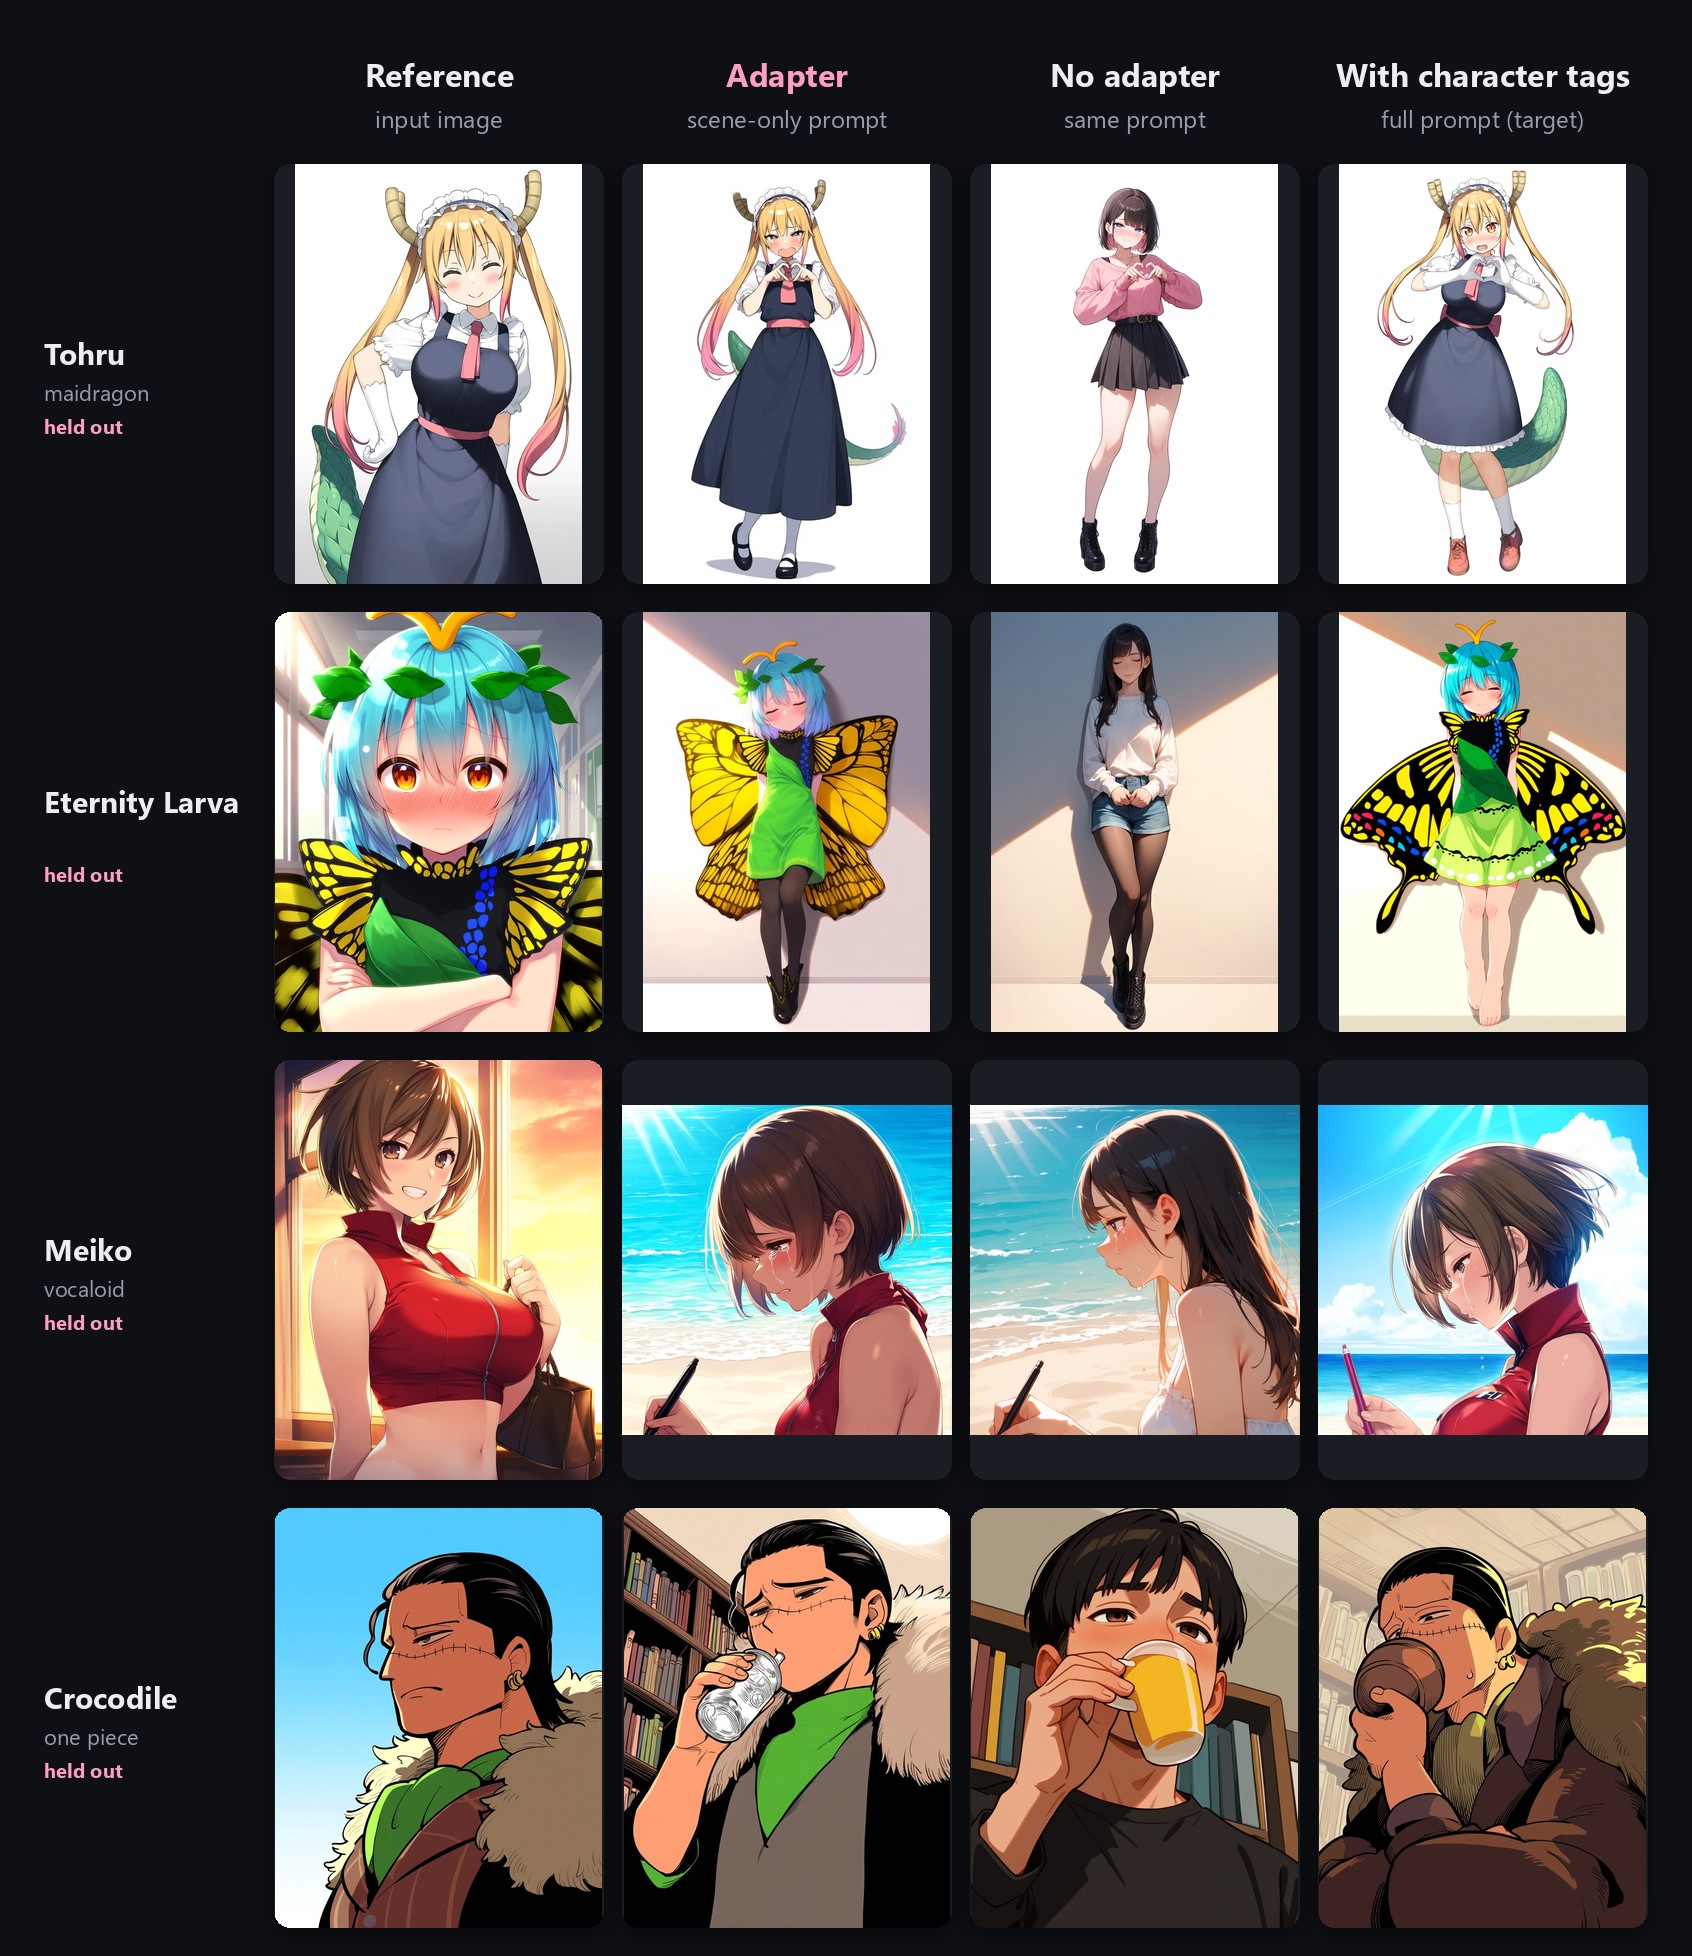
训练中从未见过的留出角色。每一行:参考图;使用适配器加纯场景提示词的生成结果;不使用适配器的同一提示词;以及用完整外观标签按名字要求基础模型生成该角色。
在 18 个评估案例中,适配器重现了发色与发型、瞳色、服装以及标志性配饰,例如角与尾巴、光环、蝴蝶翅膀或女仆头饰,而同样的纯场景提示词在裸基础模型上只会返回一个泛化角色。所有案例中姿势、构图和背景都遵循提示词,未观察到姿势复制。
两个普通参考在留出集之外也展示了同样的分工:
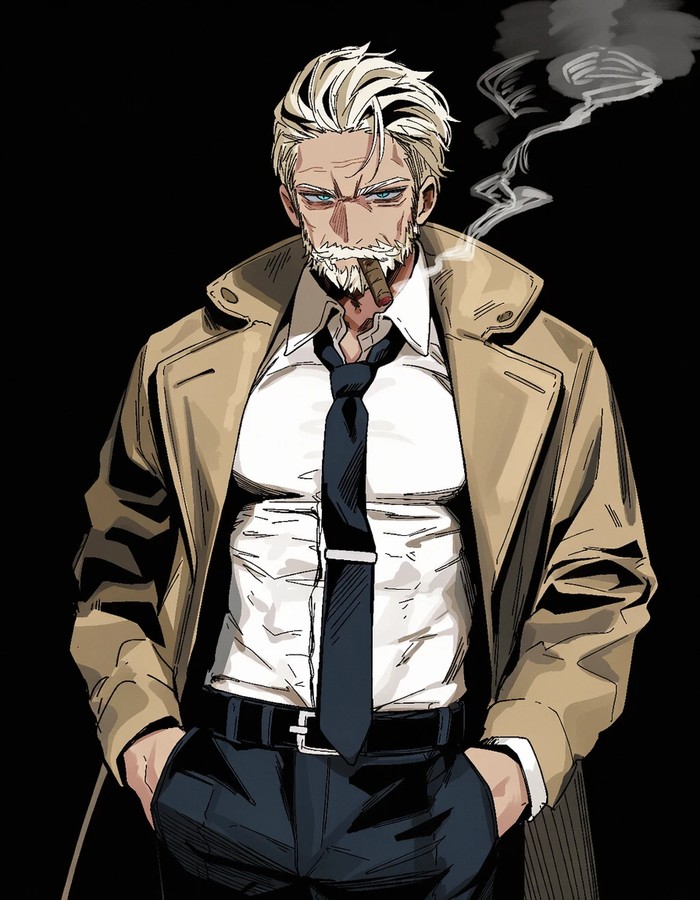 | 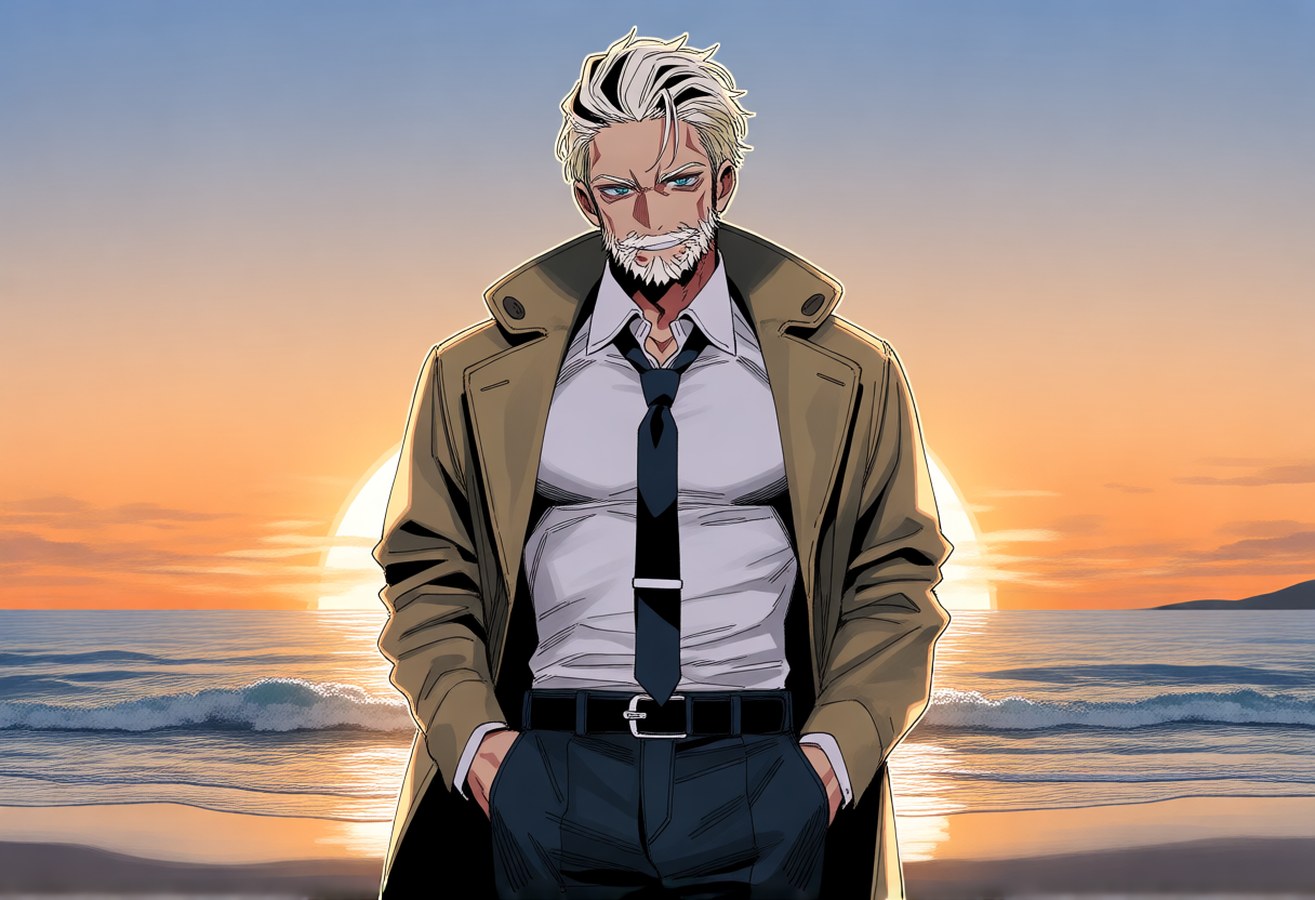 |
|---|---|
| 参考 A,提供给适配器的唯一图像 | cowboy shot, looking at viewer, smile, beach, ocean, sunset |
提示词中不含角色名、画师标签或外观标签。推荐设置为 Euler 采样器、28 到 30 步并搭配 simple,文本 CFG 4.5,参考引导 4.5 到 6 并启用 APG,计算精度使用 bf16,因为 Anima 在 fp16 下会溢出。
风格是较弱的一半
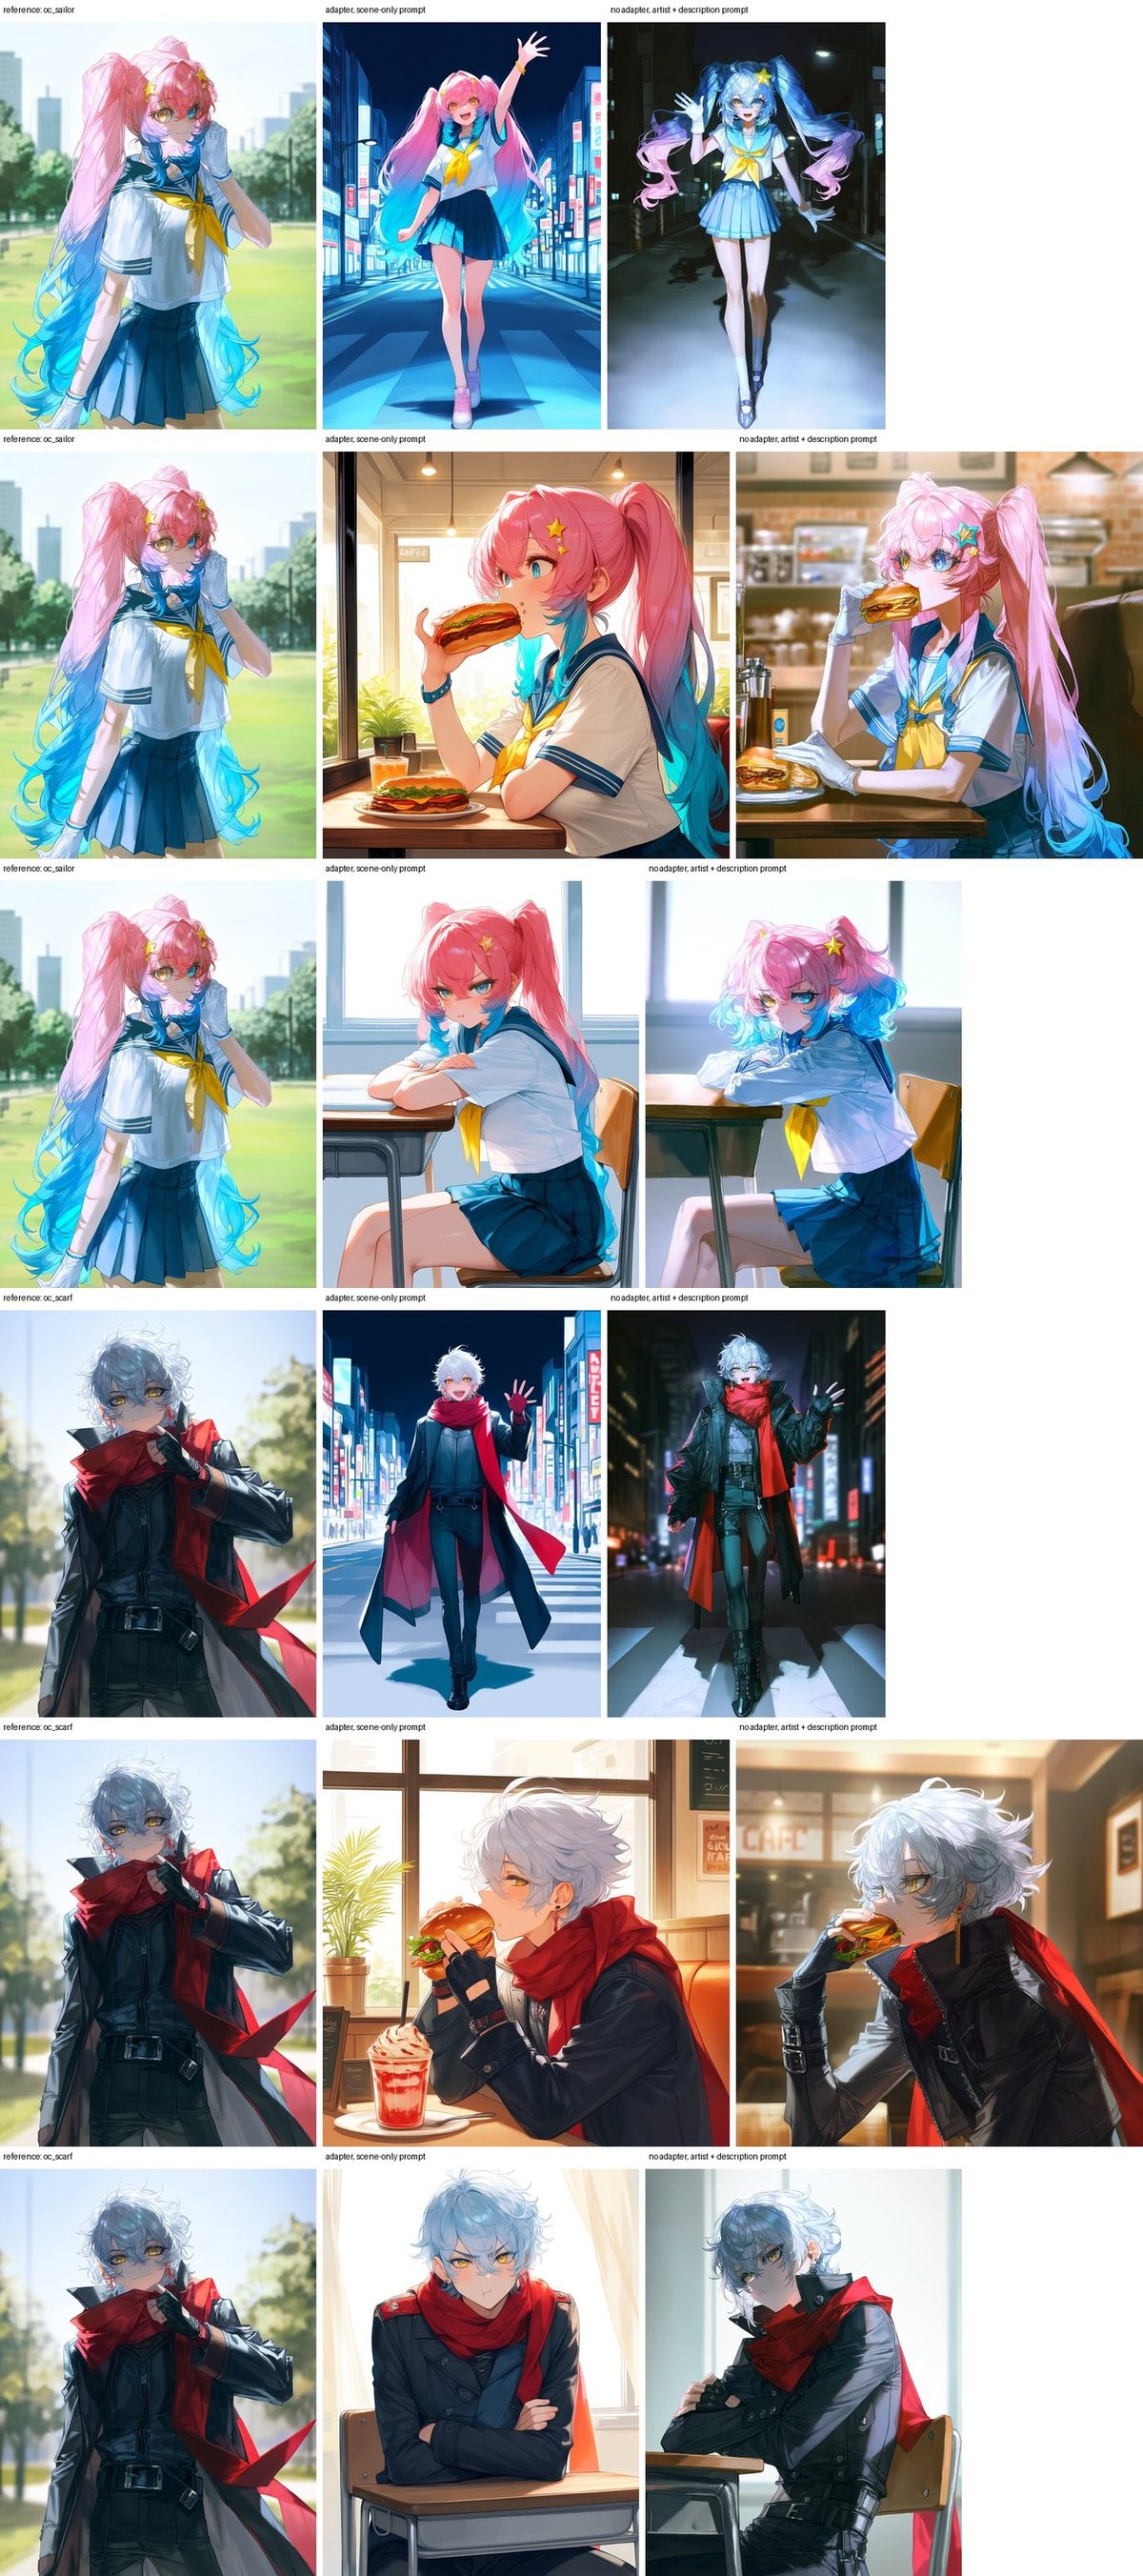
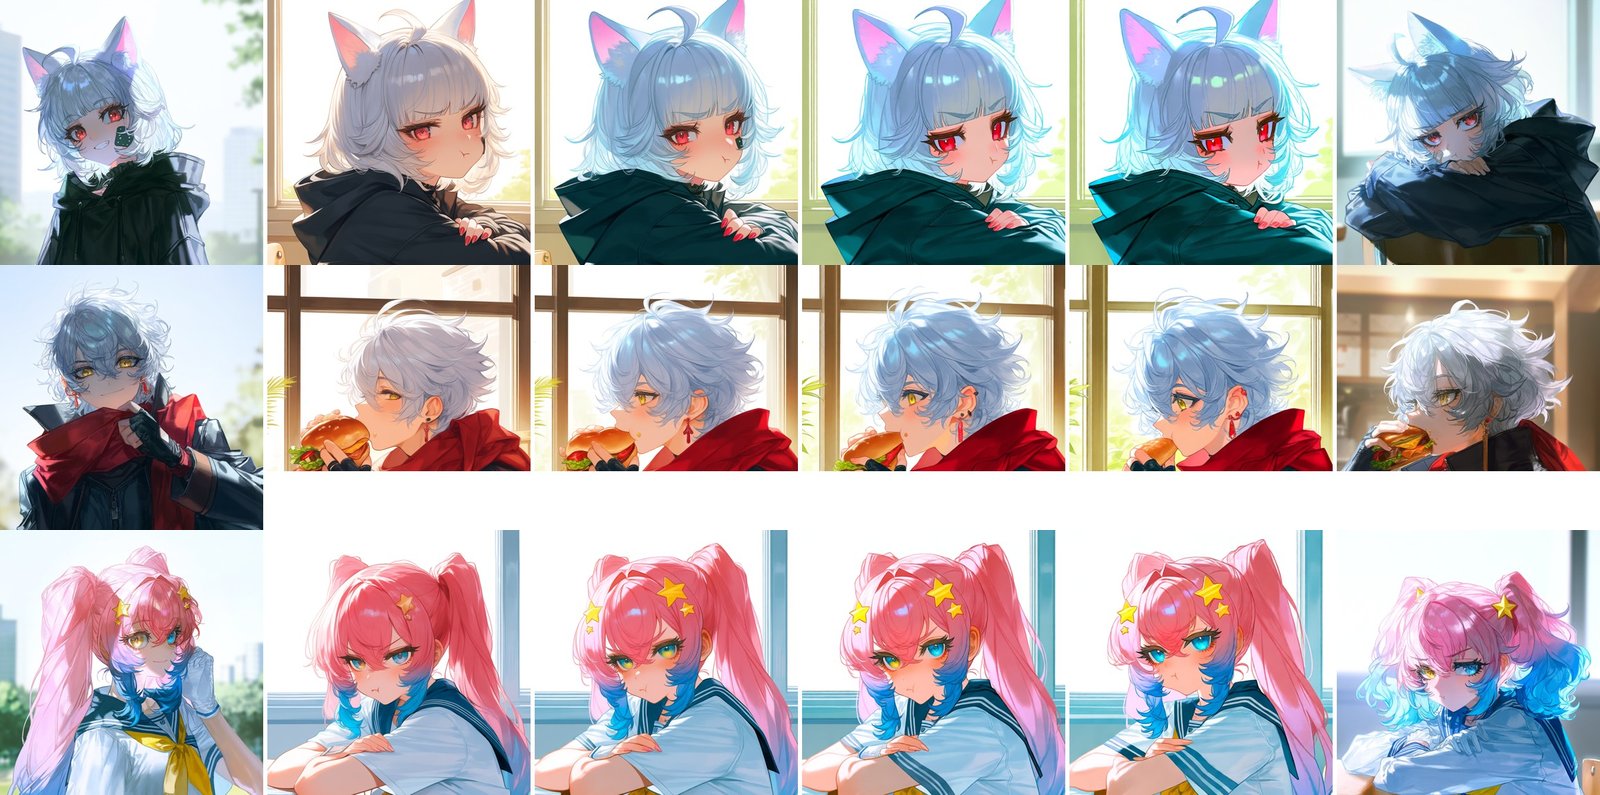
由基础模型使用训练中从未出现过的画师标签绘制的原创角色。每一行:参考图;使用适配器加纯场景提示词;使用画师与描述标签的基础模型。
角色设计迁移得很好:渐变双马尾、星星发饰、领巾、银发配红围巾和手套。画师的绘画质感、柔和光照与低饱和配色在参考引导为 1 时并未传达出来,输出回落到更锐利的 Anima 默认风格。
参考引导为 1、2.5、4.5 和 6 时的局部裁剪,旁边是参考图,最右侧是基础模型加完整标签。
提高参考引导可以找回发丝质感与高光、眼睛的渲染、冷色调,以及引导为 1 时会丢失的小配饰,例如绷带或异色瞳。超过约 4.5 后颜色会过饱和,已有的漂移会被放大,这正是 APG 或 rescale 校正的用途。绘画质感仍然没有出现,反馈将此归因于 LoRA 对它的学习不足,而不是放大不够。作者正在生成一个更大的数据集:2,000 个角色、三种画师风格,并计划把角色参考与风格参考分开。
节点
| 节点 | 作用 |
|---|---|
| Anima Ref Adapter Loader | 将适配器 LoRA 附加到 Anima MODEL 上。ref_offset_h 保持为 1.0,即训练时的取值。 |
| Anima Ref Latent | 以白色填充把参考适配进输出尺寸,对其进行编码,并同时返回该分辨率下的空 Latent。 |
| Anima Ref Guider | 供 SamplerCustomAdvanced 使用的 GUIDER,包含文本 cfg、ref_guidance、APG 或 rescale 校正,以及 PAG 等 CFG 后补丁。 |
其余部分由 ComfyUI 核心提供:anima_baseV10.safetensors 用 UNETLoader,Qwen3-0.6B 编码器用 CLIPLoader,Qwen-Image VAE 用 VAELoader。基础图在单个 SamplerCustomAdvanced 上共 19 个节点;第二个工作流增加了 Anima Safe PAG。当 ref_guidance 为 1 时,参考存在于 CFG 的两个分支中,每一步的开销与普通 CFG 步相同;大于 1 时每一步要运行模型三次,约为普通 CFG 步的 1.5 倍。示例工作流还使用了 ComfyUI-KJNodes 的 Patch Sage Attention,该节点可以绕过。
局限
这个试点版本在 300 个角色上以 rank 32 训练了 2,000 步,作者列出了这样做的代价:身份迁移远好于风格,强烈的绘画风格几乎无法迁移,细小图案、疤痕、耳环和特殊肤色常常丢失,大面积服装可能出现颜色漂移,参考角色偶尔会以场景中一个物体的形式再次出现。训练配对全部是 Anima 渲染结果,因此适配器继承了基础模型的偏向,而且目前的评估都是定性的,没有身份或风格相似度指标。
获取方式
适配器权重位于 Hugging Face,文件名为 anima_ref_adapter_pilot_r32.safetensors(约 92 MB),放入 ComfyUI/models/loras/。节点包可在 ComfyUI/custom_nodes 内通过 git clone https://github.com/ElectronGirl/ComfyUI-Anima-Ref-Adapter.git 安装,需要 Anima base v1.0 及其 Qwen3-0.6B 文本编码器和 Qwen-Image VAE。适配器是在基础模型上训练的,因此仍可在适配器加载器之前加载 Anima turbo LoRA,并使用其惯用的步数与 CFG。
评论
使用 GitHub 登录后即可参与讨论。