MiniMax H3 迎来 VBVR LoRA:改善运动与对象一致性
Licon VBVR 是面向 MiniMax H3 的图生视频 LoRA,基于 VBVR 视频推理数据训练,针对对象复制、穿模和动作顺序错乱等问题。可在 ComfyUI 中加载使用。
Licon VBVR 是 Licon Studio 于 10 月 23 日发布的 MiniMax H3 图生视频 LoRA(Hugging Face)。该适配器基于为 H3 重新处理的 VBVR 数据进行训练,针对的是视频片段需要在一段时间内保持多个对象时出现的典型失败模式:同一对象出现意外复制、身体穿模道具,以及动作顺序错乱。
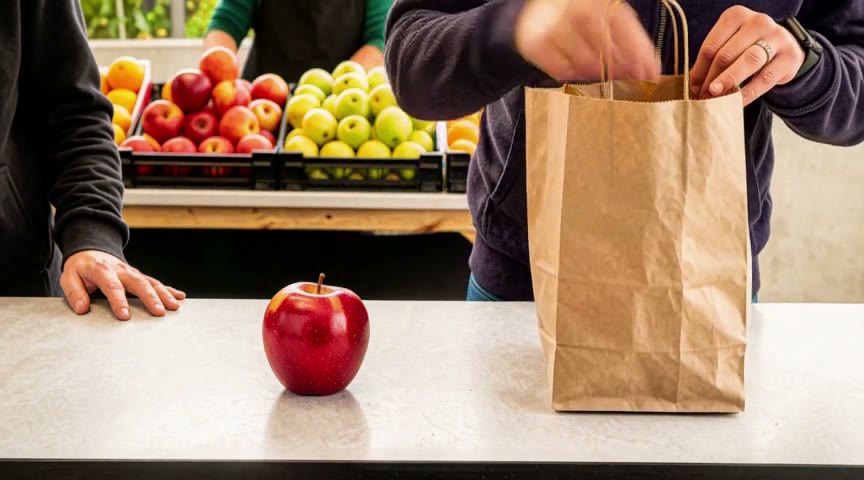
来自项目自身验证片段的画面。来源:Licon VBVR
该版本附带六个验证案例,每个案例都包含首帧输入、精确的提示词,以及使用相同种子分别在不加载和加载 LoRA 的情况下渲染出的并排对比。下面两组均为 864x480、384 帧,时长各 12.25 秒。
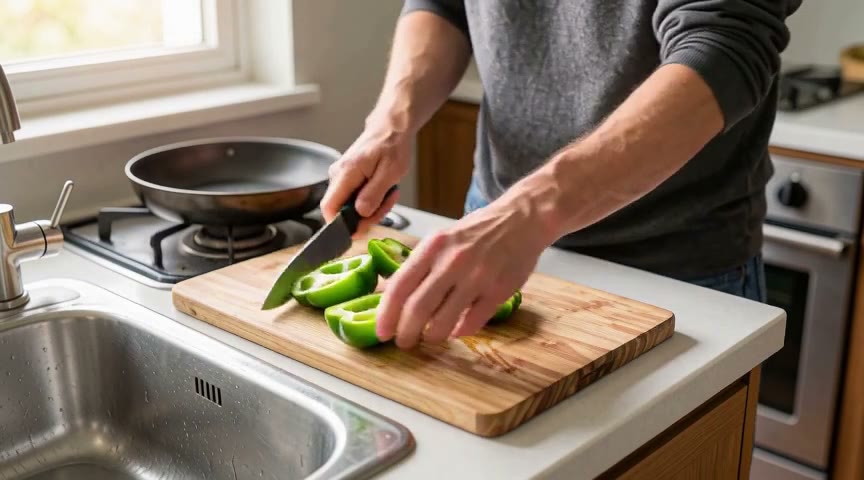 | 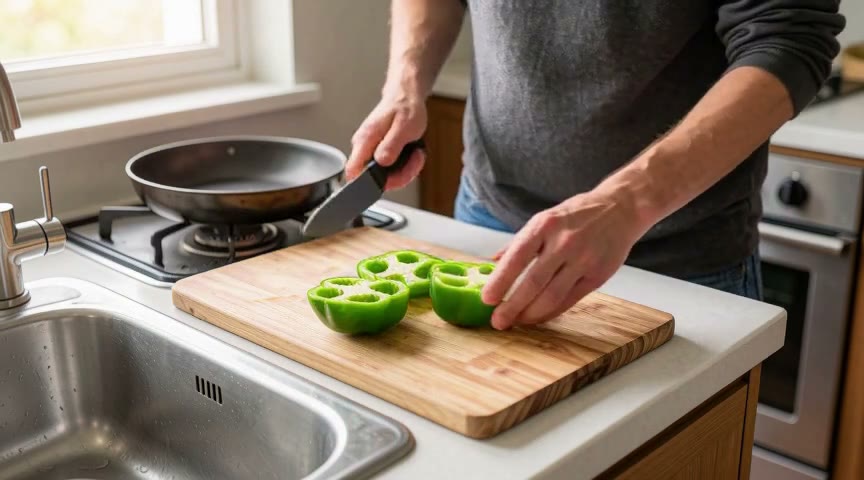 |
|---|---|
| 厨房场景,基础 H3 | 厨房场景,H3 加 VBVR |
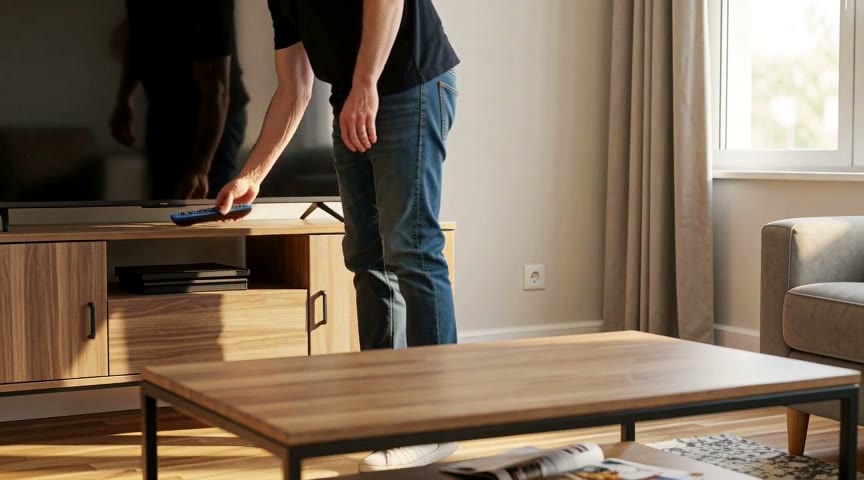 | 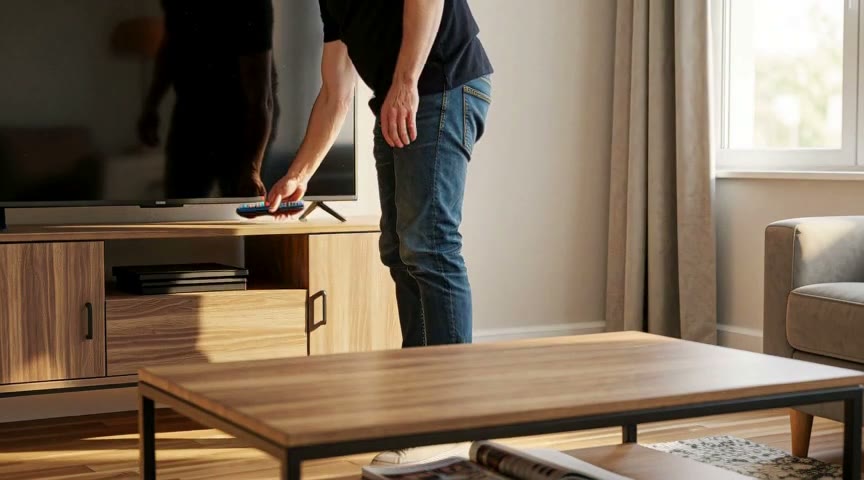 |
|---|---|
| 客厅场景,基础 H3 | 客厅场景,H3 加 VBVR |
厨房案例要求模型清洗一个绿色甜椒,将其切块并移入平底锅,且在整个序列中保持是同一批块。客厅案例则要求按指定顺序完成两个动作:先把杂志放到下层架子上,再把电视机旁的蓝色遥控器拿过来,而其他所有对象都保持在原位。两个提示词都逐步描述动作并禁止出现额外对象,这正是该 LoRA 所希望真正遵循的指令类型。
基础 MiniMax H3 在厨房提示词下的结果。
相同提示词与种子,加载 VBVR LoRA 后的结果。
VBVR 为 LoRA 带来了什么
VBVR(A Very Big Video Reasoning Suite)是一条视频推理数据集系列:围绕可验证任务构建视频片段,例如在遮挡情况下追踪某个对象、按规则对对象排序,或延续形状序列,并用提示词精确描述该任务。公开的 SFT 划分(VBVR-Pro-SFT-Video)是这类视频片段的大型集合,而训练代码与基准测试则是各自独立的项目。
作者围绕 H3 自身的 pipeline 重建了这批数据,把数据准备与预处理调整为符合 H3 训练方式的形式,而不是直接沿用其他模型的格式。该 LoRA 的文件头记录了 434,894 条训练条目、7,000 步、1280x720、rank 16、学习率 5e-05 并采用 cosine 衰减,仅作用于每个 block 中的四个投影层:attn.qkv_proj、attn.out_proj、mlp.fc1 和 mlp.fc2。监督仅限视频,音频损失权重设为零,因此该 LoRA 不会影响 H3 在生成画面的同时生成的音频分支。
该适配器大小为 149 MB,对 H3 而言相当小,与 rank-16 的构建相符。其训练元数据将 minimax_h3_fl2va_bf16.safetensors 指定为基础 checkpoint,因此它适用于 FL2VA 基础模型,而非 T2VA 版本。
在 ComfyUI 中使用
无需安装任何额外内容。将 H3-Licon-VBVR-I2V.safetensors 放入 ComfyUI/models/loras/,然后在 H3 图生视频工作流的 LoraLoaderModelOnly 节点中选择它即可。
该文件采用 kohya 命名(如 lora_unet_blocks_0_attn_qkv_proj.lora_up.weight 等),ComfyUI 自带的 LoRA 加载器可直接将其映射到 H3 的 block 名称,因此无需转换脚本或自定义节点。该项目并未发布工作流 JSON;任何现有的 H3 首帧工作流都可使用,LoRA 会作为普通的模型补丁应用。
局限
这些对比是定性的,且来自作者本人。文中没有基准测试表,也没有针对 LoRA 强度的消融实验,因此在较低强度下效果能保持到什么程度尚无文档说明。六个验证片段全部是 864x480 的写实室内场景,只涉及一两个被操作的对象,比训练集的任务组合更窄。与任何 H3 LoRA 一样,音频分支未被触碰,因此声音完全由基础模型生成。
获取方式
该 LoRA 已在 Hugging Face 上发布,并附带全部六组验证对比及其提示词。同一实验室此前还发布了 LTX-2.3 VBVR LoRA 和可直接用于 ComfyUI 的 Wan 2.2 VBVR 版本,并在今年更早时候发布了 MSR-v2 多主体引用 LoRA,详见 Licon MSR-v2。
评论
使用 GitHub 登录后即可参与讨论。