MiniMax H3 Singularity V2:动作覆盖更广,音频引用问题修复
WarmBloodAban 的 MiniMax H3 Singularity V2 INT8 为 ComfyUI 带来更广的动作覆盖范围、更严格的提示词遵循、修复后的音频引用路径以及更强的风格渲染。
Minimax-h3_Singularity_ref2va_v2_int8.safetensors 于 UTC 12:02 上传,模型卡片在同日晚些时候新增了 V2 章节。截至本文撰写时,该仓库约有 811 个点赞、669,000 次下载。
Singularity 是此前在 MiniMax H3 Singularity 中介绍过的社区 H3 融合微调模型:它合并了 H3 的 ref、fl 和 b25-49 checkpoint,先进行深度微调,再经过三天的剪枝以移除高步数训练留下的痕迹。V2 并未改变这套配方,也没有改变它所服务的四条 pipeline(文生视频、图生视频、参考生视频和视频转视频)。它仍是同一个模型,只是在此基础上用一套不同的修复重新训练了一遍。
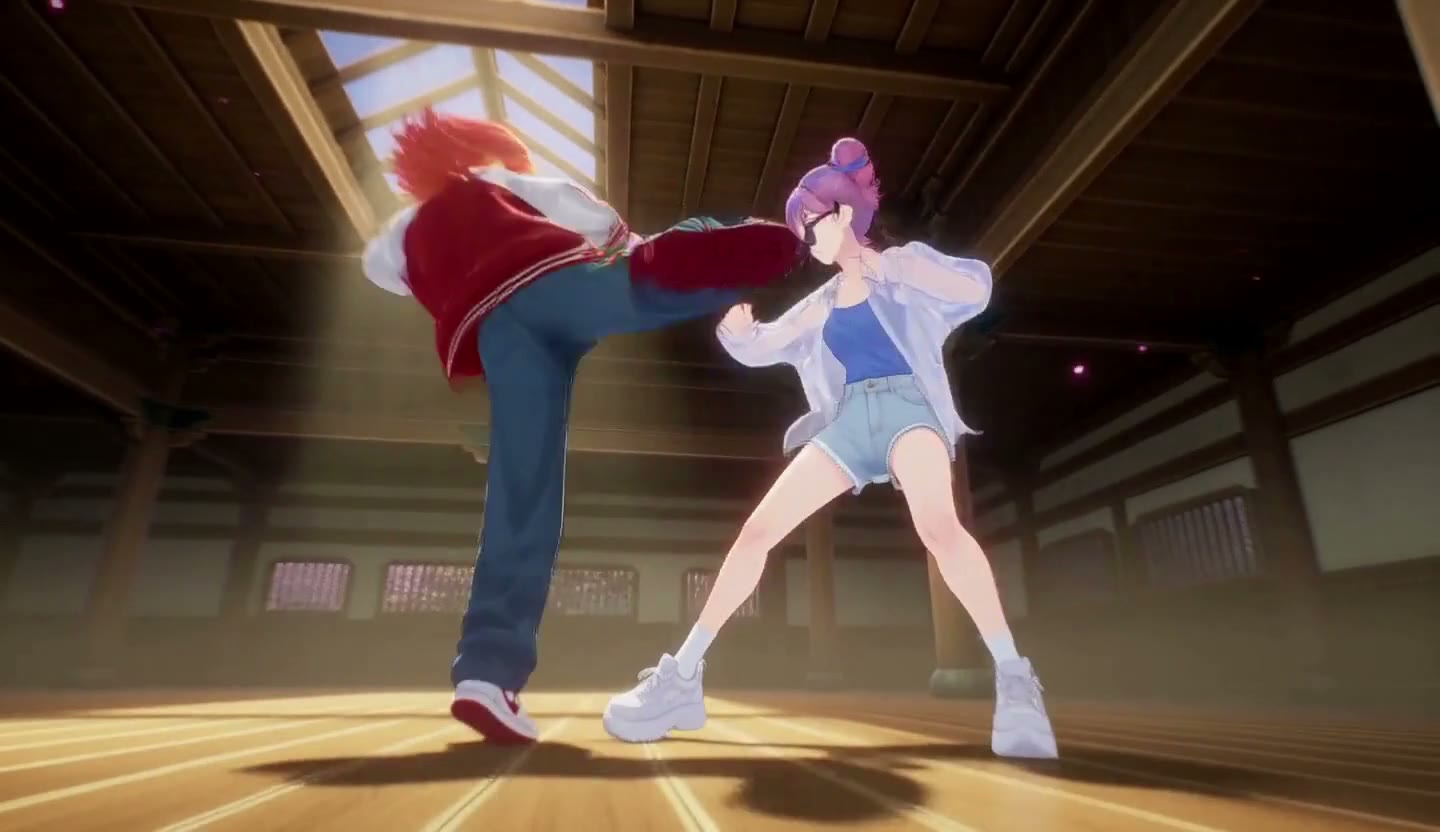
发布仓库中一段展示视频里的一帧。
V2 有哪些变化
模型卡片列出了相对 V1 的四项变化,其中三项是质量修复,一项是功能性 bug 修复。
| 方面 | V2 变化 |
|---|---|
| 动作覆盖 | 在 V1 基础上进一步训练,覆盖更广的动作场景与更多样的运动序列 |
| 提示词遵循 | 更贴近主体、动作、环境与风格说明,建议提示词保持在 5,000 字符左右 |
| 音频引用 | 音频引用条件问题已修复。现在可以用一段音频作为引用,来调整角色的颜色基调 |
| 风格渲染 | 当提示词点明目标观感(写实、东亚写实、3D CG 或电影感 CG)时效果更强 |
音频引用修复是唯一一项改变模型“能做什么”而非“做得多好”的变化。在 V1 中,音频引用路径未能正确施加条件,因此把音频与引用一并传入几乎不起作用,或产生偏离目标的颜色;V2 表示该路径现在可用于色调调整。其余特性均保持不变:面向 HDR 的训练以对抗运动模糊、中远景下的远处人脸修复、降低皮肤光泽、更强的近战与剑斗动作、奇幻 VFX、相机运动响应以及表情细节。
V2 的提示词写法
V2 的引导是在一条连贯的说明中描述主体、动作、环境、相机运动和预期风格,并避免重复以及存在冲突的风格词。卡片还给出了每种观感对应的关键词组:
| 视觉风格 | 建议包含的关键词 |
|---|---|
| 写实 | photorealistic, natural lighting, realistic textures |
| 东亚写实 | East Asian realism, realistic East Asian aesthetics, natural lighting |
| 3D CG | 3D CG, detailed materials, stylized 3D rendering |
| 电影感 CG | cinematic CG, cinematic lighting, film-quality rendering |
5,000 字符这一数字被描述为上限而非目标,因此对于动作类镜头,简短且结构清晰的提示词才是预期的默认做法。
仓库中的一段展示视频,1440×832,带音频。
仓库中的另一段展示视频。封面图即取自这一段。
一段展示视频,其文件名标明这是一次音频引用测试,也就是 V2 修复的那条路径。
文件与设置
V2 以单个 INT8 checkpoint 形式发布,占用与原生 H3 INT8 权重相同的槽位:
| 文件 | 大小 | 备注 |
|---|---|---|
Minimax-h3_Singularity_ref2va_v2_int8.safetensors | 31.7 GB | V2 版本 |
Minimax-h3_Singularity_ref2va_v1.3_Pruned_w4a8.safetensors | 11.0 GB | V1.3 剪枝 4-bit 构建,未变 |
Minimax-h3_Singularity_ref2va_Pruned_v1.3_int8.safetensors | 19.5 GB | V1.3 剪枝 INT8 构建,未变 |
V2 的上传只包含全尺寸 INT8 布局:目前还没有 V2 的剪枝 INT8 构建,也没有 4-bit 构建,因此此前使用 11 GB w4a8 文件的显卡仍需回退到 V1.3 checkpoint。卡片仍推荐 minimax_h3_ref2v_turbo_4step_v0.1 作为四步推理的加速 LoRA。
仓库还附带 MiniMax_H3_Singularity_Prompt_Writing_Specification_Enhanced_EN.md,这是一份最后更新于 9 月的提示词编写规范,描述了该微调模型被训练去读取的提示词结构。
获取方式
从 Hugging Face 仓库下载 V2 checkpoint,放入 ComfyUI/models/diffusion_models/,并在放置 MiniMax H3 扩散模型的位置加载它。模型卡片链接了一个 RunningHub 工作流,可在没有本地 GPU 的情况下通过浏览器测试;r/comfyui 上的一篇社区帖子则链接了一个围绕 V2 构建的双采样工作流。
评论
使用 GitHub 登录后即可参与讨论。