MiniMax H3 PTD LoRA 将 Ref2VA 降至 8 步或 4 步
淘宝内容 AI 的 PTD 逐跳 LoRA 将 MiniMax H3 Ref2VA 降至 8 步或 4 步,另有 RefAsymOPD 版本与经验证的 ComfyUI 节点。
taobao-content-ai 账号为 MiniMax H3 发布了两款 Ref2VA 加速 LoRA:逐跳 PTD 组合(MiniMax-H3-Ref2VA-PTD-8Step / -4Step)于 2026 年 10 月 20 日上线,随后在 10 月 22 日又推出第三个使用 PTD + RefAsymOPD 训练的 checkpoint。截至本文撰写时,PTD 仓库约有 33 个点赞和 480 次下载。
PTD 全称 Parametric Trajectory Distillation(参数化轨迹蒸馏),由 Lan Feng 与来自 EPFL、NVIDIA 与 Stanford 的合著者发表于 arXiv 2610.11498,其项目主页上的影片完全由 MiniMax H3 生成。该论文将需要 50 步采样的 33B 音视频联合模型,仅依靠一个 LoRA 和轨迹监督,蒸馏为四步或六步的学生模型。
这两个仓库补充的,是上述工作中的 Ref2VA 部分:参考图像输入,视频加音频输出,仅需 8 次或 4 次 transformer 评估。
适配器的工作原理
该团队更早发布的 PDD 版本(MiniMax-H3-Acc-LoRAs)用一组按区间划分的输出头替换了基础模型的单一输出头。PTD 保留了这组输出头,并为每一次推理步训练一个独立的低秩适配器,即在 diffusion 骨干上的“逐跳”LoRA,因此每一跳都会选择自己的适配器并融合自己的输出头。因此,8 跳的 checkpoint 在 8 次 transformer 评估中运行,4 跳的 checkpoint 则在 4 次评估中运行。
每个 checkpoint 都在 safetensors 元数据中携带自己的配置(ptd_num_hops、pdd_num_steps=32、pdd_block_size、lora_rank、lora_alpha、lora_targets)。提供的 apply_ptd_lora 会读取这些元数据并自行推导步数,这也是 ComfyUI 节点中没有步数滑块的原因:sigma 网格是 checkpoint 的固有属性。
| 文件 | 步数 | 大小 | 说明 |
|---|---|---|---|
MiniMax-H3-Ref2VA-PTD-8Step.safetensors | 8 | 11.1 GB | 逐跳 LoRA,8 跳,rank 128,BF16 |
MiniMax-H3-Ref2VA-PTD-4Step.safetensors | 4 | 5.58 GB | 逐跳 LoRA,4 跳,rank 128,BF16 |
MiniMax-H3-Ref2VA-PTD-RefAsymOPD-8Step.safetensors | 8 | 11.1 GB | 布局相同,使用 PTD 加 RefAsymOPD 训练 |
演示展示的内容
PTD 模型卡复用了 MiniMax-H3-Turbo 示例中的三个案例(泳池边的打斗、仓库对峙、从显示器中驶出的摩托车),并将它们与基础 Ref2VA 模型、4 步 Turbo LoRA 以及 8 步 PDD 版本并列对比。参考图像、提示词和 predict_ref2v.py 脚本随仓库一同提供,因此每一列都可以复现。
RefAsymOPD 模型卡更进一步,发布了五个新案例,分辨率为 768×1344,124 帧,24 fps 且带音频,每一行都以 40 步基础模型作为质量上限,与 8 步 PDD 版本、8 跳的普通 PTD 推理以及 8 跳的 RefAsymOPD 推理进行对比。其对应结论相当克制:在相同步数下,背景合理性、清晰度和真实感优于普通 PTD,且没有额外开销,因为该 checkpoint 在结构上与普通 PTD LoRA 完全一致,无需修改代码即可直接替换。
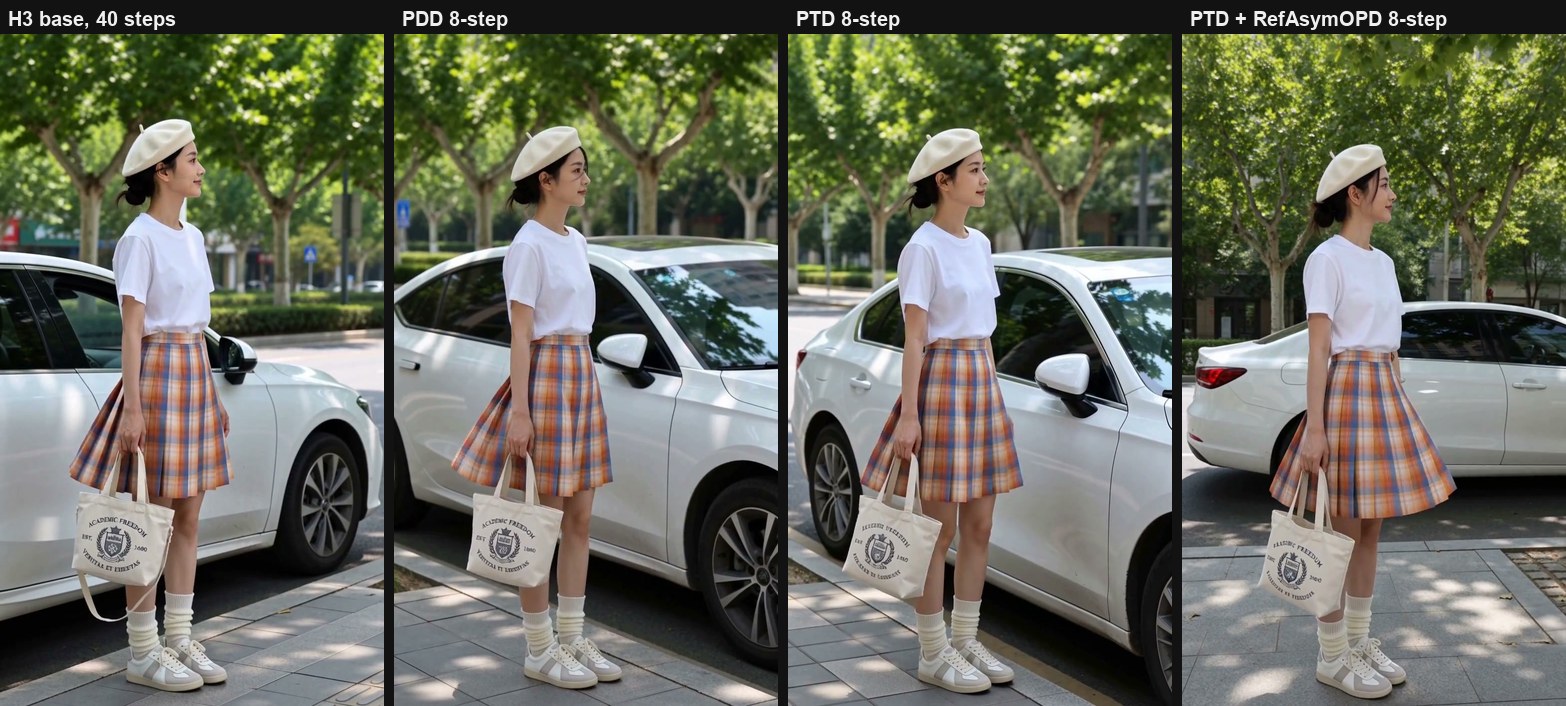
演示案例 sample-0 四列各自的同一帧画面,取自片段的同一时间点:40 步基础模型、PDD 8 步、PTD 8 步,以及 PTD + RefAsymOPD 8 步。
sample-0 的完整 8 步 RefAsymOPD 片段,包含其生成的音频。封面图来自另一个案例(sample-2)的双栏画面。
在 ComfyUI 中运行
两个仓库提供的是同一个自定义节点包:comfyui_node/ComfyUI-MiniMaxH3-PTD/。它本身并不重新实现 PTD 采样:它复用上游 ComfyUI-PTD 节点的 hook 机制,仅替换加载器、跳数网格和输出头。之所以这样拆分,是因为上游接受 4 跳和 6 跳的 checkpoint,并期望在基础输出头上施加逐跳增量,而这些适配器是 4 跳和 8 跳,且是在 PDD 的按区间输出头组之上训练的。
按照该节点包的文档,安装步骤如下:
- 将上游
ComfyUI-PTD(分支release/comfyui-inference)安装到custom_nodes/,并对其执行pip install -e。其ptd_comfy模块会导入同级的ptd包,因此仅克隆而不安装会在导入时失败。 - 将仓库中的
ComfyUI-MiniMaxH3-PTD复制到custom_nodes/。 - 将适配器 checkpoint 放入
ComfyUI/models/ptd/。 - 自行转换基础模型:这些适配器需要来自 MiniMaxAI/MiniMax-H3 的原始、未剪枝的
transformer_ref/,并使用scripts/convert_comfy_base.py进行转换。剪枝版、Turbo、PDD 以及量化基础模型均明确不可用。 - 使用
--disable-dynamic-vram启动 ComfyUI。
文本编码器(qwen3vl_32b_minimax_h3_bf16)以及视频和音频 VAE 来自 Comfy-Org/MiniMax-H3。算上基础模型,完整权重集合约为 140 GB。
节点图很短:UNet加载器,然后是 Load MiniMax-H3 PTD Adapters,接着是 PTD 采样器和 PTD Sigmas 节点,接入自定义采样器(高级),通过 MiniMax H3 参考转视频进行条件化,然后分离 AV Latent 并分别解码视频和音频。仓库提供了 API 格式的示例工作流,每个版本一个,README 中提醒必须先将其参考图像从 asset/ 复制到 ComfyUI/input/。
作者报告称,已通过 ComfyUI 的 HTTP 队列对两个 PTD checkpoint 完成端到端验证:在 checkpoint 节点处恰好为 8 次和 4 次 transformer 评估,分辨率 1344×768,243 帧,24 fps,32 kHz 立体声音频,在场景、人物一致性和音频结构上与 Diffusers 脚本一致。相同种子无法逐比特复现 Diffusers 的输出,因为两个前端抽取初始噪声的方式不同。测试所用环境为 ComfyUI 5cc4b87、ComfyUI-PTD 43ae22c 和 PyTorch 2.13.0+cu130,运行于单张 H20-3e。
社区的变通方案
由于这些适配器需要未剪枝的 140 GB 基础模型,社区的第一反应是让它们适配更小的配置。PTD 发布一天后,一个精简加载器(ComfyUI-PTD-Compact,创建于 10 月 22 日)增加了对剪枝版和量化基础模型的支持,以及 4 步适配器的 int8 版本,Banodoco 的用户一直在发布这些转换版本的首批静帧和片段。在该作者的显卡上,8 步的 int8 版本以 4 MP 生成每张静帧约需 14 秒。
获取方式
两套适配器都已在 Hugging Face 上发布:MiniMax-H3-PTD-LoRAs 对应 8 步和 4 步组合,MiniMax-H3-PTD-RefAsymOPD-LoRAs 对应 RefAsymOPD 变体。在 ComfyUI 之外进行推理,可通过 MiniMax-H3 Diffusers 模块化 pipeline 配合 diffusers >= 0.40.0 和 ref2va 工作流完成。
评论
使用 GitHub 登录后即可参与讨论。