Hy-Nomas:腾讯混元交互式世界模型,8 步生成 720p 可控视频
腾讯混元发布 Hy-Nomas,这是一个 8 步交互式世界模型,可在文本与相机控制下生成 720p 视频,ComfyUI 移植版也已推出。
Hy-Nomas 是腾讯混元的交互式世界模型:你先描述一个世界,然后用文本说明和相机运动持续操控它,模型则持续生成。团队于 2026 年 10 月 21 日发布了权重、推理代码、训练与数据标注代码(tencent/Hy-Nomas | GitHub),以及一个在线演示和一套专用基准。一天之后,社区又推出了 ComfyUI 移植版。
这次发布各项计数仍然不高:截至撰稿时,Hugging Face 上有 21 个赞,GitHub 上有 21 个 star。下文所有内容均来自模型卡、仓库和官方图库,而非第三方测试。
一个世界,分段生成
Hy-Nomas 是在视频分段之间自回归,而不是在帧之间自回归。每个分段都在模型压缩后的 Latent 空间中从高斯噪声去噪,同时关注此前生成的每个分段的键/值缓存。当前轮次的提示词、相机轨迹和该缓存是唯一的输入,注意力在分段之间是因果的,因此生成某个分段永远不需要未来的分段。
蒸馏配置使用 Euler ODE 求解器运行 8 个去噪步,文本与相机引导均为 1.0,输出 720 × 1280、24 FPS。分段长度来自提示词文件:一个 JSON 请求列出带有起止时间戳的 segments、用于开场的 visual_description_long、用于之后每一轮的 description_change,以及带有各自时间戳的 contained_actions。设置 inference.video_length=event 会依据这些事件时间推导分段长度。
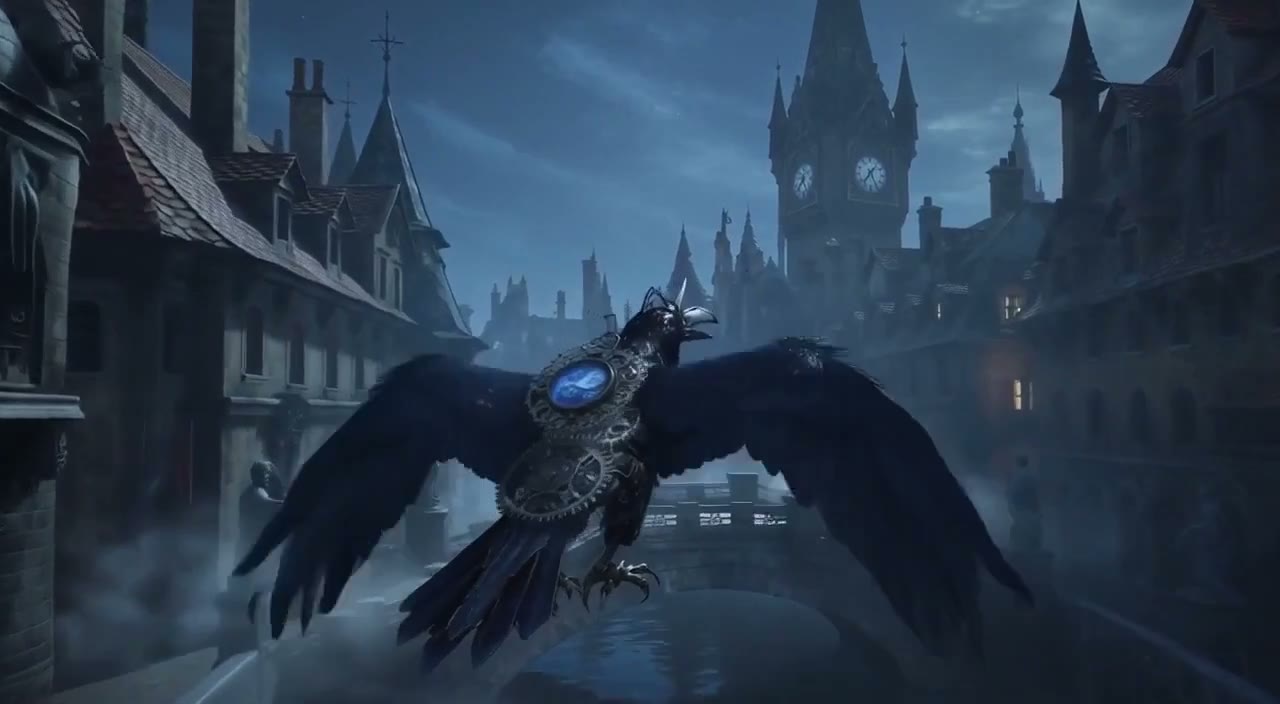
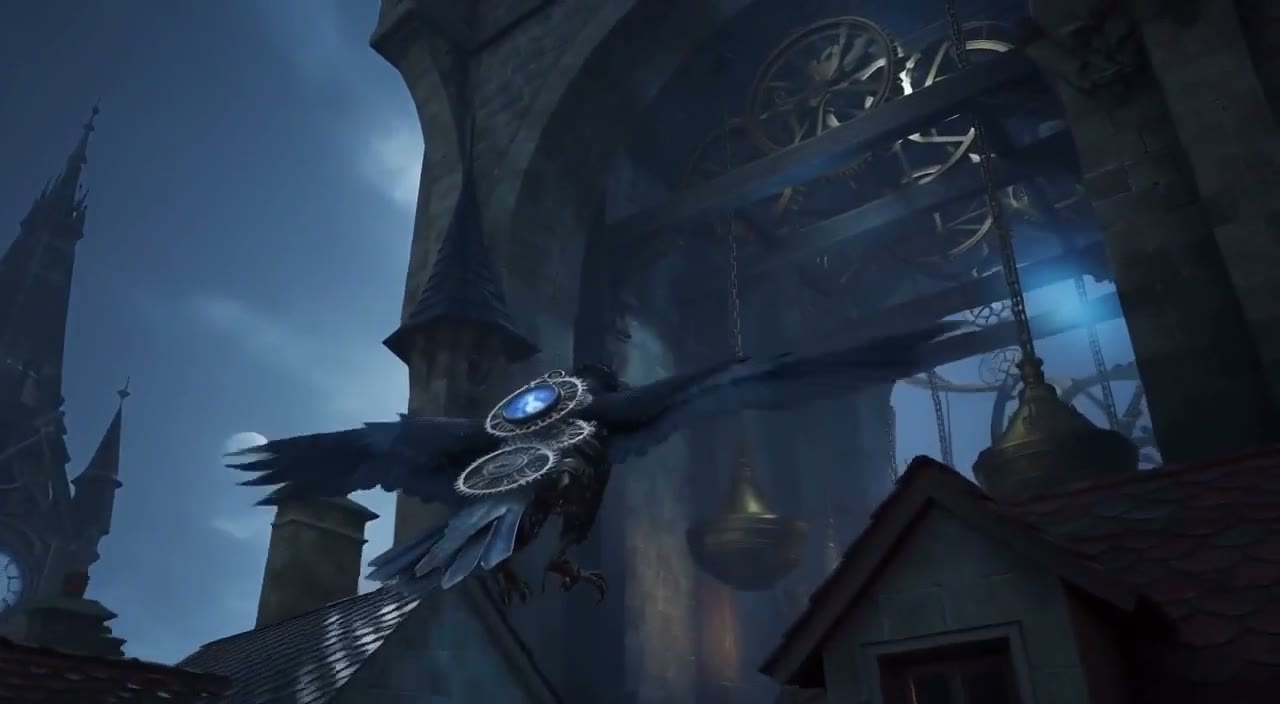
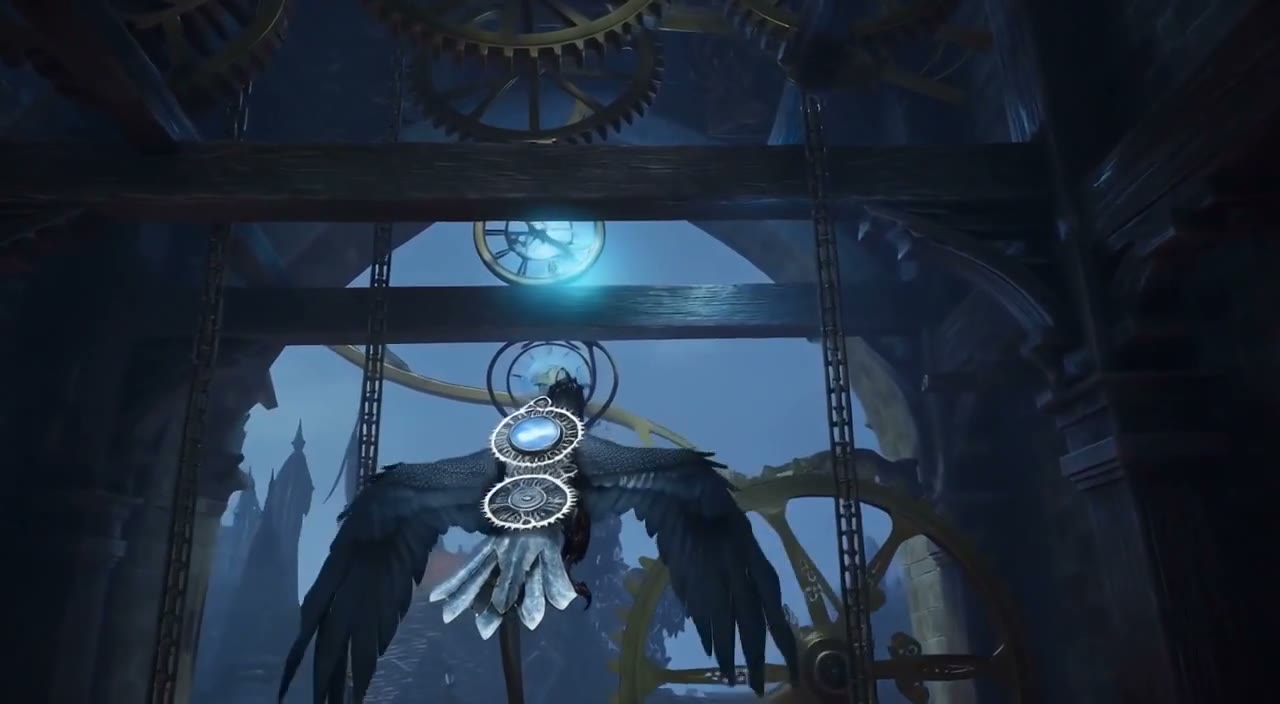
官方图库展示了在更长运行中它的表现。下面是一个 60 秒的片段 clockwork-flight,由五个各 12 秒的纯文本轮次构成,采用 CG 风格的第三人称跟随相机:
 |  |  |
|---|---|---|
| 1 秒:"一只机械鸟飞过屋顶上方,前方是成排的高耸尖塔。" | 30 秒:"它侧身掠过一道拱门,朝塔内的齿轮与结构飞去。" | 48 秒:"鸟儿在头顶的齿轮和塔内的一束蓝光下方穿行。" |
同一片段中六秒的摘录,取自鸟儿进入钟楼的那一轮。由腾讯混元生成,截取自官方图库。
相机控制作为一等输入
相机运动不是提示词中的建议,而是一条独立的条件路径。轨迹文件包含形状为 [N, 4, 4] 的相机到世界矩阵 c2ws 和形状为 [N, 3, 3] 的内参,模型对外参做归一化,按四个视频帧进行分组,并将每组展平为 64 维输入,视频 token 在每个双流模块中通过交叉注意力查询该输入。两个缩放系数暴露了这些控制项:trajectory_translation_scale 默认为 1.0,trajectory_rotation_scale 默认为 2.5。
在单次运行中,文本与相机也可以交替使用。图库按风格(真实素材、CG、电子游戏、动画和动漫)和透视(第一人称、第三人称跟随、第三人称观察)区分样本;在演示中,你可以按住 WASD 和方向键,或者拖动鼠标,在已生成的世界中移动,移动过程会以 24 FPS 记录,并在下一轮播放。
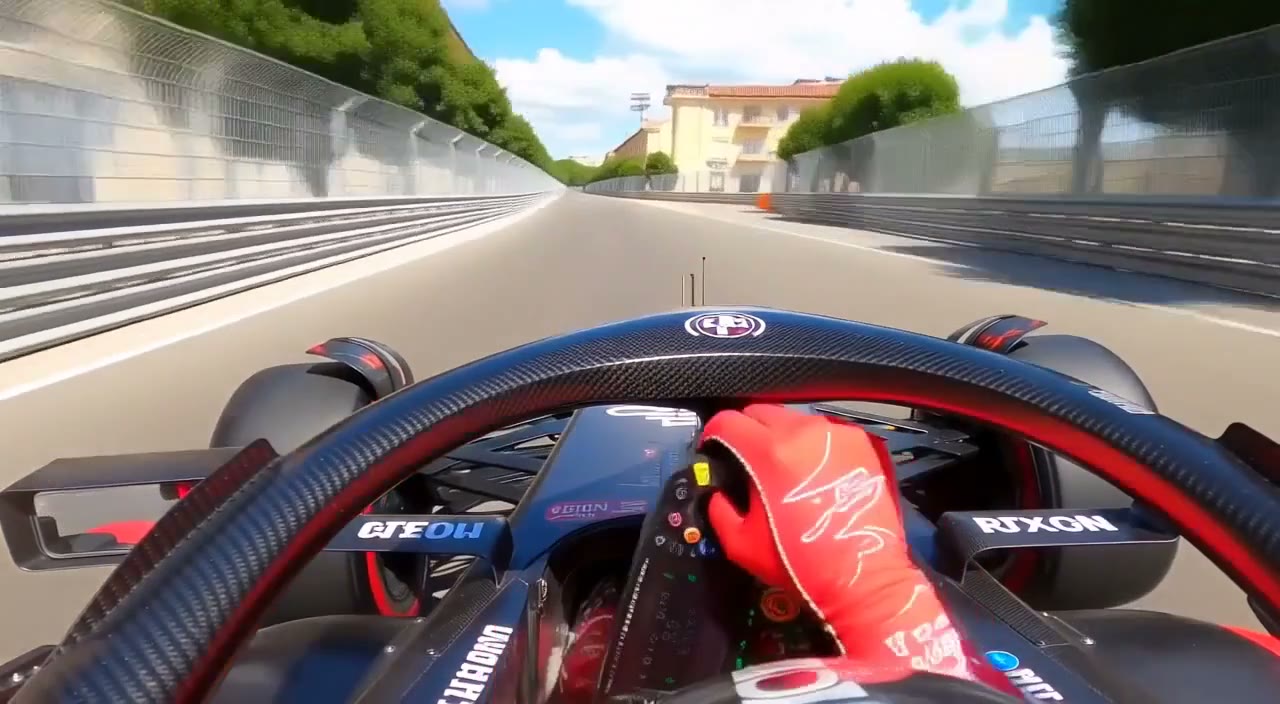
图库中的一个第一人称样本 circuit-drive:从赛车座舱内看到的街道赛道。由腾讯混元生成。
模型内部
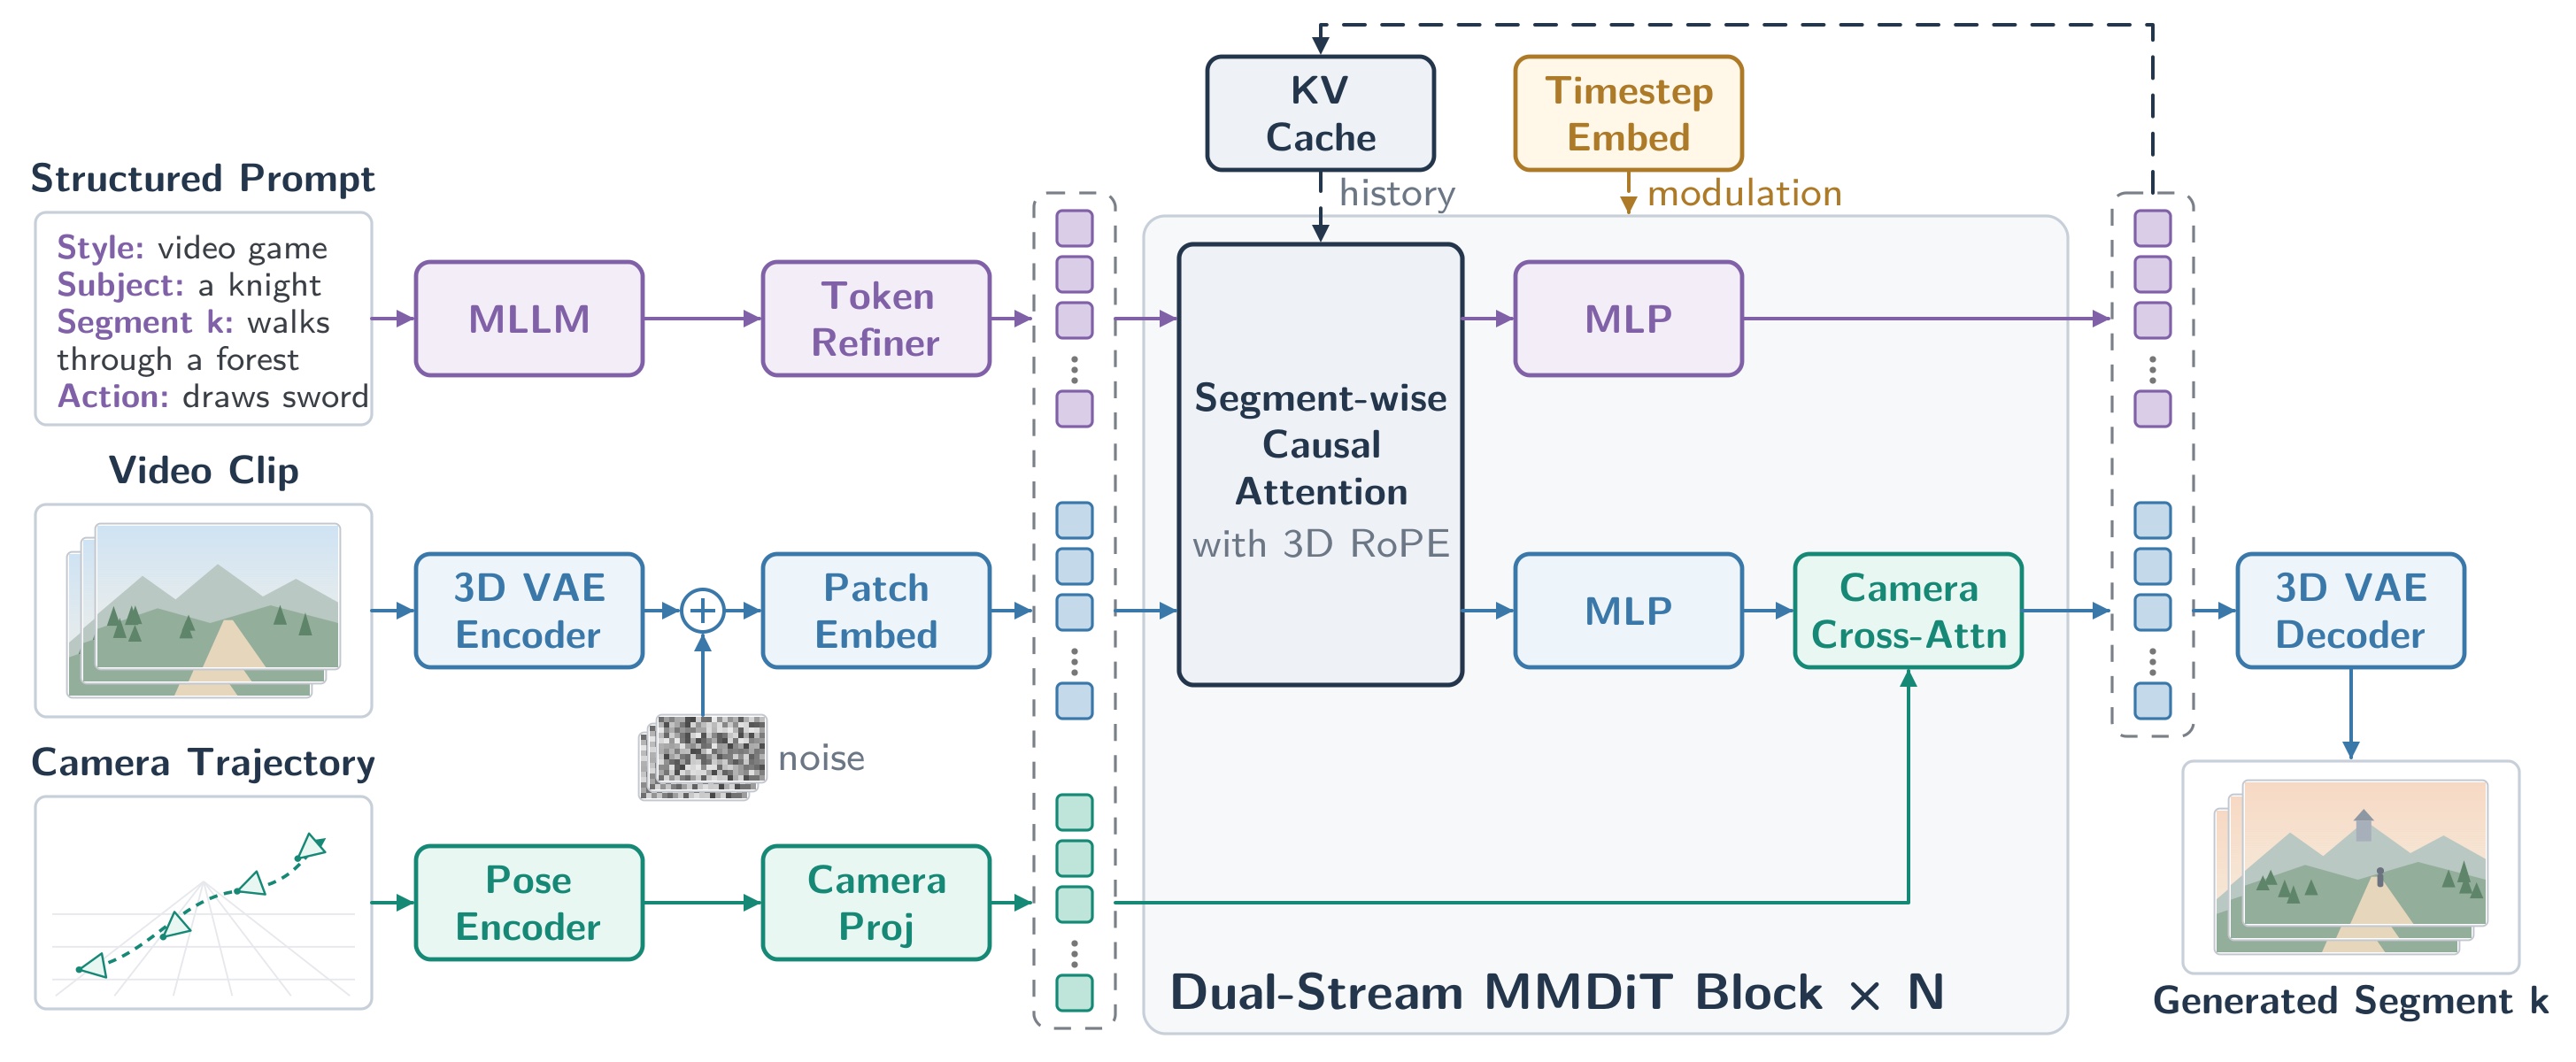
发布仓库中的框架图:文本、视频 Latent 和相机轨迹输入到双流 MMDiT 模块。
| 属性 | 配置 |
|---|---|
| 主干 | 54 个双流 MMDiT 模块,无单流模块 |
| 隐藏尺寸 | 2,048,16 个头,每头 128 维 |
| 前馈 | 4× 扩展,中间尺寸 8,192 |
| Latent | 输入输出均为 32 通道,patch 1 × 1 × 1 |
| 位置编码 | 3D RoPE,尺寸 [16, 56, 56],theta 256 |
| 文本条件 | Qwen2.5-VL-7B-Instruct 隐藏状态,3,584 维,两层 token 精炼器 |
| 相机条件 | 外参嵌入,在双流模块中通过交叉注意力注入 |
| 预测 | 流速度,Euler ODE 采样 |
视频存放于 DCAE-V f32t4c32 Latent 中:32 通道,每个方向 32× 空间压缩,4× 时间压缩。解码由微调过的 PixelUMM 解码器完成,它有 36 层、4,096 维隐藏尺寸、32 个查询头和 8 个 KV 头,以 4 × 16 × 16 的 tubelet 在 10 个 Latent 帧、5 帧重叠的时间窗口上重建 RGB。该解码只有一步,与 DiT 的 8 个去噪步相互独立。
单张 4090 配置
引用配置将一个推理组分布在 8 块 GPU 上,采用 8 路序列并行和分布式解码。第二种配置面向单张 RTX 4090,其改动全部集中在内存管理上:
- DiT 权重以及缓存的键和值以 INT8 存储,而线性图层和注意力仍以 BF16 计算。
- PixelUMM 解码器通过 CUTLASS 内核以 FP8 运行,DiT 使用 FlexAttention。
- 文本编码器、DiT 和解码器在各自阶段移到 GPU,随后卸载到 CPU。
- GPU 历史被限制为
temporal_context采样的 18 个历史 Latent 帧,更早的历史归档到系统内存中。
模型卡明确说明了这些取舍:系统内存必须容纳已卸载的模型和不断增长的历史归档,CPU 到 GPU 的传输会增加延迟,而历史预算并不能限制当前分段的内存占用。官方没有公布每个分段的耗时,因此截至撰稿时,4090 上的速度尚未得到验证。
LoRA 微调与提示词服务
本次发布附带两个适配器。Cinematic LoRA 作为可选画质适配器,用于兼容的浮动式 DiT;Robotics LoRA 在 RealSource-World 机械臂数据集上训练,用于合并进蒸馏 DiT,以增强生成世界中的模拟操作能力。INT8 加载器无法在推理时加载单独的 LoRA,因此适配器相关工作需通过 BF16 或 FP32 权重进行。
仓库还包含微调流程:SFT 数据准备、针对长序列的离线序列打包,然后是训练与合并。对于网页演示,有一个硬依赖 Nomas-PE,这是一个独立服务,把用户说明转换为结构化的生成提示词;离线推理可以读取预先准备好的提示词文件并跳过它。预构建的 Docker 镜像(hynomasoss/hynomasoss:cu130)包含 PyTorch、FlashAttention 和 MagiAttention,可免去手工构建 CUDA 内核。
Hy-Nomas-Bench
除模型之外,团队还发布了 Hy-Nomas-Bench,包含四套基准、共 280 个测试用例,覆盖多轮自由文本交互、相机导航、文本与相机交替控制以及空间记忆。该数据集提供结构化提示词、交互序列、键盘时间线和引用相机轨迹,因此可用于评估一长段已生成内容的一致性,而不仅仅是单个片段。
获取方式
本次发布没有原生 ComfyUI 支持:没有核心节点,也没有 Comfy-Org 重打包版本。官方途径是带 Docker 镜像的 GitHub 仓库,以及托管版的交互式演示。
对于 ComfyUI,社区移植版 Nynxz/ComfyUI-HyNomas 于 10 月 23 日出现,转换后的权重位于 nynxz/Hy-Nomas:
| 文件 | 文件夹 | 大小 |
|---|---|---|
nomas_dit_distilled_int8_convrot.safetensors | models/diffusion_models | 9.0 GB,INT8 ConvRot |
nomas_dit_distilled_bf16.safetensors | models/diffusion_models | 17.1 GB,LoRA 合并的基础 |
nomas_pixelumm_vae_bf16.safetensors | models/vae | 15.8 GB,PixelUMM 解码器加 DCAE-V 编码器 |
该移植版通过内置的 UNet加载器 加载 DiT,通过 加载CLIP 使用 ComfyUI 自带的 qwen_2.5_vl_7b.safetensors(类型为 qwen_image,来自 Comfy-Org/Qwen-Image_ComfyUI)加载文本编码器,并通过 加载VAE 加载解码器,因此无需自定义内核。其作者报告,在 RTX 5090 上使用 INT8 checkpoint、分辨率 1280 × 704 时,一个 3 秒的轮次约需 21 秒,另外每个窗口约需 4 秒解码时间。请把这些数字视为某位用户在一个发布仅一天的移植版上的测量结果,并将其与官方配置的 4090 目标区分开来。
评论
使用 GitHub 登录后即可参与讨论。