FastH3 Omni:8 步 H3 参考视频,音频同步
FastVideo 发布 FastH3 Omni,这是一个 8 步 MiniMax H3 蒸馏版本,可将图像、视频和音频引用合成为一段带立体声的视频,并提供 ComfyUI 权重。
FastH3 Omni 是 FastVideo 推出的 MiniMax H3 参考条件变体:一段提示词加上按顺序排列的图像、视频和音频引用,即可生成一段声音同步的视频,只需 8 次 transformer 评估,而基础版 H3 需要 50 次。Hao AI Lab 团队于 10 月 20 日发布了权重和发布说明,同一集合中还提供了可直接用于 ComfyUI 的单文件转换版本。
模型最多接受 9 张图像、3 段视频和 3 段音频,共 12 个引用,并且至少需要一张图像或一段视频。输出为 24 FPS、带 32 kHz 立体声音频的视频,帧长为 124、243 或 362 帧,即 5、10 或 15 秒。
发布视频中的一帧,由团队在 FastVideo 上用 FastH3 Omni 生成。
按位置引用
提示词通过位置而非文件名来指定输入:<Picture 1>、<Video 1> 和 <Audio 1>,编号按类型分别重新计数。引用视频自带的音轨会作为音频引用标注在其视频标签之前,独立音频则放在最后。由于引用会贯穿每个采样步骤,团队在 ComfyUI 中提供了一个尺寸选择:match 会把每个引用缩放到生成目标的像素面积,而 max 会保留 2048 px 的短边以保证身份一致性,代价是数倍的开销。
一个 5 秒请求,包含一个图像引用和一个声音引用。对白使用音频引用的音色,音频与视频一同生成,而非后期添加。
8 次评估而非 50 次
FastH3 Omni 是基础版 H3 的蒸馏学生模型,发布版本保留了基础版 H3 的文本编码器、视频 VAE 和音频 VAE,只有扩散 transformer 发生变化。采样在引导 1.0、视频 shift 12.0、音频 shift 3.0 下运行,与 ComfyUI 模板自带的配置相同。
在 8 块 GB200 GPU 上的 27 个对齐工作负载中,按完整服务方案对比,团队报告端到端延迟比基础版 H3 低 5.6 到 11.9 倍。以下是公布表格中的部分数据,每个数值均为三个种子的均值:
| 引用 | 长度 | 基础版 H3 | FastH3 Omni | 加速比 |
|---|---|---|---|---|
| 1 张图像 | 5 s | 35.44 s | 5.67 s | 6.25x |
| 1 张图像 | 15 s | 139.69 s | 14.14 s | 9.88x |
| 1 张图像 + 声音 | 5 s | 35.92 s | 5.84 s | 6.15x |
| 3 张图像 | 10 s | 131.25 s | 19.15 s | 6.85x |
| 9 张图像 | 15 s | 282.81 s | 41.57 s | 6.80x |
| 1 段短视频 | 15 s | 140.29 s | 11.76 s | 11.93x |
| 9 张图像 + 3 段视频 | 15 s | 422.20 s | 59.77 s | 7.06x |
团队还表示,在特定的 FastH3 Omni 任务上,其 UniServe 栈在 768p 下对 5 秒、10 秒和 15 秒片段可达到实时生成。公布的片段是对齐条件下的定性对比,并不构成与基础版 H3 输出效果等同的证据。
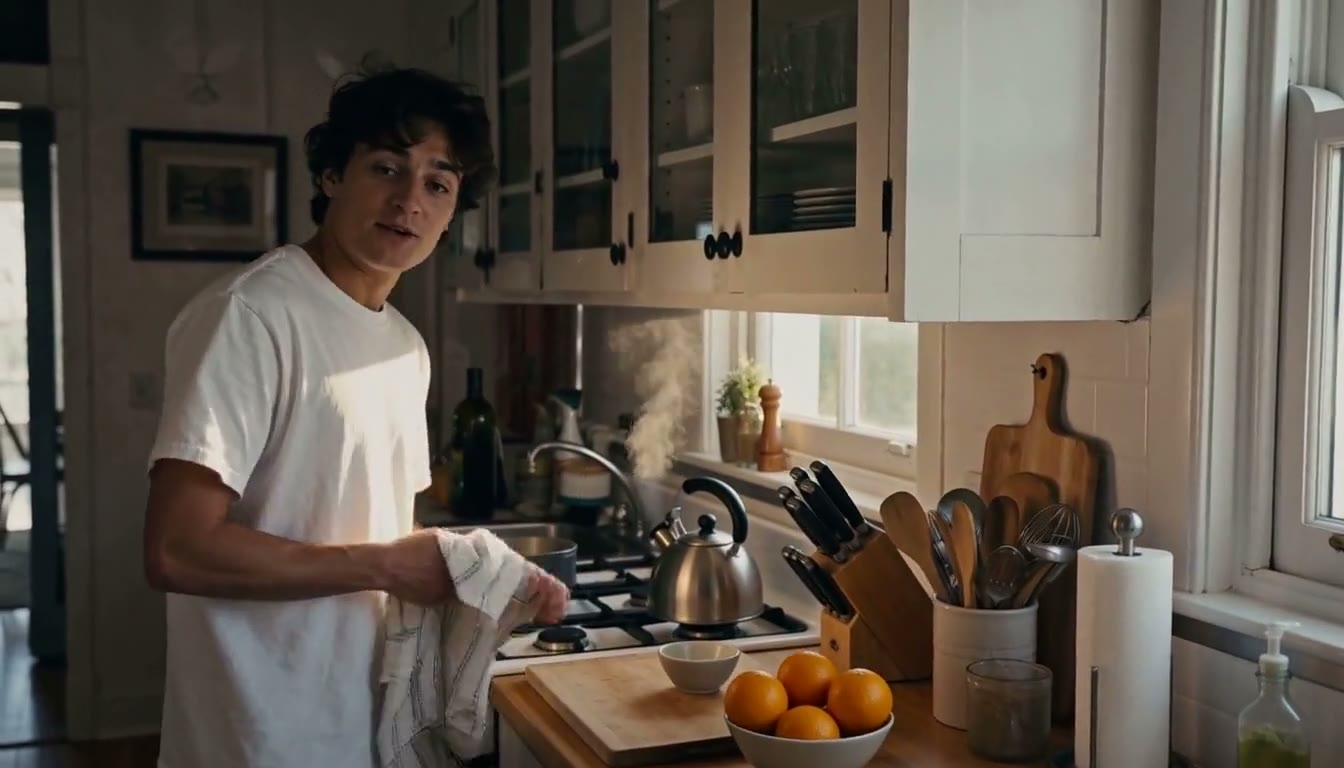 | 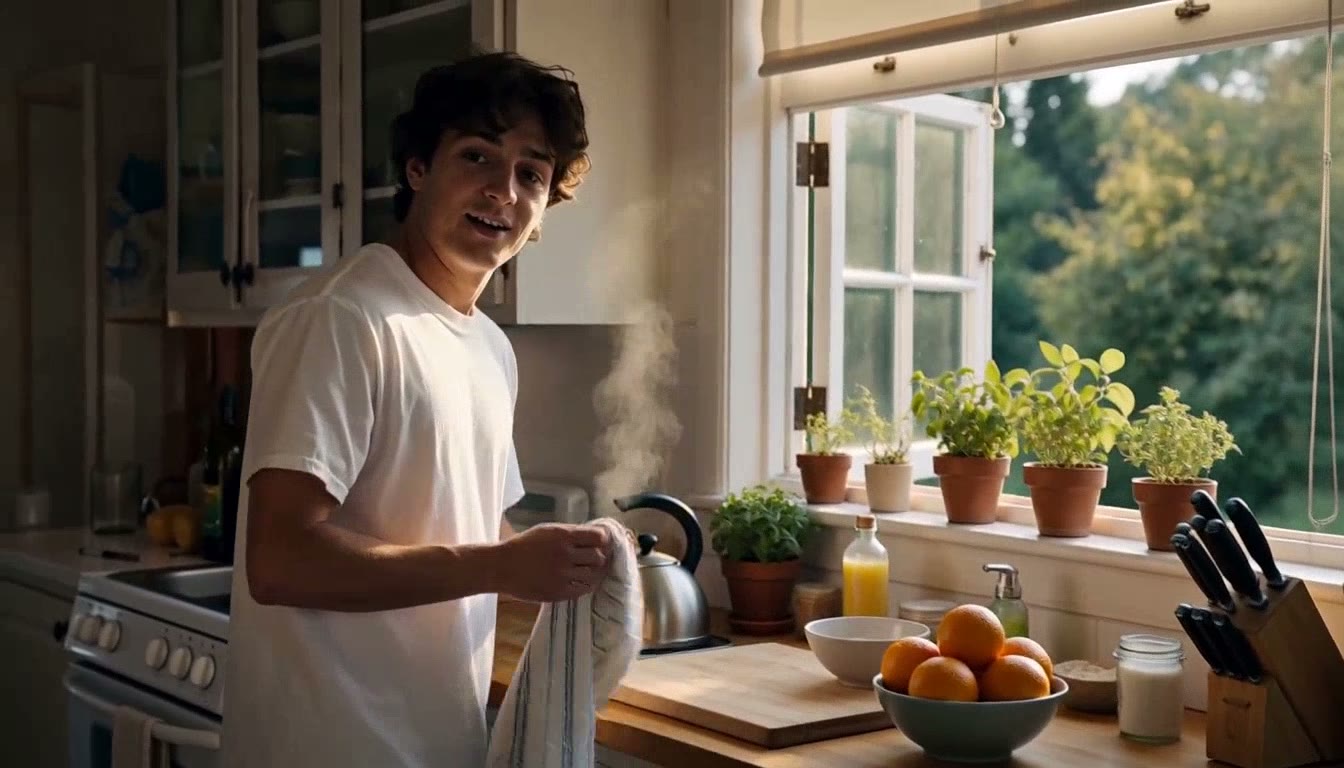 |
|---|---|
| 基础版 H3,35.44 s | FastH3 Omni,5.67 s |
1 张图像、5 秒的工作负载使用相同的提示词、引用、种子和 GPU 数量。
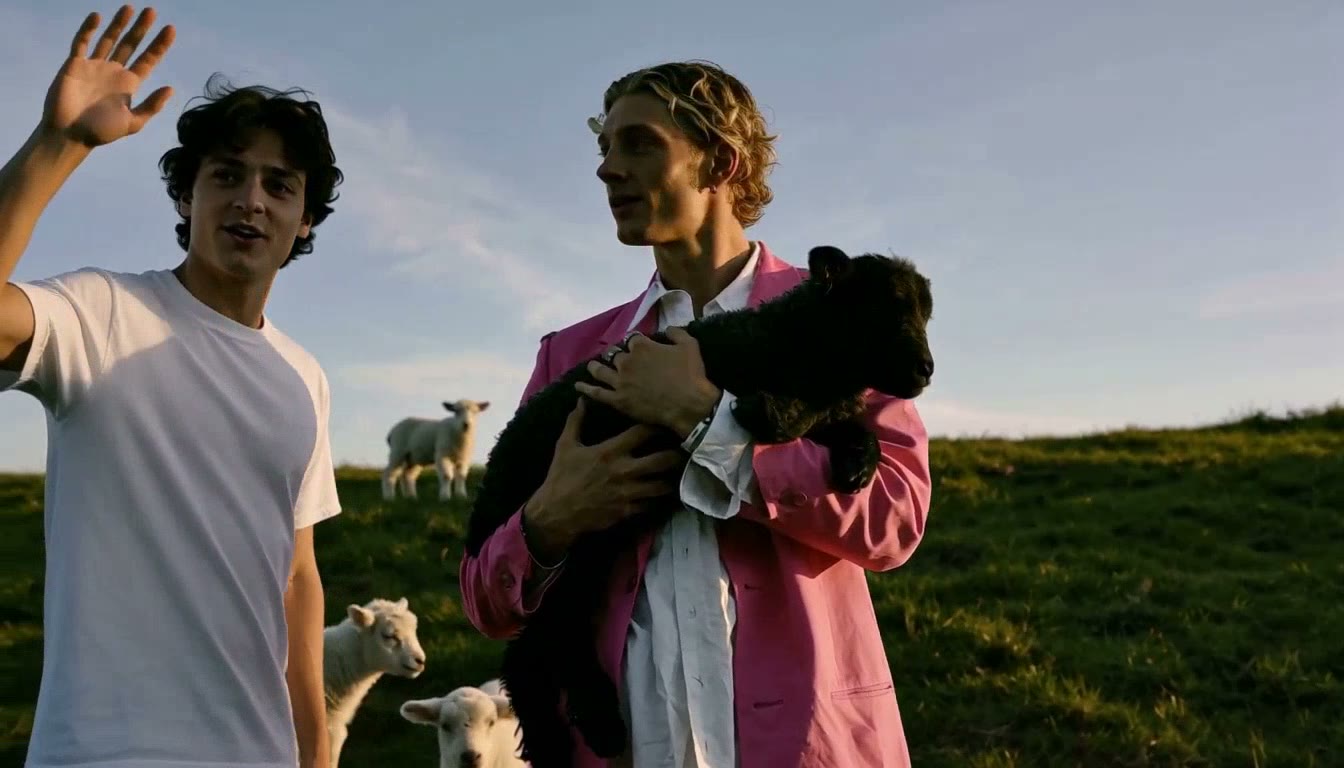
一个 10 秒请求中同时使用图像、视频和声音引用:基础版 H3 需 172.37 s,FastH3 Omni 需 19.75 s。
九个图像引用,5 秒请求。
在 ComfyUI 中运行
ComfyUI 仓库提供了单文件转换版本,因此无需自定义节点包。放置一个扩散模型、一个文本编码器、视频 VAE 和音频 VAE:
| 文件 | 大小 | 说明 |
|---|---|---|
fasth3_omniref_8step_pruned_bf16.safetensors | 44.2 GB | 引用质量 |
fasth3_omniref_8step_pruned_int8_convrot.safetensors | 22.2 GB | 与官方模板默认值一致 |
fasth3_omniref_fp8_comfy.safetensors | 23.1 GB | 独立 FP8 仓库 |
qwen3vl_32b_minimax_h3_int8_convrot.safetensors | 27.1 GB | 文本编码器,BF16 为 51.5 GB,NVFP4 AWQ 为 15.7 GB |
minimax_h3_video_vae_int8_convrot.safetensors | 2.8 GB | BF16 视频 VAE 为 5.2 GB |
minimax_h3_audio_vae_fp32.safetensors | 0.6 GB | 生成音频所必需 |
模板为 video_fasth3_ominiref_r2v,于 10 月 20 日加入 workflow_templates。它使用核心 MiniMax H3 参考转视频条件节点,输入可自动扩展,最多支持 9 张图像、3 段视频和 3 段独立音频,以及配对的视频音轨;默认以 8 步、引导 1.0、视频 MiniMaxH3SigmaShift 为 12、音频为 3,在 1344x768 分辨率和 124 帧下运行。
模型卡片指出,ComfyUI 使用自己的模型布局、采样器和运行时内核,因此结果可能与 FastVideo 和 UniServe 的输出不同。
本地与服务器配置
- 服务器: 在 GB200、B200、RTX PRO 6000 Blackwell 和 Hopper 上通过 UniServe 运行 BF16 checkpoint,采用其参考条件配置。
- DGX Spark 和 RTX 5090: NVFP4 QAD 构建版本,专为 Blackwell 上的 NVFP4 执行而训练,并配有 FastVideo cookbook 中的设备方案。
- RTX 4090: 带逐层 offload 的 FP8 构建版本,因为 Ada 架构没有 FP4 硬件。
- 解码器: 可选的 NVFP4 VAE 解码器,提供 36 层质量档和 8 层快速档。
ComfyUI 还获得了独立的 FP8 转换版本(23.1 GB)和 NVFP4 QAD 转换版本(13.8 GB)仓库。团队表示将在 10 月 21 日发布本地 AI 相关的文章和版本。
在 FastH3 系列中
基础版 H3 生成带音频的视频需要 50 个 transformer 步骤,在单块 GPU 上每段视频需要数分钟。FastH3 V2 将其蒸馏到 8 步,Trim 从 50 个块中移除 8 个以适配 8 GB 显卡,而 Omni 则增加了引用路径:在提示词之上加入图像、视频片段和声音,且保持相同的 8 步预算。FastH3 Omni 与 Nuva Lab 和 Reactor 作为预览发布合作伙伴共同进行了后训练,发布说明中致谢了 NVIDIA FastGen 团队。
评论
使用 GitHub 登录后即可参与讨论。