MiniMax H3 角色替换 v1.1:80 MB LoRA,相似度更佳
Alissonerdx 发布 MiniMax H3 角色替换 v1.1,这是一个 80 MB 的动态秩 SVD 提取版本,相似度更贴近参考图,并附带两个 ComfyUI 工作流,其中一个仅使用原生节点。
这个仓库与早前报道 H3 角色替换与动态壁纸 LoRA 的是同一个,那篇文章在 10 月初介绍了 v1.0;截至撰写时,该仓库约有 458 个赞和 144,700 次下载。包中的每个适配器都基于 H3 的 ref2va 权重训练,并采用相同的条件思路:来源片段通过 MiniMaxH3AddGuide 以对齐的引导网格(guide lattice)形式注入,而不是作为松散的视频引用。
v1.1 并未改变任务本身。它仍然是使用 body_swap: 触发词的引导驱动式身体替换,整个版本只针对 v1.0 的一个抱怨:替换后的角色看起来不够像参考图。
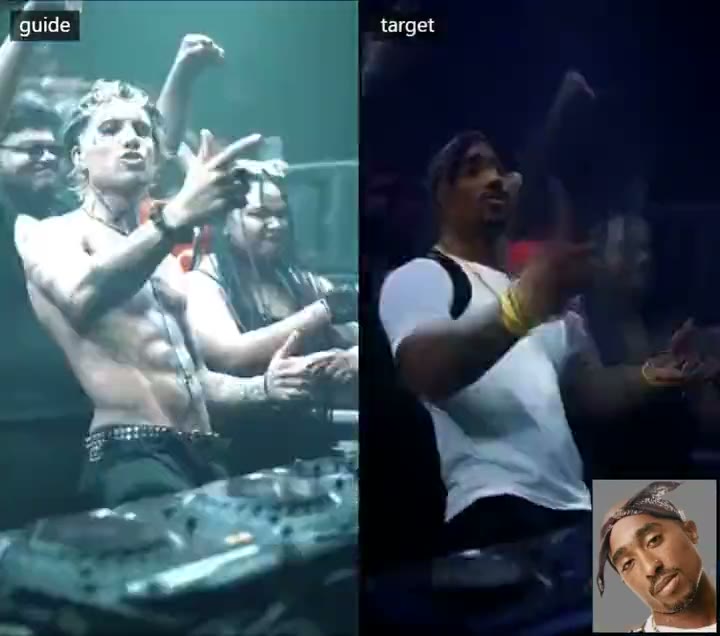
作者 v1.1 测试中引导视频与目标视频对比片段的一帧。
v1.1 有哪些变化
作者并没有为此版本重新训练新适配器。v1.1 是对 v1.1 训练运行的 80 MB SVD 提取,通过 Frobenius 范数能量分析为每一层单独选择动态秩:208 个层各自保留能承载自身 95% 能量的最小秩,结果落在 4 到 34 之间,中位数为 7。这让文件比 v1.0 的 rank-64 checkpoint 小约八倍,同时在相似度上得分更高,因此参考图能更紧密地作用于面部、头发、身体和服装,而引导视频仍然提供场景、相机和表演。
| Checkpoint | 大小 | 说明 |
|---|---|---|
minimax_h3_character_swap_v1.1_ref2va_fro | 80 MB | 逐层动态秩(4 到 34,中位数 7),推荐版本 |
minimax_h3_character_swap_v1.0_ref2va_r64_gl | 620 MB | Rank 64,上一个版本,保留用于并排对比 |
指南要求强度为 1.0,这也是作者公开的发布准则:在 1.0 下无法正常工作的 LoRA 不会发布。
作者在版本仍在进行中时发布了其中三段秩对比。第一段使用能量分析提取的秩,第二段混合了为 v1.1 提供训练的两个阶段,第三段是完整的引导视频与目标视频对比。
基于 Frobenius 能量的秩提取,即 v1.1 最终采用的方案。
混合秩测试,结合了 v1.1 背后的两个训练阶段。
引导视频与替换输出的并排对比片段。
两个 v1.1 工作流
v1.1 附带一对全新的流程图,二者之间的选择主要取决于片段长度。
| 工作流 | 使用内容 |
|---|---|
| Shot Planner | ComfyUI-BFSNodes 1.113.0 或更新版本。长视频被切分为多个镜头,每个镜头单独渲染再拼接,参考对象和 {details} 在规划器中描述,流程图会构建并排对比。 |
| 仅原生节点 | Generate Text 查看参考图并写出完整提示词,然后由 MiniMax H3 Reference to Video 和 Add Guide 渲染一个片段。无需社区节点包。 |
两者都以 8 步配合 DMD turbo LoRA 运行,并且都提供可选的第二遍处理,加入 LMS 锐化 LoRA 和 1280×704 的 latent 放大器。每个工作流都带有一条注释,列出它所加载的每个模型的下载链接;模型加载器保留保存时的文件夹名称,因此如果你的文件放在其他位置,就需要重新选择每个加载器。
提示词模板
角色描述是决定参考信息能保留多少的关键部分。指南现在附带一个固定模板:在一行内使用它,只将 {details} 替换为以逗号分隔的参考角色描述,并以性别开头。
body_swap: subject_definitions: <Subject 1> is the {details} shown in <Picture 1>, whose identity, face, head, hair or fur, skin, body shape, proportions and clothing define the character in the target video. The guide video provides the scene and the performance: its background, environment, lighting, camera, framing, body pose, hand and arm movement, head rotation, gaze direction, lip movement and facial expression, frame by frame; only the main subject of the guide video is replaced: its face, hair, body and clothing become <Subject 1>. summary: [video generation + reference] Replace the guide subject with <Subject 1>, keeping the scene, camera and the complete motion and performance of the guide video. detailed_description: [Shot 1] <Subject 1> takes the exact place of the guide subject and moves with the same timing, body pose, gestures, head motion, gaze, speech and facial expressions, while keeping the complete identity from <Picture 1>: facial structure, hair or fur, skin, body shape and clothing stay stable in every frame. The background, lighting, colors and camera of the guide video are preserved. Prevent identity drift, clothing changes, texture crawling and flicker.{details} 应当从头到脚地撰写:性别、身高与体型、脸型和肤色、头发、上下装及其颜色与材质、鞋履、配饰,以及纹身、疤痕或皱纹等显著特征。指南禁止在该位置描述背景、相机或光照。
有两种方式可以自动填充它。在 Shot Planner 中,{details} 保留在提示词里,由面板的 Describe refs 操作写出每个参考对象的描述,或者在工作流运行时由语言模型写出。在原生工作流中,Generate Text 接收参考图和一条返回完整提示词的指令,指南建议将 max_length 设为约 768,以免提示词末尾被截断。
获取方式
将 LoRA 放入 ComfyUI/models/loras/,载入其中一个 v1.1 工作流,并查看流程图内的注释了解它所需的模型。公开的设置会加载 H3 ref2va 扩散模型(作者示例中使用的是剪枝版 int8_convrot 构建)、H3 文本编码器、视频与音频 VAE,以及一个 8 步 DMD turbo LoRA。可选的 qwen3.5_9b_w4a8_gptq 视觉语言模型仅用于描述参考对象。
输入顺序很重要。把原始片段送入 MiniMaxH3AddGuide,并将 frame_idx = 0,因为 LoRA 是在引导 latent 上训练的;然后通过 H3 原生的图像引用路径把角色图像作为 <Picture 1> 送入。保持输出宽高比和帧数与引导视频一致,H3 的帧数取 17n + 5(5、22、39、56、73、90、107、124 等),并在运行长片段前先用一段较短的区间做测试。
评论
使用 GitHub 登录后即可参与讨论。