RTX 30 系列 BF16 解锁:ComfyUI 最高提速 60%
一款开源 Linux 内核模块恢复了 RTX 30 显卡的 FP/BF16 指令发射速率。在一张 3090 Ti 上,ComfyUI 的 BF16 工作流运行速度提升 31% 到 60%,而 INT8 保持不变。
这个卡片家族多年来一直带着一道软件限制:消费级 GA102、GA103、GA104 与 GA106 芯片把 FP/BF16 融合乘加发射到 FP32 的速率只有同款硅片的专业级兄弟型号的一半。gpu-unlock 在 nvidia 加载之前写入速度选择器来抬高这一上限,因此上层其余部分无需修改即可运行。
模块改变了什么
该项目结合了更早的两种做法:CMP 解锁器的 V67/PLM 技术,以及 UEFI 方法的驱动前时机。具体来说,在 NVIDIA 驱动绑定卡片之前,模块写入速度选择器 SS0 0x88888888(选择完整的 BF16 速率)与用于 IMLA4 的 4 位 SS1 0x8,然后执行 FLR 并退出。它既不是 UEFI 应用,也不是打过补丁的驱动,这正是其作者强调的特性:NVIDIA 每次发布新驱动版本时都无需重做补丁。
README 直白地说明了效果:它使这四个芯片家族把 FP/BF16 FMA 发射到 FP32 的指令发射速率翻倍。除非内核命令行通过 gpu_unlock.targets= 显式启用(可以是 all,也可以是一串 PCI 地址),否则模块不做任何事;无论有多少张卡片,它们都会在约一秒内并发解锁。
数据是什么样的
项目自身的引用测量是在 450 W 的 RTX 3090 Ti 上运行稠密 8192³ GEMM,取五次采样的中位数,使用 FP32 累加:
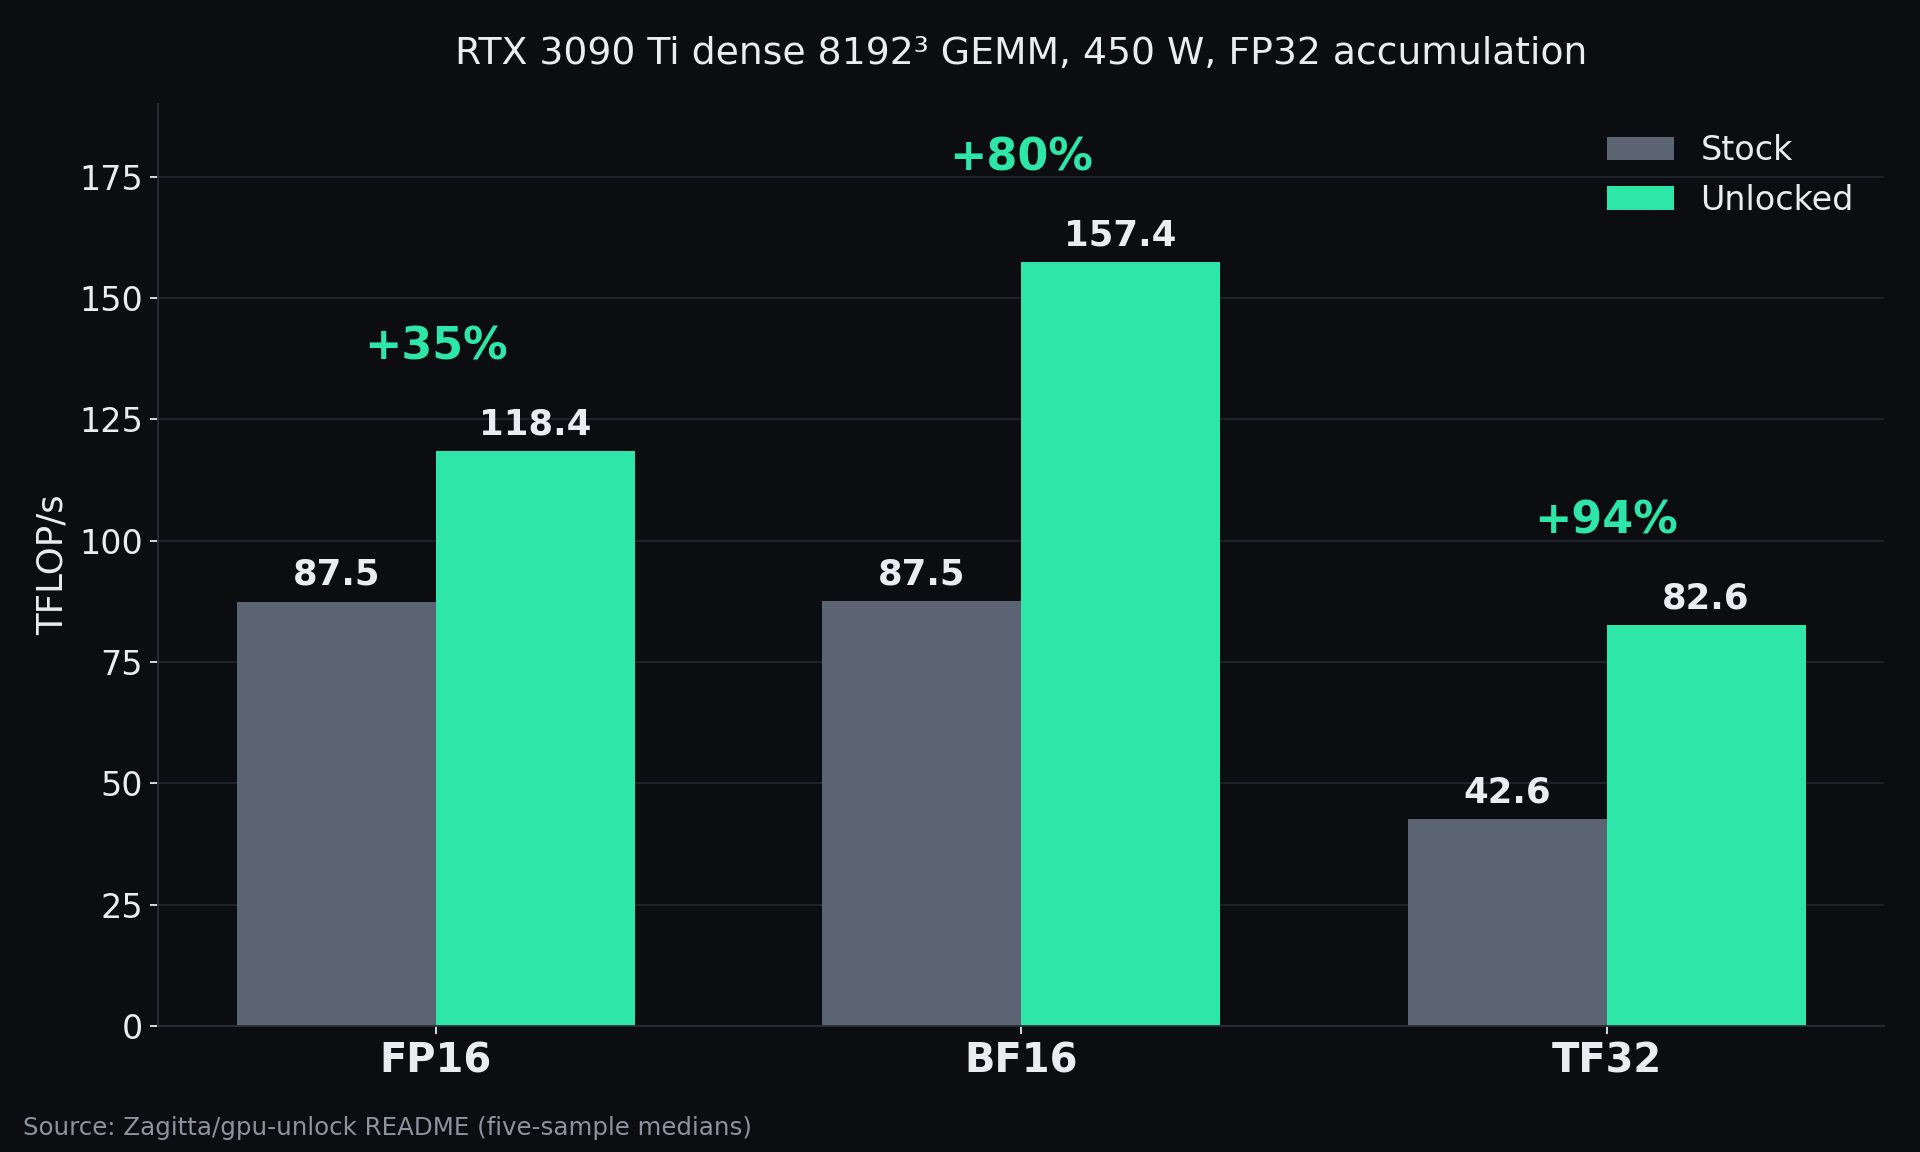
BF16 从 87.5 TFLOP/s 提升到 157.4 TFLOP/s,TF32 从 42.6 提升到 82.6,接近翻倍,而 FP16 涨幅较小,从 87.5 到 118.4。README 只把这一变化描述为把 FP/BF16 FMA 发射到 FP32 的发射速率翻倍,并未按数据类型细分,因此公开的表格是这一细分唯一的测量来源。
仓库 README 中收集的用户兼容性反馈覆盖了其余情况:
| 卡片 | 结果 | BF16 GEMM 提升 |
|---|---|---|
| RTX 3090 Ti | 已解锁 | +68–80% |
| RTX 3090 | 已解锁 | +25–67% |
| RTX 3080 10 GB | 已解锁 | +70–73% |
| RTX 3080 20 GB | 已解锁 | +56–59% |
| RTX 3070 | 已解锁 | +73–81% |
| RTX 3060 12 GB | 已解锁 | 约 +80% |
| RTX 3080 Ti 20 GB(OEM) | 解锁完成,BF16 仍为半速 | 无 |
| RTX 3070 Ti | 未用此模块测试 | 无 |
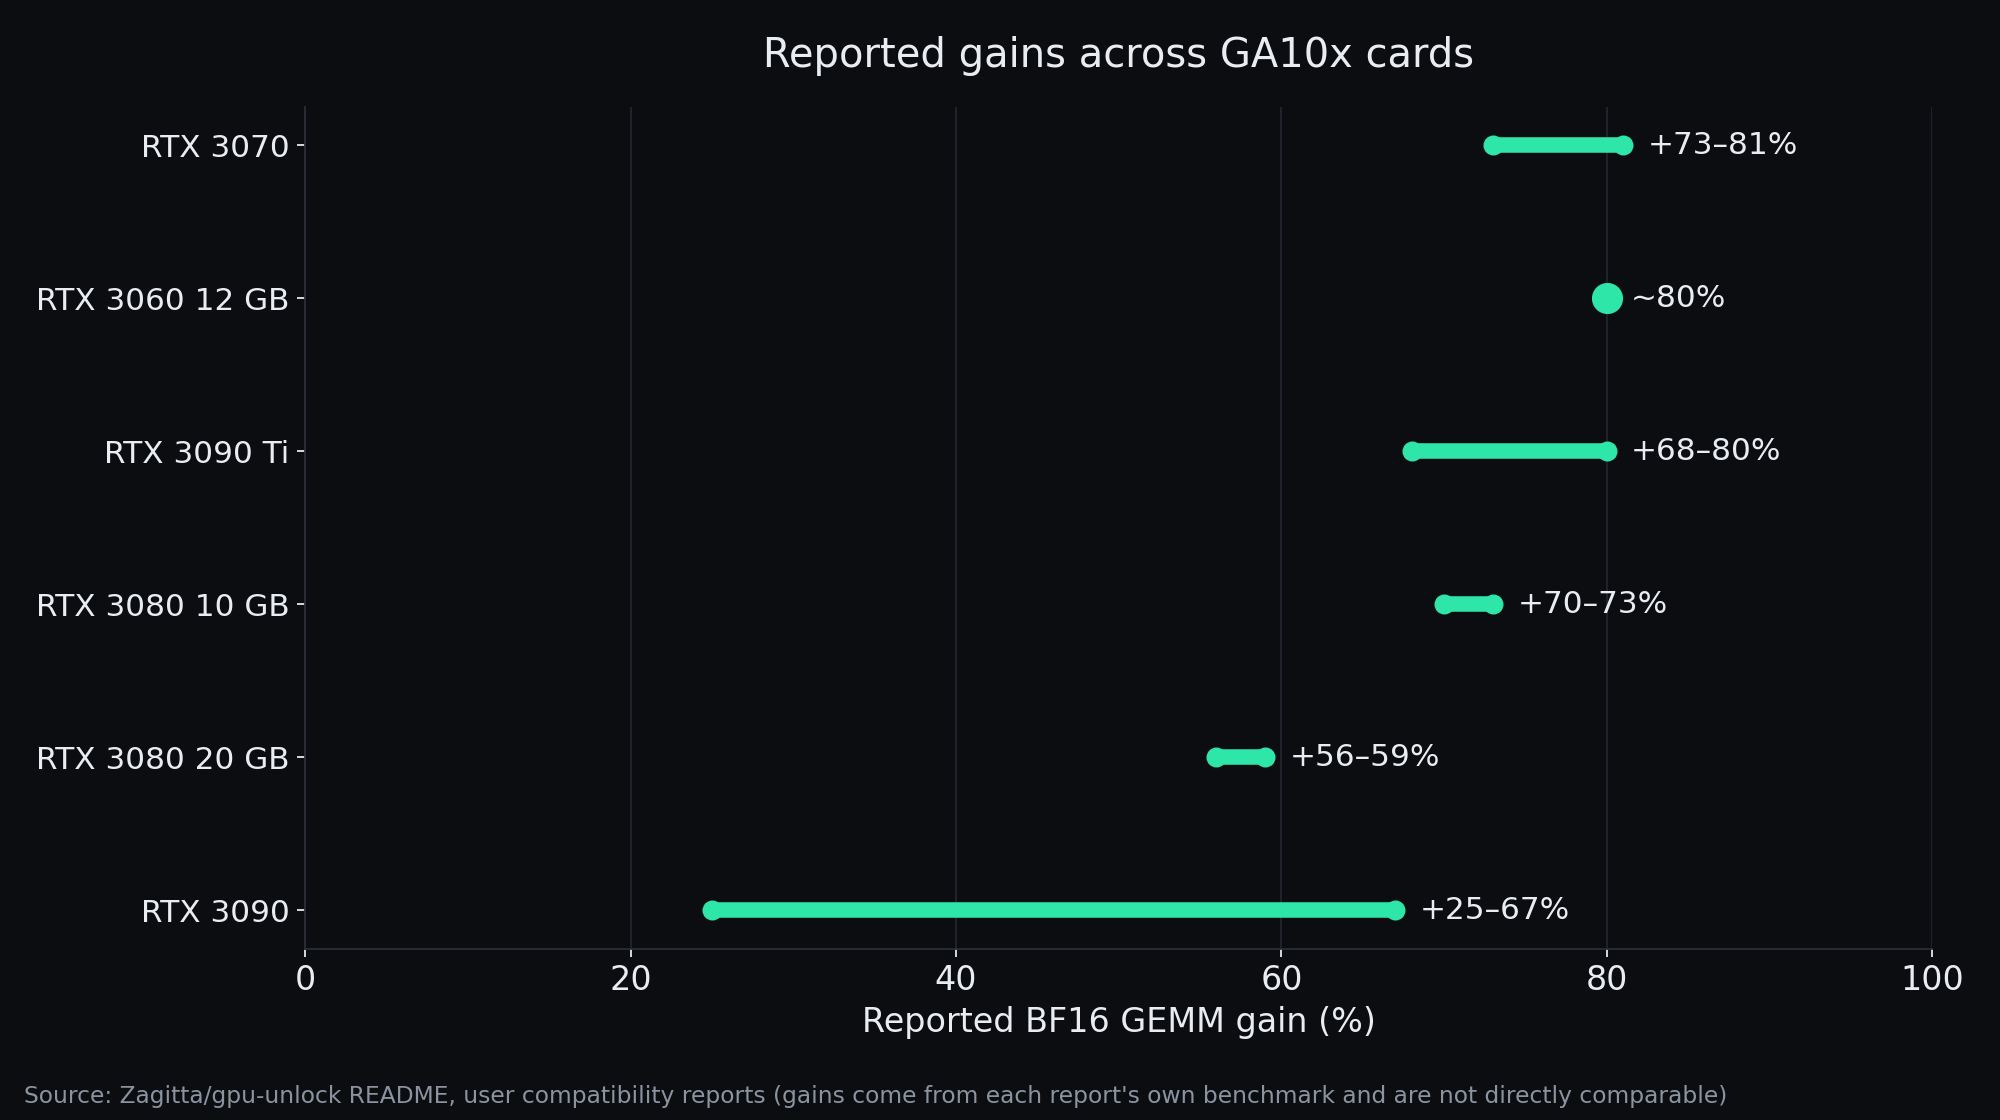
README 明确指出,这些数字来自各份反馈自带的基准测试,不能直接比较。功耗上限是主要的干扰因素:最低的数字是 3090 上的 +25%,来自一张被限制在 225 W 的卡片。
在 ComfyUI 中的实测
对本站而言,有用的测试不是 GEMM 而是生成。一位独立的 RTX 3090 Ti 所有者 u/under-_-null 在原始驱动和解锁后的驱动上运行了相同的工作流,并公布了每张图像或每个片段的耗时中位数:BF16 流水线最高快 60%,INT8 则几乎不变。
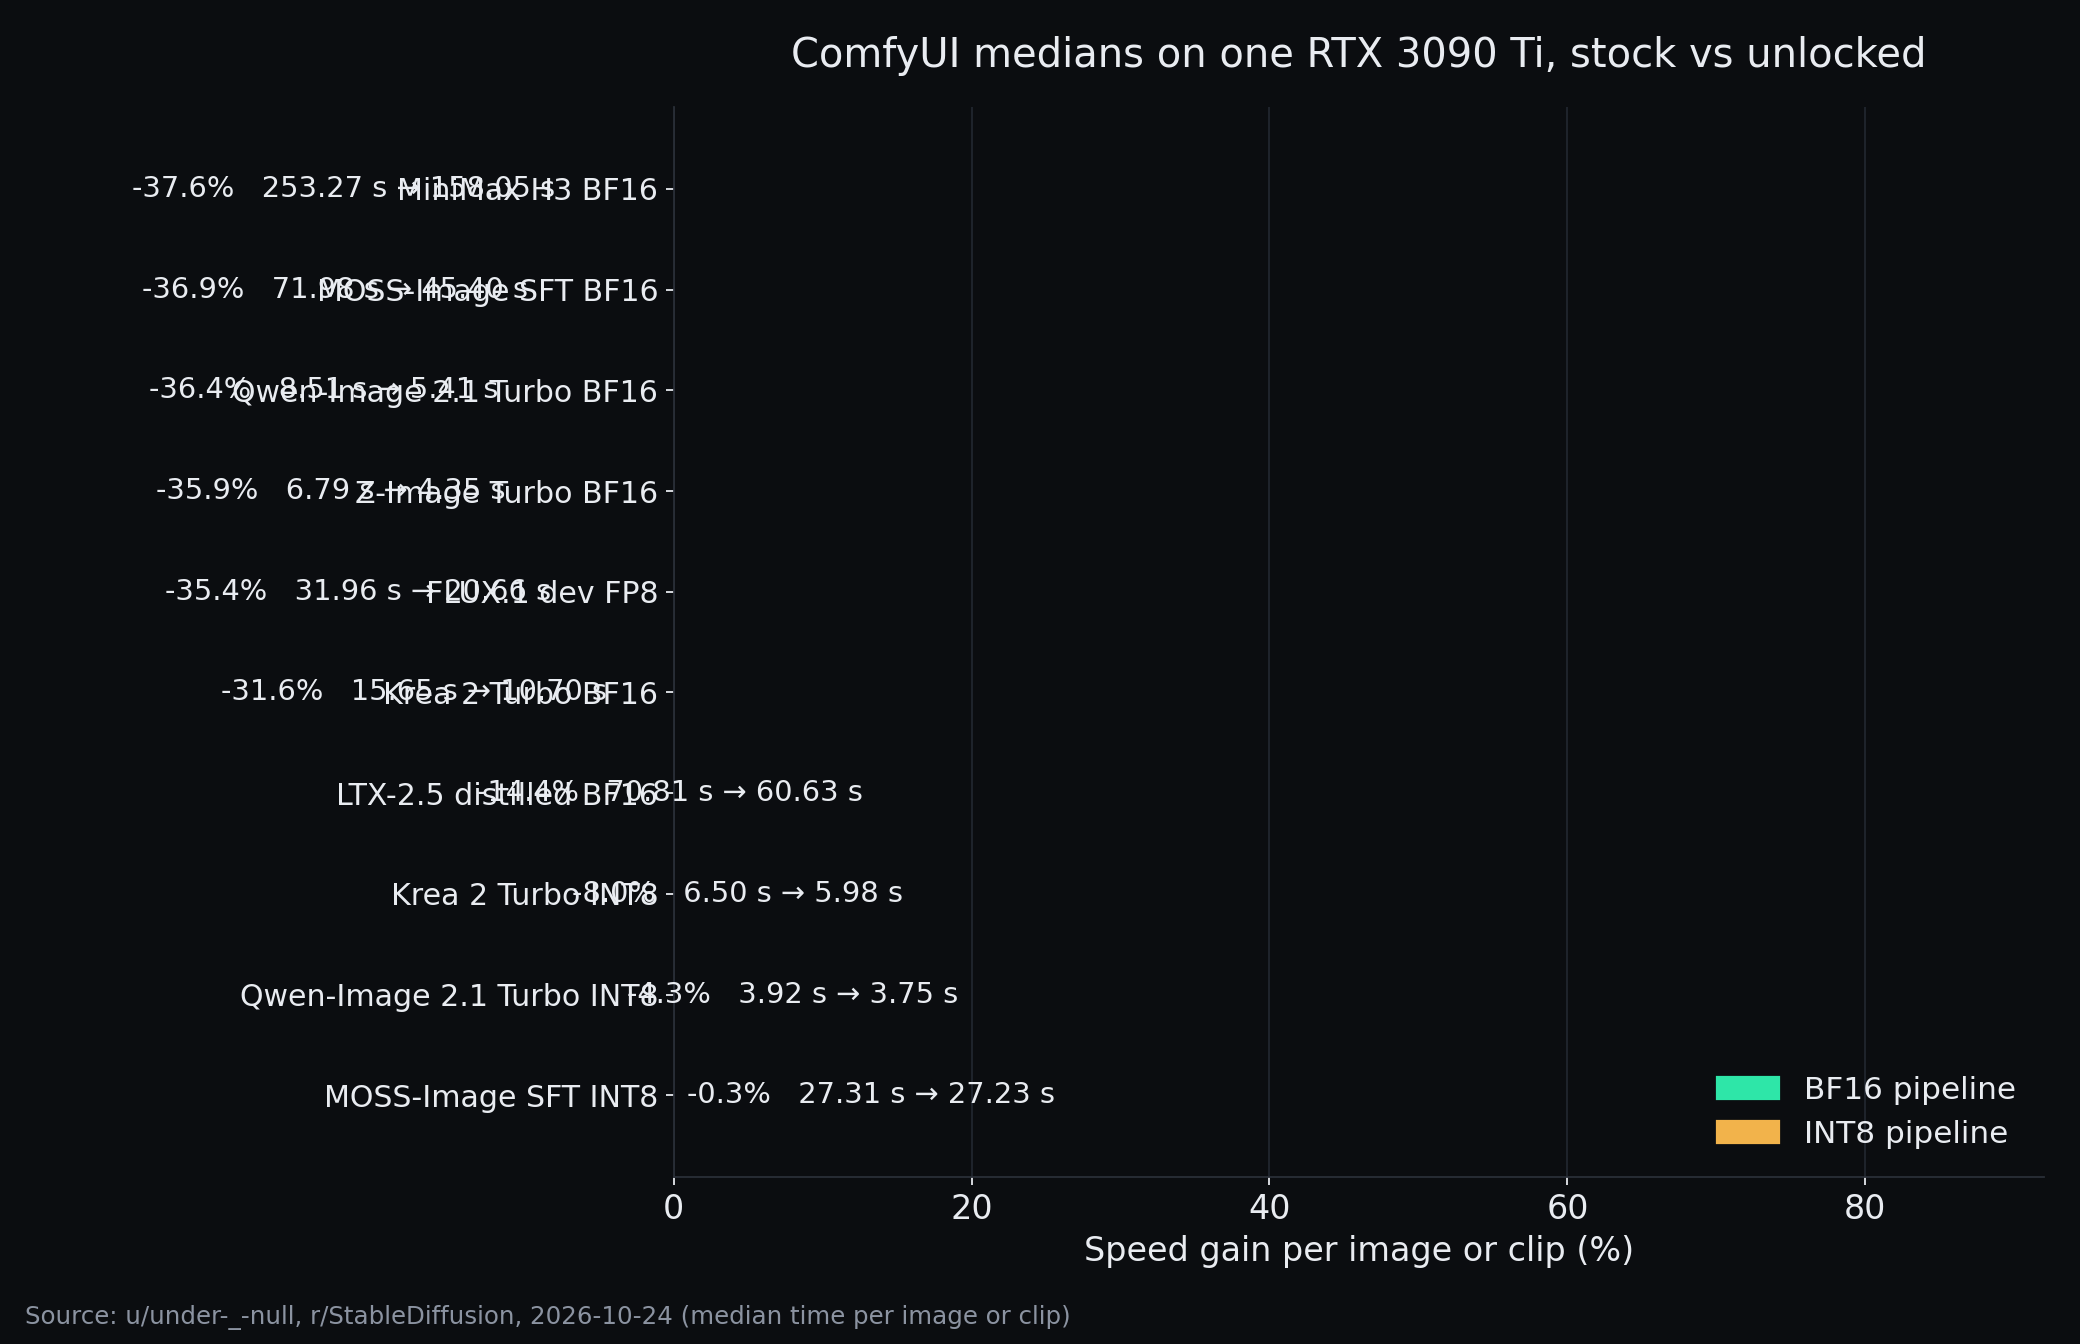
| 模型与精度 | 原始 | 解锁后 | 提升 |
|---|---|---|---|
| MOSS-Image SFT BF16 | 71.98 秒 | 45.40 秒 | +58.6% |
| Qwen-Image 2.1 Turbo BF16 | 8.51 秒 | 5.41 秒 | +57.2% |
| Z-Image Turbo BF16 | 6.79 秒 | 4.35 秒 | +56.1% |
| FLUX.1 dev FP8 checkpoint | 31.96 秒 | 20.66 秒 | +54.6% |
| Krea 2 Turbo BF16 | 15.65 秒 | 10.70 秒 | +46.3% |
| MiniMax H3 BF16(视频与音频) | 253.27 秒 | 158.05 秒 | +60.2% |
| LTX-2.5 distilled BF16(视频与音频) | 70.81 秒 | 60.63 秒 | +16.8% |
| MOSS-Image SFT INT8 | 27.31 秒 | 27.23 秒 | +0.3% |
| Qwen-Image 2.1 Turbo INT8 | 3.92 秒 | 3.75 秒 | +4.6% |
| MiniMax H3 INT8 ConvRot | 155.07 秒 | 118.21 秒 | +31.2% |
有两点值得注意。提升集中在 BF16 工作中,这正是发射速率起作用的地方;INT8 量化路径几乎不受影响,因此已经在跑 INT8 ConvRot 模型的用户只能得到几个百分点,而不是 60。INT8 ConvRot 下的 MiniMax H3 是例外,达到 31%,远高于同一份反馈中的其他 INT8 条目。
输出保真度得以维持:同一份反馈比对了 150 次解锁与原始状态的静图运行,解码后的 RGB 像素完全一致。仓库中的其他兼容性反馈也这样说,这与发射速率变化而非精度变化的性质相符。
依赖项与风险
尝试前需要注意的详情,均来自项目文档:
- 仅支持 Linux。 模块针对已安装的内核头文件构建,并通过 mkinitcpio、initramfs-tools 或 dracut 安装,提供 Arch、Debian 与 Fedora 的打包目标。
- 按卡片启用。
gpu_unlock.targets=all会解锁所有尚未绑定的 GA10x 卡片;否则按lspci -D打印的格式列出 PCI 地址。已被驱动初始化的卡片会被拒绝。 - 需要冷启动。 开机后手动加载模块对已经由
nvidia绑定的卡片没有任何作用。 - 挂起处理。 速度选择器在断电后会复位,因此除非用
gpu_unlock.resume=0禁用,模块会通过挂起通知器在恢复时重新解锁。休眠不在覆盖范围内。 - 显示卡也能用,从复位开始到
nvidia-drm接管之前,控制台会被清空。 - 并非所有卡片都有响应。 OEM 版 RTX 3080 Ti 20 GB 会完成解锁,但 BF16 仍保持半速,且目前还没有 GA103 的反馈。
另一个社区项目 impacifist/Windows-GPU-UNLOCK 将该技术移植到面向 Windows 用户的 UEFI 路径。它不属于原始项目,本文也未对其进行测试。
获取方式
- 模块: Zagitta/gpu-unlock,仓库中的版本为 1.0.0,包含兼容性表格与固件提取代码。
- 基准测试讨论帖: RTX 30 系列解锁讨论 与 RTX 3090 Ti ComfyUI 反馈。
- Windows 移植版: impacifist/Windows-GPU-UNLOCK。
评论
使用 GitHub 登录后即可参与讨论。