Fizgig LoRA 隔离:防止单张人脸扩散到所有人
Fizgig v8.4.0 新增 LoRA 隔离功能,将 DOP 与融合触发词、负向配对训练结合,在 Krea 2 上把陌生人脸泄漏从 48/50 降至 0/50。
Fizgig v8.4.0 新增了 LoRA 隔离(LoRA Isolation),这是一种角色 LoRA 的训练模式,可阻止主体的人脸扩散到画面中的其他所有人(发布说明 | 技术说明 | 演示视频)。普通的人物 LoRA 会把这张脸带到背景里的陌生人、站在旁边的朋友,甚至一整群人的脸上。使用 LoRA 隔离后,多个受训主体可以同时出现在一张图中,或站在模型已经认识的人旁边,每张脸都保持各自的样子。不加触发词时,你得到的仍然是基础模型自带的人物,与训练前一样。
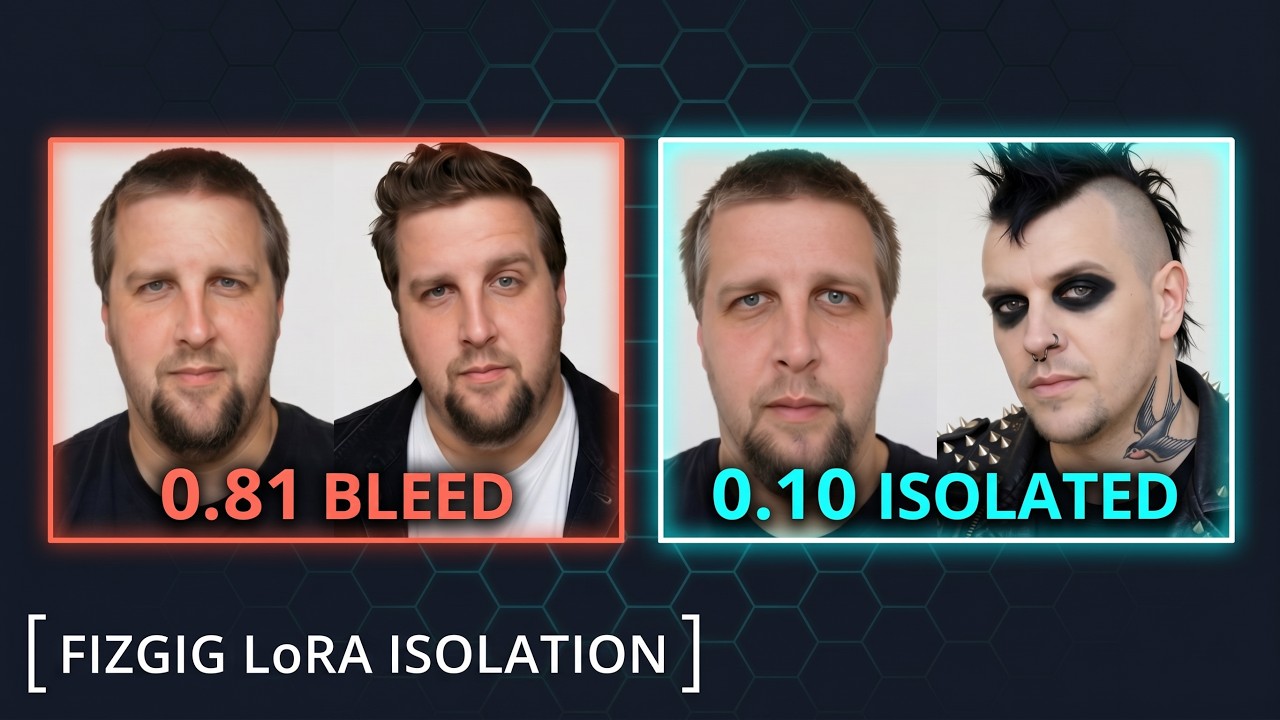
Fizgig LoRA 隔离,演示视频由 Fizgig 作者制作。来源:Fizgig v8.4.0 发布说明
结果
两个 LoRA 都在 Krea 2 上用相同的照片、设置、随机种子和 epoch 训练,唯一区别是是否启用 LoRA 隔离。两者都学习了两个人(主体,以及作为第二角色的朋友)和一种剪纸风格。随后每个 LoRA 用 25 条提示词、两个随机种子渲染,共 50 张图像。每张图都是分屏画面:一侧是一位不同的、经过细致描述的白人男性,另一侧是训练主体,同样是白人男性。这种配对刻意选用了泄漏最难处理的情况。每一半都用 ArcFace(insightface buffalo_l)与主体在 35 张训练照片上的均值人脸进行比对评分,其中同一人通常得分 0.45 以上,不相关的人在 0.0 到 0.2 之间。
| 普通 LoRA | Fizgig LoRA 隔离 | |
|---|---|---|
| 被识别为主体的陌生人 | 50 张中的 48 张 | 50 张中的 0 张 |
| 主体与自身的相似度 | 0.77 | 0.78 |
相似度并未下降:主体本人的真实照片彼此之间得分为 0.81,而这些渲染在 LoRA 还与第二个人共享的情况下达到 0.78。LoRA 中出现第二个人通常是问题所在,而在这里它却是解决方案的一部分。
工作原理
在 Subjects 卡片上选择 Fizgig LoRA Isolation 时,Fizgig 会应用六项机制。
DOP:差分输出保持
每张训练图还会在描述中移除触发词后再训练一次,在这一遍中,LoRA 被约束为与基础模型对同样加噪输入给出的自身预测一致。没有触发词时,LoRA 学会什么都不改变,因此主体不会出现在没有点名他们的提示词中。Fizgig 将 DOP 归功于 Ostris 和 AI-Toolkit,并在其基础上叠加了自己的实现。
多主体身份锚定
两个或更多身份一起训练,每个身份来自各自的文件夹、拥有各自的触发词。并排学习两张脸,能让 LoRA 明白一张脸属于某个特定触发词,而不是泛指整个类别,这也是第二个人能帮上忙而不是添乱的原因。上面的测试用一位女性作为第二主体,而所有陌生人都是男性,因此这一效果并非特定于性别。即使只训练一个人的 LoRA,也推荐同时训练第二个人。
融合词元的类别解耦
在每条描述中,触发词与其类别词会合并成一个词,因此 gwelt, a man 会按 gweltman 训练。普通的类别词元("man")是模型中其他所有男性共享的词元,也是主体特征跨越到他人身上的桥梁。把它粘到触发词上后,类别词就变成了另一个词元,主体的外观永远不会附着到共享词元上。Fizgig 在读取描述时执行拼接,磁盘上的描述文件保持不变。触发词必须能干净地拼接:fyxo 加上 woman 会被读作 f | yx | ow | oman,破坏了融合词,因此 Subjects 卡片提供了一个 Check a trigger word 按钮,用训练模型自己的 tokenizer 测试拼接效果。
单帧内的负向配对合成
每个人会得到 16 张并排图像:把他本人的一张训练照片与一个已生成的陌生人在同一个 2:1 画面中并排,主体位于哪一侧随机决定。这些图像在一张图里教会模型"这个人是主体,那个人保持陌生人",而这正是普通 LoRA 泄漏的地方。描述中先写陌生人、再写主体,因为这些模型使用的文本编码器是因果式的,触发词之后的每个词在编码时都已经"看到"了触发词。
陌生人是一组固定的 32 个已生成人物,涵盖 8 个族群,男女年龄从 20 多岁到 50 多岁。该套图的第二版在 Qwen Image 2.1 上渲染,以获得自然的皮肤质感,这样就不会把 LoRA 拉向糟糕的皮肤,也没有使用任何真实人物的照片。该套图随 Fizgig 的模型一起下载,约 21 MB。
学习率缩放与均衡采样
并排图像在自己的步骤上以双倍学习率训练,DOP 每隔一步以双倍权重运行,Balance the subjects 会重复较小的文件夹,使每个主体的训练频率与最大的主体大致相当。
类别感知的训练路径
每个主体会被识别为人物、动物或物品,或风格/外观。人物会得到融合触发词和并排图像。动物或物品只得到融合触发词。风格或外观保留原样的触发词,不生成并排图像,因为风格应当改变整个画面。
数字背后的配置
| 设置 | 值 |
|---|---|
| 模型 | Krea 2,Standard LoRA |
| 主体 | 一个人(36 张照片)、第二个人(53 张照片)、一种剪纸风格(8 张图片),均衡 |
| Rank / alpha | 16 / 16 |
| 学习率 | 自适应学习率,2e-4 至 4e-4,恒定调度器 |
| 优化器 | AdamW 8-bit,最大梯度范数 1,批处理 1 |
| EMA | 0.98 |
| 分辨率 | 0.25 MP(496 × 496),分桶,不放大 |
| 基础精度 | INT8 |
| 随机种子 | 42 |
| 检查点 | epoch 20 |
| 隔离附加项 | 每个人 16 张并排图像,2× 学习率;DOP 每隔一步,权重 2 |
在相同设置下,训练耗时约为普通 LoRA 的 1.5 倍。
目前已知情况
- 最多 4 个主体都能训练良好。一张图中两个受训人物加上一个模型已经认识的人,几乎每次都能成功;一张图中三个或更多受训人物则时好时坏。
- 同一类别的两个主体(例如两位女性)需要约 1.6 倍的 epoch,因为二者都会喂给同一个"一个女人"保持通道,而该类别被约束的强度大约是两倍。
- 提示时使用融合后的词,例如
gweltman man at a cafe,并描述画面中的其他人。LoRA 会自行把他们区分开,描述只是安全网。 - 该方法目前只在 Krea 2 上测试过。它在 Fizgig 中除 ACE-Step 外的所有模型上都能运行;在 MiniMax H3 上,主体仅根据照片训练,视频片段和语音文件不放入文件夹。
使用方法
该模式位于 Training 标签页的 Subjects 卡片上:选择主体数量,为每个主体指定一个文件夹,说明它是什么,然后把 Your subject and other people 设为 Fizgig LoRA Isolation。每个主体下方,卡片会显示它训练时使用的词、其中一条描述,以及训练将使用的并排图像,这样描述问题会在运行前而不是运行后暴露出来。
设置 Subjects 卡片:操作演示视频由 Fizgig 作者制作。来源:Fizgig v8.4.0 发布说明
描述撰写指南:MULTI_PERSON.md。同一版本还让多概念训练(2 到 4 个主体文件夹)在每种模型的 Standard LoRA 和微调上都可用,而不再仅限于 H3。
可用性
Fizgig 是一个开源 LoRA 与微调工作室,支持 Klein 9B、Krea 2、MiniMax H3、Qwen Image 2.1、Anima、Z-Image Turbo 和 ACE-Step XL(GitHub),v8.4.0 是当前版本。LoRA 隔离是训练侧的功能,因此生成的 LoRA 可以像在 Fizgig 中训练的其他任何 LoRA 一样在 ComfyUI 中加载。
评论
使用 GitHub 登录后即可参与讨论。