TaoMate-H3-FL2VA:面向 MiniMax H3 的流式首尾帧 LoRA
阿里巴巴 TaoLive AIGC 团队发布 TaoMate-H3-FL2VA,这是一款 3 步 LoRA,为流式 MiniMax H3 生成加入首尾帧控制,并附带首日可用的 ComfyUI 转换版本。
阿里巴巴的 TaoLive AIGC 团队于 10 月 15 日发布 TaoMate-H3-FL2VA,这是一款 3 步 LoRA,为 MiniMax H3 的流式 TaoMate-H3 运行时加入首尾帧控制(权重 | 代码)。团队称其为“据我们所知首个实时流式首尾帧转音视频(FL2VA)模型”:生成依然是分块进行的,也依然携带持久的音视频 KV 缓存,但片段现在不仅要从选定的首帧开始,还必须落在选定的尾帧上。
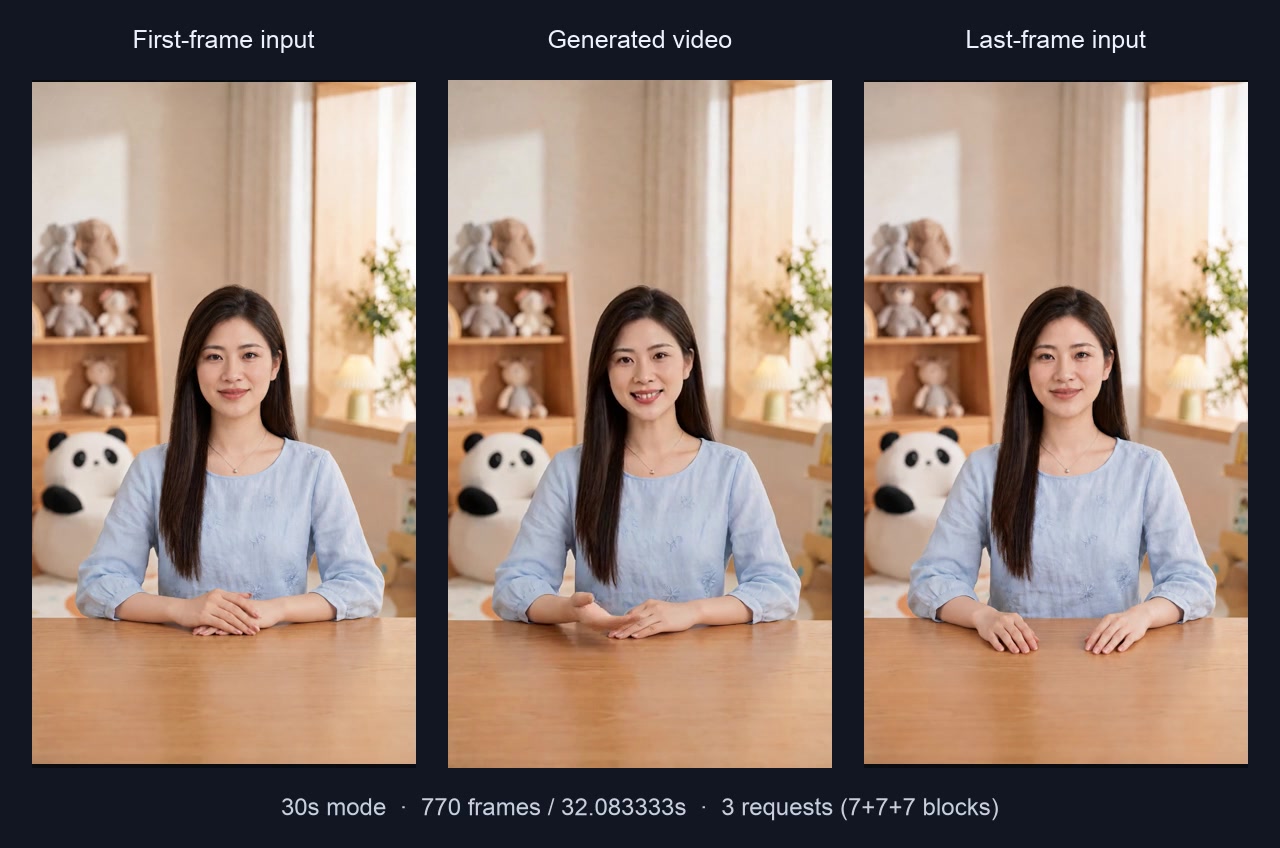
seated_001 FL2VA 示例的官方预览:一段由首帧和尾帧生成的 30 秒流式片段。
更早的 T2AV 版本仅根据提示词生成。FL2VA 为同一运行时加入了全局终点约束,因此三步去噪块必须抵达最终关键帧,同时语音、音效和视频保持在同一时间线上同步。
seated_001 的官方 30 秒对比:在三次连续流式请求中共生成 770 帧。
发布内容
- FL2VA LoRA 适配器,位于 TaoLiveAIGC/TaoMate-H3-FL2VA:rank 128、alpha 128,step-300 在线生成器权重以 float32 保存。该适配器与 T2AV 版本采用相同的三文件结构(
config.json、adapter_config.json、adapter_model.safetensors),不含优化器状态、EMA 以及仅用于训练的打分模型。T2AV 适配器则是 step-3000 生成器 EMA checkpoint。 - 独立的 FL2VA 推理子项目,位于 TaoMate-H3 仓库 的
src/taomate-fl2av,附带一个已完成示例seated_001(家庭客厅中的坐姿讲解)。
--time 模式 | 输出 | 流式请求 |
|---|---|---|
--time 30 | 770 帧 / 32.08 秒 | 3 次连续请求,每次 7 个块 |
--time 10 | 260 帧 / 10.83 秒 | 1 次请求,6 个块 |
--time 5 | 124 帧 / 5.17 秒 | 1 次请求 |
三种模式均以 24 fps 和 768x1376 运行,采用三步去噪、最近七个干净 AV-KV 窗口以及一次性整段解码。文档记录的 30 秒运行使用 step-300 在线生成器 LoRA、85 帧的最终块,以及用于音频的冻结 Base10 teacher。
该示例自带两张关键帧,因此条件输入是实测运行的一部分,而不仅仅记录在 README 中:
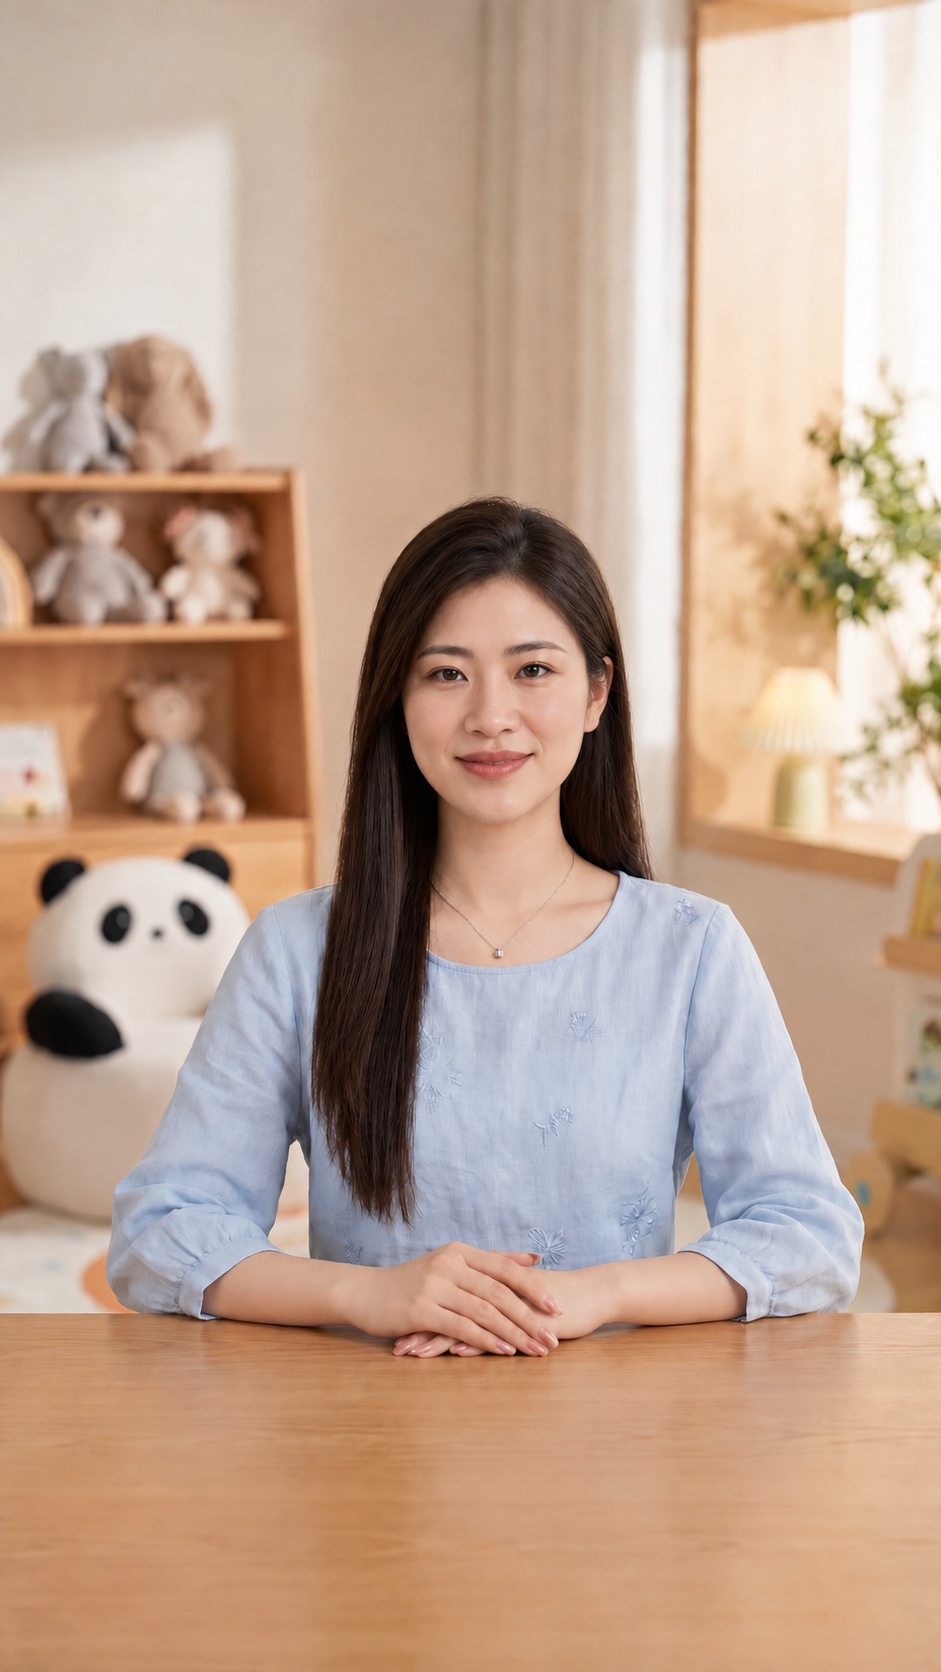 | 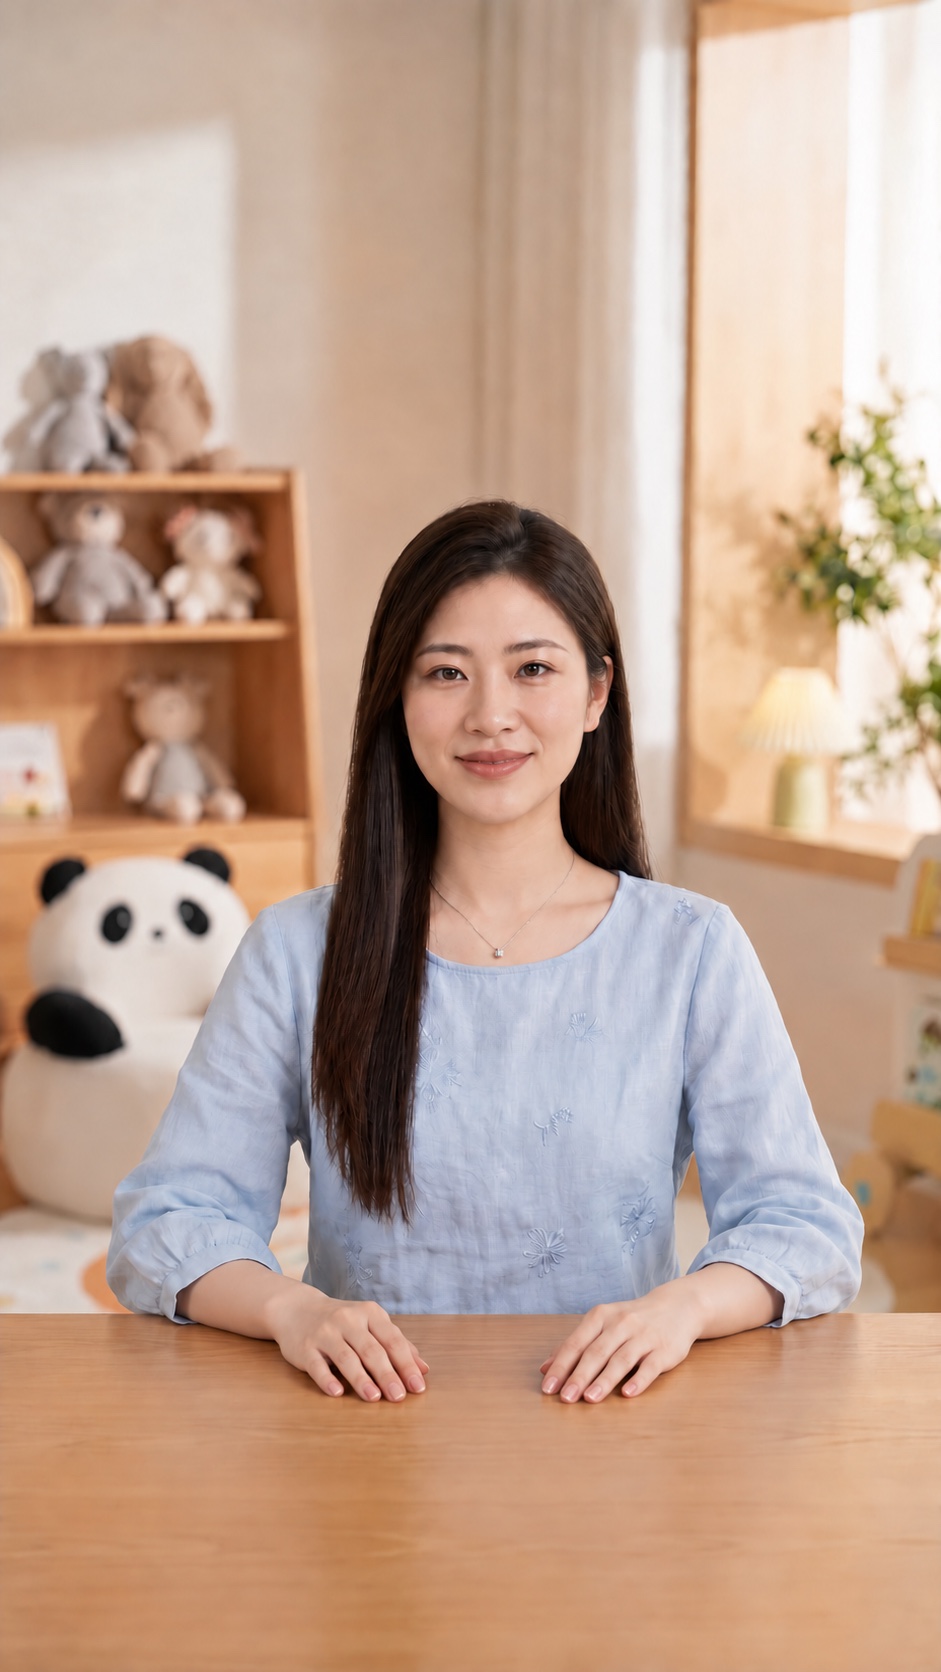 |
|---|---|
| 首帧 | 尾帧 |
在 ComfyUI 中运行
FL2VA 路径已经存在于 ComfyUI 核心中。MiniMax H3 图像转视频节点除提示词、宽度、高度和帧长度外,还接受可选的 first_frame 和 last_frame 输入,并返回正向条件以及音视频 Latent;它同时处理 t2va 和 fl2va 条件。使用该适配器进行本地生成,无需流式运行时、阶段并行启动器或多 GPU 配置。适配器本身必须采用 ComfyUI 的键名布局,社区转换版本在发布后数小时内就已出现:
- Kijai 的
MiniMax-H3-experimental仓库包含minimax_h3_taomate_fl2va_3step_avg_rank_19_bf16.safetensors(约 176 MB),这是一个 rank 平均版本,与其他 MiniMax H3 实验性 LoRA 放在一起。 - austinit/TaoMate-H3-FL2VA-ComfyUI 同时发布了完整的 rank-128 BF16 版本(1.24 GB)和平均 rank-19 的 BF16 版本(169 MB)。上传者建议从 3 步、CFG 1.0、LoRA 强度 1.0 和 Euler 采样器开始,并反馈较小的版本在测试中运行正常。
- Robert1212star/TaoMate-H3-3Step-ComfyUI,即此前托管 T2AV 转换版本的仓库,在同一天加入了 BF16 格式的 FL2VA 权重(约 1.24 GB)。
社区反馈
r/StableDiffusion 上的讨论把 TaoMate 3 步系列当作日常的 MiniMax H3 加速器:一位评论者称它是“99% 生成”场景的首选 LoRA,另一位在把 LoRA 强度降到 0.6 并改用带 er_sde 的 Beta 采样器后,反馈动作更自然。也有人在使用它作为 refiner pass 时更偏好更早的 T2AV 适配器。快速大幅动作仍是该系列已知的弱点:评论者反馈舞蹈和剧烈动作镜头会退化,这也与 T2AV 的相关文章一致。一位测试者指出,FL2VA 适配器卡片上标注 optimizer_step: 300,而 T2AV 版本为 step 3000,因此新适配器是一次更短的训练,而不是更长。
可用性
官方运行时仅支持 Linux,面向 NVIDIA Hopper(SM90)GPU;仓库文档将 FL2VA 示例描述为在八块 GPU 上使用 TP2 和 SP4 序列并行的单节点运行,并支持 4 块和 8 块 GPU 配置的单节点推理。ComfyUI 用户只需要 MiniMax H3 基础模型加上上述任一 LoRA 转换版本。同系列的引用转音视频(Ref2AV)权重仍列为待定。
评论
使用 GitHub 登录后即可参与讨论。