SolarRenderer:在 MiniMax H3 上实现四步结构渲染
SolarRenderer 新增两个 MiniMax H3 LoRA,可在四步内将灰色方块、语义图或 SMPL 网格转换为视频,并提供 ComfyUI 节点和三个工作流。
SolarRenderer 能将结构视频转化为 MiniMax H3 上的成品影像:无论是来自游戏引擎的灰盒、语义分割图、一组骨架、深度图、SMPL 人体网格,还是模型在训练中从未见过的草图。两项秩为 384 的 LoRA 承担了这项工作:一个控制 LoRA 将结构输入 H3 自带的引用通路,另一个四步 LoRA 则在四次采样步骤内完成视频片段的渲染。
该项目由 Guian Fang、Shengju Qian、Dongyue Lu、Junchao Huang、Lutao Jiang、Xin Wang、Yiren Song、Li Jiang 与 Mike Zheng Shou 共同完成,参与机构包括 NUS、LIGHTSPEED、香港中文大学(深圳)、SLAI 与香港科技大学(广州)。权重已于 2026 年 10 月 13 日发布至 Hugging Face,包含训练数据与基准测试的代码仓库于 10 月 15 日跟进发布,论文编号为 arXiv 2610.28630。
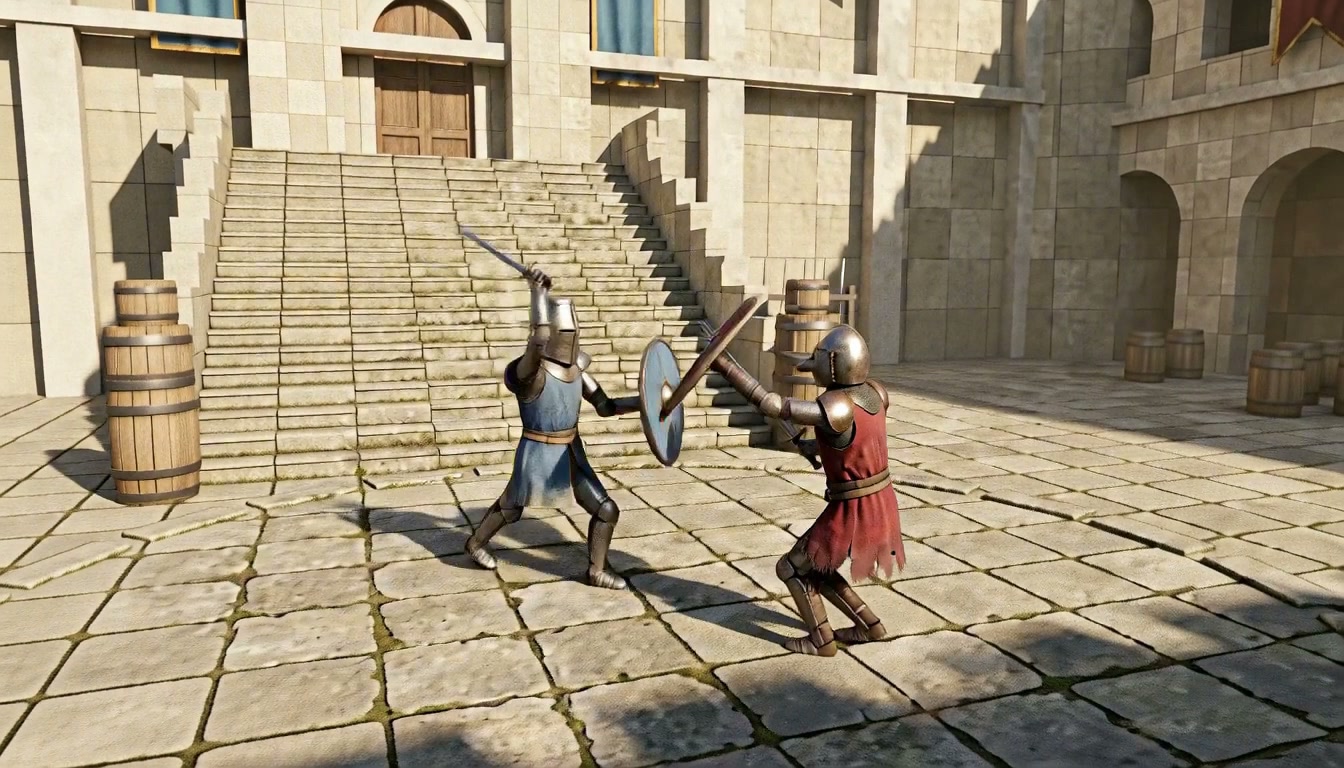
基准测试中灰盒城堡案例的一帧画面,仅依据结构视频,加上首帧与提示词渲染而成。
输入要求与输出结果
输入包括:一段 24 fps、至少 158 帧的结构视频,一个可选的首帧(用于指定你想要的外观),以及一段提示词。输出为 158 帧、24 fps 的视频,横屏 1344x768 或竖屏 768x1344,采用四步采样。其他画布尺寸会被缩放并裁剪。提示词并非自由文本:该模型是在一种六段式格式上训练的(主体定义、摘要、保留分析、350 到 500 词的描述、声景、非叙事音乐),仓库中也明确指出,简短的自由式句子效果要差得多。
控制 LoRA 不携带条件类型标签。结构帧会在它们所描述帧的位置进入 H3 的原生引用通路,而提示词用文字指明该结构,这正是单个适配器能够覆盖它从未训练过的结构表征的原因。基准列出了 16 种结构类型,其中 11 种在训练中未曾出现,而论文图库显示这些未见类型同样表现良好:铅笔分镜、点云、体素、线框,以及儿童的蜡笔画。
 |  |
|---|---|
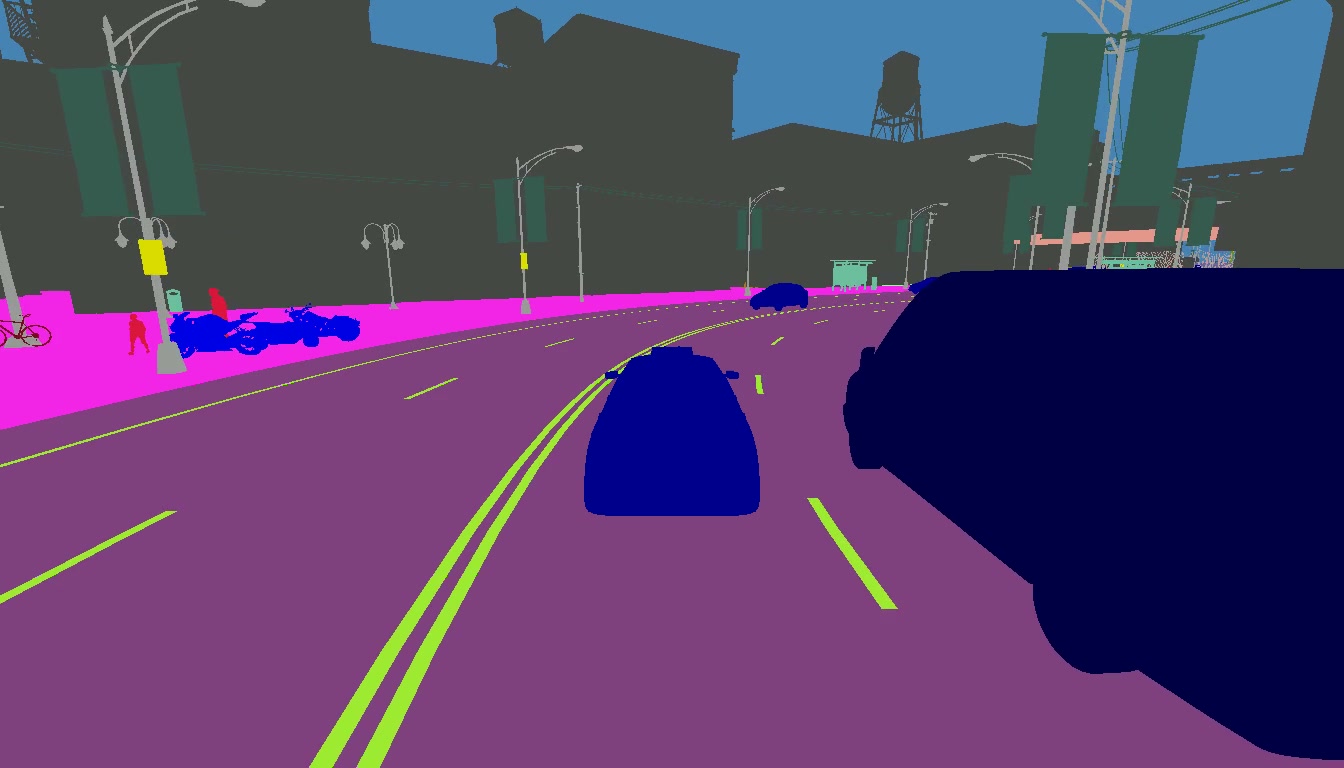
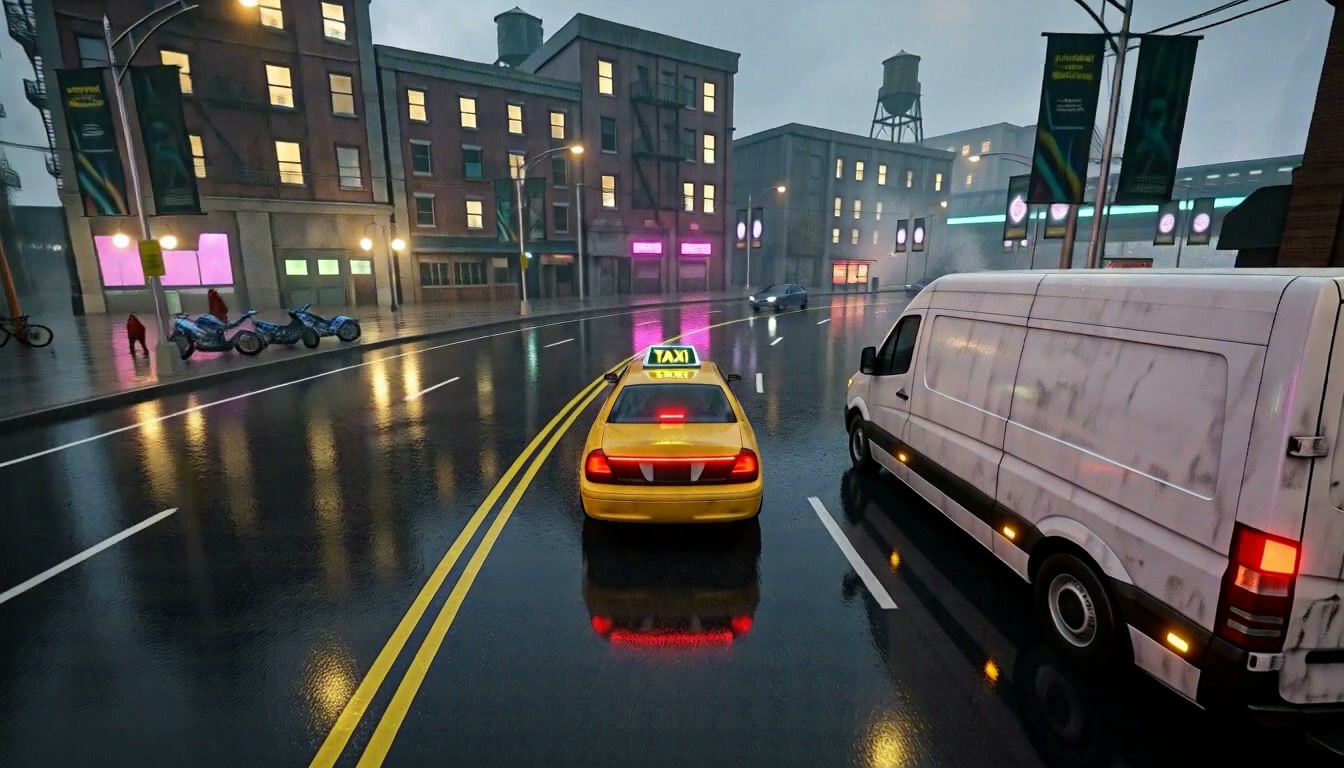
| 从 CARLA 导出的语义分割 | 渲染结果,标注为快速相机、夜晚、多人 |
 |  |
|---|---|
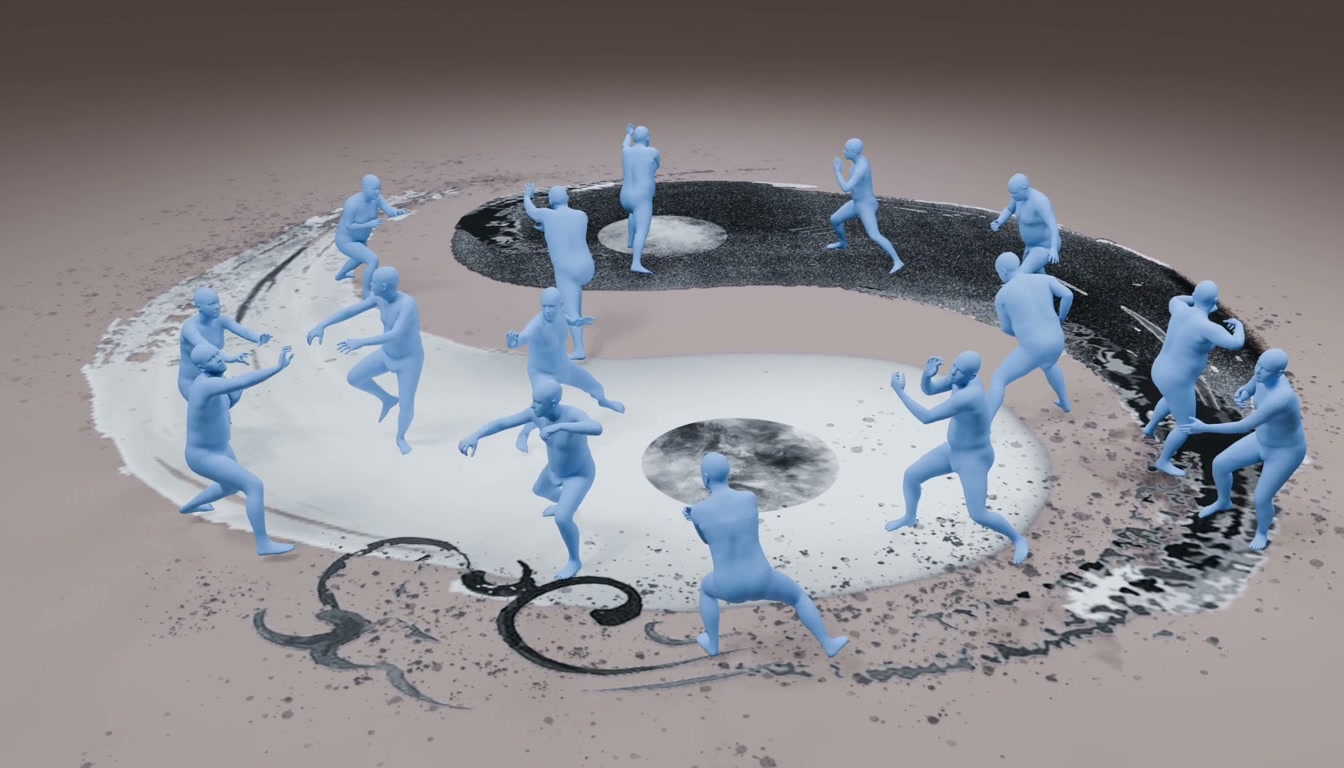
| 来自 DirtyMoCap 视频的 SMPL 人体网格,属于训练集之外的条件类型 | 同一段视频片段以动漫风格渲染 |
完整的 158 帧赛博朋克渲染,由已发布的基准输出重新编码而来。
两个 LoRA、四步与流式配对
控制 LoRA 的秩为 384,并按帧对齐注入结构视频。四步 LoRA 的秩同样为 384,基于 DMAD 微调而来;DMAD 是社区自 10 月初起一直在为 ComfyUI 转换的四步 H3 蒸馏模型。此处的蒸馏模型使用结构引导重新训练,使四步学生模型保留控制行为。论文测得该路径比 50 步采样快 12.3 倍。
两个 LoRA 还各自提供第二个版本:块因果版本。因果配对逐块渲染片段,每个块最多包含五个 Latent 帧,可看到提示词、第一帧、此前六个块的结构以及它之前已渲染的五个块,但绝不会看到更靠后的块。每个块执行四步,然后写入键/值缓存,因此块一完成即可显示;--seconds 借助六块窗口的内存,将单次渲染延长至结构视频的长度。
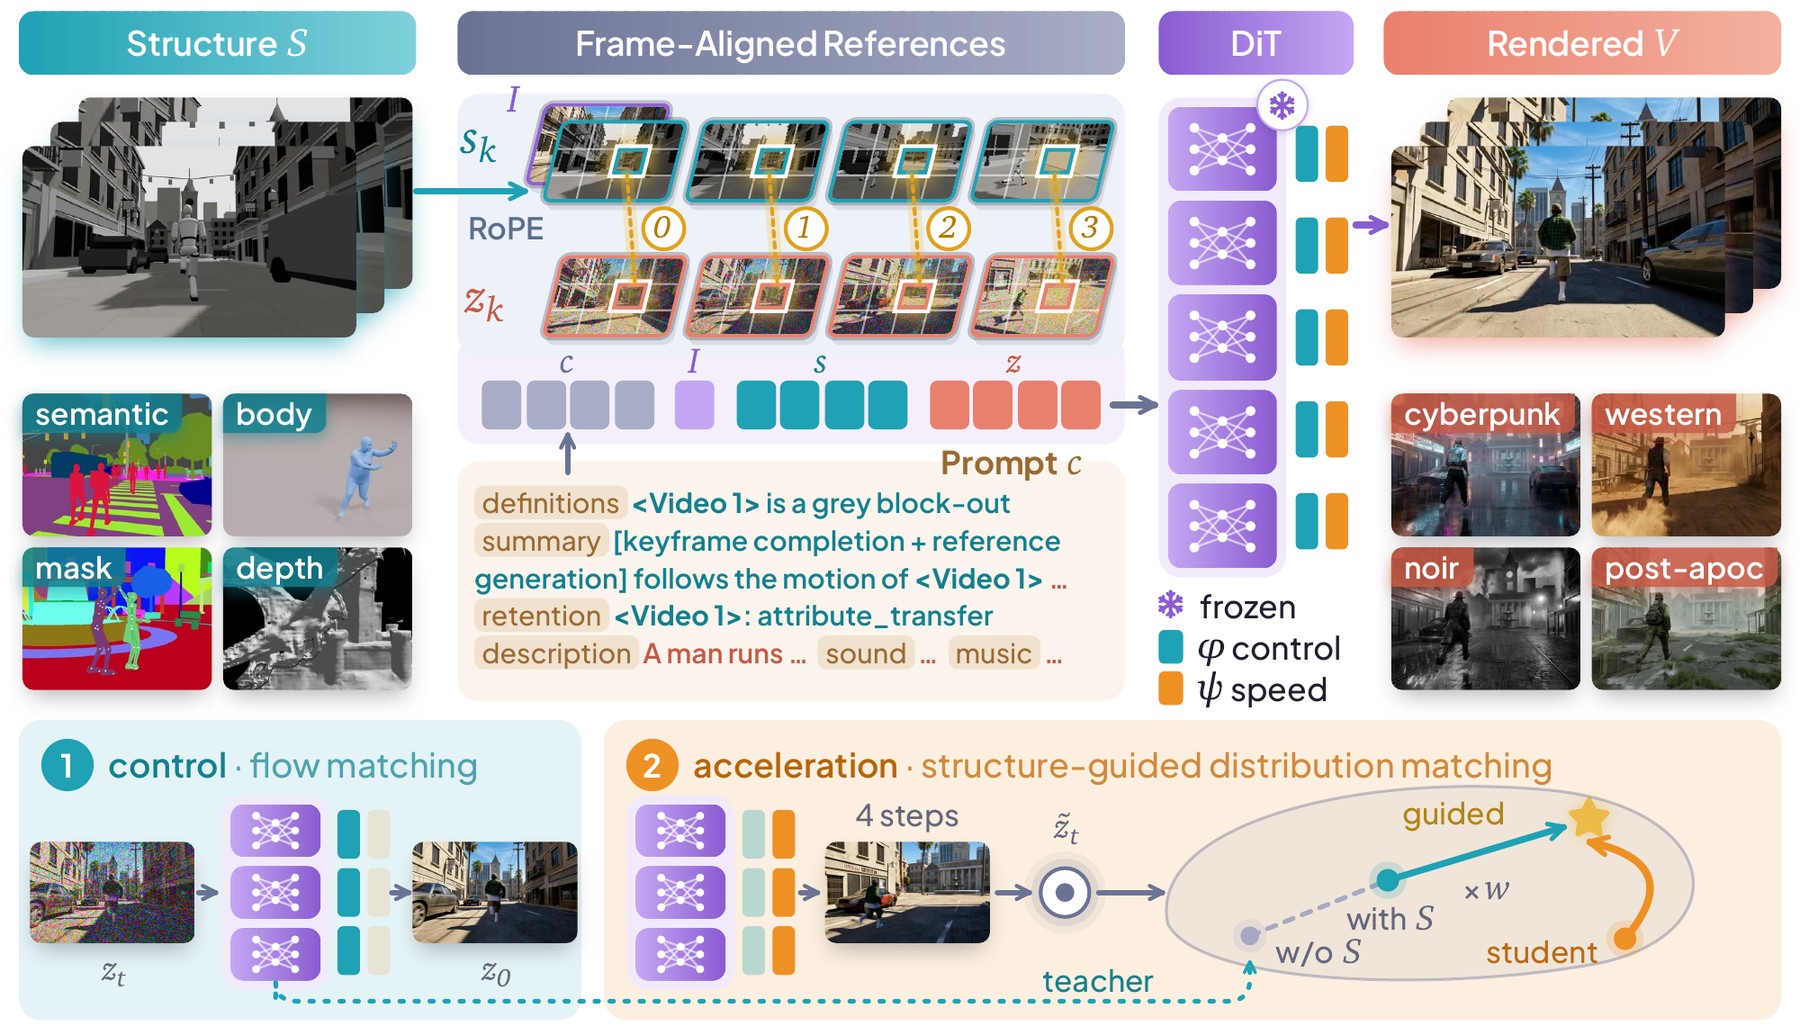
项目中的 pipeline:输入结构视频,在冻结的 H3 主干上应用控制 LoRA 与四步 LoRA,并采用用于流式生成的块因果变体。
在 ComfyUI 中运行
仓库在 comfyui/ 中自带节点包,按常规方式克隆到 custom_nodes/ 即可;它没有注册表条目,因此 ComfyUI Manager 找不到它。它基于 ComfyUI 自带的 MiniMax H3 支持(v0.30.0 或更高版本)与 Comfy-Org/MiniMax-H3 权重运行,LoRA 按发布版本直接加载:加载器会把它们映射到 ComfyUI 的权重名称上,其中两个会串联,先接四步 LoRA,再接控制 LoRA。
| 节点 | 作用 |
|---|---|
| SolarRenderer LoRA Loader | 加载已发布的 SolarRenderer LoRA,可串联两个 |
| SolarRenderer Structure to Video | 输入结构视频、首帧和提示词;输出条件和空 Latent |
| SolarRenderer Model (silent soundtrack) | 采样时把配乐保持在静音状态,与渲染器的训练方式一致 |
| SolarRenderer Four-Step Sigmas | 四步调度表,配合 SamplerCustomAdvanced 采样 |
| SolarRenderer Causal Sampler (long clips) | 借助因果对,以任意长度逐块渲染 |
| SolarRenderer Fast Attention | 在另一个内核上运行注意力,输出相同 |
| SolarRenderer Prompt | 由各个自由部件构建六段式提示词 |
| SolarRenderer Web Capture | 将 three.js 或 WebGL 页面连同其音频录制为结构视频 |
它附带三个工作流:完整质量、低内存和长片段因果图。低内存工作流对本地显卡最有价值。仓库报告称,在 16 GB 显卡(如 RTX 4080 或 4090)和 64 GB 系统内存上,它完成渲染时 ComfyUI 保持在 14 GB GPU 内存,含 CUDA 上下文的峰值为 14.5 GB。在能容纳全部模型的显卡上,这条路径的耗时约为完整版的两倍。
该节点包还在 http://127.0.0.1:8188/solarrenderer 提供一个页面:选择一个示例,或拖入结构视频和首帧,写好提示词,选择模型,它就会渲染,采样器预览一到达就显示,并在结构视频旁播放结果。设置 --preview-method taesd 并把 taeh3.safetensors 放入 models/vae_approx,即可观察每一步。只有 Web Capture 节点需要额外安装(playwright 和一次 Chromium 下载)。
基准测试结果说明了什么
论文使用 Gemini 成对评判器对 208 个困难案例和 53 个留出片段进行评分,报告每个问题的 Elo 分数,并给出 DOVER、LAION 美学、VideoScore2、闪烁、DINOv2、CoTracker3 和边缘 F1 的自动评分。在留出集上,对比还包含针对真实片段的 DISTS、LPIPS、PSNR 和 SSIM。
| 方法 | 步数 | 总体(困难集) | 总体(留出集) | 自动评分(困难集) |
|---|---|---|---|---|
| SolarRenderer | 4 | 1441 | 1510 | 71.6 |
| SolarRenderer,因果 | 4 | 1191 | 1199 | 71.2 |
| LynnReal-Omni | 4 | 1441 | 1410 | 70.0 |
| PAI ControlNet-Union | 40 | 1221 | 1189 | 69.4 |
| 官方 H3 骨干网络 | 50 | 1075 | 651 | 69.8 |
| Streaming CWM | 4 | 1075 | 988 | 70.7 |
| Wan2.2-VACE-Fun | 50 | 389 | 651 | 65.2 |
| Cosmos-Transfer2.5 | 35 | 389 | 651 | 64.7 |
| StreamRender-H3 | 2 | 580 | 651 | 63.9 |
这张表中确实存在平局:LynnReal-Omni 在困难集的总体评分上与 SolarRenderer 持平,但在留出集上落败。因果变体仅与双向变体进行对比评分,因此排名在其下方。这些数字背后的评判结论和 522 份渲染结果已随基准测试一同发布,因此可以重新评分,而不必凭空采信。
论文还声称因果变体能够实时渲染 768p。仓库自带的 Reactor 集成是一个由 Reactor 团队贡献的开发预览,其说法更为保守:在四块 B200 GPU 上,一个稳定的 17 帧块大约需要 1.8 到 2.1 秒,达不到原生 24 fps 的时间线,而准备一个新视频可能需要一分多钟。
社区发现了什么
在 Banodoco Discord 上,该版本发布当天就有人进行了上手测试。Kijai 针对原始 DMAD 测试了四步 LoRA,发现必须使用 Latent 引导来匹配训练设置,结果才能对齐;之后,在他看来,原生 H3 节点可以承载它:“你确实必须使用 Latent 引导来匹配他们的训练,这样效果更好,我们可以用原生节点完成。”他对输出的评价褒贬不一,但很具体:运动跟随准确到略微过于字面的程度,而丢掉第一帧会损失质量。
提示词形式引发的抱怨最多,Kijai 称官方示例提示词非常复杂,RuneX 则建议使用系统提示词。RuneX 在运行该包的页面时还遇到了宿主缓冲区错误,并认为如果模型已以原生方式加载,包中大部分内容都是可替换的:“其他那些只是一个 Flash Attention 节点和一个手动 sigma 节点。”Alisson 的 TARA 补丁在 H3 运动迁移上采用了同样的原生引用路线,他让训练规模有了参照:136,000 个片段,而他自己的只有 700 个。
相关反应来自 10 月 25 日的 #minimax_h3_chatter,从这里开始。
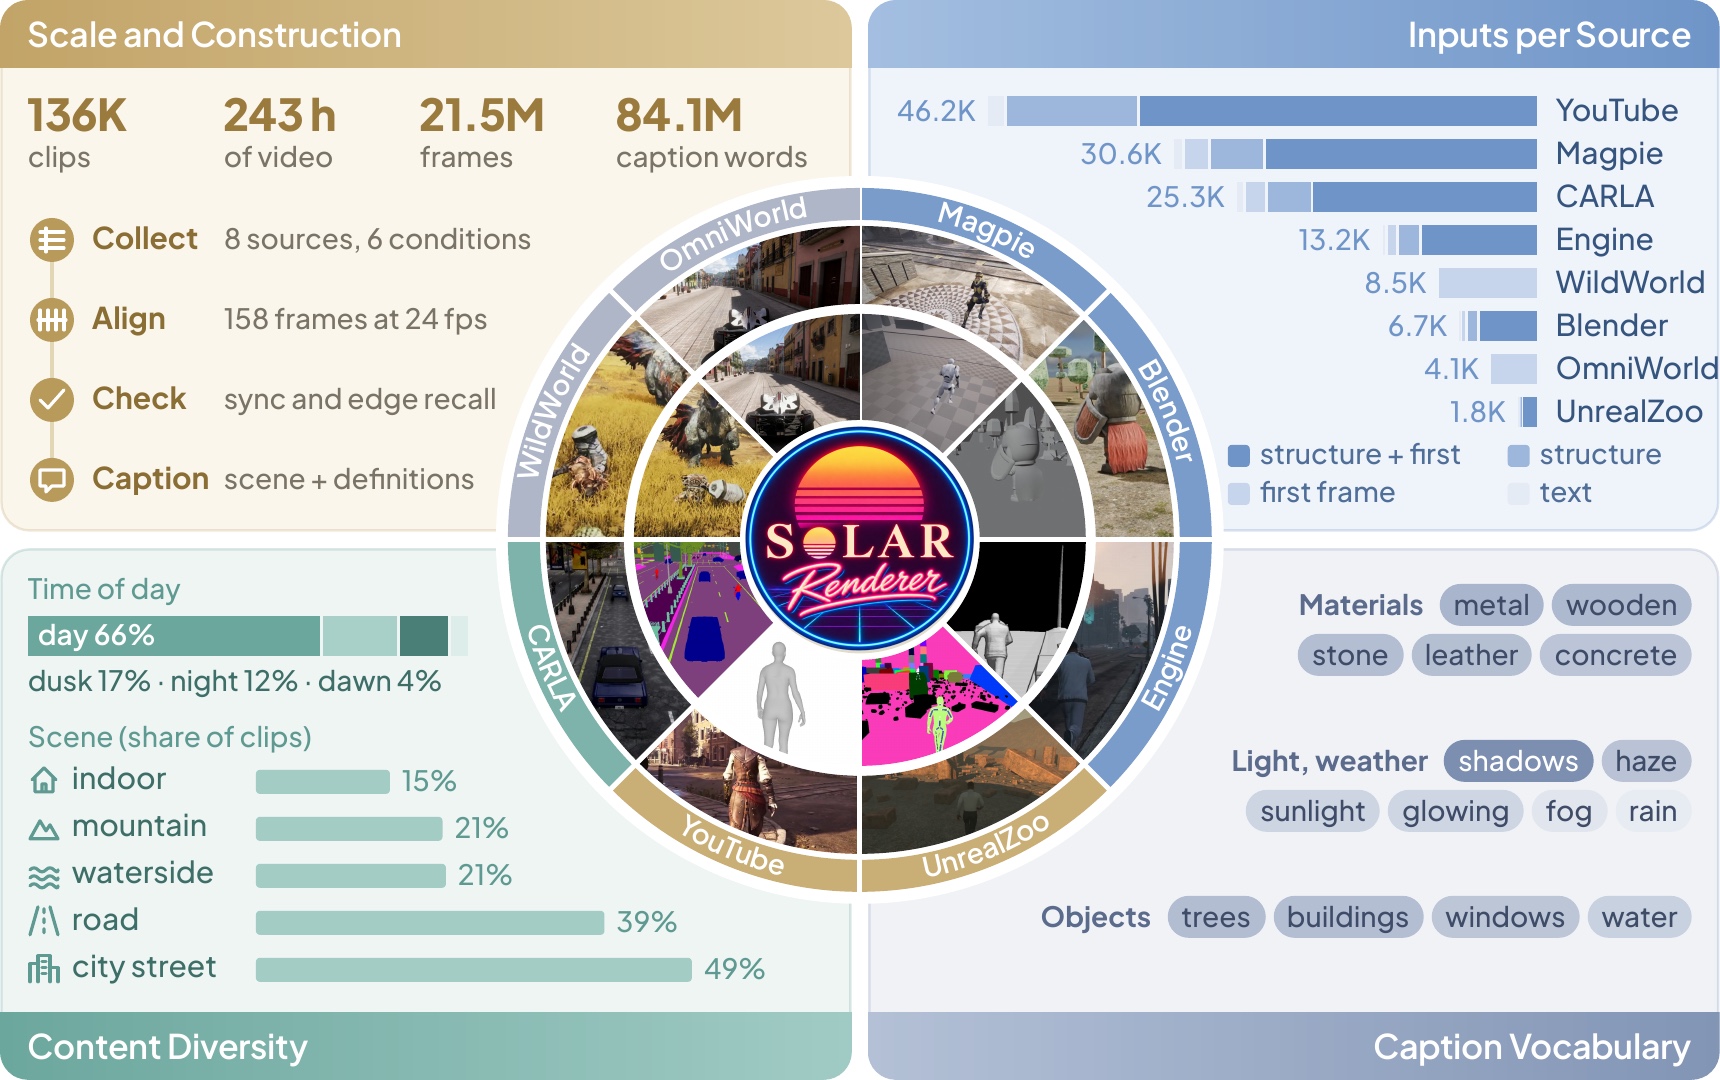
已发布的训练来源:Magpie、CARLA 和 UnrealZoo 片段,论文描述的 136,000 个片段中有 57,738 个。
值得了解的局限
- 训练所用的视频片段为 6.6 秒。更长的视频需要因果配对(causal pair),而因果采样器在 1344x768 下会保留约 80 GB 的 key/value 缓存,当它放不下时会溢出到系统内存。
- 引用路径需要 135 GB 的 H3 权重,外加 8 GB 的 LoRA 用于双向配对;正是 ComfyUI 的低内存方案让 16 GB 显卡也能跑起来。
- 提示词格式是硬性约束,而不是风格建议。自由文本会失去 LoRA 训练时所针对的控制能力。
- Elo 评分表来自单一评判者,而困难划分(hard split)的首帧由图像模型生成,而非真实拍摄的照片。
- Reactor 流式路径属于预览,与原生推理并非逐位一致,Docker 执行也尚未验证。
获取方式
权重、causal pair、配置和许可条款位于 Enderfga/SolarRenderer;代码、ComfyUI 节点包、三个工作流、提示词技能以及 Reactor 集成位于 GitHub 仓库;训练数据和基准测试位于 Enderfga/SolarRenderer-Data。Hugging Face Spaces 上还提供在线演示,无需安装即可完成渲染。
评论
使用 GitHub 登录后即可参与讨论。