H3 Anti-Burn LoRA:阻止链式 H3 片段中的面部烧灼
一款面向 MiniMax H3 续接片段的 rank-32 LoRA,可将 lightx2v 8 步链式生成中的面部烧灼从 +44% 降至 0%,并将未见过的 turbo 从 +61% 降至 +4%。
diffusion_model.*),因此不需要自定义节点。
它针对的问题
一段长 H3 视频通常通过链式生成构建:第 2 个片段接续第 1 个片段的最后几帧,第 3 个片段接续第 2 个,依此类推。每次续接都会复制交给它的结尾,并叠加一点自身的误差。经过几个片段之后,面部就会烧灼:皮肤和线条变得粗糙、刻痕感明显,整个画面也随之变得生硬。
该 LoRA 仅加载在续接流程上,让它们贴近正常生成的第 1 个片段的外观。它明确不适用于第 1 个片段,因为第 1 个片段没有可烧灼的来源。
使用方法
- 仅在渲染续接片段(第 2 个片段及之后)的模型上,用
LoraLoaderModelOnly加载它。 - 从强度 0.5 开始。如果面部仍逐片段变得更粗糙,就调高;如果面部变得柔化或发蜡,就调低。
- 强度取决于所用的 turbo 和流程。将 LoRA 合并进 8 位模型会削弱其效果,因此建议先在 4 到 5 个片段的链上试几个值再作定夺。
实测结果
每条链 10 个片段,每个片段约 37 秒,覆盖四个场景(一个厨房、使用第二个种子的同一厨房、一个公园和一个门廊),每个设置对所有链取平均值。“面部烧灼”指第 1 个片段到第 10 个片段之间面部细节纹理的变化幅度:0 表示第 10 个片段与第 1 个片段一样干净,正值表示发生烧灼,负值表示比第 1 个片段更柔和。
| Turbo | 无 LoRA | 0.4 | 0.5 | 0.6 | 0.8 |
|---|---|---|---|---|---|
| 未见过的模型(从未训练过) | +61% | +29% | +4% | −13% | |
| HyperFlow 8 步 | +25% | +4% | −1% | −14% | |
| lightx2v 8 步 v1.0 768p | +44% | +14% | 0% | −7% | −37% |
| Larry Turbo v4(600 步 EMA) | +261% | +212% | +159% | +57% |
“未见过的模型”这一列最重要:该 LoRA 是在 Larry Turbo v4、HyperFlow 和 lightx2v 上训练的,但它仍能把从未见过的第四种 turbo 在 0.6 强度下控制在 +4%。
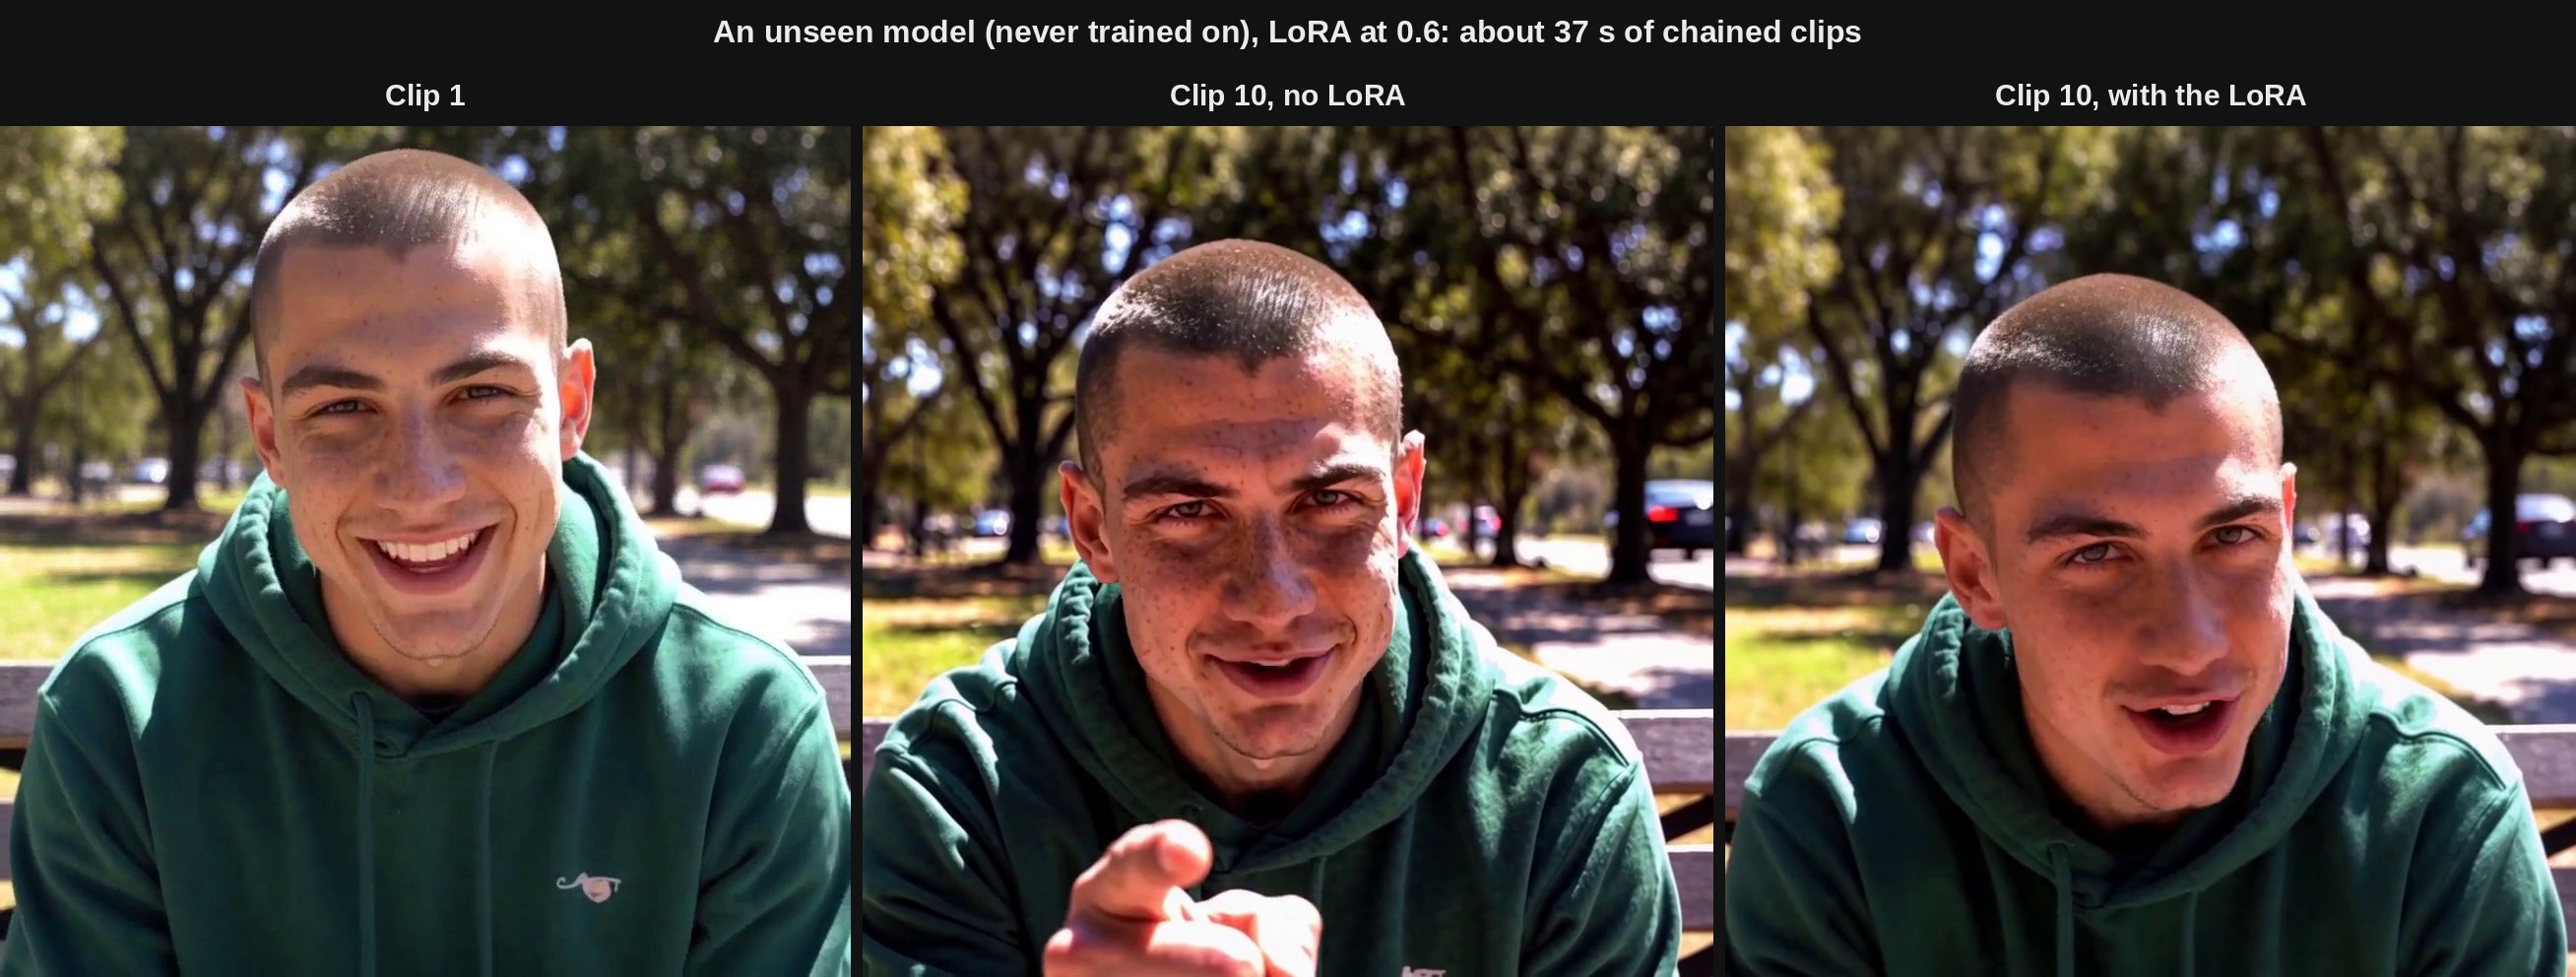
一个该 LoRA 从未训练过的 turbo。依次为第 1 个片段、不使用 LoRA 的第 10 个片段、以 0.6 强度使用它的第 10 个片段。在此场景中,面部烧灼从 +51% 变为 −4%。
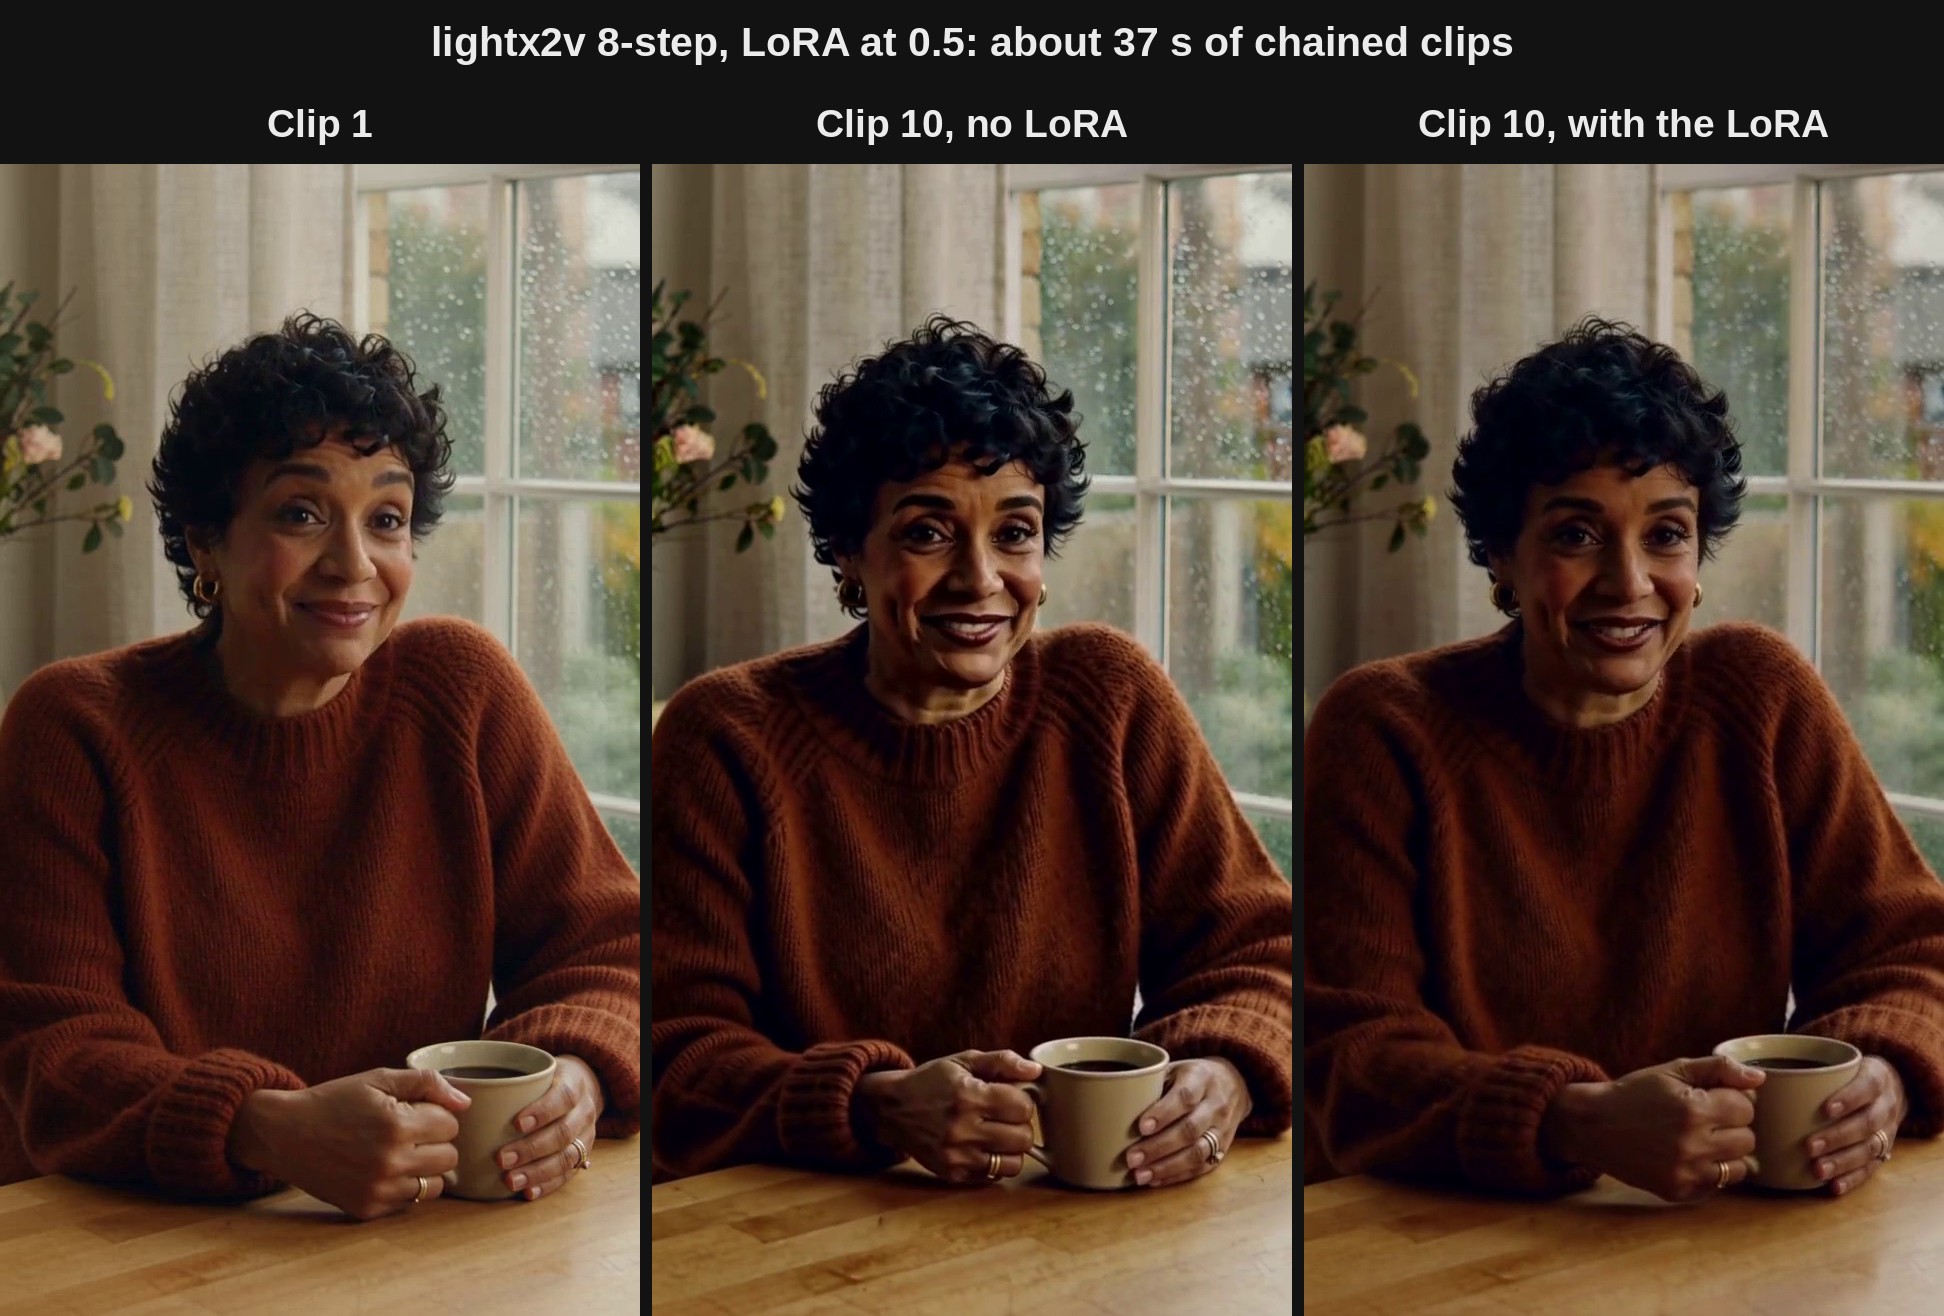
lightx2v 8 步 v1.0 768p 在厨房场景中:不使用 LoRA 为 +52%,以 0.5 强度使用时为 +6%。
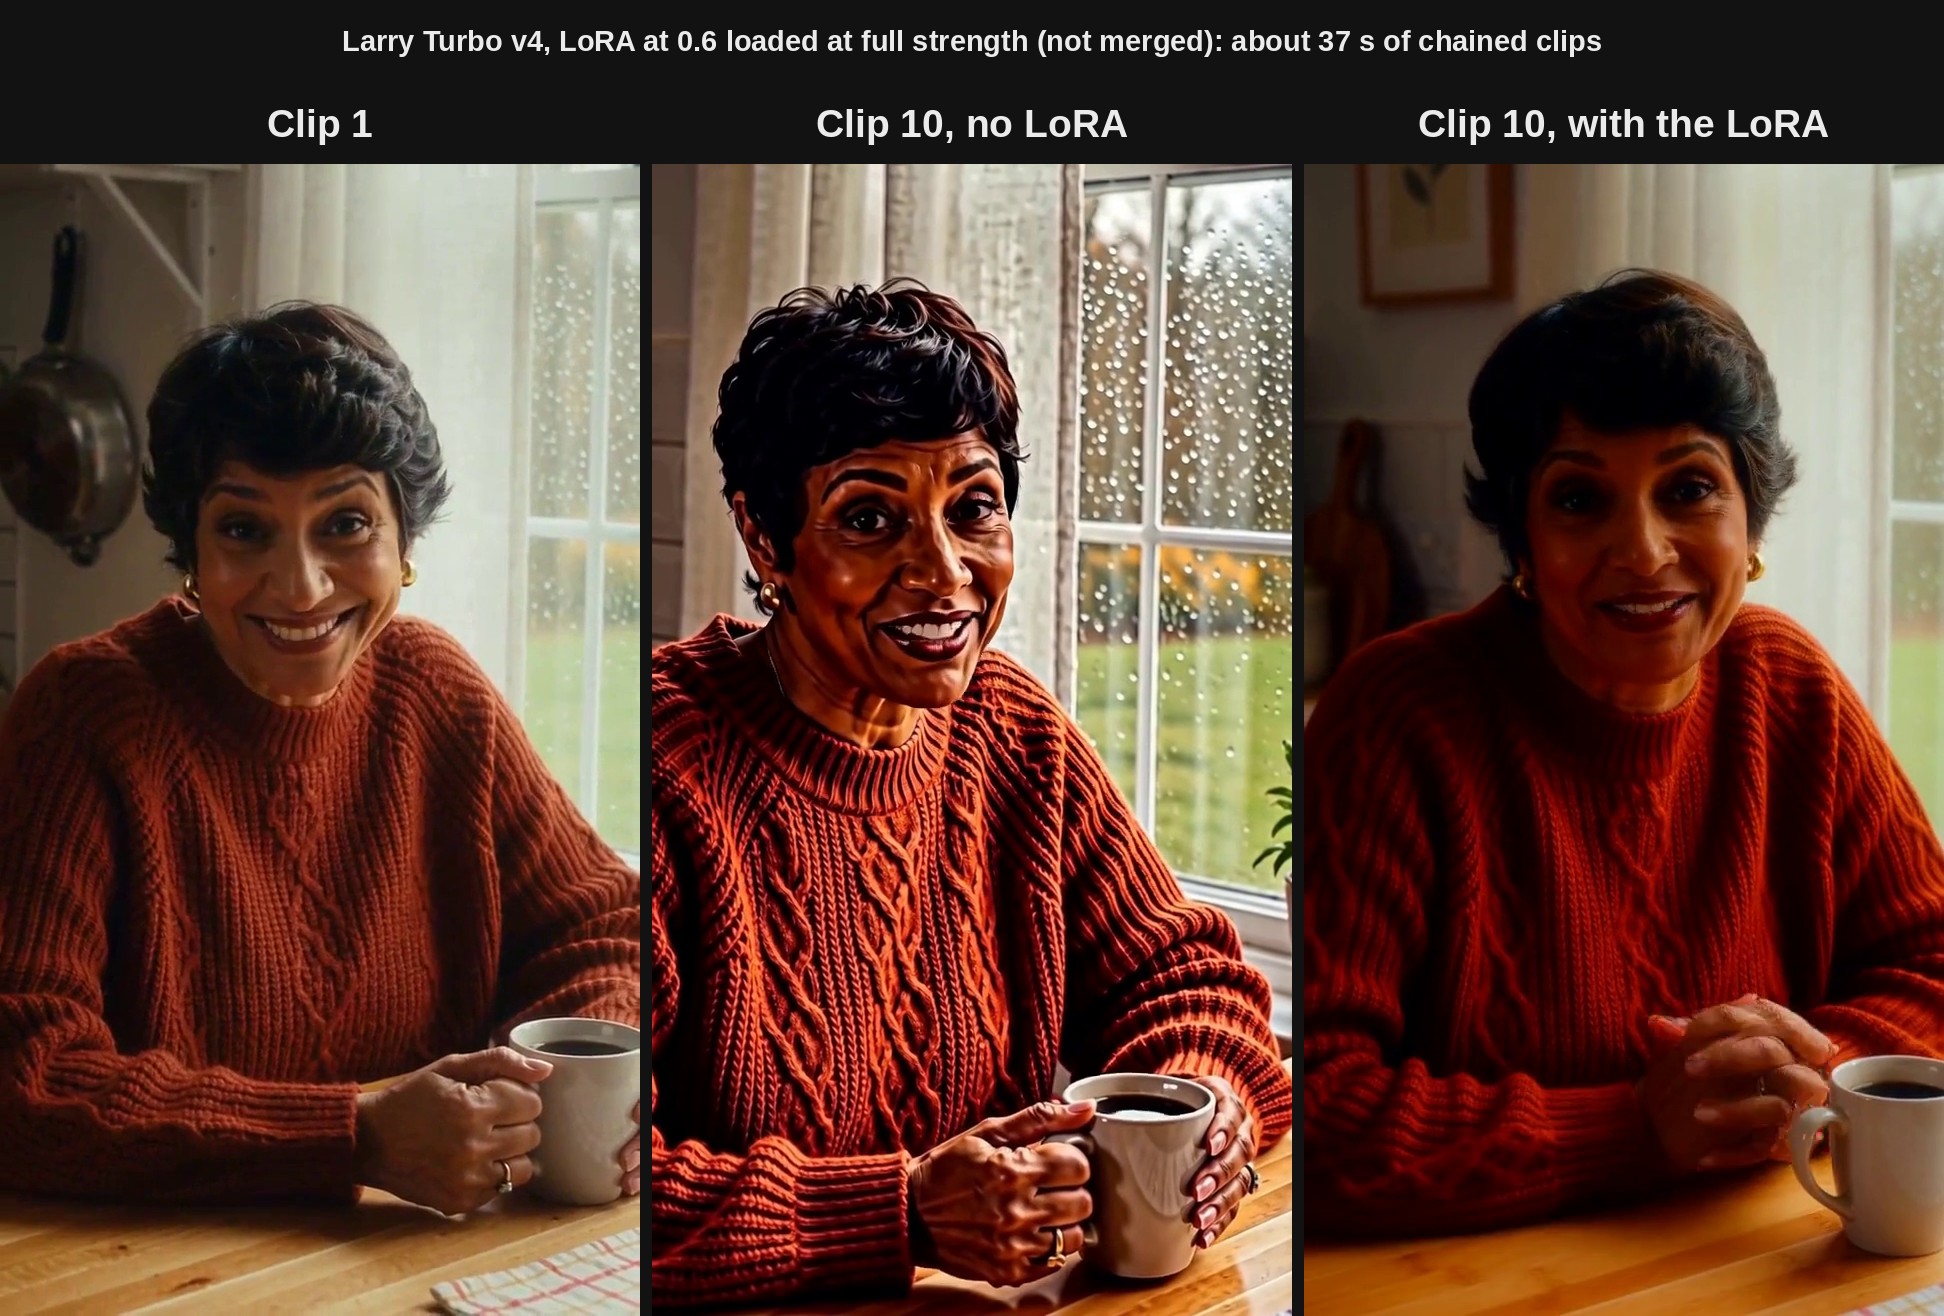
Larry Turbo v4 是本次测试中烧灼最严重的模型:不使用 LoRA 为 +189%,以完整强度加载 0.6 强度时为 −15%。Larry 仍会使图像变柔和,并整体偏暖、偏暗。
在合并方案中,Larry 需要高于 0.8 的强度。在 1.0 时其面部烧灼消失(−19%,两条链),但相机取景开始发生变化;若改为完整强度加载而非合并,0.6 就把它从 +261% 降到 −5%。
不使用 LoRA 时,饱和度、皮肤红润度和唇形同步保持不变。细节会略微下降:比第 1 个片段低 4% 到 14%,而不使用 LoRA 时则比第 1 个片段高 3% 到 18%。强度过高会表现为面部柔化、发蜡。
这些数字背后的设置
- 使用 ComfyUI 的 int8 ConvRot 剪枝版 MiniMax H3 模型,来自 Comfy-Org/MiniMax-H3;第 1 个片段使用
fl2va,续接片段使用ref2va。 - LoRA 在 turbo LoRA 之前用
LoraLoaderModelOnly合并。 - 每个续接片段都携带上一个片段的最后 39 帧及其音频,作为受保护的遮罩上下文。
- 8 步,CFG 1,分辨率为 640×1152、1152×640 和 864×864。
其他模型(bf16、fp8、GGUF)、其他步数以及其他续接方式都需要不同的强度。
局限
模型卡片对其适用范围说得很直接。每个设置四个场景属于小规模测试,单条 10 片段链的结果可能上下浮动 ±15 个百分点。它能防止烧灼,但无法修复已经烧灼的视频。它只在基于遮罩上下文的续接上测试过,未在其他视频延长方式上测试,且只测试了面部处于中近距离的说话人物。
训练方式
训练采用轨迹自蒸馏。作者记录了每种 turbo 在一次全新 8 步生成中的实际表现,共 150 次全尺寸运行,Larry、HyperFlow 和 lightx2v 各 50 次。随后该 LoRA 在续接模式下训练,将同一视频的开头固定为受保护的上下文,并以该 turbo 自身全新运行的结果作为目标,这样续接就会学着看起来像一次全新生成,而不是放大其上下文中的内容。训练中没有使用合成烧灼,也没有使用全新噪波损失;更早使用这些方法的版本会把一切变柔和。
运行设置为 300 步、rank 32、学习率 1e-4、网络权重 0.6、分辨率 864、124 帧,在单张 RTX PRO 6000 上完成。
获取方式
适配器文件为 Hugging Face 仓库中的 h3_antiburn_universal_v1.safetensors:416 个张量,bf16,覆盖 50 个 DiT 块的注意力层和 MLP 层以及 2 个 token-refiner 块,不含 adaLN。将其放入 ComfyUI/models/loras/。训练代码、配置以及记录和评分脚本位于 ai-toolkit 分支的 h3-antiburn 分支。
评论
使用 GitHub 登录后即可参与讨论。