ComfyUI-Drama3:Fish Audio Drama 3 在 8 GB 显卡上本地运行
ComfyUI-Drama3 是一个节点包,可在 ComfyUI 中以 8 GB 显存运行 Fish Audio Drama 3,支持声音克隆、16 说话人对话、内联提示与 Qwen3-ASR。
ComfyUI-Drama3:把 Drama 3 和 Qwen3-ASR 做成 ComfyUI 节点,无需安装额外软件包。
Drama 3 是一个 35B 的混合专家文本转语音模型,每个 token 激活 3B 参数。Fish Audio 自家的软件包是八个 safetensors 分片加一个编解码器,磁盘占用约 40 GB,而 ComfyUI 合作伙伴节点 通过 API 访问它。这个节点包走的是本地路线:它自行加载已发布的 checkpoint,在 ComfyUI 内生成音频编码,并在同一画面中把它们解码为 44.1 kHz。
8 GB 显卡上的 35B 模型
Drama 3 是 Qwen3.5 风格的混合专家模型:40 层,每层有 256 个路由专家,其中每个音频帧运行 8 个,外加注意力或 DeltaNet、一个共享专家和一个 13 层码本解码器。除路由专家之外的所有部分约 6 GB,常驻 GPU。当专家留在内存中时,32 GB 的专家权重存放在锁页(pinned)系统内存里:每一帧都会复制每层所需的八个专家,而显存剩余空间里的最近最少使用(LRU)缓存会保留那些会被再次用到的专家,85% 到 95% 的读取命中 13 GB 缓存。
该节点包提供四种 checkpoint 版本,可按机器选择:
| 文件 | 大小 | 专家 | 专家在内存中时的内存占用 |
|---|---|---|---|
drama3_fp8experts_bf16 | 38.6 GB | FP8,与 Fish Audio 发布时一致 | 约 48 GB |
drama3_int8experts_bf16 | 38.7 GB | int8 ConvRot | 约 48 GB |
drama3_w6a8experts_bf16 | 32.7 GB | W6A8 | 约 40 GB |
drama3_w4a8experts_bf16 | 24.6 GB | W4A8 | 约 32 GB |
FP8 逐字节保留 Fish Audio 自己的专家权重。int8 大小相同,在 RTX 3090 上快 14% 到 17%,因为 int8 专家以 int8 运行,而 FP8 专家每次都要转换成 bf16。更小的文件适合内存不足以满足 FP8 文件约 48 GB 需求的机器。当 experts 设为 VRAM 而非 RAM 时,第二块 GPU 可以承载专家权重。
声音、对话与提示
该节点包遵循 Drama 3 自身的提示词语法,与技术报告所记录的一致:
| 控制 | 写法 | 示例 |
|---|---|---|
| 说话人 | 在行首使用 <|speaker:N|>,N 从 0 到 15 | <|speaker:0|> Ready? |
| 点标签 | 在声音应落下的位置使用 [tag] | Well [sighs] fine, you win. |
| 作用域标签 | 用 <tag>...</tag> 包住它修饰的词 | Promise me <whisper>you won't tell her</whisper>. |
| 风格前缀 | 在行首使用 [style] | [with bright eager excitement] We won! |
| 导演备注 | Direction:,然后下一行写 Line: | Direction: icy calm. |
| 语言提示 | 在行末使用 [language: xx],不会被朗读 | Welcome back. [language: en] |
一段文本最多可由 16 个说话人共享,每个人各占一个声音槽位。长文本会被切成约 300 字节的块,且不会切断标签。生成有四种模式:每行生成一次、每行生成一次且能听到上一行、每个说话人生成一次,或整篇脚本一次性生成,让每一行都能听到其他行。解码会用 0.3 秒静音连接不同的生成结果,并可缩短过长的停顿。
一个声音只需从一段音频切片及其转写文本编码一次,之后便可保存为 output/drama3_voices 中几 KB 的文件,因此后续运行既不需要原始切片,也不需要编解码器。已生成的音频同样可以保存到 output/drama3_codes,无需重新生成即可再次解码或编辑。
转写与编辑生成结果
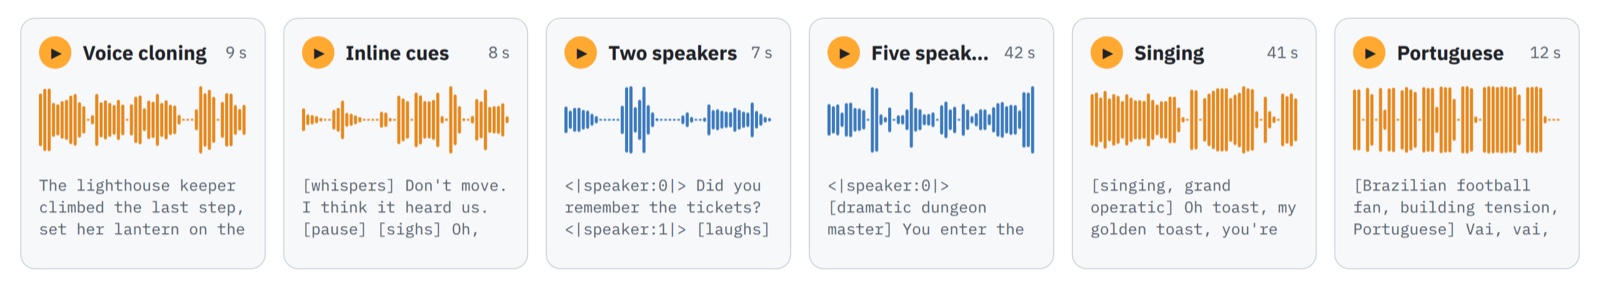
来自该节点包示例页面的六个示例:克隆、提示、双人场景、五人场景、唱歌和葡萄牙语。每个示例均生成于 RTX 3090 或 RTX 4090,使用 FP8 版本。
声音克隆需要先有转写文本,而该节点包正好提供:Load Qwen3-ASR 加上 Qwen3-ASR Transcribe 可运行 1.7B 或 0.6B 语音识别模型以及一个强制对齐器,支持 30 种语言且无需额外软件包。在 RTX 3090 上,一段 6.6 秒的音频切片用 1.7B 模型转写约需 2 秒,用 0.6B 模型约需 1 秒,且已包含模型加载时间。同一个对齐器为 Drama 3 Editor 提供支持,它会在 ComfyUI 画布上打开:字幕会逐词跟随人声,每个声音一条轨道,编辑器可以剪切、添加静音、命名声音并设置其音量。点击 Use these edits 会带着这些编辑重新运行节点,且编辑会保留在工作流中。
速度
Drama 3 每秒钟语音生成 21.5 个音频帧,因此每帧 46 ms 即为实时。逐帧解码受限于 CPU,因为单个核心会启动大量小型 GPU 内核,所以专家缓存大小对速度的影响比预期要小。使用克隆声音、约 9 秒语音,在 Intel Core i9-14900K 上测量,包含提示词处理:
| GPU | 文件 | 专家缓存 | 每帧毫秒数 | 峰值显存 |
|---|---|---|---|---|
| RTX 4090 | W4A8 | 16 GB | 52 | 21.3 GB |
| RTX 4090 | W4A8 | 4 GB | 67 | 11.7 GB |
| RTX 4090 | int8 | 16 GB | 69 | 21.5 GB |
| RTX 3090 | int8 | 16 GB | 69 | 21.6 GB |
| RTX 3090 | FP8 | 16 GB | 84 | 21.6 GB |
| RTX 3090 | FP8 | 4 GB | 119 | 11.9 GB |
| RTX 3090 限制到 12 GB | FP8 | 自动 | 137 | 9.8 GB |
| RTX 3090 限制到 8 GB | FP8 | 自动 | 214 | 6.5 GB |
最后两行的测试中,3090 剩余的内存被另一个进程占用,用以模拟 12 GB 或 8 GB 的显卡。作者还提醒,Fish Audio 的服务器会发送 top_k 30,这会让生成结果在停顿处变成静音,因此节点默认采用该 Space 自身的设置:temperature 1.0、top_p 0.9,且不设 top_k 上限。
入门
ComfyUI/custom_nodes/ 并重新启动 ComfyUI。无需 pip install:节点只使用 ComfyUI 已包含的内容。
cd ComfyUI/custom_nodes
git clone https://github.com/PedroMarinhoDev/ComfyUI-Drama3
下载权重
checkpoint 放到 models/diffusion_models,编解码器放到 models/vae,ASR 和对齐器文件放到 models/asr:
hf download PedroMarinhoDev/Drama-3-ComfyUI drama3_fp8experts_bf16.safetensors --local-dir ComfyUI/models/diffusion_models
hf download PedroMarinhoDev/Drama-3-ComfyUI drama3_codec.safetensors --local-dir ComfyUI/models/vae
hf download PedroMarinhoDev/Qwen3-ASR-ComfyUI qwen3_asr_0.6b_bf16.safetensors --local-dir ComfyUI/models/asr
运行工作流
将示例工作流拖入 ComfyUI,在 加载音频 中选择几秒干净的语音,在 Drama 3 Generate 中写入文本并排队。
获取方式
节点包: PedroMarinhoDev/ComfyUI-Drama3
权重: PedroMarinhoDev/Drama-3-ComfyUI · PedroMarinhoDev/Qwen3-ASR-ComfyUI
示例: pedromarinhodev.github.io/ComfyUI-Drama3
基础模型: fishaudio/drama-3 · Drama 3 新闻
评论
使用 GitHub 登录后即可参与讨论。