SMD:图像、视频、3D 和 MiniMax H3 的 4 步蒸馏
Simplified Matching Distillation 是一种仅基于回归的少步扩散配方。其学生模型覆盖 FLUX、Qwen-Image、Wan2.1、MiniMax H3 和 3D,并为 H3 提供 ComfyUI 工作流。
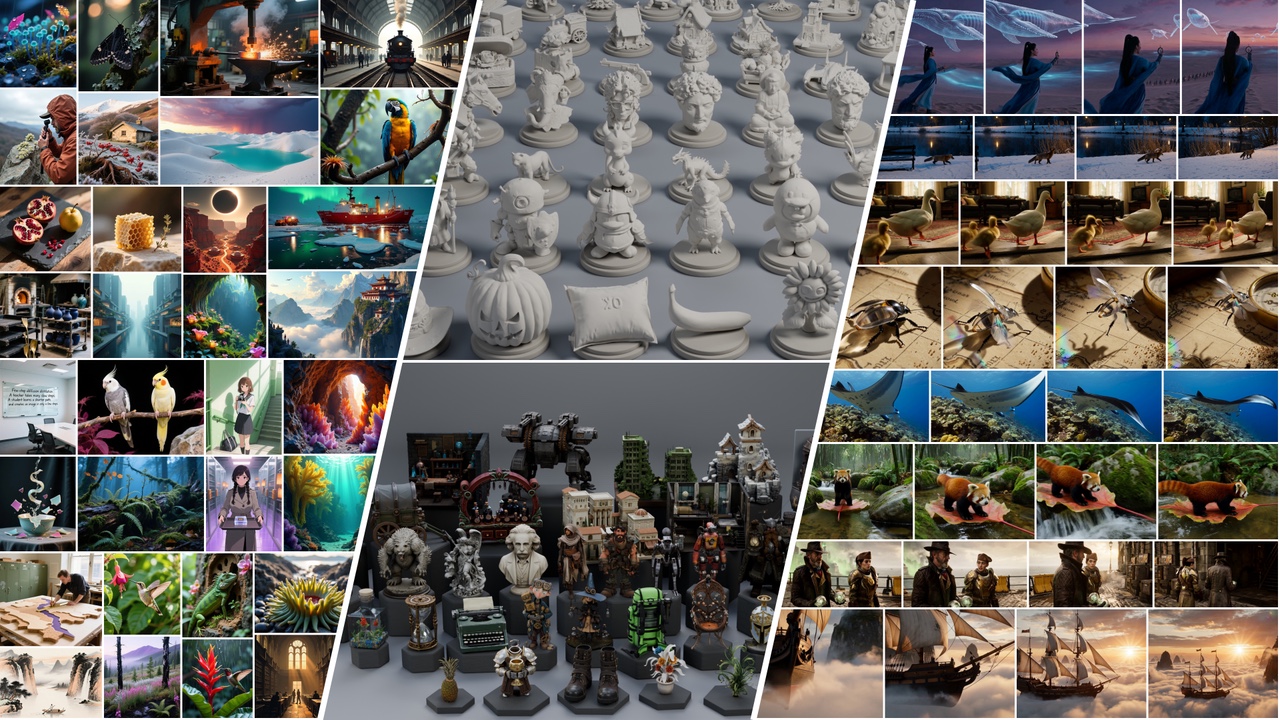
已发布 SMD 学生模型的输出:图像生成与编辑、3D 资产,以及带同步音频的视频。
SMD 改变了什么
SMD 从朴素的同策略(on-policy)速度回归出发:学生模型在自身轨迹上训练,而不是在教师样本上训练。方法其余部分由两项新增设计支撑。Pivot 是一种仅在训练时使用的残差代理,它把教师在粗粒度跃迁内所做的局部修正与学生自身的区间均值预测分离开来,因此 4 步学生模型能够表达其自身无法表示的教师速度变化。第二项是一个排斥项,将学生推离较弱的教师预测;论文称这是一种避免不良模式的轻量方式。
推理阶段没有任何额外开销:无需在线分数估计,无需假分数模型,无需对抗判别器,部署的生成器保持其原有架构。正因如此,同一方法在同一次发布中既能以 LoRA 形式叠加在已有 checkpoint 之上,也能作为完整的去噪器发布。论文报告其可扩展到 330 亿参数,并支持跨模型、多教师与因果视频蒸馏。
发布内容
| 任务 | 学生模型 | 格式 |
|---|---|---|
| 文本生成图像 | FLUX.1-dev、Qwen-Image、SD3.5-Medium、FLUX.2 Klein 4B、Lens | LoRA,SD3.5 另外提供完整 transformer |
| 图像编辑 | Qwen-Image-Edit-2511 | LoRA |
| 文本生成视频 | Wan2.1 1.3B、Wan2.1 14B、因果 Wan2.1 1.3B | LoRA |
| 音视频 | MiniMax H3 T2VA 4 步与 8 步、H3 Ref2VA 4 步与 8 步 | LoRA 适配器 |
| 图像生成 3D | Hunyuan3D-2.1 Shape、TRELLIS.2 形状与纹理 | 每个蒸馏阶段各一个 LoRA |
有两个分支超出了单教师蒸馏。FLUX.2 9B 同时作为 Klein 4B 与 Lens 的教师,而 SD3.5-Medium 有六个变体,即 self、clipscore、geneval、ocr、pickscore 和 multi,其中每个专门化变体优化不同的奖励。
该合集里的每个仓库都附带权重,以及一个已完成示例,其中包含其提示词或引用输入、随机种子与采样设置。LoRA 包需要匹配的基础模型与版本,而完整 transformer 仍需从基础模型获取其编码器与解码器。
发布内容中的示例
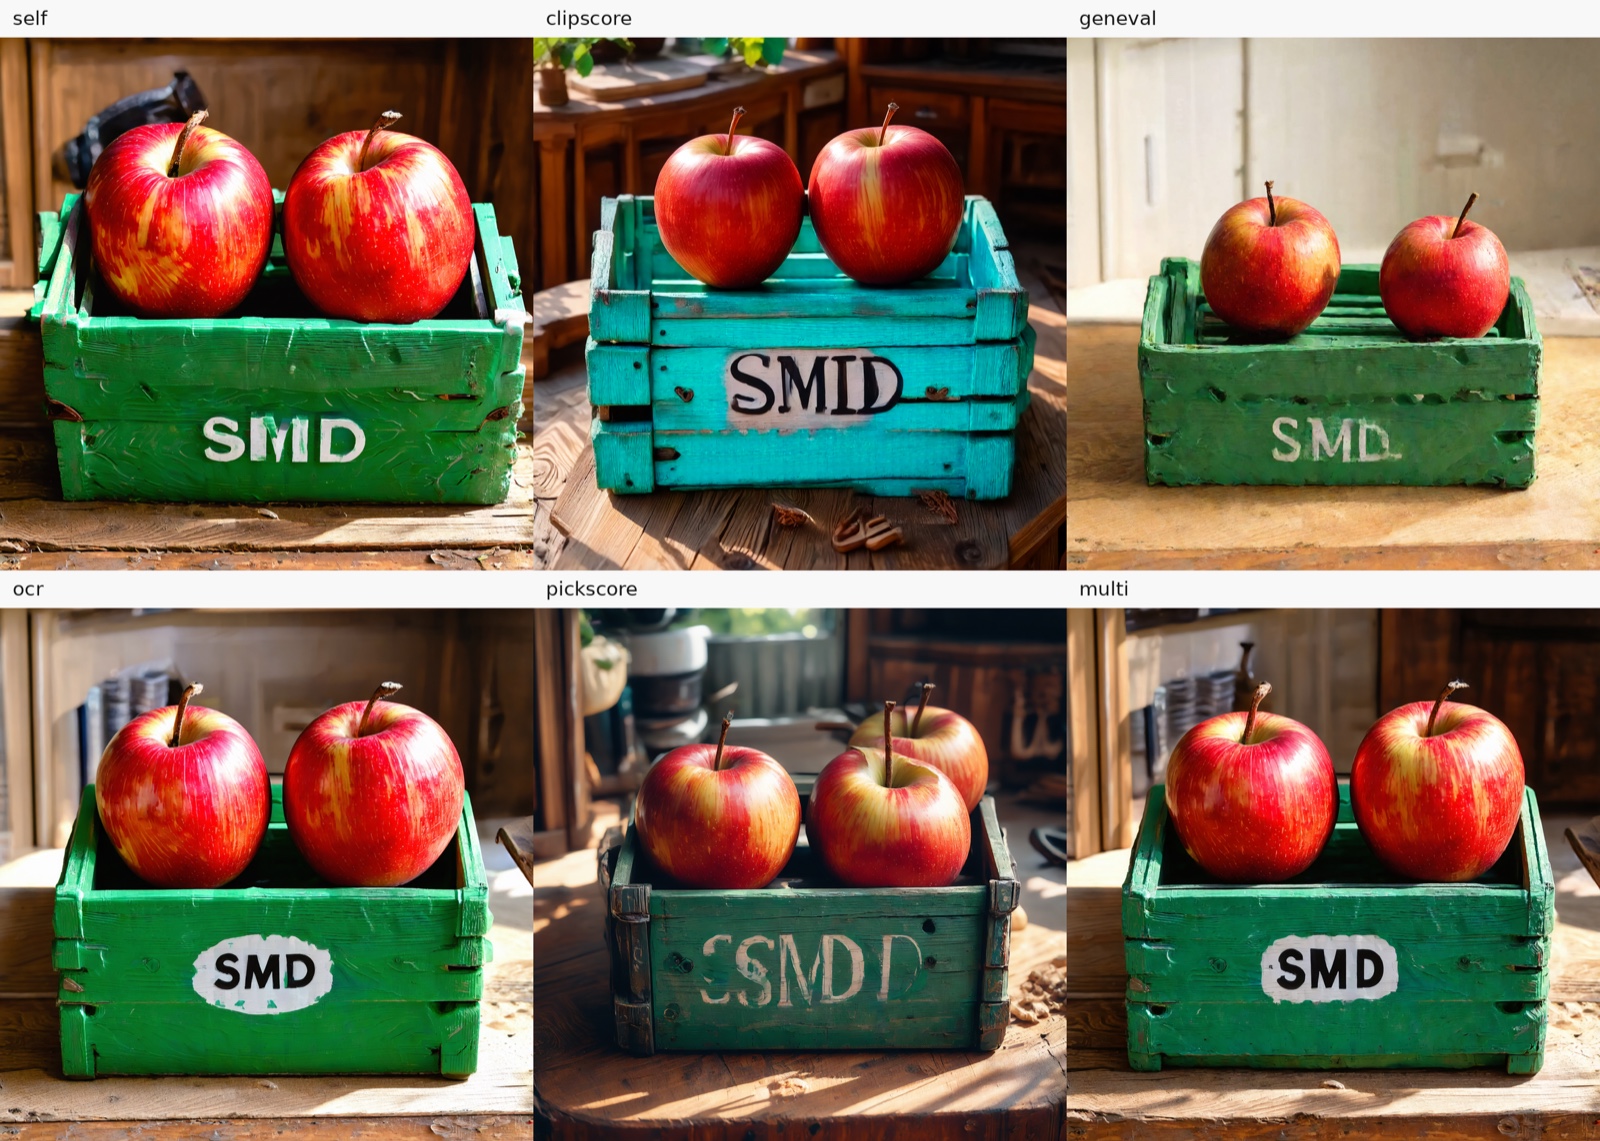
六个 SD3.5-Medium 学生模型并排对比,其中包括多教师 multi 变体。
图像类学生模型各使用四步采样,模型卡展示了生成这些结果所用的设置:为 FLUX.1-dev 使用帆布托特包,为 Qwen-Image 使用下午茶,为 Qwen-Image-Edit-2511 使用一组来源与编辑后的图像对,并为 FLUX.2 Klein 4B 和 Lens 提供双教师对比。视频方面,Wan2.1 14B 与因果 1.3B 模型均以四步运行;3D 方面则为 Hunyuan3D-2.1 Shape 以及 TRELLIS.2 的两个阶段提供四步 LoRA,并各附一段转台视频。
在 ComfyUI 中使用 MiniMax H3
四个 H3 学生模型有各自的包,可运行在 ComfyUI 原生节点上,无需自定义节点包,也无需检出 SMD 训练仓库:
| 包 | 步数 | 示例片段 |
|---|---|---|
| SMD-MiniMax-H3-T2VA-4step-ComfyUI | 4 | 文本生成音视频 |
| SMD-MiniMax-H3-T2VA-8step-ComfyUI | 8 | 文本生成音视频 |
| SMD-MiniMax-H3-Ref2VA-4step-ComfyUI | 4 | 引用图像生成音视频 |
| SMD-MiniMax-H3-Ref2VA-8step-ComfyUI | 8 | 引用图像生成音视频 |
每个包都包含转换后的 LoRA、一个完整工作流以及示例输入。其 download_models.py 会检查模型文件、复制示例输入,并把工作流添加到 ComfyUI 的默认用户库中,因此它会出现在工作流侧边栏的 SMD 分类下;工作流 JSON 也可以直接拖到画布上。引用条件图使用 UNETLoader、LoraLoaderModelOnly、MiniMaxH3SigmaShift、MiniMaxH3ReferenceToVideo 和 ManualSigmas,因此由 LoRA 完成实际工作,采样调度来自该包。在 4 步与 8 步之间切换,意味着打开对应包的工作流与 LoRA。
来自 4 步 Ref2VA 包的一段五秒 H3 引用图像生成音视频片段,使用仓库中附带的两张引用图像生成。
这些包提示了一个陷阱:将 H3 权重替换进 ComfyUI 默认图像模板时,可能会因 audio_scale 缺失而报错,因此应改用包中提供的完整工作流。
训练你自己的学生模型
训练代码与推理示例位于同一个仓库中。它运行在 Linux x86_64 上并依赖 Conda:environments/setup_conda.sh 会构建一个包含 Python 3.12、PyTorch 2.7.1 和 CUDA 12.6 wheel 的环境,FlashAttention 则从源码编译。一次运行就是针对某个训练配置调用 torchrun 并传入数据路径,例如使用两块 GPU 和一份包含 prompt 列的 Parquet 文件来训练 Qwen-Image,而 --download-resources 会拉取该配置所需的资源。
训练在训练基础设施上基于 NVIDIA FastGen,并使用来自 Hugging Face Diffusers 的模型实现;H3 导出路径会写出带有采样元数据的 LoRA 适配器,因此无需融合后的基础 checkpoint。该仓库还附带用于环境搭建、训练与推理,以及接入新模型的智能代理技能。
局限
- 步数与质量方面的说法均来自作者本人:据报告,在 4 NFE 下 SMD 超越了强少步基线,并在多项基准上超过多步教师模型。这些数字来自论文,而非此处的独立复现。
- 蒸馏后的学生模型与各自包中的基础版本和采样设置绑定。尤其是 H3 学生模型,它们是带有缓存条件的 LoRA 适配器。
- 该训练仓库面向 Linux,需要 Conda 和支持 CUDA 12.6 的 NVIDIA 驱动;3D 阶段还需要第二个环境。
- 在已发布的学生模型中,两个 H3 引用条件包的下载量目前最高(撰写时分别约为 1,500 和 1,200),而图像与 3D 仓库的下载量仍为个位数或两位数。
获取方式
代码: zjwfufu/SMD
项目页面: zjwfufu.github.io/SMD-Page
论文: arXiv 2610.18472
权重: Hugging Face collection
数据集: zjwfufu/smd-data
H3 包: T2VA 4-step · T2VA 8-step · Ref2VA 4-step · Ref2VA 8-step
基础模型: MiniMax H3
评论
使用 GitHub 登录后即可参与讨论。