MiniMax H3 角色替换与 Live Wallpaper LoRA:ComfyUI 工作流与示例
Alissonerdx 的 MiniMax H3 LoRA 包新增 v1.0 角色替换能力,可将引导片段中的主体替换为参考角色,并附带 Live Wallpaper 适配器,提供 ComfyUI 工作流与示例。
该仓库与九月介绍的 H3 锐度 LoRA 以及 VFX Edit、Style Transfer 与 Head Swap 适配器同属一个仓库,并且它仍是下载量较高的 H3 LoRA 包之一,在撰写时约为 396 个赞和 116,900 次下载。其中所有内容都基于 H3 的 ref2va 权重训练,并共享相同的条件思路:源片段以对齐引导的方式注入,而不是作为松散的视频引用。
新增内容
| 模型 | 功能 | 触发词 | 工作流 |
|---|---|---|---|
minimax_h3_character_swap_v1.0_ref2va_r64_gl | 用参考图像中的角色替换引导片段的主要主体 | body_swap: | minimax_h3_character_swap_workflow.json |
..._gl_WIP | 实验性并排 checkpoint,768 px,第 250 步,并非主要模型 | body_swap: | 同一工作流 |
minimax_h3_live_wallpaper_v1.0_ref2va_r32 | 为一到三张参考图像添加动画,相机行为的可预测性较低 | live_wallpaper: | minimax_h3_live_wallpaper_workflow.json |
minimax_h3_live_wallpaper_v1.0_ref2va_r64 | r32 checkpoint 的相机感知延续版本 | live_wallpaper: | 同一工作流 |
角色替换权重于 2026 年 10 月 13 日上传。仓库还在 examples/ 文件夹中提供了 19 个角色替换预览片段、12 个 Live Wallpaper 片段以及一组并排对比。
角色替换
角色替换可将引导视频中的主要主体替换为参考图像中显示的角色,同时继承引导视频的场景、构图、运动、姿态和表演。公布的设置刻意保持狭窄:
- 将 LoRA 放入
ComfyUI/models/loras/,并加载捆绑的角色替换工作流。 - 将原始片段发送到
MiniMaxH3AddGuide,frame_idx = 0。该 LoRA 是针对引导 latent 条件训练的,因此这是推荐的视频输入方式,而不是视频引用槽位。 - 将角色图像通过 H3 原生图像引用路径作为
<Picture 1>发送。 - 提示词以
body_swap:开头,并描述参考角色。当出现多个人物时,请指明要替换的引导主体,否则可能会选择视觉上最突出的人物。 - 保持输出宽高比和帧数与引导片段一致,并在较短片段上测试后再运行较长的片段。
body_swap: Replace the man in the guide video with the character in <Picture 1> while preserving his pose, motion, clothing layout, camera and background.捆绑的工作流包含一个 Planner 节点,用于拆分较长的源片段,该节点是可选的:ComfyUI 自带的视频加载器可以直接向 Add Guide 输入。当需要保留源音轨时,音频条件需要在 BFS Shot H3 Conditioning 节点上设置 with_audio = true。作者还记录了将角色替换与更早的 Head Swap LoRA 结合使用的方法,因为两者都是使用引导 latent 训练的,并指出在某些情况下这可能有助于唇形同步,但尚未大规模测试。
限制条件也说得直白。这是一个实验性 LoRA,并非保证身份迁移的系统:在小脸、遮挡、快速运动、困难角度、光照变化和长片段中,身份可能会漂移;该模型面向人物和类人角色;并且它可能会虚构部分参考图像中不可见的细节。角色替换工作流需要 H3 ref2va checkpoint 以及作者自己的 BFS Shot 节点(BFSShotPlanner、BFSShotH3ConditioningSimple、BFSShotUnpack / Join / Repack),此外还需要 BiRefNetRMBG、VideoHelperSuite 等社区包,它们建立在核心 H3 节点之上。
仓库中的一个角色替换示例。
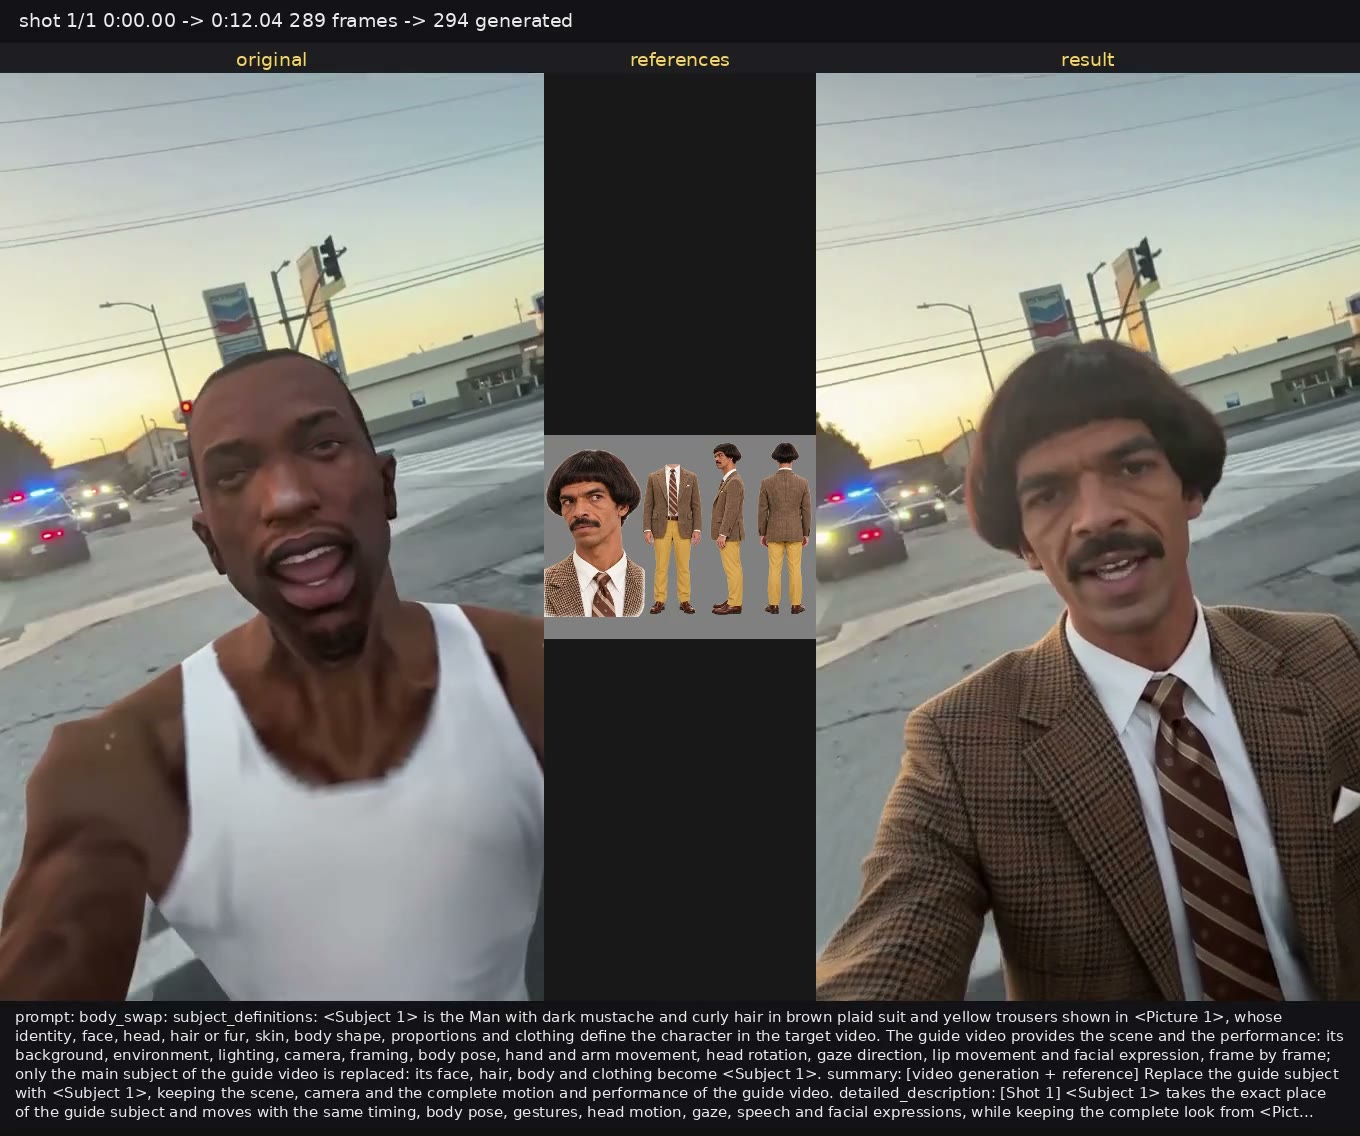 | 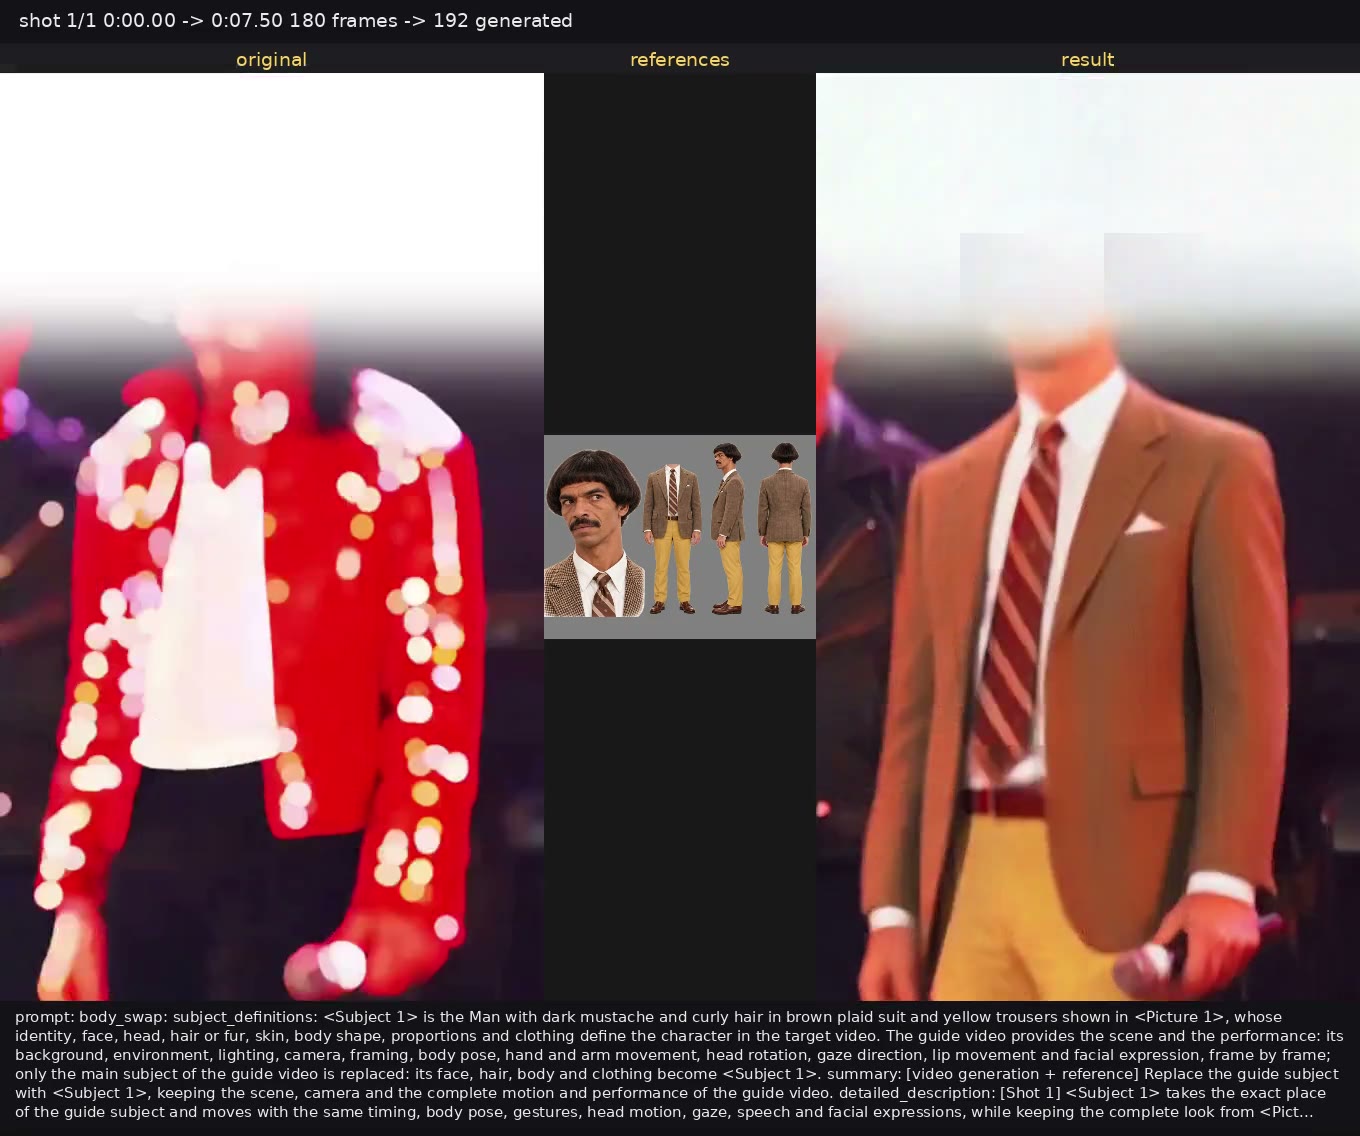 |
|---|---|
| 另一个示例片段 | 第三个示例片段 |
Live Wallpaper
Live Wallpaper 可为一幅现有图像添加动画,并尽量保留其主体和构图。仓库发布了两个 rank,指南解释了何时使用哪个:r32 在描述主体运动、环境运动和效果但没有任何相机标签的字幕上训练到第 1,500 步,在某些情况下可以更忠实地保留面部特征;r64 从该第 1,500 步 checkpoint 继续训练到第 2,500 步,使用相机感知字幕,是当相机必须跟随提示词时推荐的版本。
输入方案使用 H3 原生的参考生视频路径:<Picture 1> 为必填,用于定义主体和构图;<Picture 2> 作为可选的中间帧;<Picture 3> 作为可选的结束帧。额外的引用必须按相同顺序连接到第一遍和第二遍中的 MiniMax H3 Reference to Video 节点,并且提示词应将它们描述为一个连续的动画,而不是分开的场景。
每个提示词都以 live_wallpaper: 开头,保持为一个简洁的句子,并以明确声明主体和构图被保留作为结尾。指南要求每次都给出相机指令,并推荐使用固定机位,而不是让相机行为保持未指定:
live_wallpaper: Animate <Picture 1> with a locked-off camera with no zoom, pan, tilt, tracking, or reframing, plus gentle hair movement and existing lights softly pulsing, while preserving the original subject and composition.live_wallpaper: Animate <Picture 1>, using <Picture 2> as the midpoint and <Picture 3> as the ending frame, with the camera gradually pulling back as the visible energy expands, swirls, and softly fades, while preserving the original subject and composition.仓库发布了 r64 续训背后的字幕分布。在 295 条相机感知记录中,156 条(52.9%)描述固定机位,44 条(14.9%)描述轻微漂移,20 条(6.8%)描述缓慢放大,其余涵盖倾斜、平移和组合运动。最常见的运动词是 swirling(104)、floating(103)和 pulsing(88),最常见的效果类别是光、辉光或微光(170)、能量或光环(65)以及花瓣、树叶或植被(56)。指南指出,这些计数描述的是训练数据,而不是保证的生成比例。
仓库中的一个 Live Wallpaper 示例。
一个 r64 示例片段,即相机感知 rank。
可用性
从仓库下载这些 LoRA,并将它们放入 ComfyUI/models/loras/,然后从 workflows/ 文件夹加载匹配的工作流:每个工作流都会列出所需的模型和节点包,且仓库在 docs/ 下为每个模型保留了单独的指南。LoRA 条件本身运行在核心 MiniMax H3 节点上,包括 MiniMaxH3AddGuide 和 MiniMax H3 Reference to Video,而捆绑的示例工作流还会通过社区节点包加载视频、调整帧大小、使用 BiRefNet 生成遮罩并添加标签,因此请安装每个工作流报告为缺失的内容。
评论
使用 GitHub 登录后即可参与讨论。