FluxSR:面向 Flux.1-dev 的一步式 4x 超分辨率 LoRA
FluxSR 发布面向 Flux.1-dev 的一步式 4x 真实世界超分辨率 LoRA,并附带训练与推理代码以及现成的社区 ComfyUI 节点包。
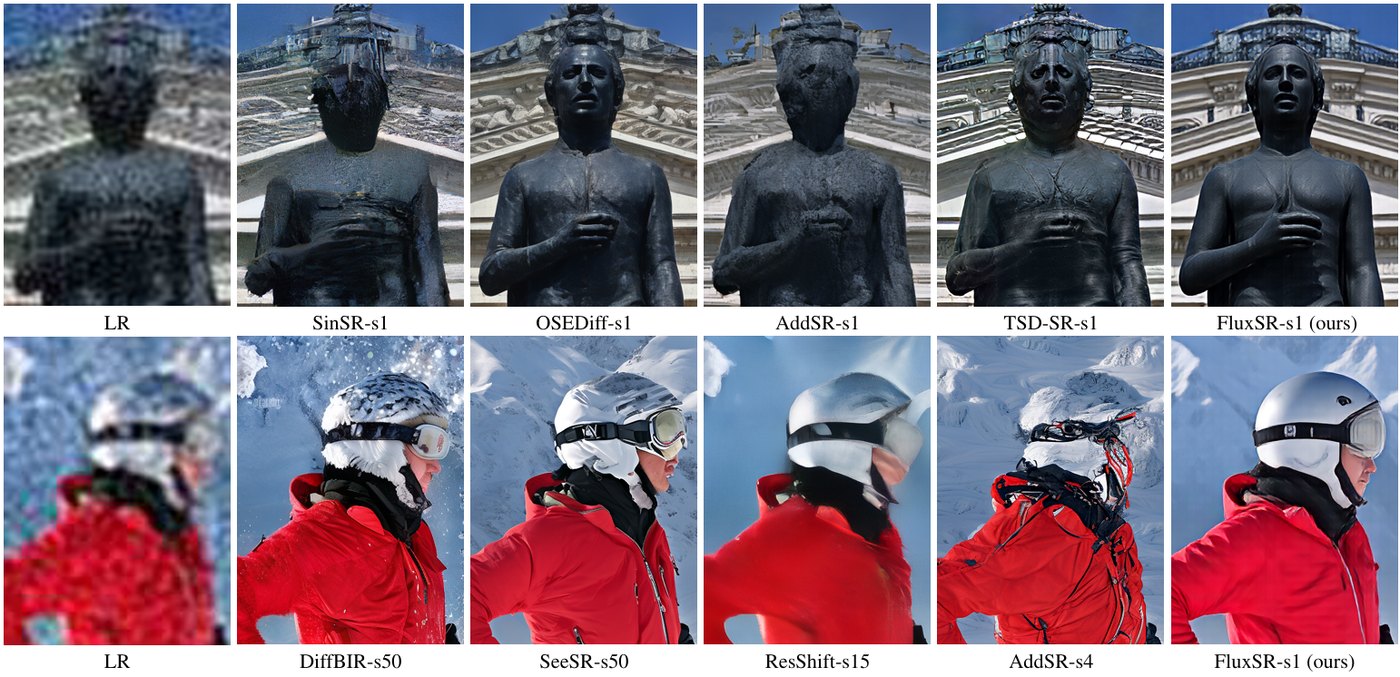
来自项目仓库:FluxSR 的重建结果与其他一步式和多步式超分辨率方法并列对比。
FluxSR 能做什么
多步 diffusion 超分辨率结果准确但速度慢,而更早的一步式变体会继承其蒸馏来源教师模型的伪影。FluxSR 将 Flux.1-dev 同时作为教师模型和基础模型,并在其之上增加了三个部分:
- **流轨迹蒸馏(Flow Trajectory Distillation,FTD)**把多步 flow-matching 模型蒸馏为单次采样步骤,因此一次 transformer 前向即可生成 4x 图像。
- TV-LPIPS 用全变分加权的变体替代普通的感知损失,论文用它把重建结果推向真实纹理,而不是平滑的平均值。
- **注意力多样化损失(Attention Diversification Loss,ADL)**是一种正则化项,用于降低 transformer 内部的 token 相似度,而这通常正是一步式输出中高频散斑的来源。
最终成果以 LoRA adapter 而非完整 checkpoint 的形式发布。该 adapter 大小为 717 MB,rank 与 alpha 均为 64,推理在 timestep 350、引导 4 下运行,这些参数均读取自随附的 training_config.json。
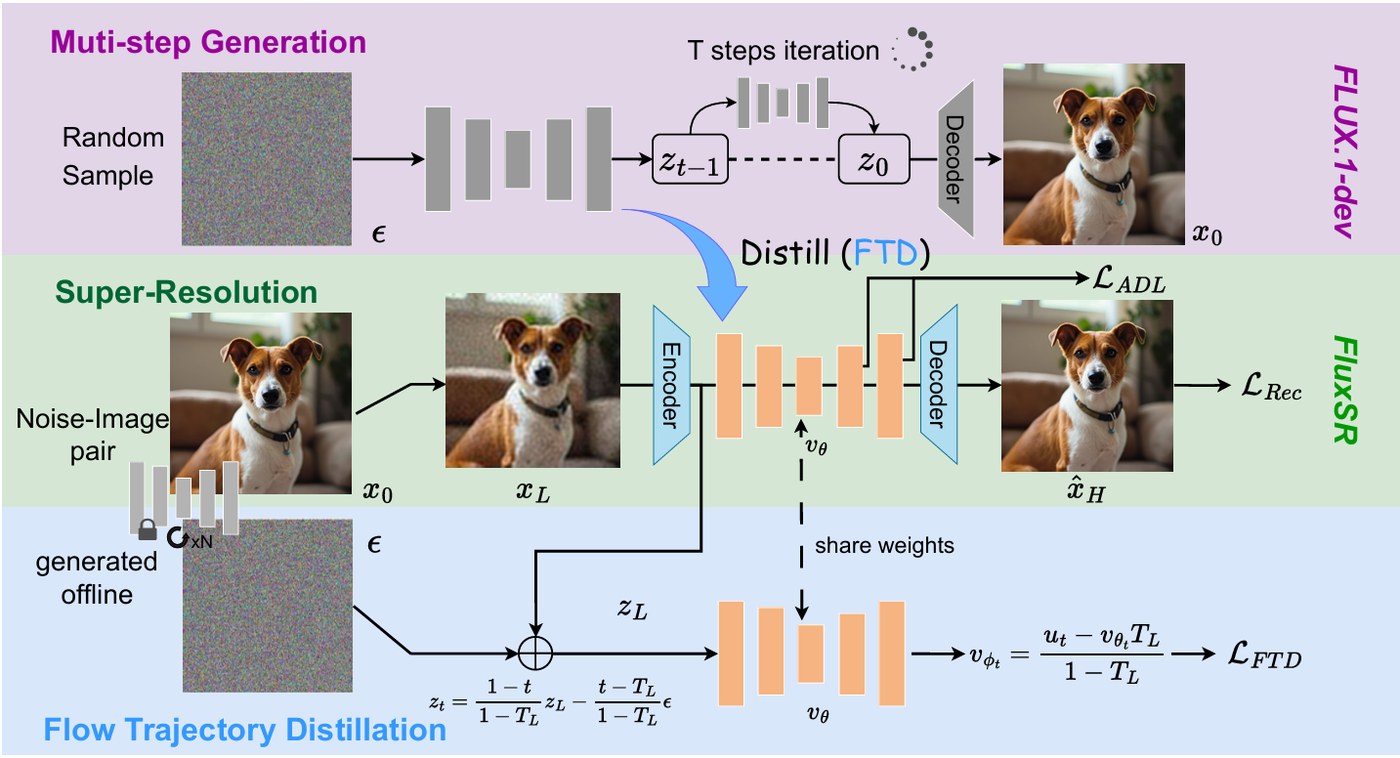
FluxSR 训练流程:Flux.1-dev 教师模型生成训练图像对,LoRA 学生模型通过 TV-LPIPS 和 ADL 蒸馏为单步。
发布内容
| 文件 | 说明 |
|---|---|
pytorch_lora_weights.safetensors | FluxSR transformer LoRA adapter(717 MB) |
training_config.json | 推理时使用的 timestep、引导以及 LoRA rank/alpha |
t5_embedding.pth、clip_embedding.pth | 该 adapter 所需的固定文本 embedding |
prompts_10k.json | 用于生成训练图像对的 10,000 条提示词 |
该仓库记录的不只是推理,而是完整流程。训练数据由 Flux.1-dev 教师模型以 50 步、引导 3.5 生成,保存配对的噪波、教师 latent、解码图像和种子;当有真值可用时,scripts/evaluate.py 会针对真值报告 PSNR、SSIM、LPIPS、DISTS 和 MUSIQ。
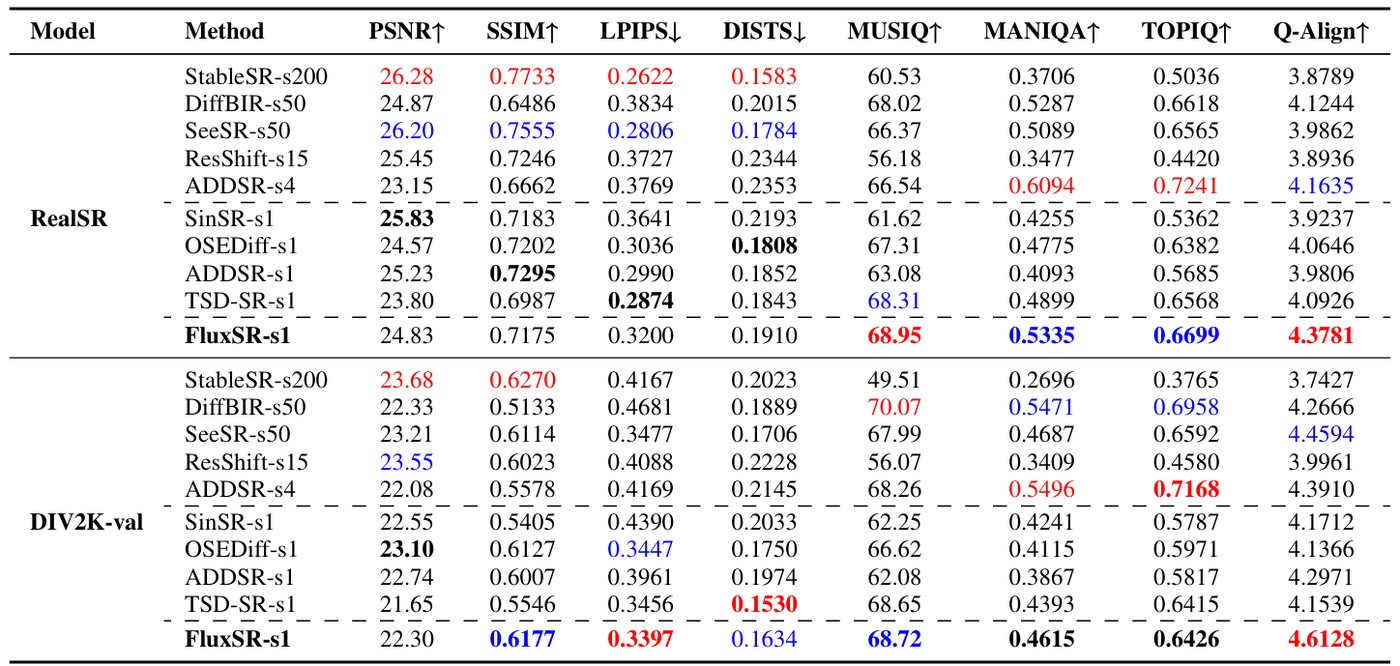
论文表 1:与其他真实世界超分辨率方法的定量对比。
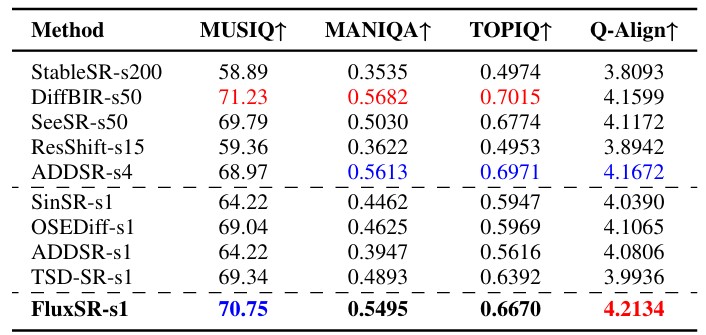
论文表 2 报告了在 RealSet65 上的同样对比。
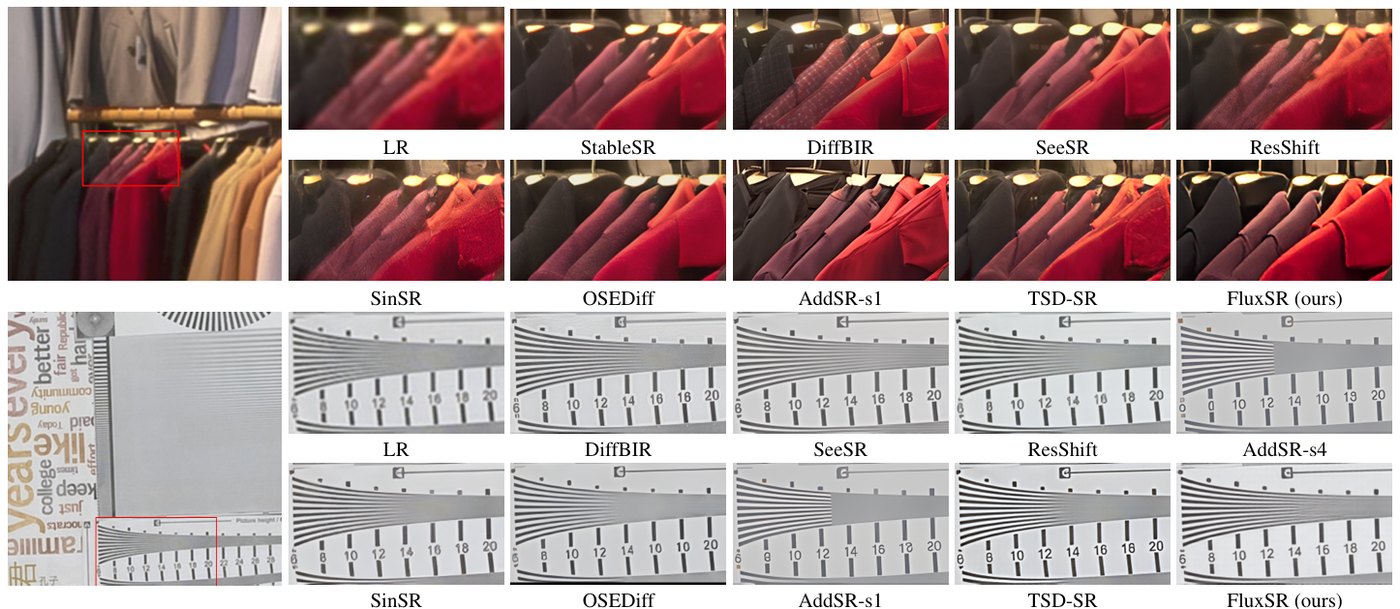
论文中的定性对比:FluxSR 与其他超分辨率方法在真实世界低分辨率输入上的对比。
在 ComfyUI 中运行
该项目本身并未附带 ComfyUI 节点,但同一天就出现了一个社区节点包。JohnDopamine 于 2026 年 10 月 13 日在 Banodoco #flux 通道发布了 FluxSR 节点包(版本 1.0.1 修复了 T5 和 CLIP embedding 路径),并报告了在一台约 84 GB 可用显存的机器上的两次运行结果:
| 输入 | 输出 | 时间 |
|---|---|---|
| 446 x 448 | 1784 x 1792 | 3.18 s |
| 688 x 864 | 2752 x 3456 | 34.91 s |
该节点包使用 Flux.1-dev 加 LoRA 以及 Hugging Face 包中的两个固定 embedding 文件运行,因此任何已经能运行 Flux.1-dev 的环境都能运行它。针对更大的输入提供批处理与分块(tiled)模式,推理脚本还提供 --offload sequential 和 --vae-tiling,以适配更低内存的配置。
该节点包目前以 zip 形式存在于社区通道中,而不是放在仓库里,因此需要手动安装。
可用性
LoRA 权重、固定 embedding 和训练提示词位于 Hugging Face,训练、推理与评估代码位于 GitHub。基础 Flux.1-dev 权重需在接受其访问条件后单独下载。
评论
使用 GitHub 登录后即可参与讨论。