Spark-H3:块稀疏注意力加速 ComfyUI 中的 MiniMax-H3
Spark-H3 把 Spark-Attn 块稀疏注意力带入 ComfyUI 的 MiniMax-H3:为 RTX 40 和 50 系列提供预构建节点,并在 10% 密度下实现快 1.73 倍的 DiT。
来自项目仓库:相同的提示词、种子与调度,分别使用稠密注意力、10% 密度的 Spark-H3 与 Sol-H3 渲染。
Spark-Attn 改变了什么
块稀疏注意力将一次视频注意力计算拆分为两个分支:一个精确分支完整计算排名最高的 key/value 块,另一个压缩分支以低成本覆盖其余部分。Spark-Attn 重做了这两部分,而 Spark-H3 是它在 MiniMax-H3 上的实现。技术博客发布于 2026-09-23,最后更新于 2026-10-08。
- Spark-Reblock 用自适应划分取代固定的时空瓦片。当两个 query 在 key 上产生相似的注意力分数模式时,就认为它们相似,相似度由对侧二阶矩导出的马氏余弦距离来度量。分层划分器不断切分组,直到每个叶子都达到目标块大小,整个过程耗时
O(N log N),因此块布局会随输入、层和注意力头变化,而不是固定的邻域。 - Spark-Reweight 用加权摘要加对数质量偏置取代压缩分支的均值池化 key/value 摘要。均值池化会低估注意力质量,因为注意力在归一化之前会对 logits 取指数:它用
exp(E[x])替代了E[exp(x)]。该偏置补回缺失的质量,打分时使用视频 query 的均值作为每个注意力头的一个锚点,因此额外开销保持线性。
两部分都在 10% Top-K 预算下单独测量:
| 消融 | 注意力质量召回率 | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| 固定块划分 | 68.66% | 18.61 | 0.68 | 0.26 |
| + Spark-Reblock | 81.54% | 22.41 | 0.80 | 0.14 |
压缩分支方面:
| 消融 | 绝对对数质量误差(nats) | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| 均值池化 | 3.86 | 18.61 | 0.68 | 0.26 |
| + Spark-Reweight | 2.78 | 19.17 | 0.70 | 0.24 |
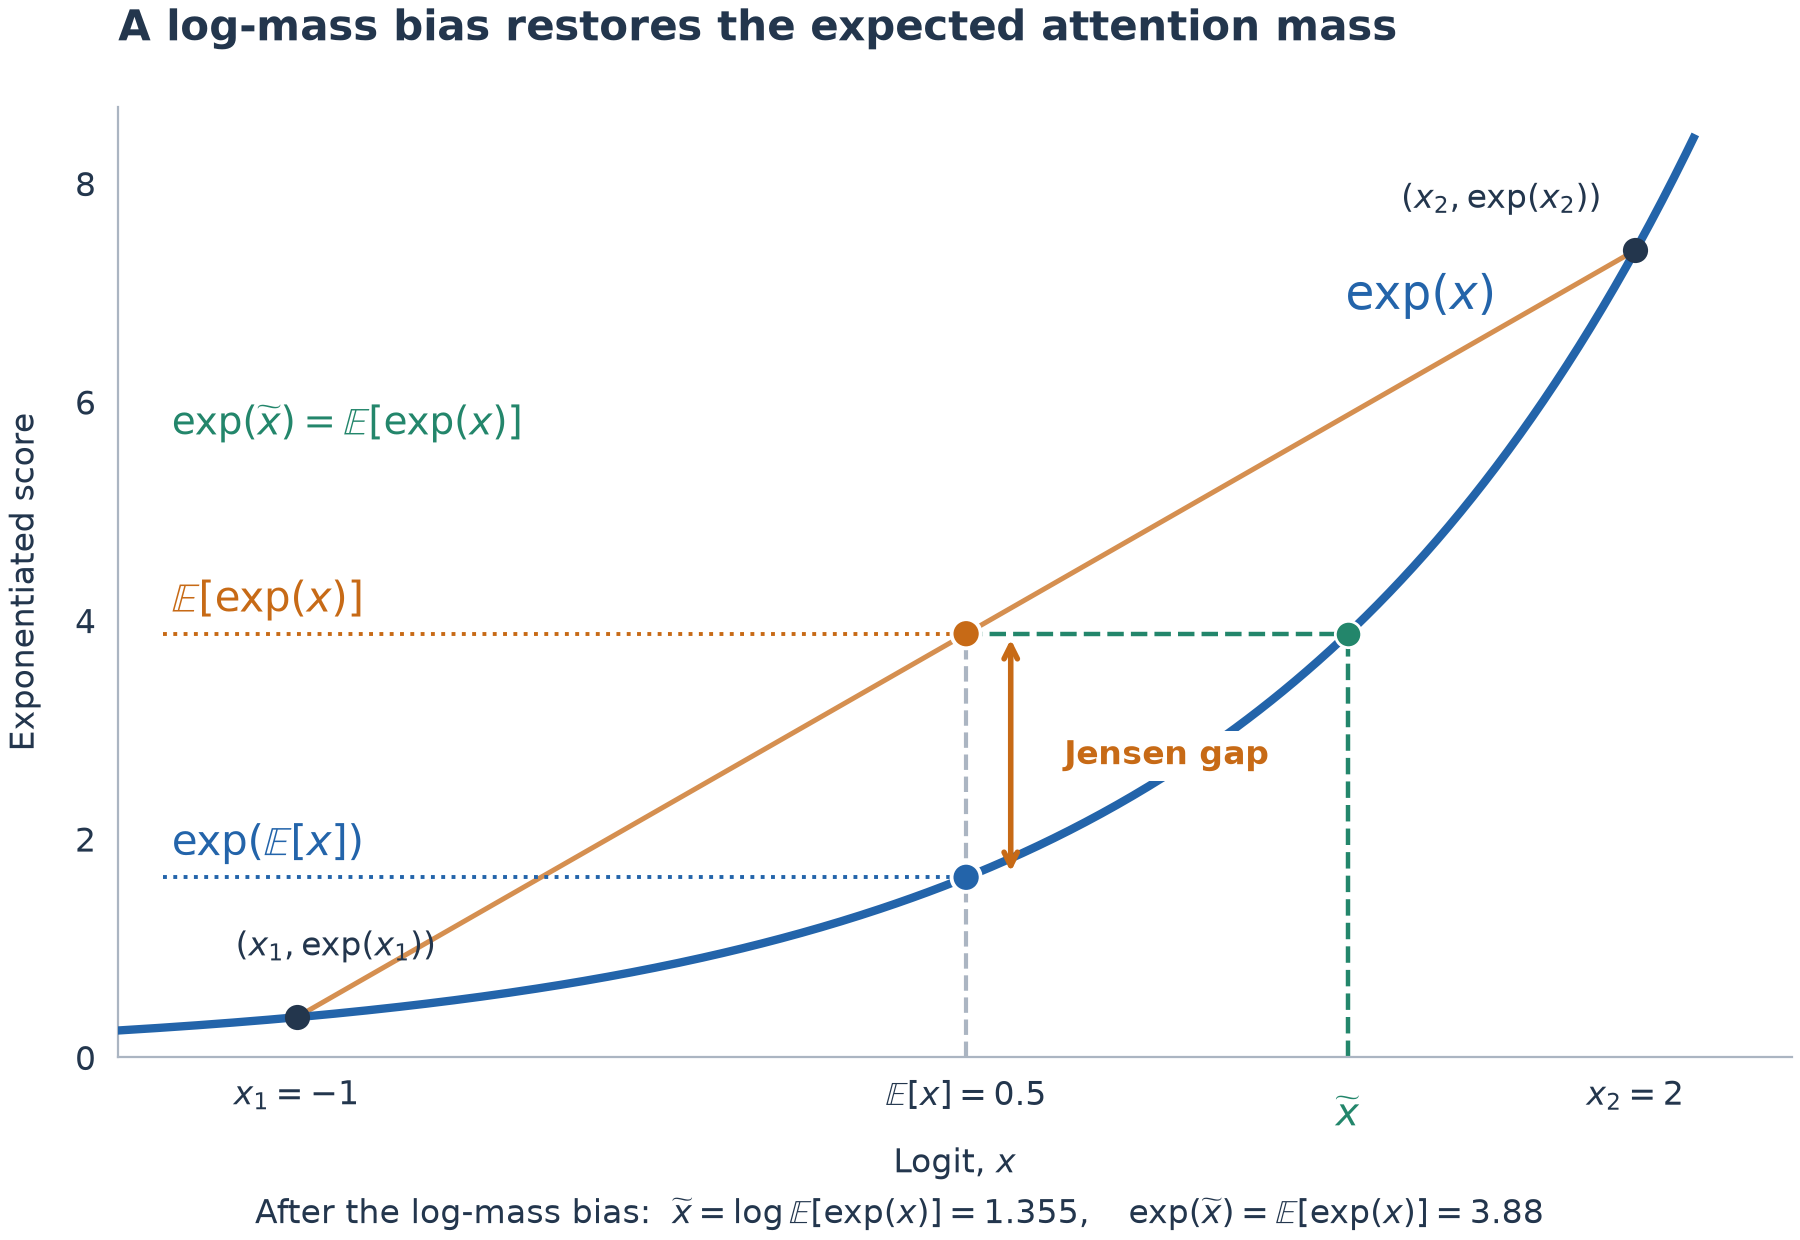
均值池化得到 exp(E[x])(图中蓝色),低于期望的指数值 E[exp(x)](图中橙色)。绿色点是加入对数质量偏置后的有效池化 logit,其指数值与期望指数一致。
基准测试
对比数据在单张 RTX PRO 6000 Blackwell 上,使用 VBench 提示词,分辨率 1344x768、240 帧、24 fps,以及 19 步 MiniMax-H3 调度。这里每种稀疏方法都共享 20% 的稠密预热,第一个 Transformer 层始终保持稠密,并与相同提示词和种子产生的稠密输出进行比较。
| 方法 | 密度 | DiT 延迟 | DiT 加速 | PSNR | SSIM | LPIPS | ATTN 加速 |
|---|---|---|---|---|---|---|---|
| 稠密 | 100% | 583.3 s | 1.00x | 引用 | 1.00 | 0.00 | 1.00x |
| Sol-H3 | 动态 | 355.4 s | 1.64x | 20.36 | 0.71 | 0.20 | 2.19x |
| Spark-H3,速度 | 10% | 337.4 s | 1.73x | 23.30 | 0.80 | 0.14 | 2.33x |
| Spark-H3,均衡 | 20% | 371.1 s | 1.57x | 25.38 | 0.85 | 0.09 | 1.96x |
| Spark-H3,保真 | 30% | 404.1 s | 1.44x | 27.07 | 0.88 | 0.07 | 1.76x |
| Spark-H3-Lite,速度 | 10% | 330.2 s | 1.77x | 23.34 | 0.80 | 0.14 | 无 |
在 10% 密度下,Spark-H3 相比 Sol-H3 提升 2.94 dB PSNR,同时运行还略快一些;而提高密度则会以速度换取保真度,这一权衡呈单调关系。Spark-H3-Lite 是更轻量的变体,将重分块延迟减半,代价是在 20% 和 30% 密度下有少量保真度损失。在 VBench 各维度上,每种 Spark-H3 变体在主体与背景一致性、运动平滑度、成像质量和美学质量方面都保持在稠密结果约 0.3 分以内。
ComfyUI 节点
该包为 ComfyUI 自带的 MiniMax-H3 实现新增两个注意力节点:MiniMax H3 Spark Attention (SM89) 和 MiniMax H3 Spark Attention (SM120)。把其中一个接在模型加载器与 BasicGuider 之间的 MODEL 连线上,且每个模型只应应用一个注意力补丁。画面中的其他部分保持不变,因此它能与示例所用的社区 LoRA 叠加使用。
| 要求 | 值 |
|---|---|
| ComfyUI | 0.38.x 或 0.39.x |
| Python | 3.12+ |
| PyTorch / CUDA | CUDA 13.0,BF16 |
| 操作系统 | Linux 或 Windows x86_64 |
| SM89 | GeForce RTX 40 系列 |
| SM120 | GeForce RTX 50 系列、RTX PRO 5000 / 6000 Blackwell |
安装器会为你所用的 ComfyUI 选择匹配的后端:0.38.x 上使用 comfy-kitchen 0.2.36,0.39.x 上使用 0.2.37。v0.1.2 版本新增了经过验证的 Windows 安装包,并更新了随附工作流与安装文档;CUDA 12.8 只能通过源码构建路径获得。模型文件仍来自 Comfy-Org MiniMax-H3 仓库,ComfyUI 指南也链接了一份中文安装指南。
在 ComfyUI 中端到端运行,同样在 RTX PRO 6000 Blackwell 上,生成 1344x768、时长 14.4 秒的视频片段:
| 变体 | 稠密 | 保真(20%,含预热) | 速度(20%,无预热) |
|---|---|---|---|
| MiniMax-H3,20 步 | 1018.5 s | 461.7 s · 2.21x | 323.3 s · 3.15x |
| MiniMax-H3 + LightX2V 8 步 | 408.0 s | 199.5 s · 2.05x | 129.6 s · 3.15x |
同一段视频中分别使用稠密、保真和速度注意力生成,采用 ComfyUI 原生 MiniMax-H3 工作流。提示词来自 Video DeltaNet 的提示词集。
工作流
发布包附带五个示例工作流,每个都固定 topk_mode=topk_ratio 与 reblock_layout=q_reuse_k。原生、LightX2V、Larryvrh 和 DMAD 示例使用 topk_ratio=0.2;LBH 两遍示例使用 0.1,以匹配 Diffusers 的 h3_lbh 路径。
| 示例 | 配置 |
|---|---|
| 原生 MiniMax-H3 | 核心示例:20 步,无 LoRA,无额外节点 |
| LightX2V 8 步 LoRA | 需要将 LightX2V Turbo LoRA 放入 models/loras |
| Larryvrh 8 步 LoRA | 需要转换后的 LoRA,可用 ComfyUI 自带的 LoraLoaderModelOnly 加载 |
| DMAD 4 步 LoRA | 使用 DMAD 重加噪采样器 |
| LBH 两遍 + LightX2V 4 步 | 需要官方 LBH 放大节点及其 latent 放大模型 |
该包不会静默安装这些额外的 LoRA:它们保留在 models/loras 下,是否使用由你决定。用于 Larryvrh 权重的转换脚本保留了 208 个主干 LoRA,并把 51 个 AdaLN 更新投影到剪枝模型八维时间步曲线上。
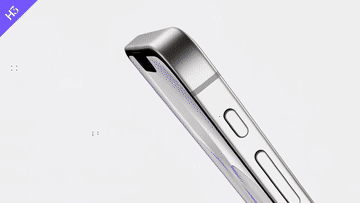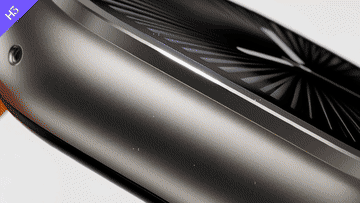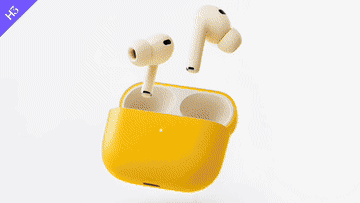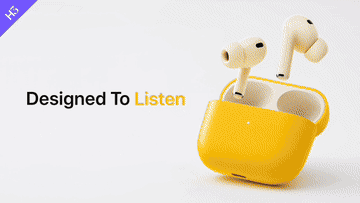
使用 Spark-H3 后端渲染的极简产品广告提示词,来自项目仓库的示例集。
获取方式
Spark-H3 位于 github.com/zechengtang/Spark-H3,纯代码镜像在 Aazeus/Spark-H3,技术文章在 zechengtang.github.io/Spark-H3。它是推理后端而非 checkpoint,因此不重新分发模型权重,Spark-H3 可以与现有的 H3 LoRA 组合使用。项目路线图将 SM120 验证列为进行中,计划推出不依赖 comfy-kitchen 的独立版本以及 SM90 和 SM100 的内核,技术报告则尚未发布。首个 ComfyUI 版本也还很新,因此打包与路由细节预计还会不断变动。
如果你已经在 MiniMax-H3 上试用过 Veda 稀疏注意力,那篇博客还讨论了 Spark-Attn、Sol-Attn、Veda 与普通块稀疏注意力的差异:Veda 学习一个用于 Top-K 选择的打分器,Sol-Attn 使用内容自适应阈值,而 Spark-Attn 改变了块布局以及未选中块的处理方式。
评论
使用 GitHub 登录后即可参与讨论。