H3 Person Remover LoRA:从视频中删除人物
Akatz Labs 的 Person Remover LoRA 使用 SAM 3.1 跟踪人物,将遮罩填充为绿色并在重叠窗口中重建背景,附带现成的 ComfyUI 工作流。
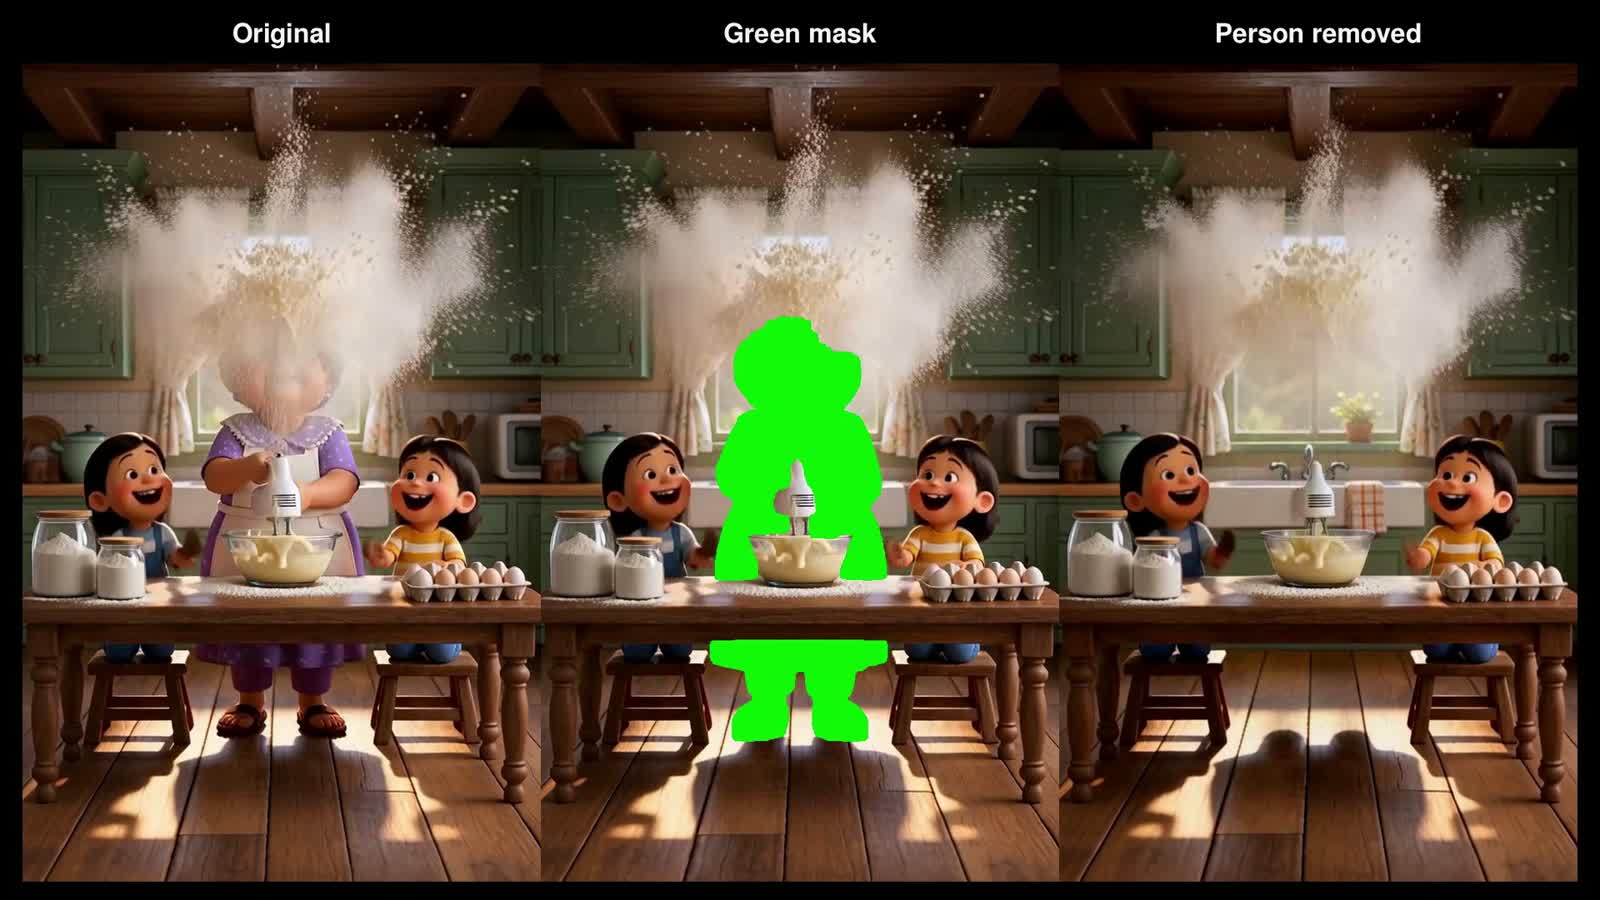
选自包含八个示例的展示:原始片段、绿色遮罩、重建后的背景。
作者的前后对比展示,以 1280 像素宽度重新编码。
该适配器能做什么,不能做什么
该 LoRA 不负责分割人物,也无法自行凭空生成干净的背景。SAM 3.1 会根据诸如 man in gray shirt 这样的文本描述提供跟踪遮罩,而你仍需提供视频首帧的干净版本,也就是已经移除该人物的版本,可以来自图像编辑器或图像编辑模型。接下来由窗口 reroll 工作流完成其余工作:输入带绿色遮罩的帧,H3 重新生成被遮盖的区域,重建后的边界帧则把连续内容带入下一个窗口。
默认移除提示词:
移除被绿色遮罩标记的人物并重建背景。保留视频的其余部分,包括其相机运动和帧时序。
窗口 reroll 的具体参数
该工作流是经过调优的,而非通用配置,记录下来的设置值得照搬:
| 设置 | 值 |
|---|---|
| Scheduler | beta / simple |
| CFG | 1 |
| 视频 / 音频 sigma shift | 12 / 3 |
| 遮罩扩展 | 5 像素 |
| 帧率 | 24 fps |
| 随机种子 | 904234 |
无需 Turbo 或 VFX LoRA。工作流使用 17n + 5 形式的 H3 帧长度(22、39、56、73 ...),并建议从 22 帧开始,因为更长的窗口只会消耗更多内存,而不会自动改善结果。每次续接都使用已生成的边界帧作为下一个引用,并携带 18 帧的已生成视频和音频历史,relay 会移除重叠部分,并将结果裁剪回来源帧数。默认输出是静音的;若要保留配乐,可将「获取视频元素」中的原始音频连接到最终的「创建视频」节点。
输入依赖项有明确要求:24 fps 视频,宽和高可被 32 整除,最好是约五秒钟的短连续镜头。
训练记录
V1 是基于剪枝版 Ref2VA 模型的 rank-16 适配器,在最初的 250 次优化更新(静态五帧对与保留正则化)之后,又进行了 2,000 次优化更新训练。
| 设置 | 记录值 |
|---|---|
| 架构 | minimax_h3_ref2va,剪枝版 |
| Rank / alpha | 16 / 16,不含 adaln_proj |
| 张量 | BF16,416 个张量,分布于 208 个适配器目标 |
| 优化器 / 学习率 | AdamW8bit / 5e-5 |
| 文本编码器 | NVFP4 Qwen3VL |
| 任务 / 正则化分辨率 | 1152 / 256,宽高比分桶 |
| 任务帧长度 | 5、56、73、90、124(24 fps) |
| 正则化长度 | 107 帧(24 fps),含音频 |
| 运行环境 | AI Toolkit 0.13.23,外加一个已记录的对齐视频引导补丁 |
混合阶段的训练池包含 128 个静态配对、来自 20 个场景的 80 个移动遮罩片段,以及六个保留片段。数据集卡片记录了构建、划分和审核状态,training/ 目录则包含配置、调度、模型哈希和运行时补丁。
局限性
Akatz Labs 直言了目前仍会失败的情况:
- H3 会重新生成整个场景,因此即使训练配对保留了遮罩之外的像素,未遮罩区域也并未与原始画面逐像素锁定。
- 被漏掉的手、发丝边缘、阴影、反射或被遮挡的身体部位可能会残留,而更大的遮罩会让模型编造更多背景。
- 质量不佳的干净首帧会一路影响到后续窗口,强烈的相机运动或硬切也会破坏连续性。
- reroll 某个窗口会改变其续接内容,因此重建后的后续部分也需要检查。
- 记录的数据集验收标记仍为 false:通过技术检查并不等同于每个示例都获得人工认可。
获取方式
该工作流需要当前版本的 ComfyUI,并具备原生 MiniMax H3 和 SAM 3.1 支持,同时需要将 H3-Person-Remover-V1.safetensors 放入 models/loras/。发布的工作流固定了 H3 ref2va 剪枝版 INT8 ConvRot transformer、NVFP4 Qwen3VL 文本编码器、H3 视频与音频 VAE,以及 SAM 3.1 multiplex;此前的验证在 RTX 4090 搭配 ComfyUI 0.37.0 上运行,作者称这是一套经过测试的配置,而非最低规格要求。H3 Relay 提供了工作流所使用的窗口预览和 reroll 控件。
评论
使用 GitHub 登录后即可参与讨论。