Qwen-Image 2.1 恢复 LoRA:让放大后的图像保持原貌
一款面向 Qwen-Image 2.1 的社区 LoRA,能让恢复或放大后的照片保持原始构图:偏移仅 0.3 px,未使用时为 2.2 px,另附 ComfyUI 工作流和两个模型。
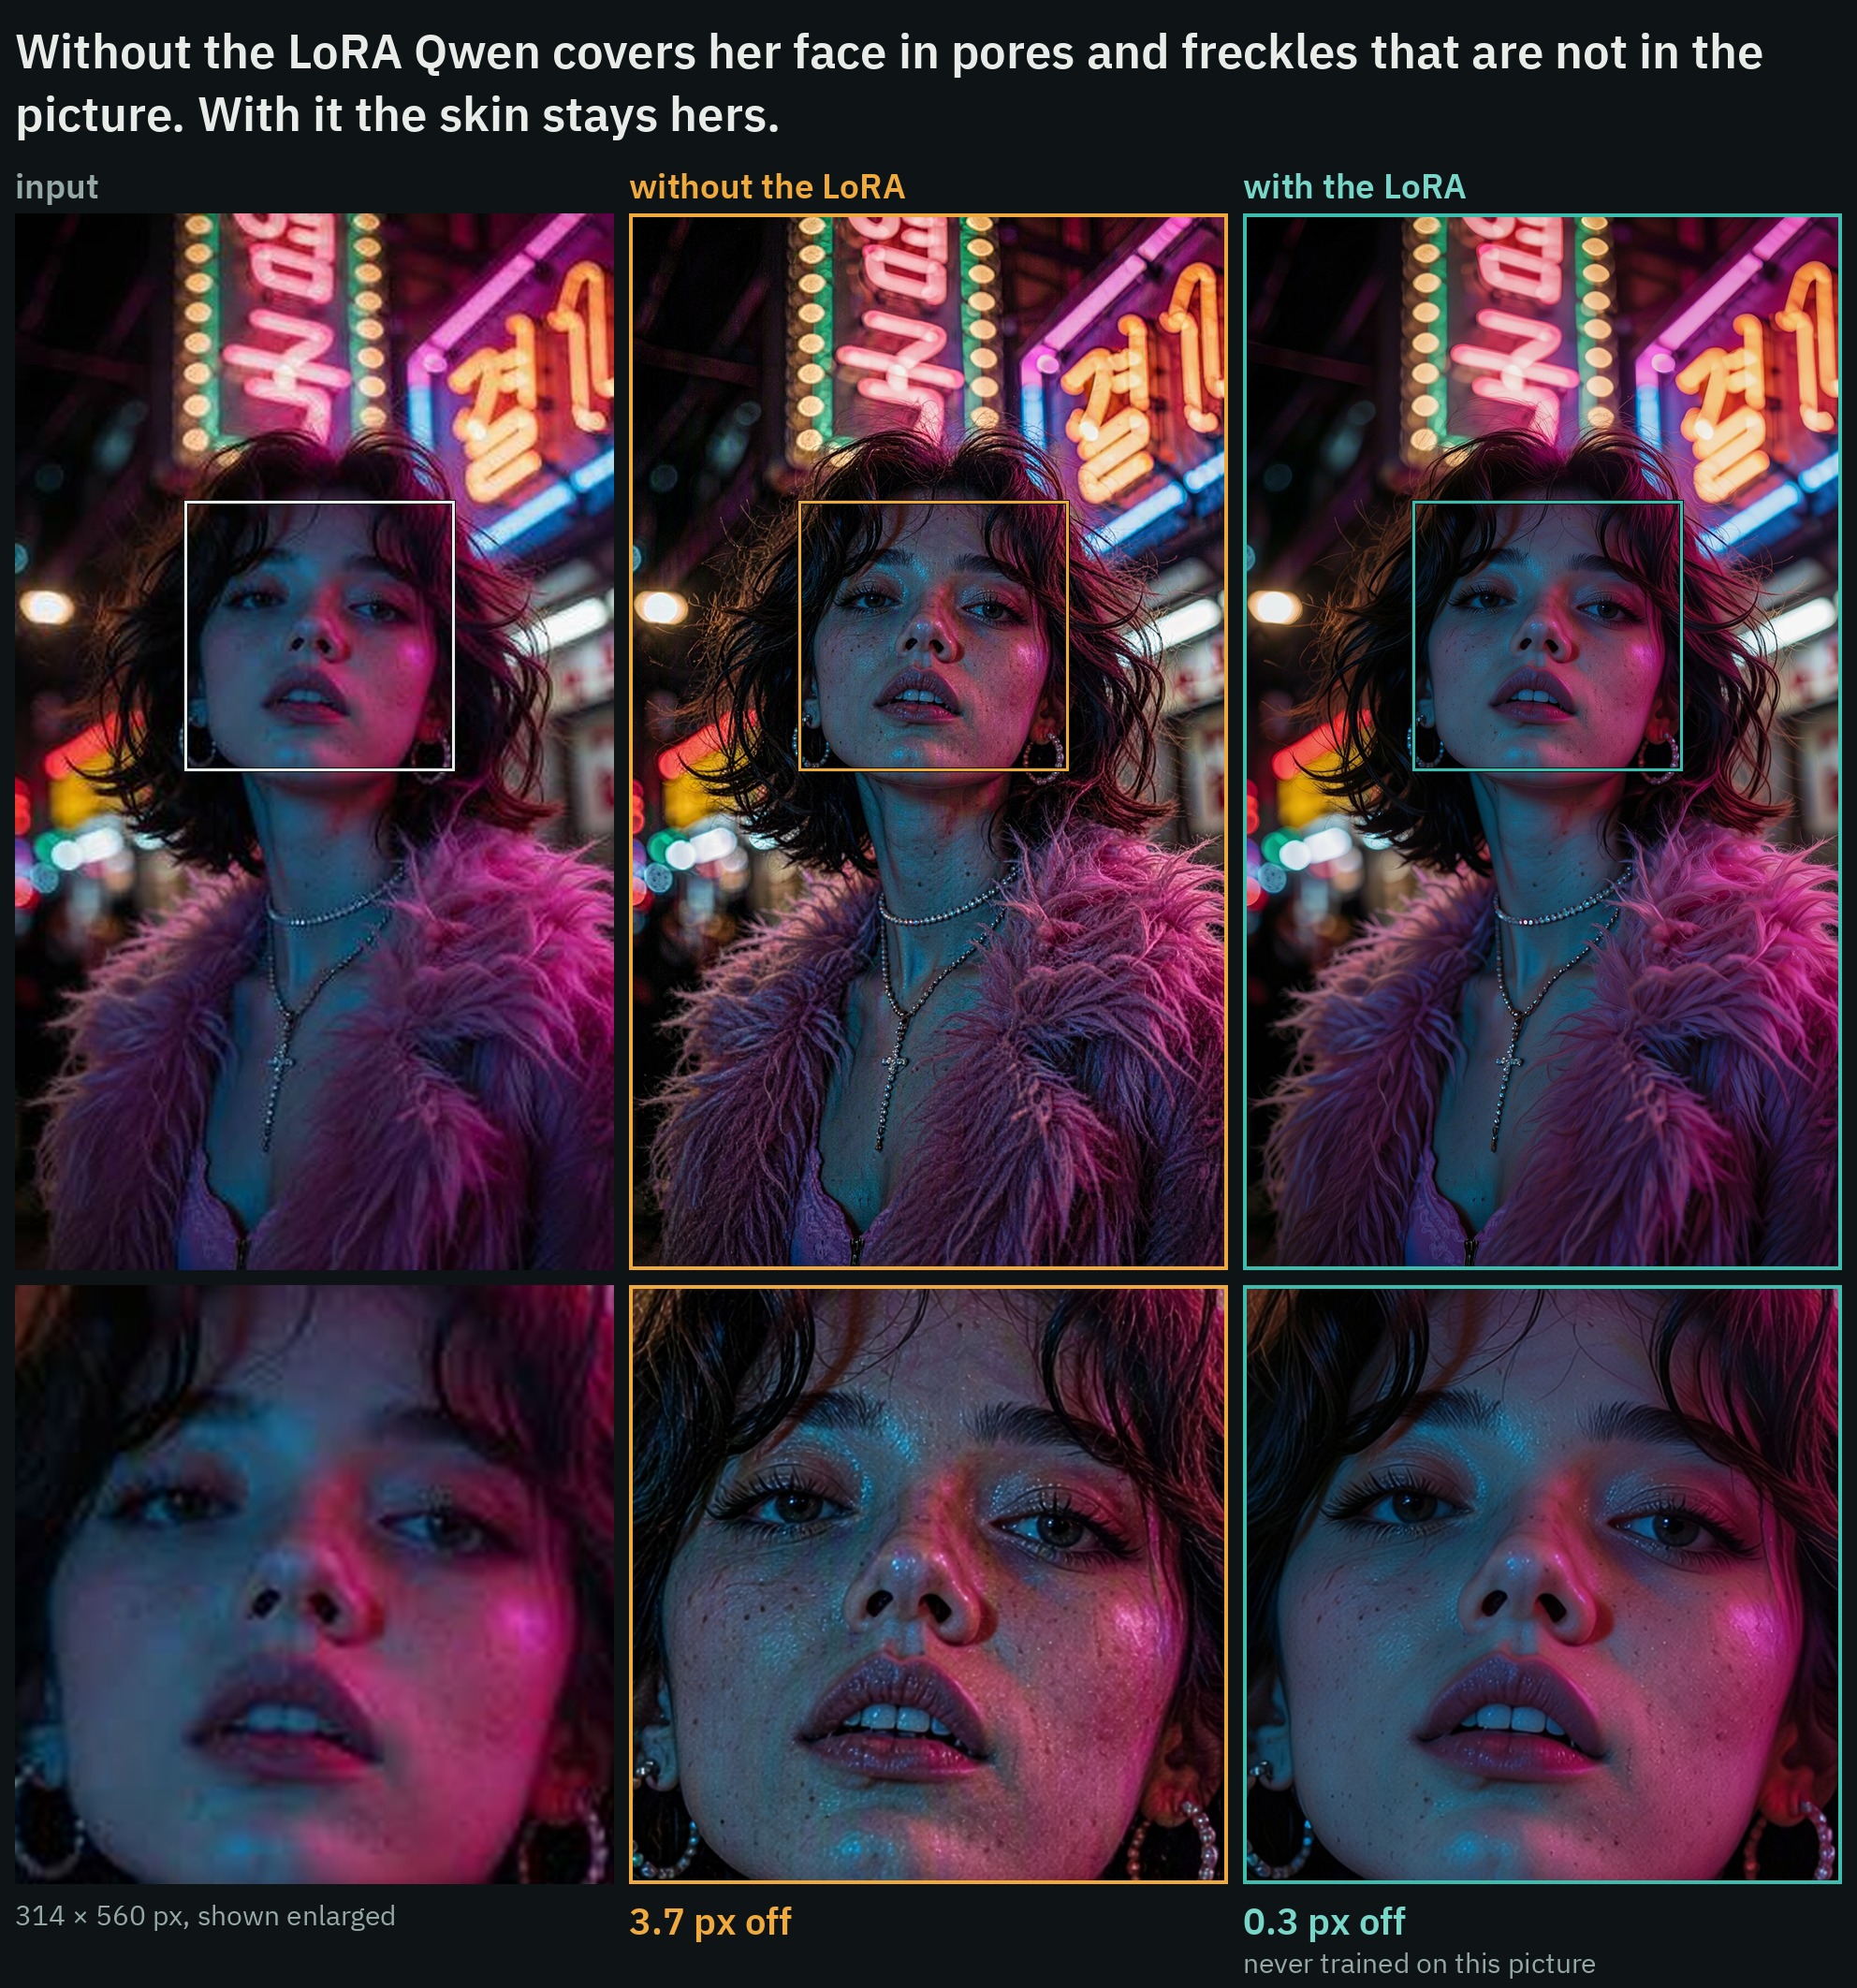
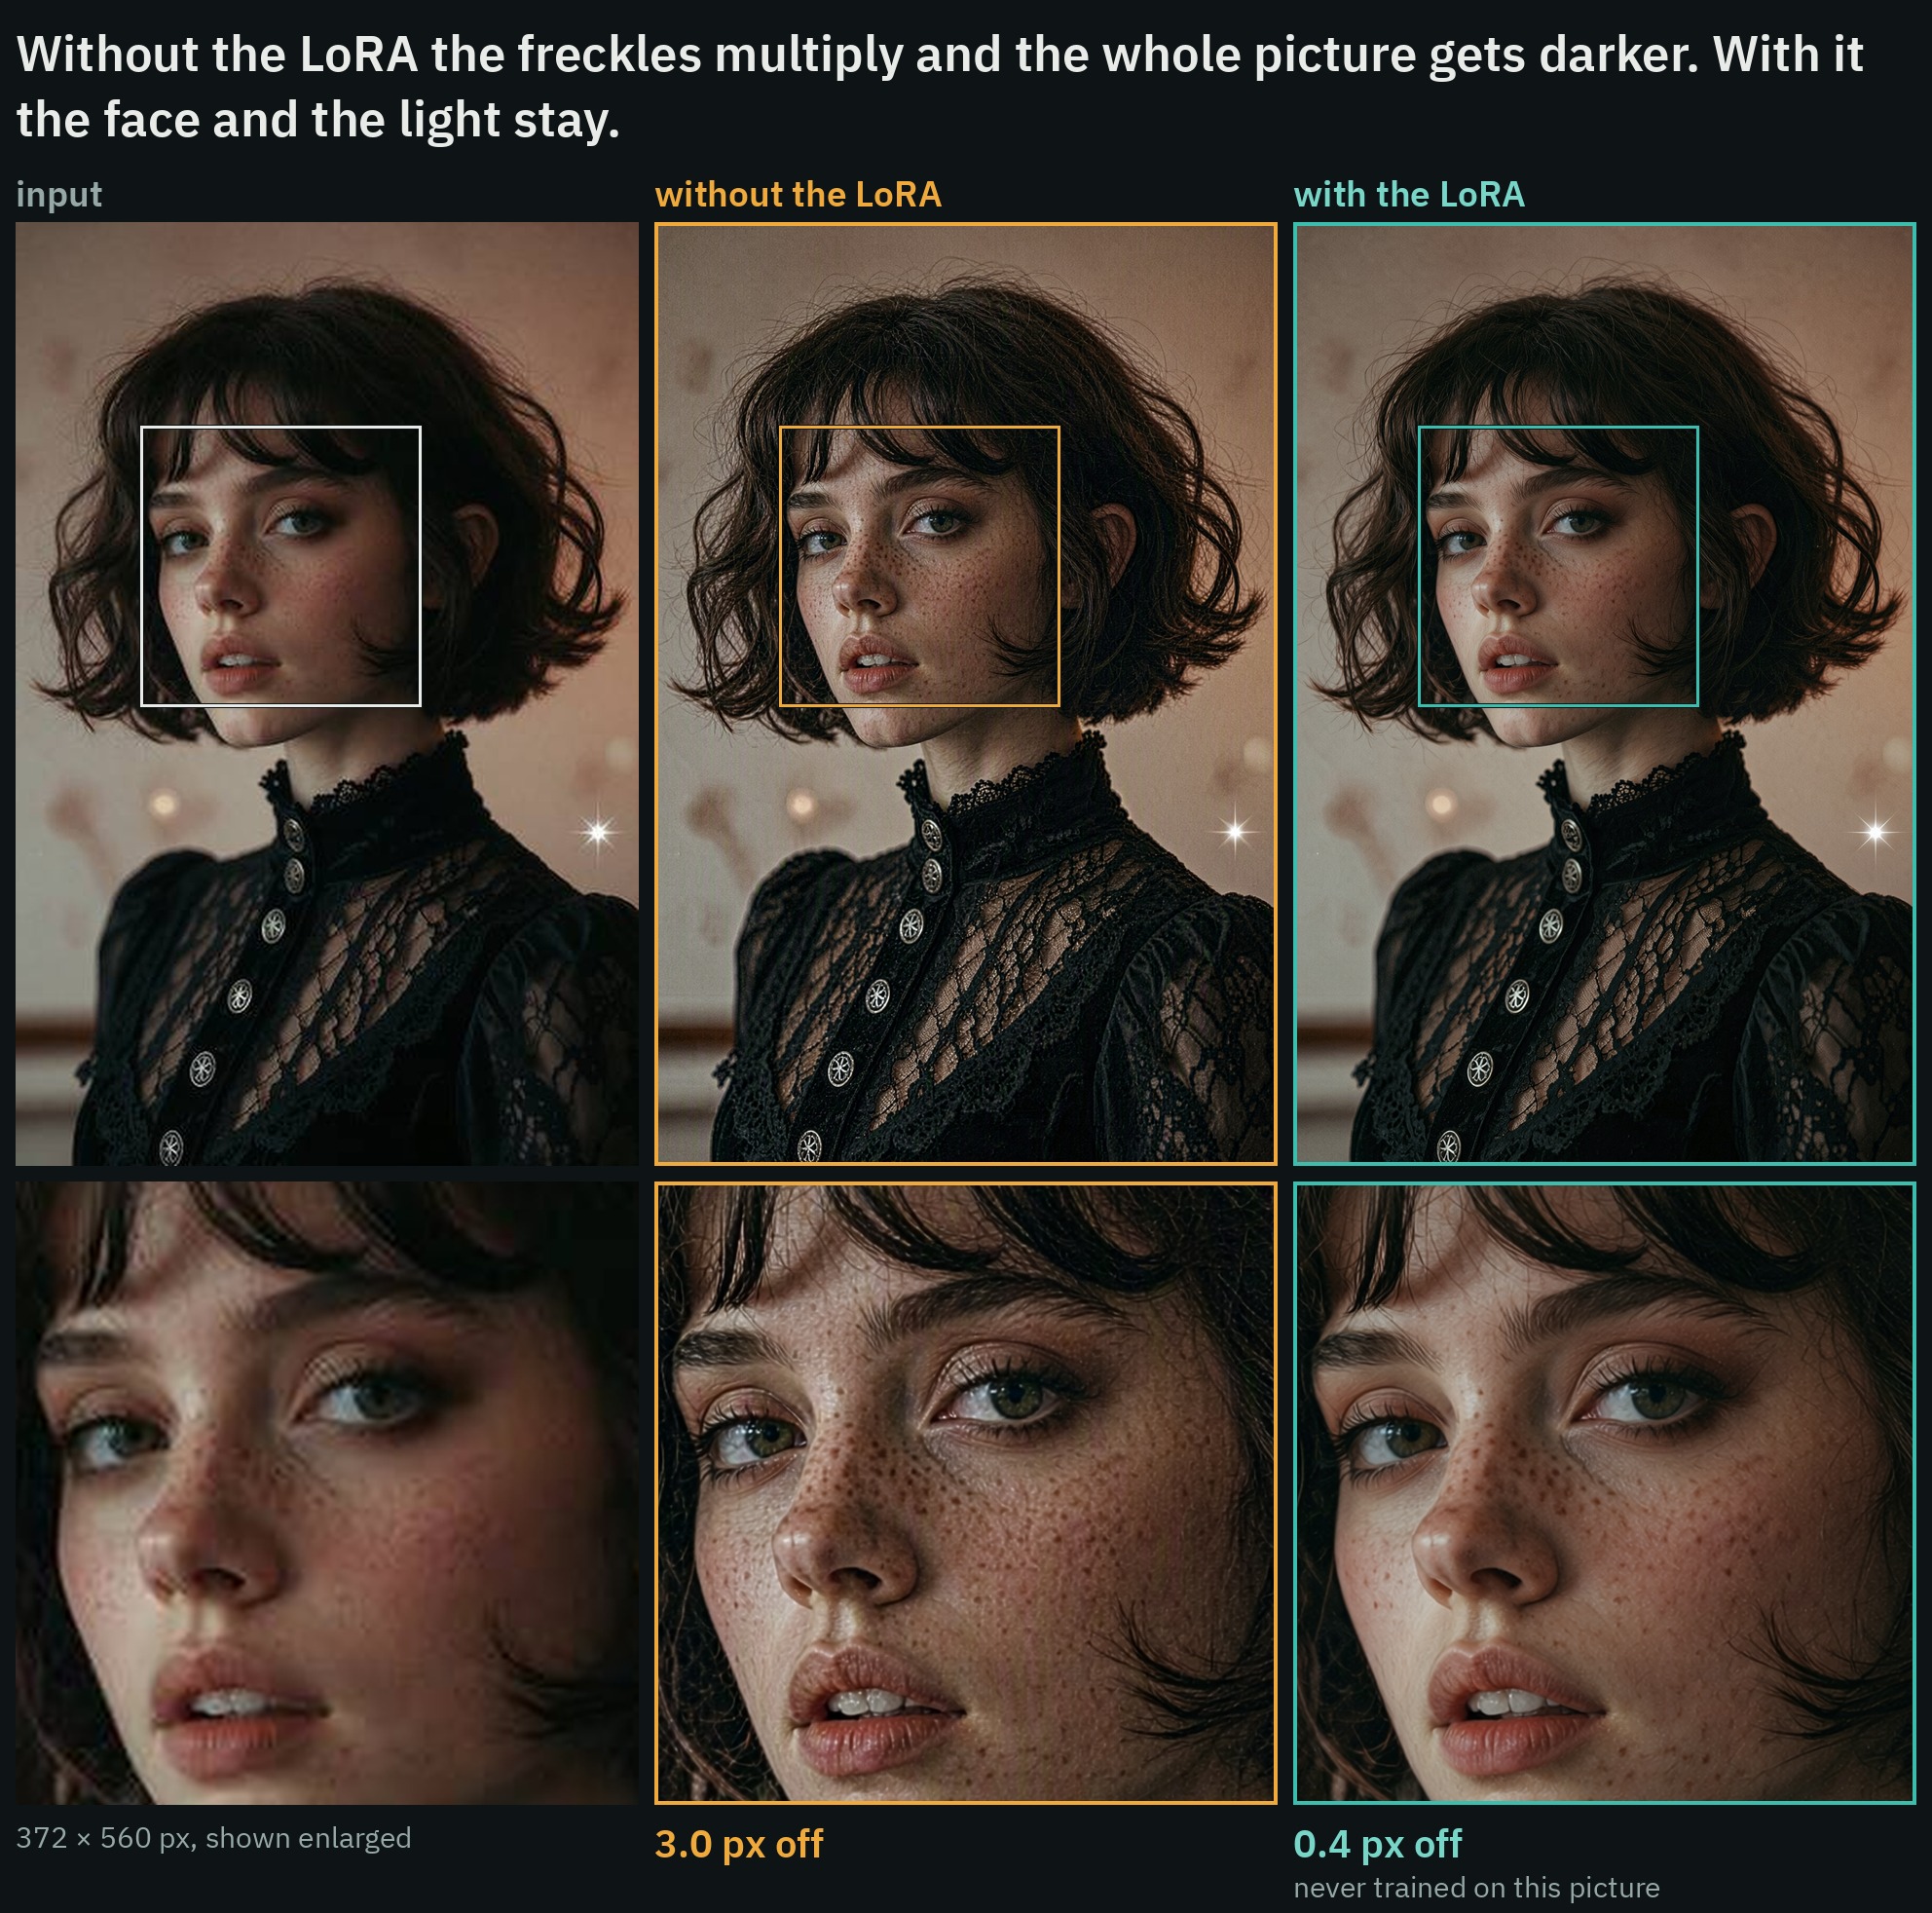
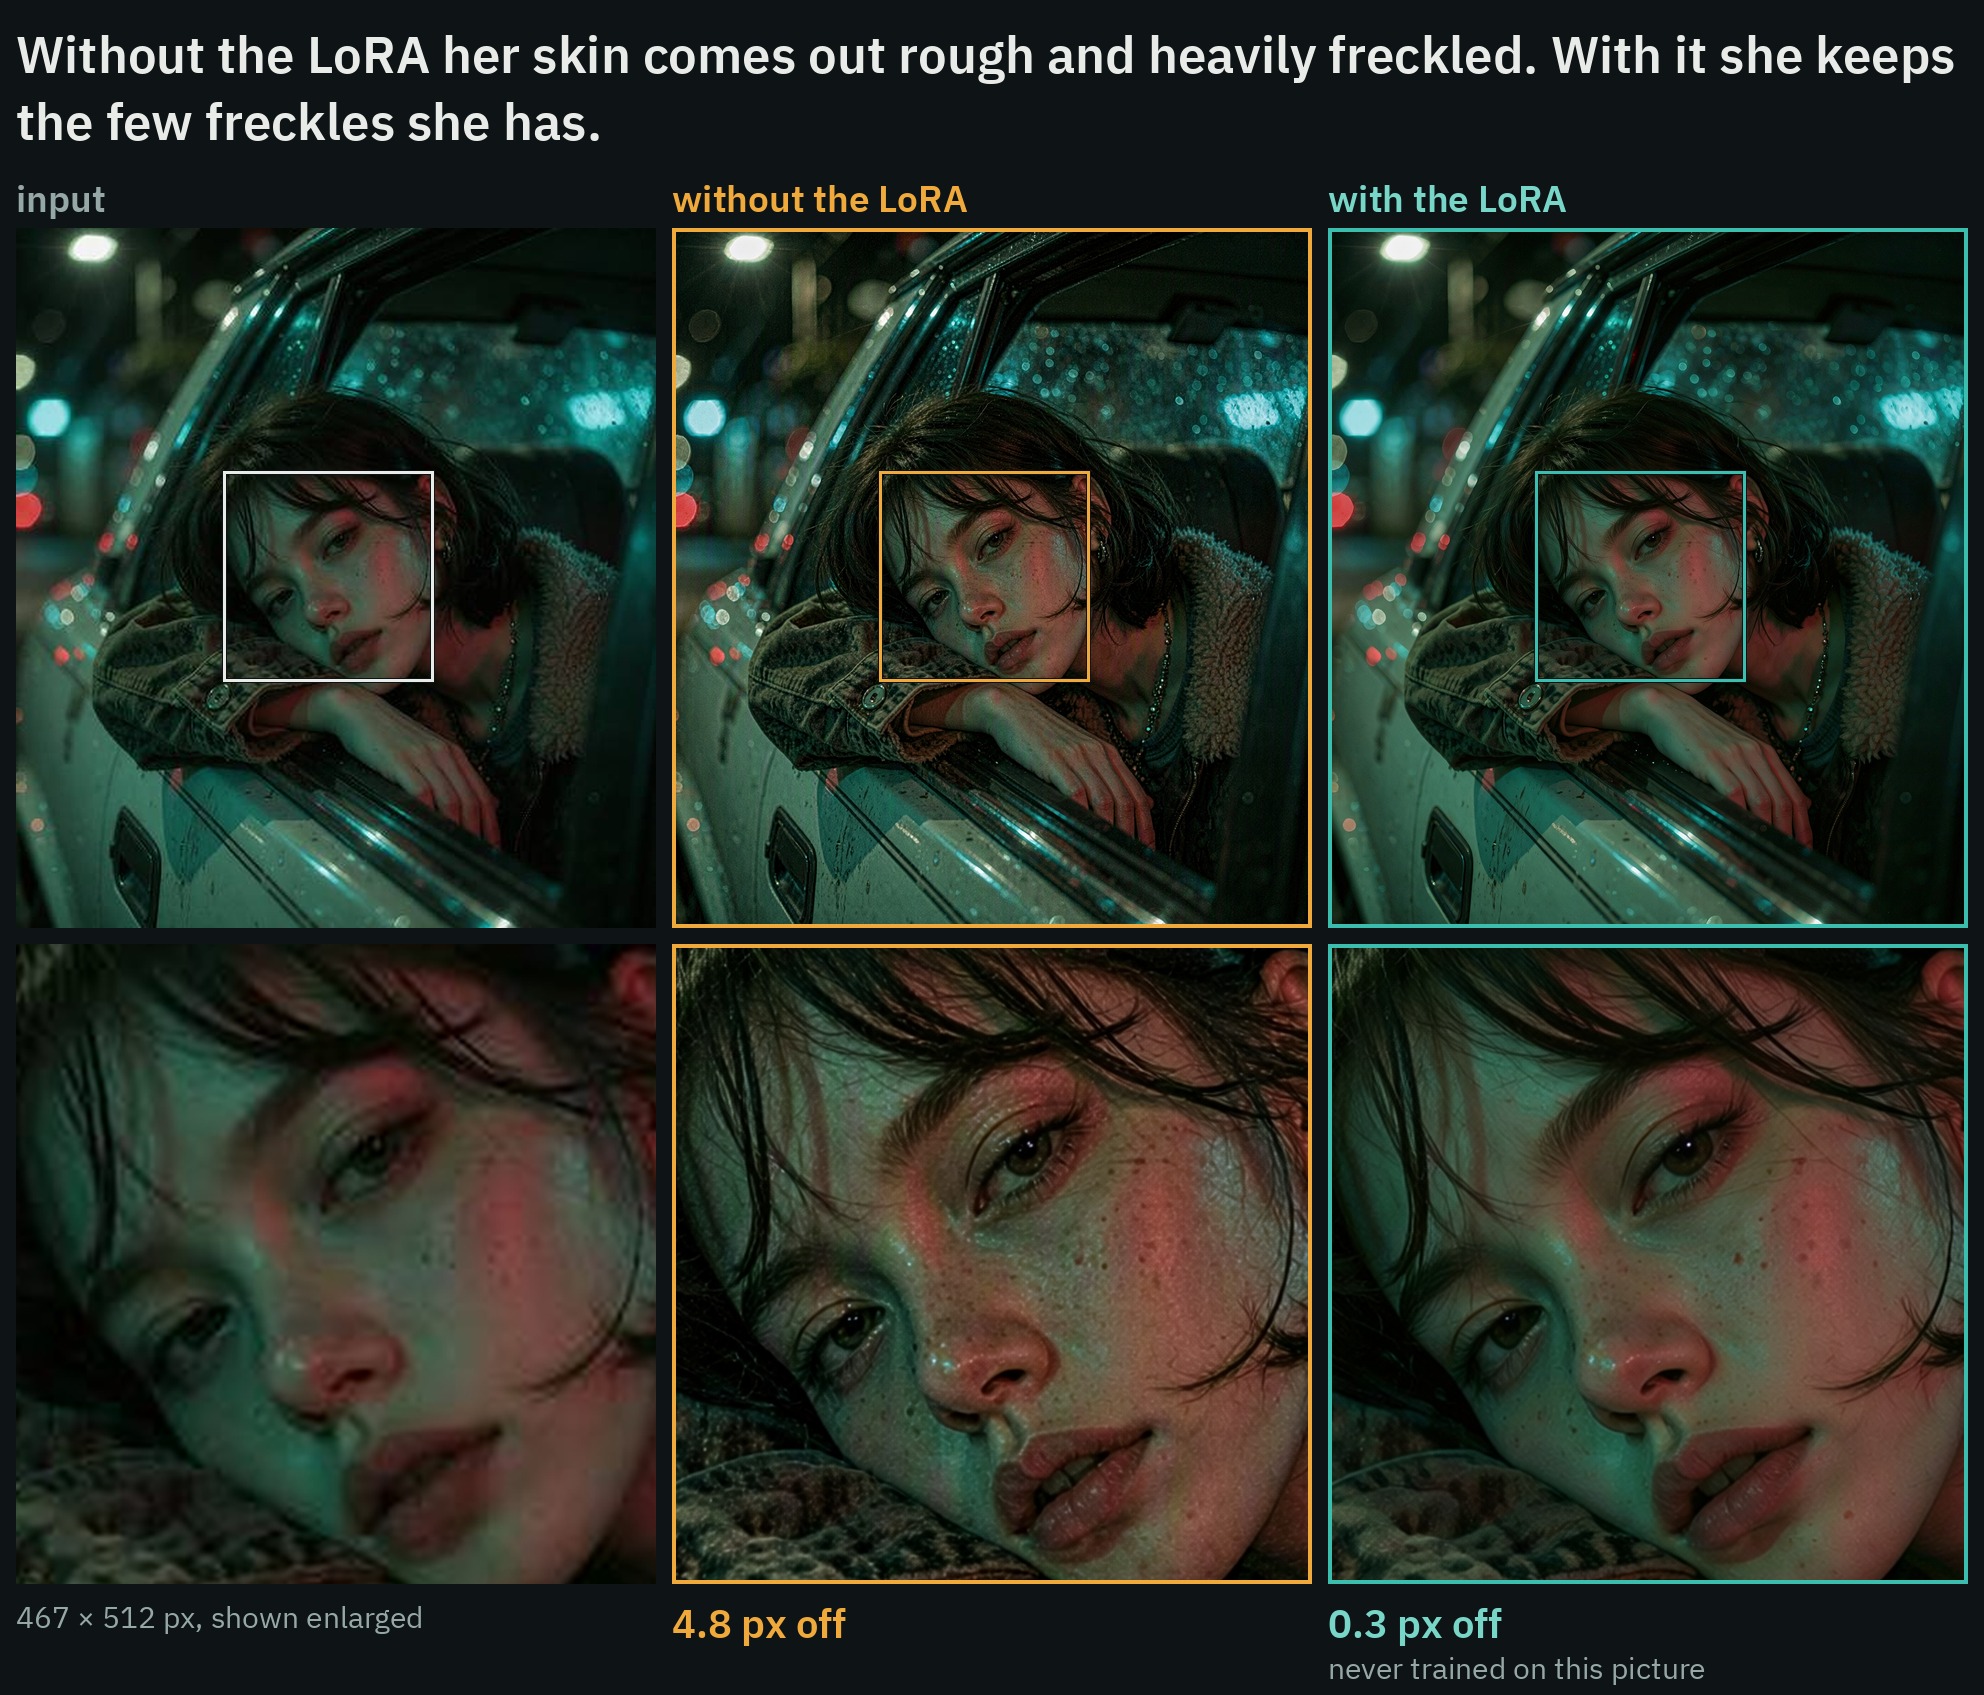
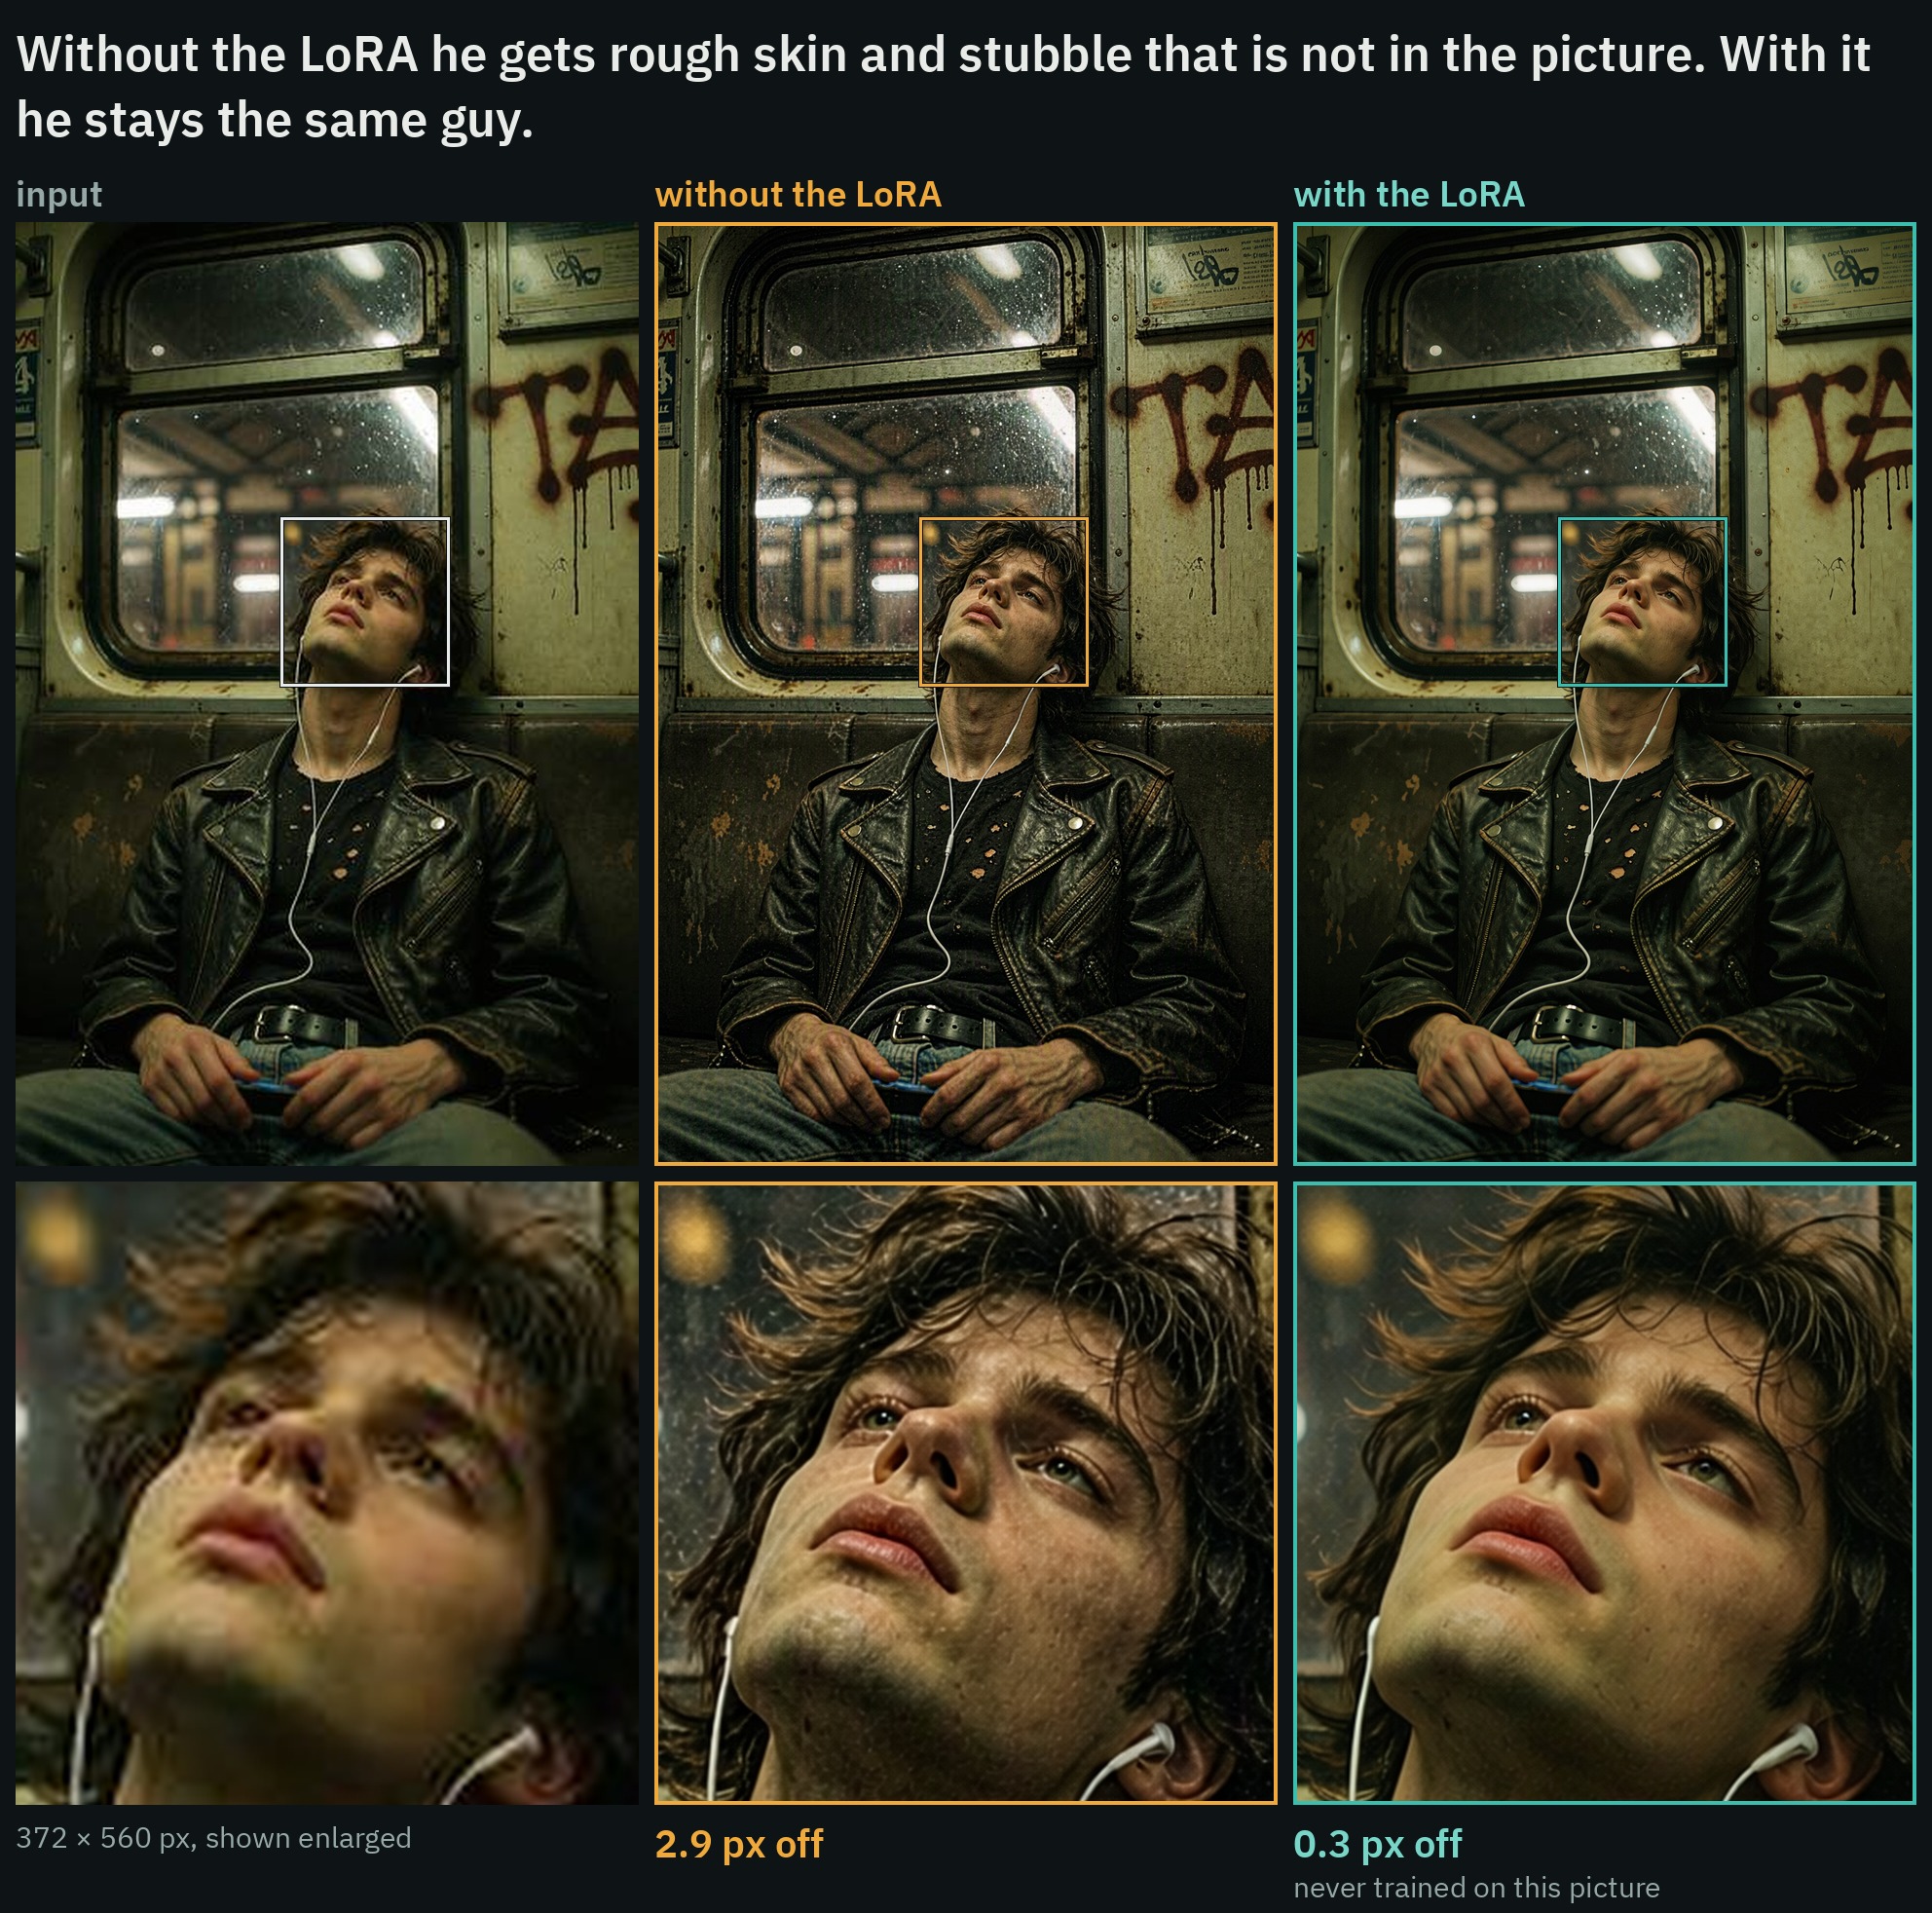
每组对比依次为:小尺寸输入、不使用 LoRA 的结果、使用 LoRA 的结果,下方放大显示标记的区域。全部通过该仓库自带的工作流运行,使用相同的提示词和种子,采用 Viggle Turbo 8 步,约 2 MP。“px off”表示结果与输入所缩小自的全尺寸图像之间的差值。这些图像都不在训练集中。
原版 Qwen-Image 2.1 对小尺寸图像做了什么
Qwen-Image 2.1 本身就是一个能力不错的照片恢复模型,但它的失效方式与模糊恰好相反。当被要求放大一张经过压缩或低分辨率的照片时,它会凭空编造细节:原始照片中根本不存在的毛孔、雀斑、胡茬和颗粒感,还会把脸重绘得比照片中的人老上几岁。它还会挪动画面中的内容。在作者的测试集中,原版 Qwen-Image 2.1 结果最差的角落与全尺寸原始图像相差 2.35 px,这在屏幕上看起来很小,但已足以使结果无法直接叠回来源图像。
该 LoRA 的训练目标,是用一部分编造出来的纹理换取对原图的贴合。它是一次重绘,而非恢复:细节仍然是编造的,只是编造得更少,卡片上也直接说明了这一点。
- 无需触发词。 先把图像放大到约 2 MP(两边都能被 32 整除),作为 image 1 输入,然后向它提出请求。
- 强度 1.0:适用于对焦清晰的小尺寸或压缩图像。
- 强度 0.75:可获得稍多 Qwen 自身的纹理。
- 强度 0.5:适用于模糊的照片、手抖拍下的照片或视频帧。
Restore the photo: remove blur, noise and compression artifacts and recover sharp, natural detail, keeping the same composition, people and colors.对于有划痕或褪色的照片,卡片会使用第二条请求,它同时还能恢复颜色:
Restore the old photo: remove scratches, dust, fading and grain and recover sharp, natural detail and color, keeping the same composition and people.留出集实测
作者自己的八张图片,长边缩至 512 或 560 px 并保存为质量 70 的 JPEG,然后放大到约 2 MP,再用相同的种子、LoRA 权重 1.0、CFG 1、euler / simple 进行恢复。每一个数值都是与全尺寸原图对比测得的,而模型从未见过这些原图。8 步的列使用 Viggle Turbo;25 步的列不使用:
| 八张留出集图片 | 无 LoRA,8 步 | 有 LoRA,8 步 | 无 LoRA,25 步 | 有 LoRA,25 步 |
|---|---|---|---|---|
| 与原图的距离,最差角落中位数 | 2.35 px | 0.26 px | 1.59 px | 0.15 px |
| 同上,八张中最差 | 3.83 px | 0.38 px | 3.25 px | 0.26 px |
| 与原图的接近程度(SSIM,1 = 完全相同) | 0.578 | 0.766 | 0.743 | 0.812 |
| PSNR | 23.2 dB | 28.0 dB | 26.3 dB | 29.3 dB |
| 颜色与亮度偏移 | 2.05 % | 0.97 % | 1.72 % | 1.04 % |
| 同一张脸(人脸识别,1 = 完全相同) | 0.821 | 0.905 | 0.837 | 0.901 |
| 细节精细度,相对于原图的 | 121 % | 78 % | 58 % | 36 % |
细节精细度这一行用一个数字概括了这种权衡。超过 100 % 意味着细节是凭空生成的:在 8 步下,纯 Qwen-Image 2.1 画出的颗粒比原图更多,而在 25 步下它画出的颗粒大约只有原图的一半。使用 LoRA 后两者都低于原图,因此结果看上去会略微平滑。作者还把另外 29 张图片跑了一遍相同的 8 步测试:使用 LoRA 时偏差 0.28 px,不使用时为 2.16 px;同一张脸为 0.88 对 0.79;SSIM 为 0.777 对 0.611。
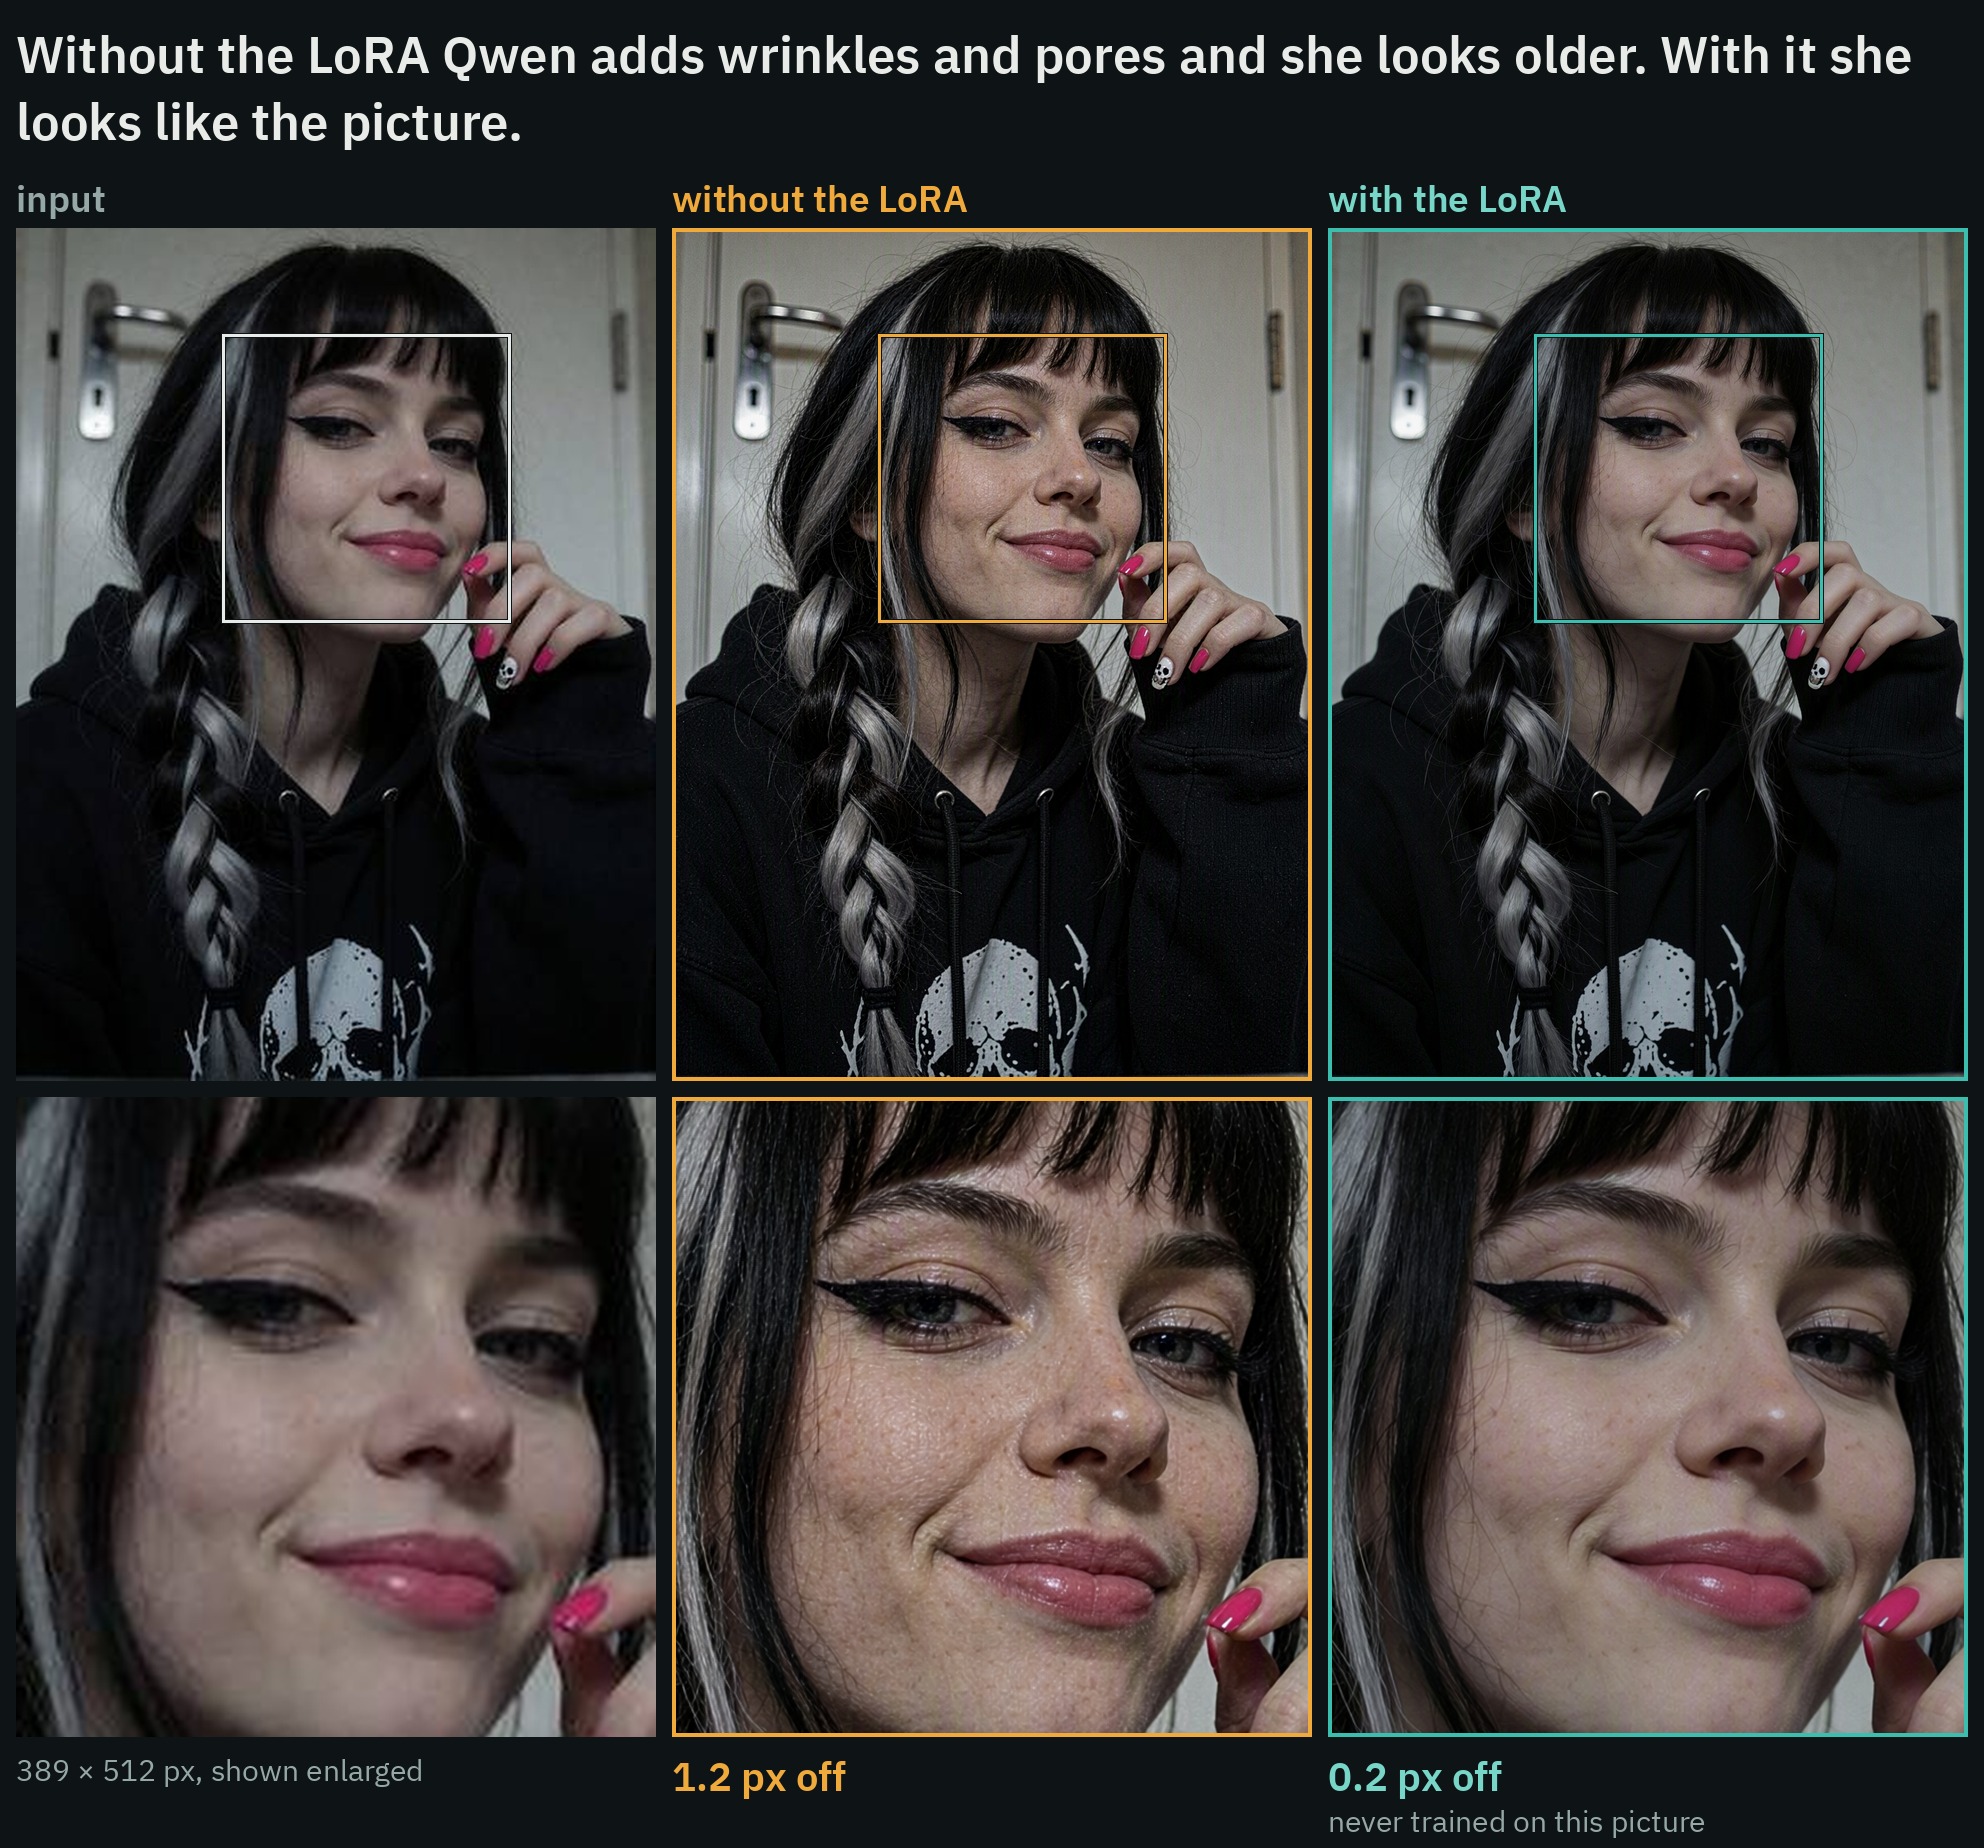
一张 389 px 的 JPEG 放大到 2 MP。这些图片都不在训练集中。
各种类型的损伤
该发布还报告了 57 组留出样本对,它们以与训练样本对相同的方式受到损伤,并使用正常请求以 8 步完成单次推理。SSIM 是相对于干净图像测量的,而“px off”为中位数:
| 损伤类型 | 图片数 | SSIM,受损输入 | SSIM,无 LoRA | SSIM,使用 LoRA | px off,无 LoRA | px off,使用 LoRA |
|---|---|---|---|---|---|---|
| 小型网络图片 | 15 | 0.772 | 0.524 | 0.716 | 2.53 | 0.31 |
| 手机平滑处理 | 5 | 0.836 | 0.565 | 0.857 | 2.65 | 0.17 |
| 视频截图 | 5 | 0.771 | 0.578 | 0.745 | 2.77 | 0.50 |
| 保存后重新保存 | 5 | 0.816 | 0.560 | 0.794 | 2.21 | 0.24 |
| 模糊与噪波 | 5 | 0.496 | 0.521 | 0.678 | 2.48 | 0.24 |
| 低分辨率 JPEG | 5 | 0.777 | 0.531 | 0.763 | 3.16 | 0.23 |
| 重度混合 | 5 | 0.735 | 0.646 | 0.746 | 1.28 | 0.25 |
| 陈旧印刷品 | 4 | 0.551 | 0.437 | 0.749 | 2.46 | 0.19 |
| 条带 | 4 | 0.915 | 0.463 | 0.843 | 2.34 | 0.17 |
| 低分辨率 PNG | 4 | 0.873 | 0.636 | 0.847 | 3.39 | 0.15 |
| 全部 | 57 | 0.756 | 0.544 | 0.762 | 2.70 | 0.23 |
使用 LoRA 后,所有 57 组结果都更接近干净图像,并且所有 57 组的偏移都更小。在若干类型中,受损图像本身的得分高于任何恢复结果,因为柔和的图像在平均意义上本就接近。
陈旧印刷品在四个留出样本上另有单独数据:恢复之前,颜色和亮度与干净图像的偏差为 15%,使用正常请求恢复之后偏差为 7%,而使用老照片请求则为 4%。划痕、灰尘和颗粒在两种请求下都会消失。模型未见过的某种褪色则可能保留:在第二次使用不同褪色方式的测试中,划痕消失了,而褪色的颜色依然存在。
强度是一个可调旋钮
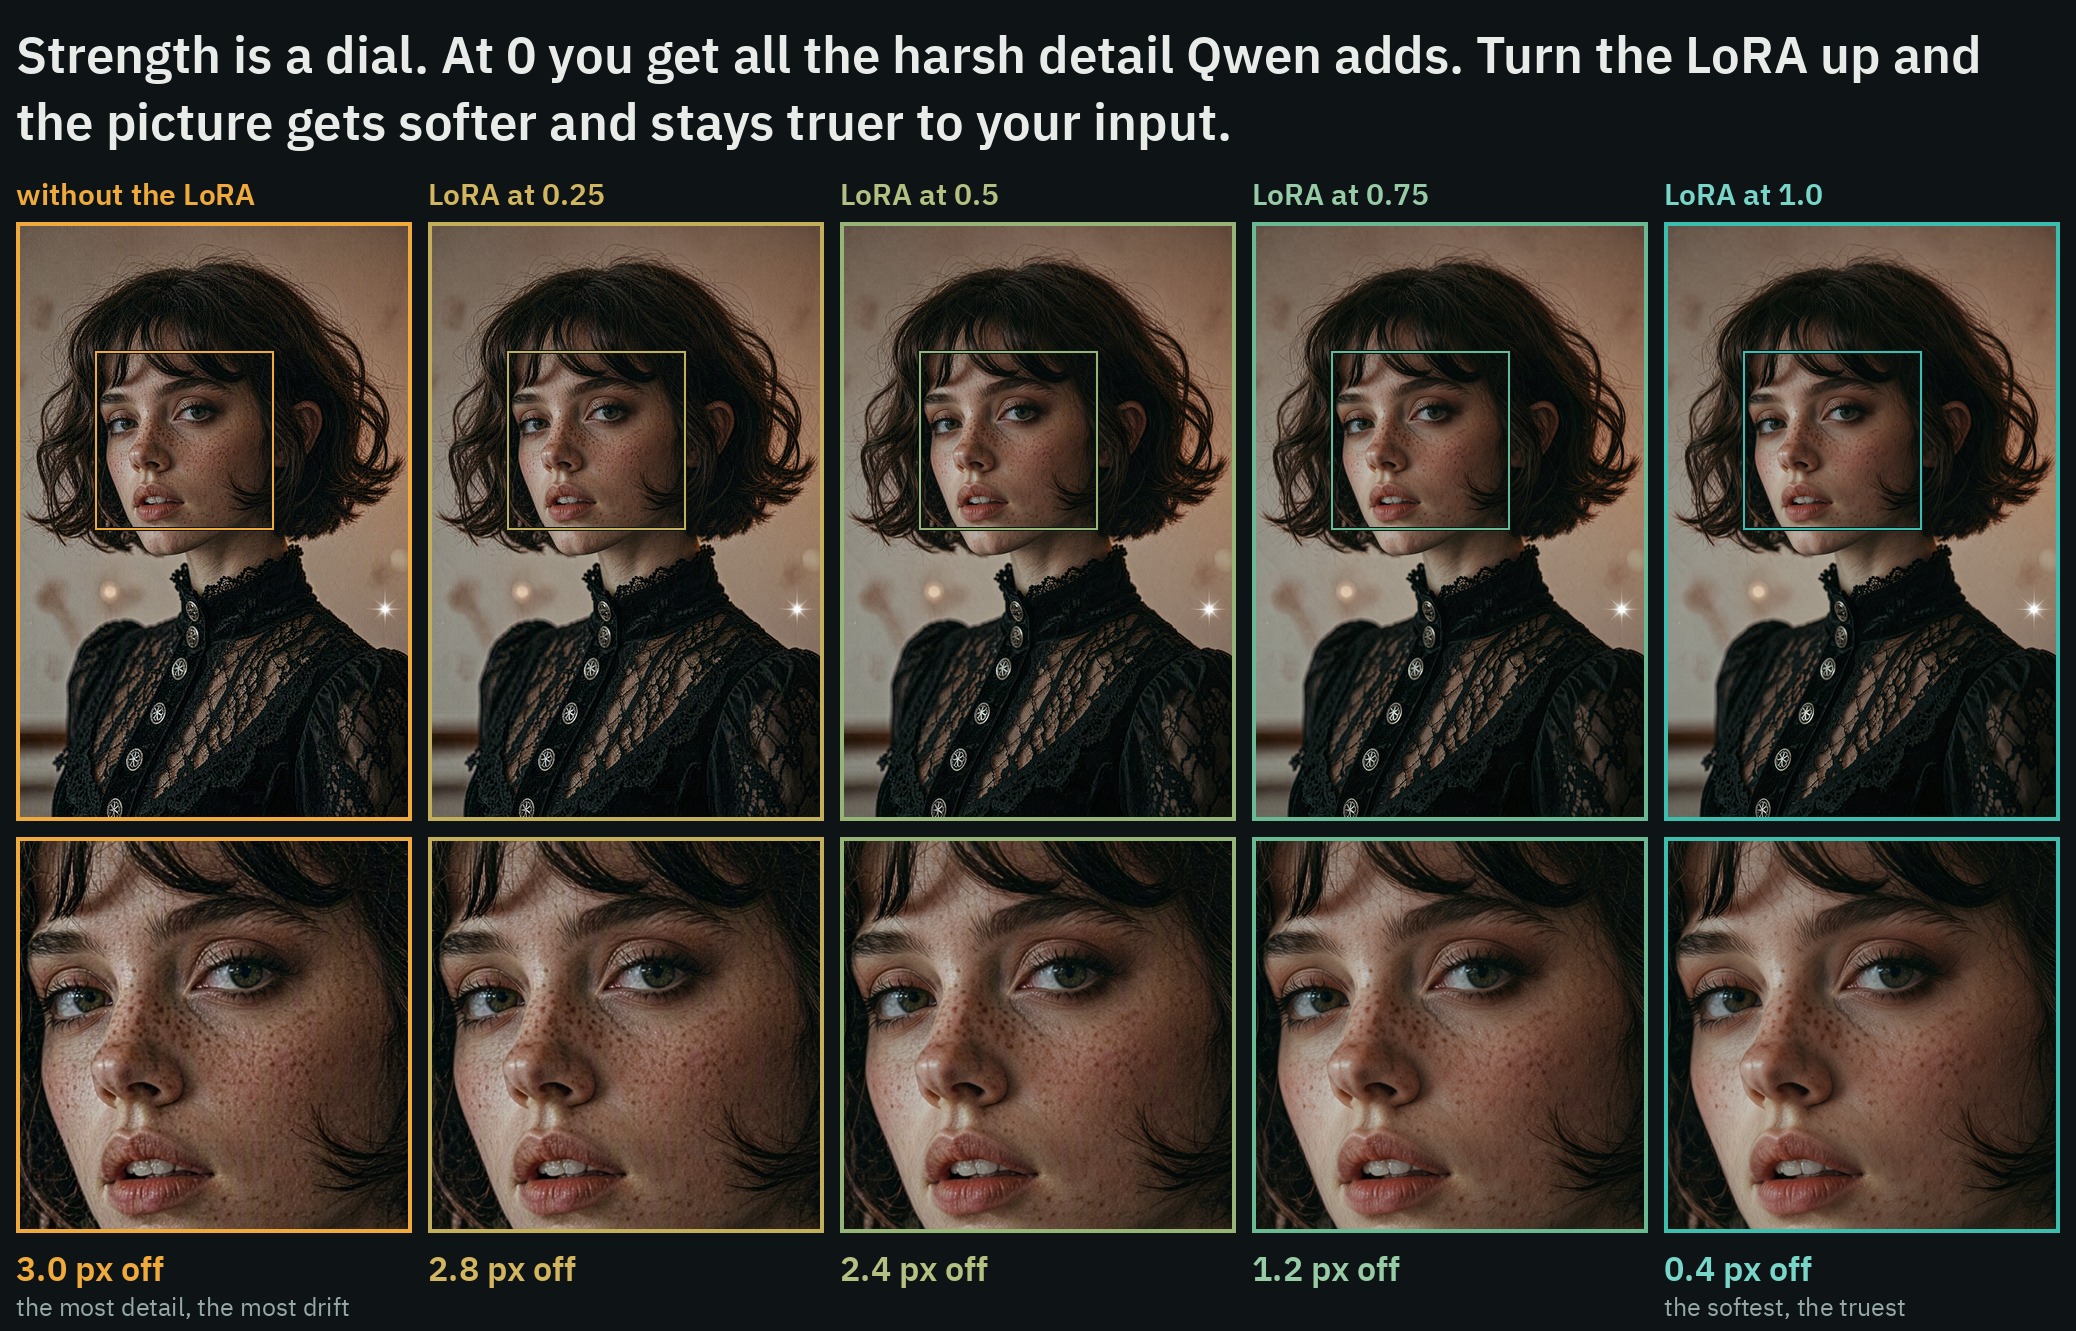
在这组 29 张图的数据上,整个强度区间从 0 处的原始 Qwen 一直延伸到 1.0 处最忠实的结果:
| 强度 | off / 0.5 / 0.75 / 1.0 |
|---|---|
| 与原始图像的距离 | 2.16 px / 1.31 px / 0.37 px / 0.28 px |
| 人脸相似度 | 0.794 / 0.858 / 0.875 / 0.880 |
| 颜色与亮度偏移 | 1.88 % / 1.26 % / 1.05 % / 0.94 % |
| 细节保留(相对原始图像) | 102 % / 81 % / 77 % / 72 % |
模糊照片最能体现这个旋钮的价值。作者用 26 张真实的低分辨率照片(旧自拍和手机照片)分别在 1.0、0.75 和 0.5 下进行了测试。在最模糊的六张上,1.0 恢复后偏软,0.75 几乎没有改善,而 0.5 恢复后很锐利;其余二十张上三种设置都有效,其中 1.0 最为平滑。把一张模糊照片分块放大到 8 MP,在这样试过的三张图上,1.0 下放大结果同样锐利。
该 LoRA 是在照片上训练的,在绘画上同样适用。在六张测试绘画(动漫、带文字的海报、水彩、3D 卡通、漫画、油画)上,它保留了原有风格和文字:SSIM 为 0.714,而不使用它时为 0.491;偏差为 0.27 px,而不使用时为 2.65 px。
与其他工具对比
卡片将本次发布与它能找到的、用于同一任务的其他工具进行对比,使用相同的 29 张图片、相同的测量指标,全部以 1.0 的强度运行。它们的用途并不完全相同:有些是为了增加细节,而这款 LoRA 是为了忠于原图,所以下表只回答一个问题,即结果与原始图像有多接近:
| 29 张小图 | 偏离原始图像 | 人脸相似度 | 颜色与亮度偏移 | SSIM |
|---|---|---|---|---|
| 仅 Qwen Image 2.1 | 2.16 px | 0.79 | 1.88 % | 0.611 |
| SeedVR2(3B),ComfyUI 自带节点 | 0.42 px | 0.82 | 0.44 % | 0.771 |
| Deblur anything | 0.39 px | 0.85 | 1.42 % | 0.702 |
| Detail Enhancer,在同一节点图中 | 2.07 px | 0.76 | 2.94 % | 0.673 |
| Detail Enhancer,使用其自身工作流,25 步 | 12.45 px | 0.71 | 4.16 % | 0.590 |
| 本 LoRA | 0.28 px | 0.88 | 0.94 % | 0.777 |
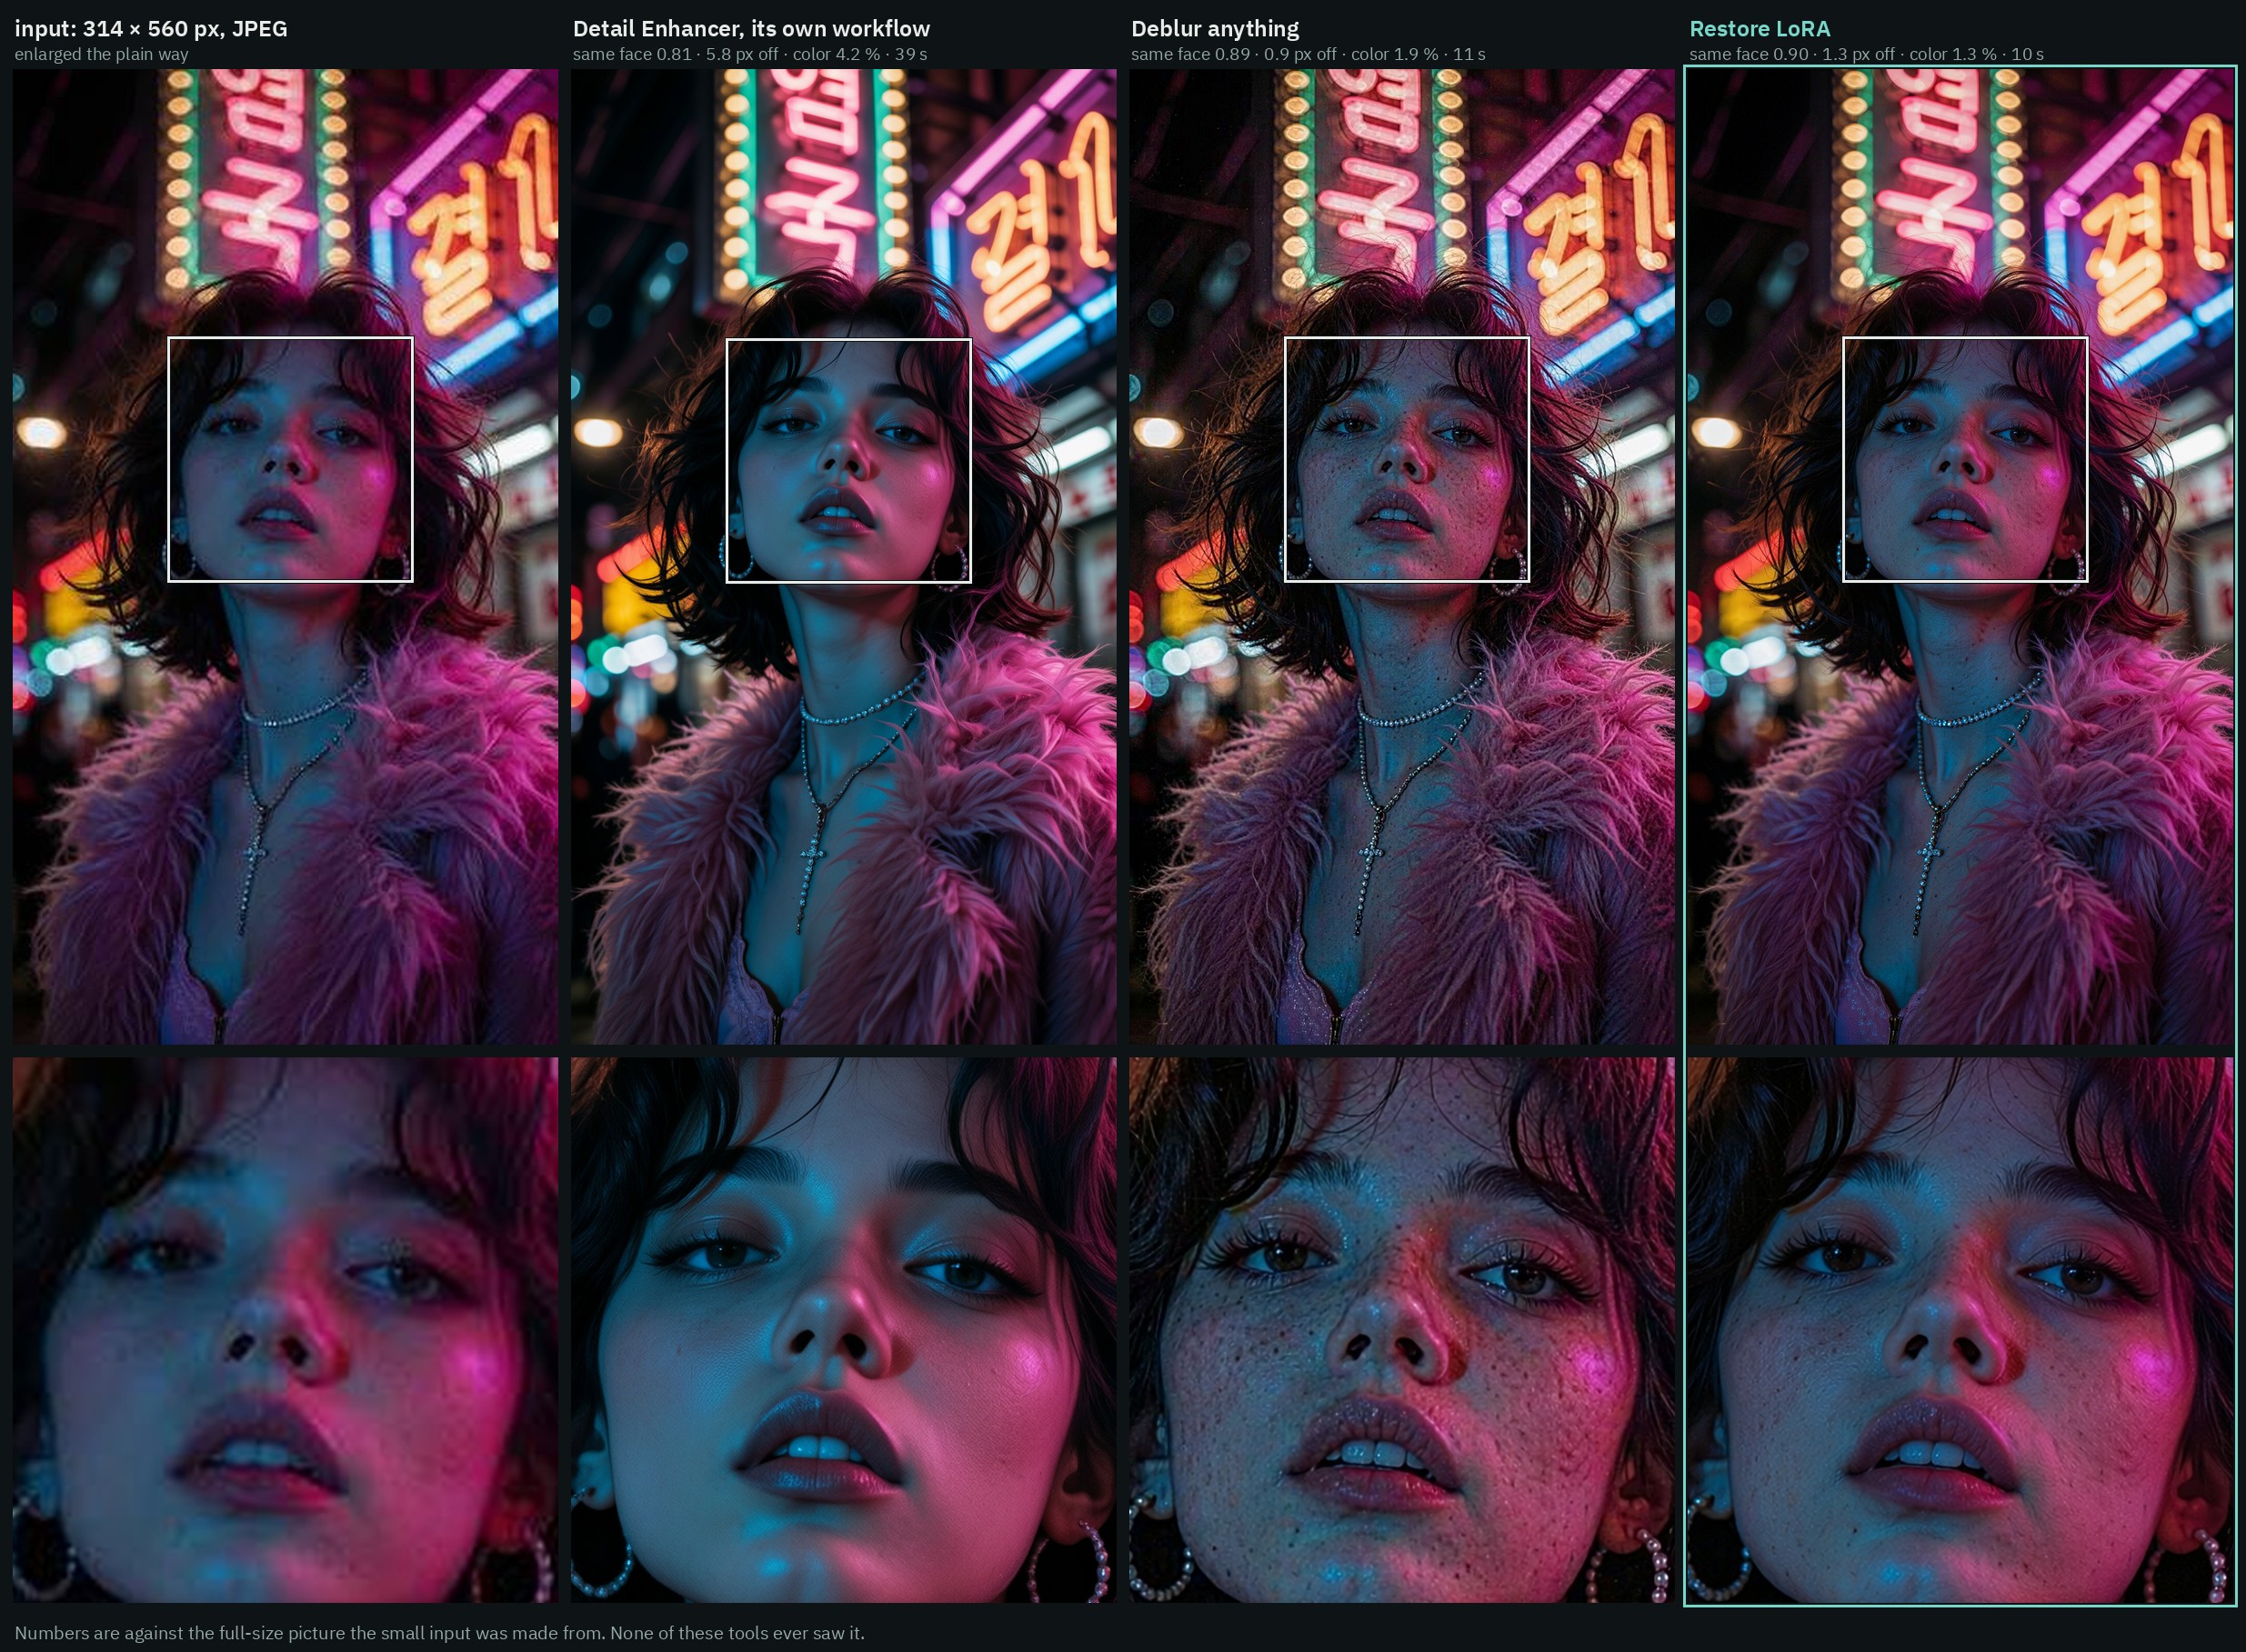
按 SSIM 衡量,本 LoRA 在全部 29 张图片上都比 Detail Enhancer 更接近原始图像(当 Detail Enhancer 运行自身工作流时为 29 张中的 28 张),也比 Deblur anything 更接近,并在 29 张中的 18 张上比 SeedVR2 更接近。在人脸保持方面,它在 28 张中的 28 张上优于 Detail Enhancer,在 28 张中的 26 张上优于 Deblur anything,在 28 张中的 27 张上优于 SeedVR2。SeedVR2 是迄今为止最快的,大约 3 秒,而其他工具约 11 秒,并且它的颜色保持最好。
使用哪个文件
| 文件 | 说明 |
|---|---|
qwen-image-2.1-restore.safetensors | 1,500 步,建议从这里开始。 在作者的测试图片中,它与原图最为接近。皮肤会显得略微平滑。 |
qwen-image-2.1-restore-1250.safetensors | 1,250 步。在噪点较多的手机照片上能绘制更多精细细节,并保留更多皮肤纹理。接近程度略低一些。 |
两者均为 rank 32,并使用 ComfyUI 的键名命名,因此无需任何转换即可加载到 Comfy-Org Qwen-Image 2.1 权重上。
在 ComfyUI 中运行
该适配器是仅作用于模型的 LoRA,因此恢复本身不需要自定义节点。将 .safetensors 文件放入 ComfyUI/models/loras/,在模型加载器之后添加一个 LoraLoaderModelOnly 节点并将强度设为 1.0,然后把小图作为图像 1、把上面的请求作为提示词交给 Qwen-Image 2.1。卡片自带的设置是:搭配 Viggle Turbo 时使用 8 步、CFG 1;不使用它时为 25 步。
仓库的 workflows/ 文件夹中附带了一个现成的工作流,它使用作者的 ComfyUI-AusBoss 节点构建,与他更早发布的版本所用的是同一套节点包。
限制
- 这是一次重绘,而不是恢复。精细细节是为了适应画面而编造出来的,而单纯的 Qwen-Image 2.1 能生成更多细节。
- 严格贴合原图才是关键所在,因此需要新增内容才能成立的结果不会得到这些内容。
- 模糊输入在全强度下处理,输出依然偏柔。可降到 0.5,或采用分块放大。
- 这些数据来自作者自己的测试图像,以及对比集中一部分样本在未启用 Turbo 的情况下跑 25 步的结果。
- 对于超过 2 MP 的结果,作者会搭配他在 Civitai 上发布的分块放大工作流一起使用。
可用性
- LoRA 权重:ausboss/Qwen-Image-2.1-Restore-LoRA
- 每张图像的数值:comparison_numbers.csv
- 基础模型重打包:Comfy-Org/Qwen-Image-2.1
- 作者的节点包:ausboss/ComfyUI-AusBoss
评论
使用 GitHub 登录后即可参与讨论。