Qwen-Image 2.1 换装 LoRA:ComfyUI 在原图画面内完成服装替换
一款适用于 Qwen-Image 2.1 的社区 LoRA 能把换装结果还原到原图之上:构图、面部与背景保持不变,只改变服装,并附带 ComfyUI 工作流。
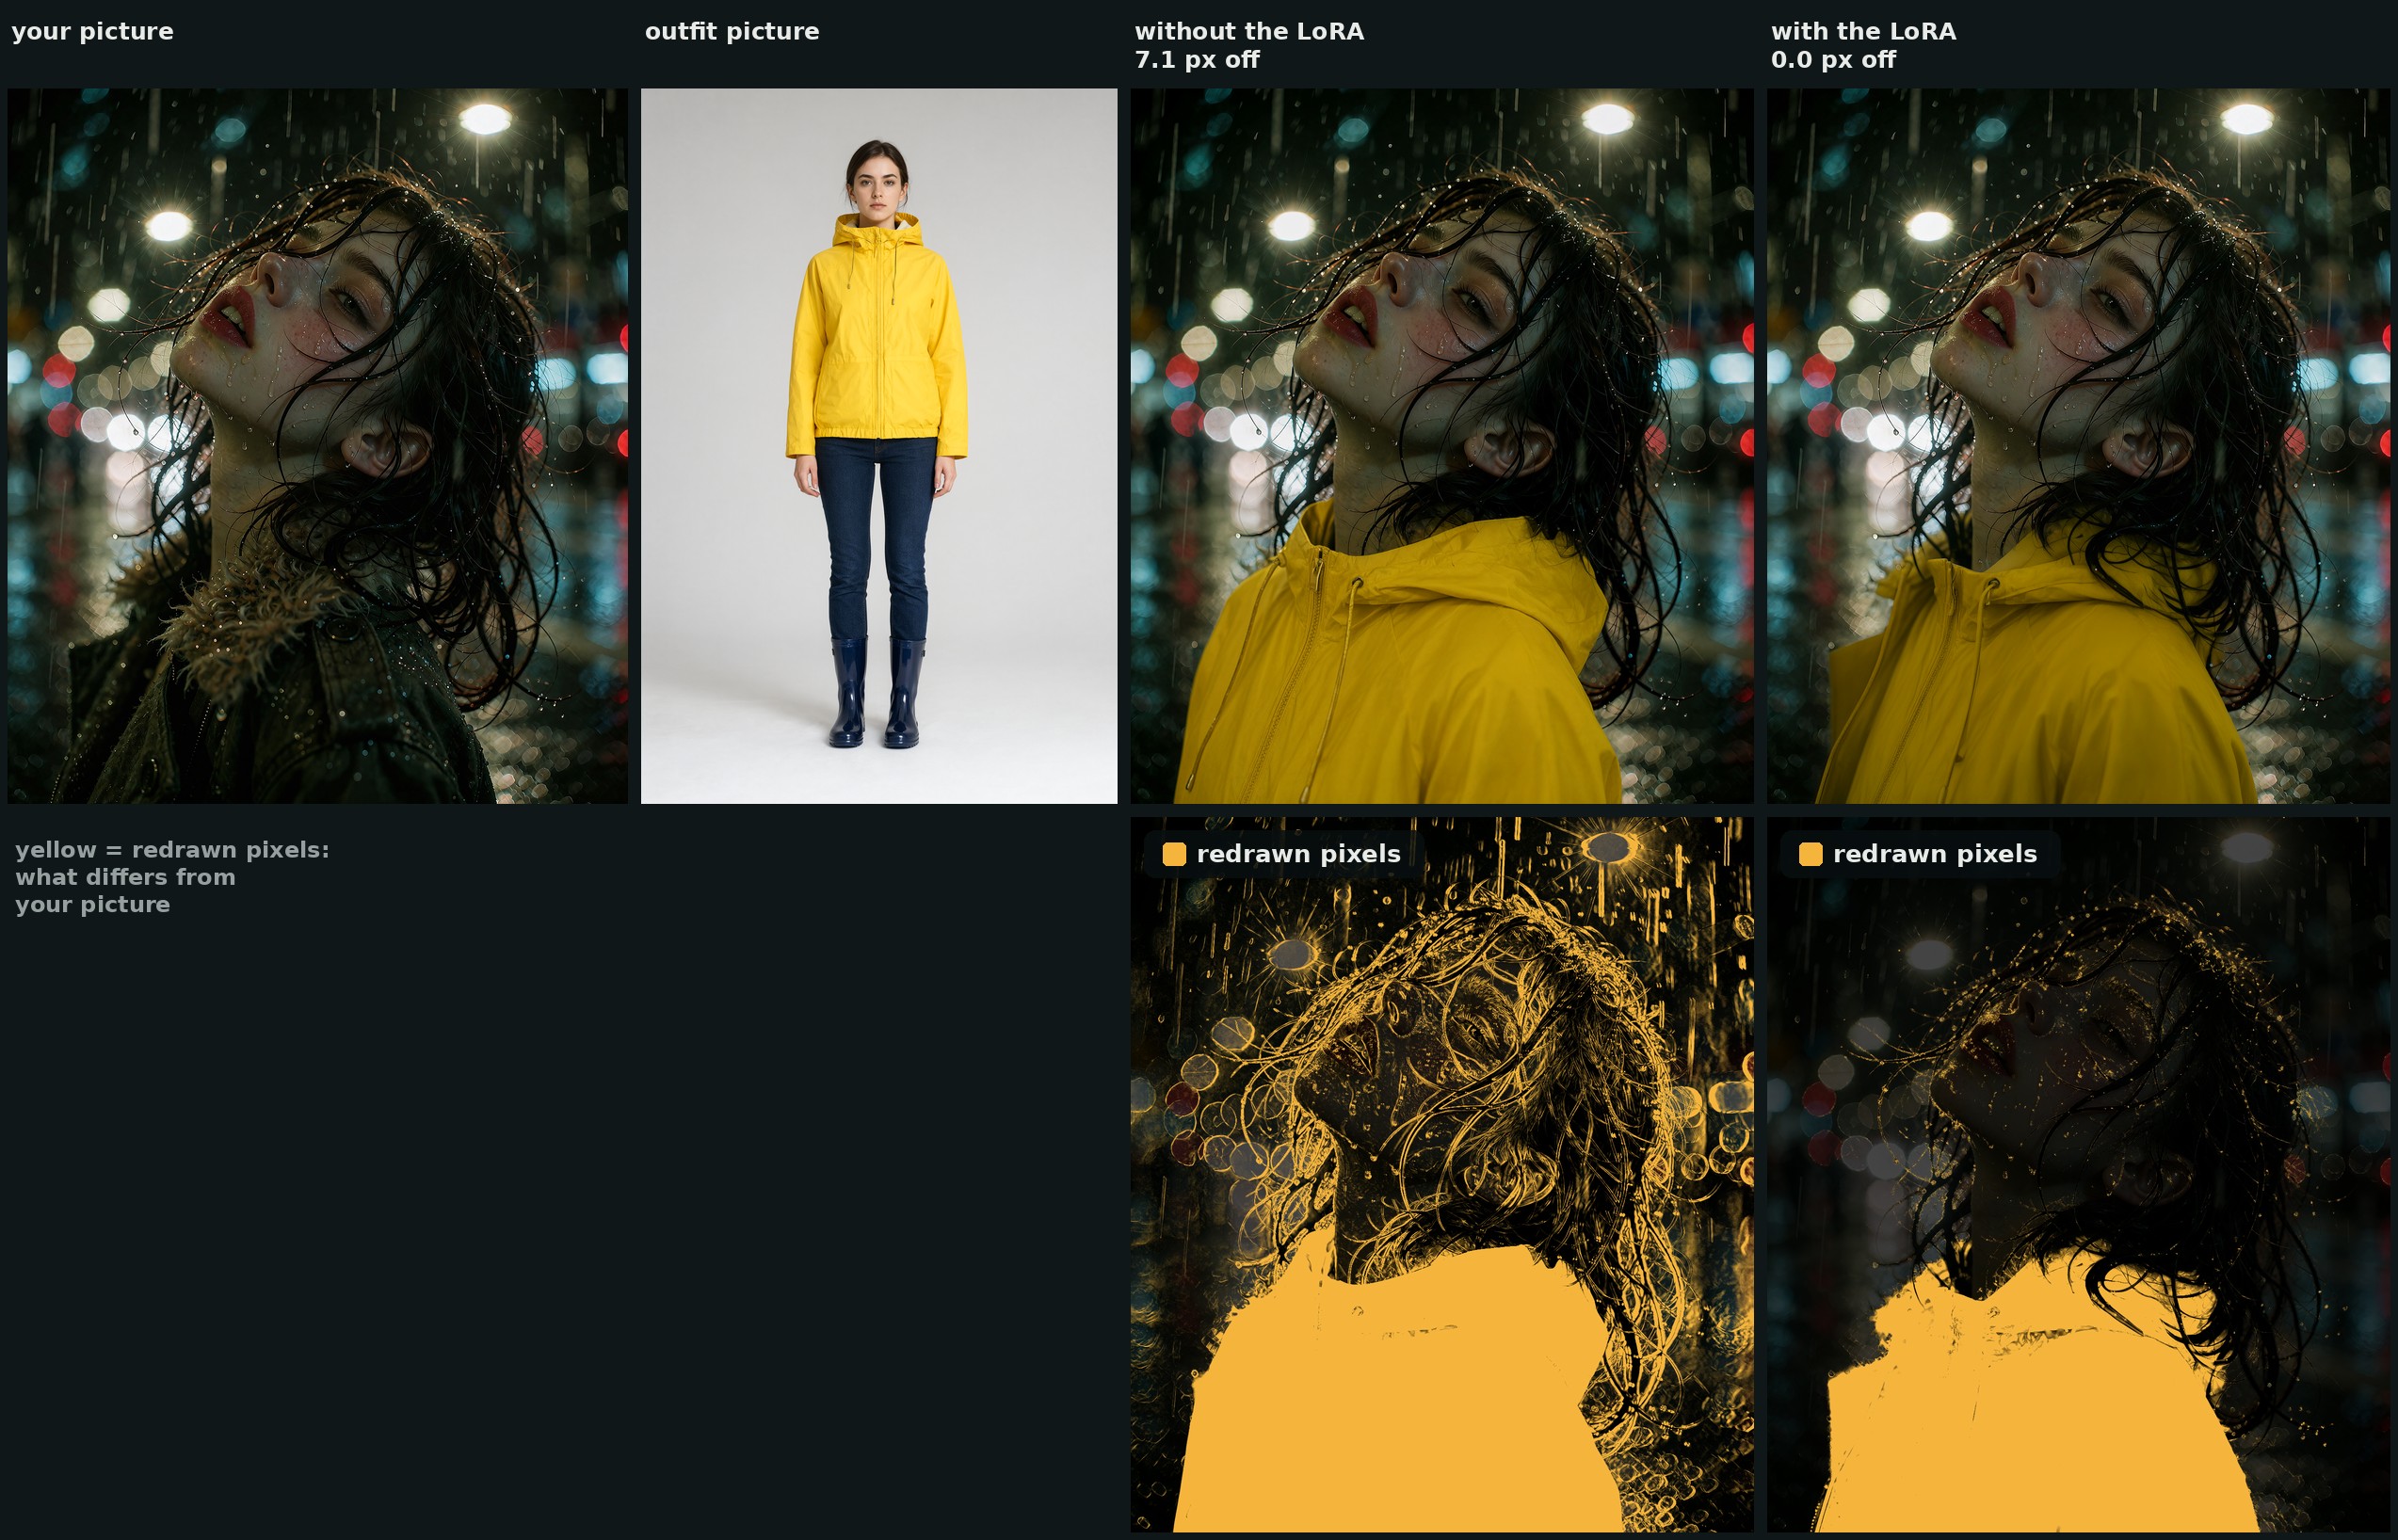
上排:换装结果,使用相同的请求和种子。下排:以黄色标出的重绘像素。不使用 LoRA 时,面部、窗口和墙壁都会亮起;使用它时,只有外套不同。无论是这个人还是这件外套,都不在训练集中。
原生 Qwen-Image 2.1 存在的问题
每一次 Qwen-Image 2.1 编辑都是一次全新的生成,因此换装时被重新构图的不只是衣服。作者用原生 Qwen-Image 2.1 跑了 47 次换装,并逐张肉眼标注:其中 24 次可用,另外 23 次则存在各种问题。通常问题并不出在服装本身:
- 相机后拉,以便把整套服装收进画面,
- 原本没有腿的画面里却被硬塞进一条裤子,
- 身体或姿势被重绘,以承载新衣服,
- 或者整体只是偏移了几个像素。
以人物照片为基准测量,原生结果在最差的角落约偏离 3.4 px。这个偏差很小,但意味着结果无法再叠回原始图像:人脸被重绘得略微柔和,背景也被重新绘制,哪怕并没有提出任何修改要求。用 ControlNet 锁住姿势能保持场景原位,但大约每五次换装就有一次没能把衣服穿上,因此该方案被放弃。
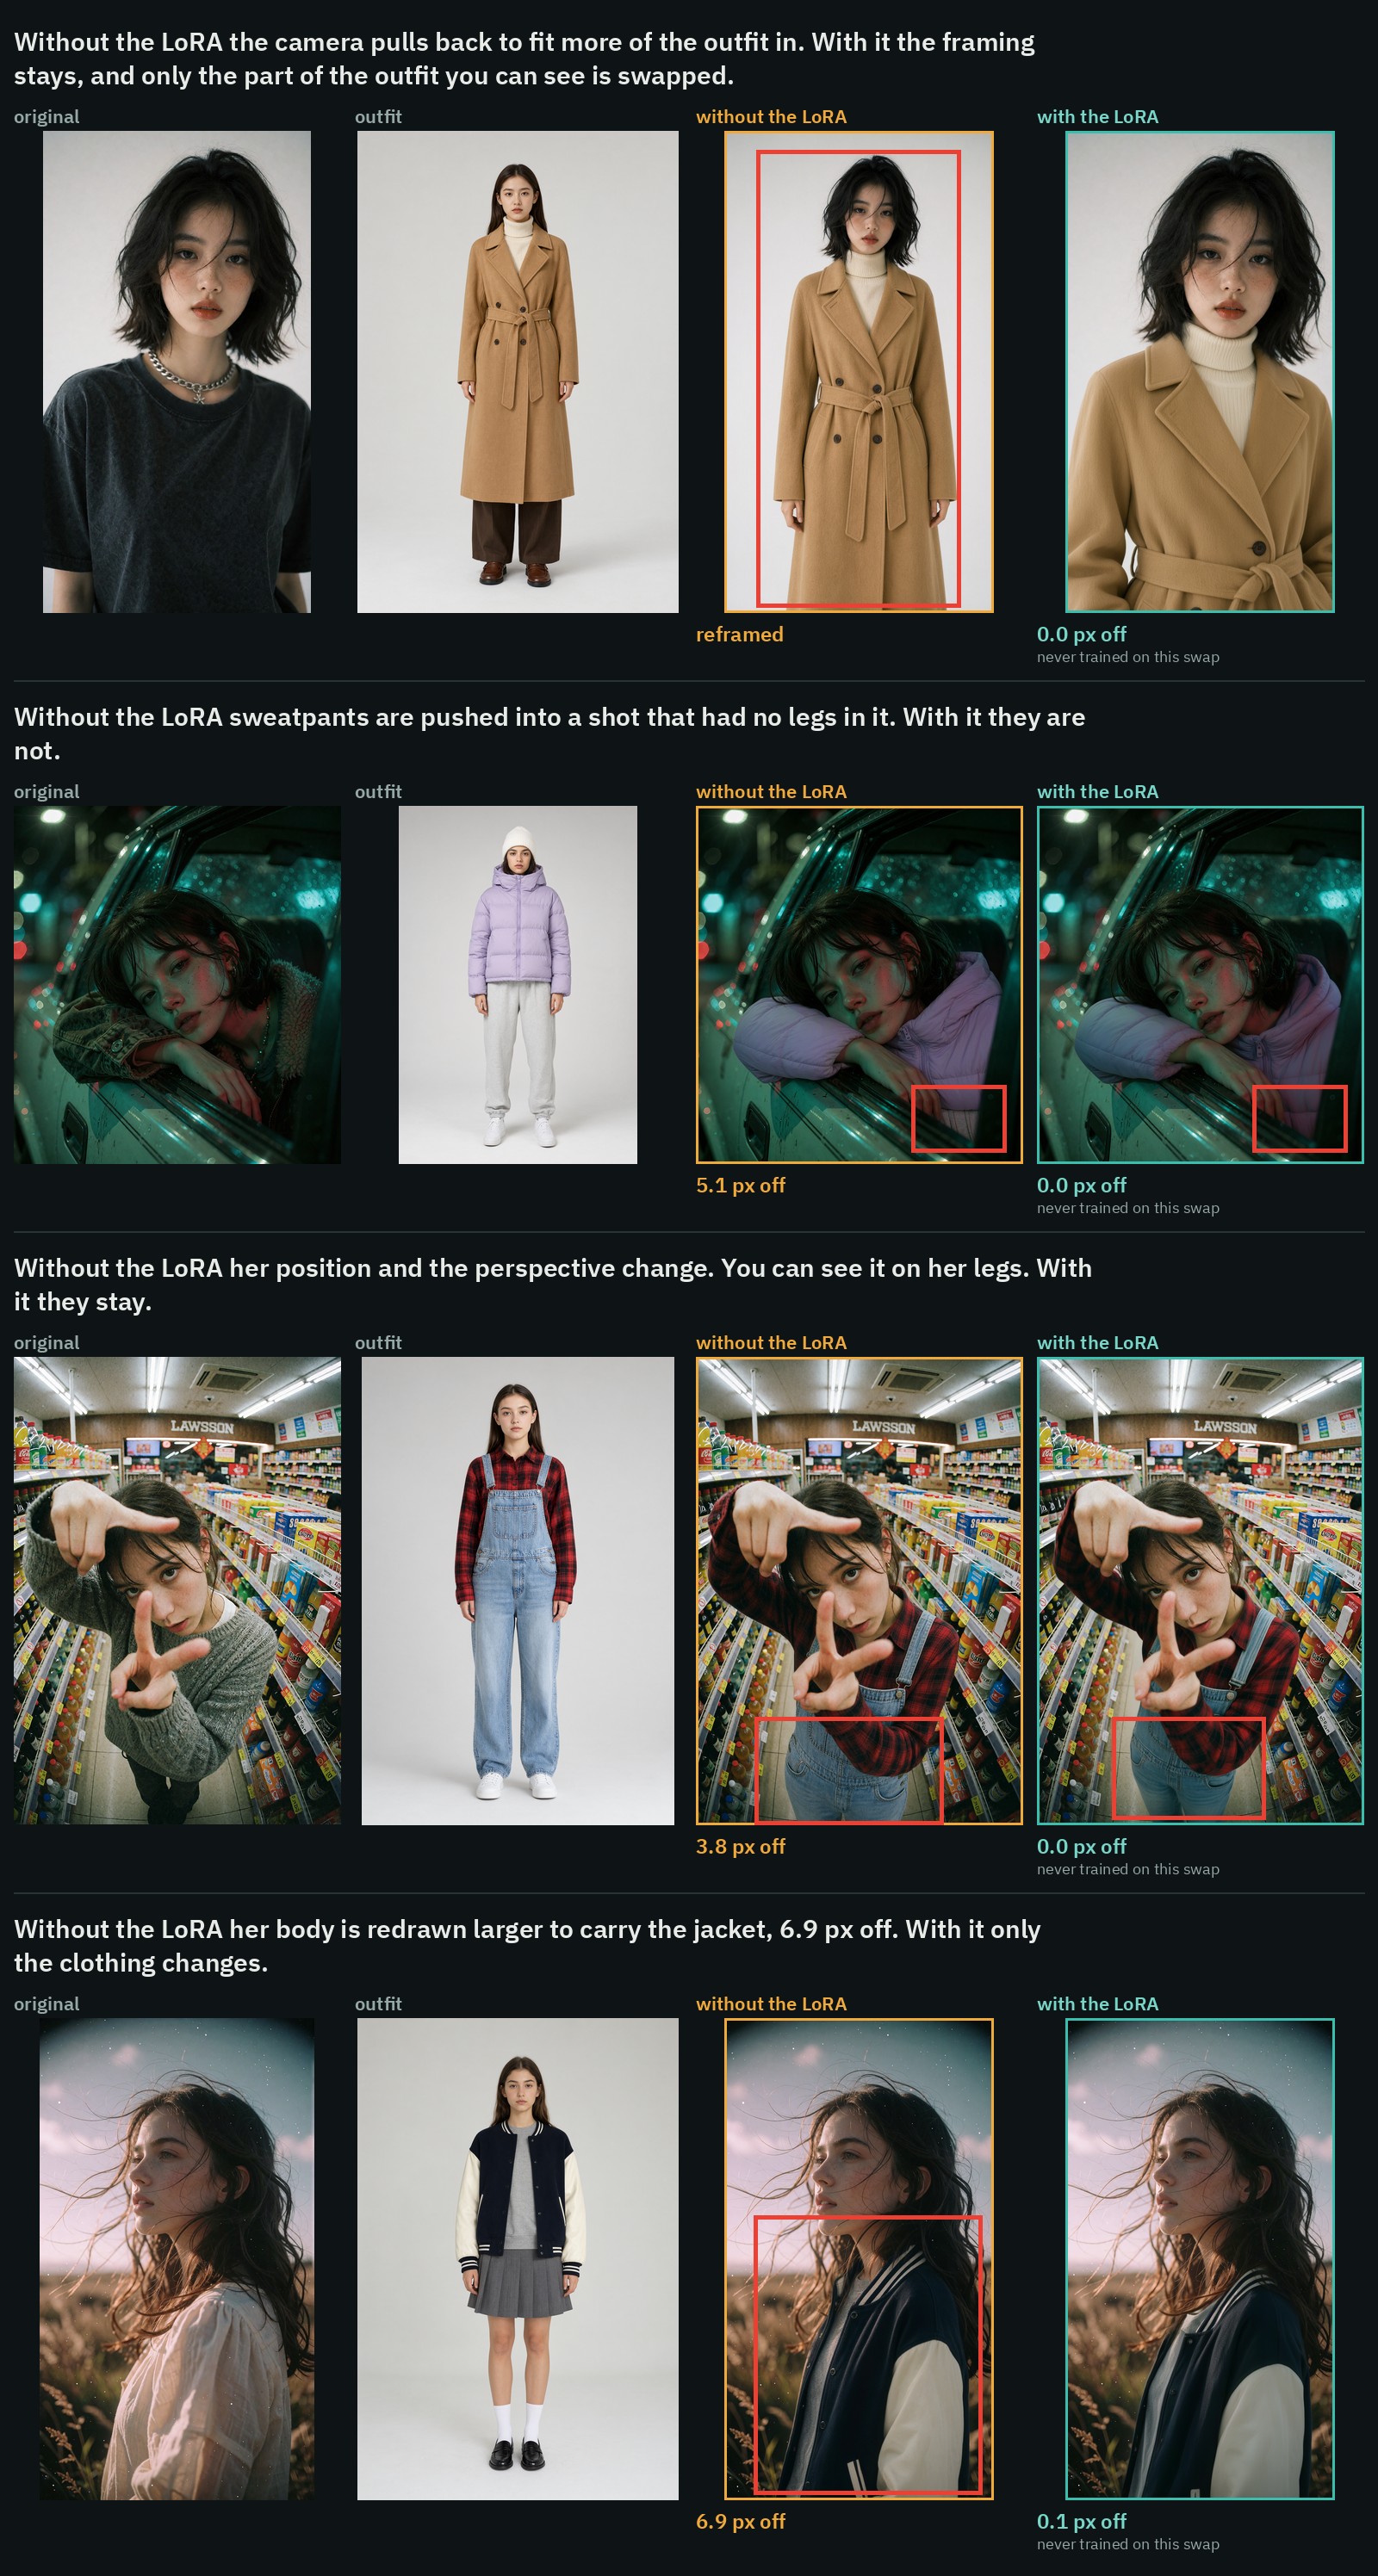
这 47 次换装中的四次,使用相同的工作流与种子,分别在不使用和使用 LoRA 的情况下进行。它们都不在训练集中。
实测保持
十六个 LoRA 从未训练过的换装,全部以约 2 MP 通过同一个工作流运行,使用相同的种子、25 步、CFG 1、euler / simple、adapter 为 1.0。“偏移”指结果图最差的角落距离人物原图有多远。人脸和背景的数值是在将结果图与人物原图对齐之后测得的,因此它们衡量的是重绘程度,而不是偏移:
| 十六个留出换装 | 无 LoRA | 1,000 步 | 1,250 步 | 1,500 步 |
|---|---|---|---|---|
| 最差角落偏移,中位数 | 3.6 像素 | 0.1 像素 | 0.1 像素 | 0.1 像素 |
| 最差角落偏移,十六个中最差 | 7.0 像素 | 0.2 像素 | 0.2 像素 | 0.2 像素 |
| 人脸明显变化的像素 | 14.1 % | 1.7 % | 1.8 % | 2.0 % |
| 人脸相对人物原图的 PSNR | 29.8 dB | 37.8 dB | 37.7 dB | 37.1 dB |
| 背景明显变化的像素 | 10.8 % | 0.9 % | 0.9 % | 1.2 % |
| 背景 PSNR | 27.6 dB | 40.5 dB | 40.4 dB | 40.0 dB |
强度很重要:500 步在 0.5 强度下偏移 1.8 像素,而在 1.0 强度下为 0.1 像素,因此强度减半会带回大约一半的偏移。从 500 步起,各个步数在数值上都同样保持住画面。它们之间的差别在于新服装未覆盖的衣物会变成什么样。
作为引用,上面那四组普通对比在没有 LoRA 时偏移分别为 4.8、7.1、5.2 和 7.2 像素,加上 LoRA 后则分别为 0.1、0.0、0.0 和 0.1 像素。
旧衣服会怎样处理
未加 LoRA 的原版 Qwen-Image 2.1 往往会保留新服装未遮盖的部分:比基尼下的靴子,裙子下的破洞牛仔裤。训练步数在很大程度上决定了这些。两次换装,各用三个随机种子,均使用普通提示词:
| 换上新裙子后牛仔裤消失 | 换上比基尼后靴子消失 | |
|---|---|---|
| 无 LoRA | 3 次中 0 次 | 3 次中 0 次 |
| 第 500 步 | 3 次中 0 次 | 3 次中 0 次 |
| 第 1,000 步 | 3 次中 2 次 | 3 次中 2 次 |
| 第 1,250 步 | 3 次中 0 次 | 3 次中 0 次 |
在请求末尾再加一句话,可以在第 1,000 步进一步引导结果。Replace everything they wear. 在泳装下脱掉了连裤袜(鞋子保留),而 Keep their own shoes and legwear. 保住了普通请求已经移除的靴子。这两句话都没有出现在任何训练标注中,所以这是基础模型在响应,而 LoRA 保持画面其余部分不变。在第 1,250 步和第 1,500 步,同样的句子几乎没有或完全没有产生差别,这也是该版本推荐使用第 1,000 步的另一个原因。随附的工作流默认加入 Replace everything they wear.,位于一个可编辑的盒子中。
应该使用哪个文件
| 文件 | 说明 |
|---|---|
qwen-image-2.1-outfit-swap.safetensors | 训练步数 1,000,从这里开始。 它最常把旧服装彻底清除,而不是残留一部分在身上。 |
qwen-image-2.1-outfit-swap-1250.safetensors | 训练步数 1,250。对画面的保持同样出色。会保留更多人物原本的穿着(靴子、裙子下的牛仔裤)。 |
qwen-image-2.1-outfit-swap-1500.safetensors | 训练步数 1,500,是整个训练的终点。保持程度相同,但面部和背景的变化略多一点。 |
三个 LoRA 均为 rank 32,并采用 ComfyUI 的键名命名方式,因此可以直接加载到 Comfy-Org 的 Qwen-Image 2.1 权重上,无需任何转换。
在 ComfyUI 中运行
该适配器是一个仅模型 LoRA,因此换装本身不需要自定义节点。把请求写成一句话,人物作为图像 1,服装作为图像 2:
Dress the person in image 1 in the <outfit, in a few words> shown in image 2. Keep their face, hair, hands, pose and the background exactly the same.要把它加入任意一个双图 Qwen-Image 2.1 编辑画面:
- 将
.safetensors文件放入ComfyUI/models/loras/,并在模型加载器之后添加一个 LoraLoaderModelOnly 节点,权重(strength)设为 1.0。 - 使用 Text Encode Qwen Image 2.1 节点,把人物作为
image_1、服装作为image_2,resolution设为 0,请求作为提示词。 - 在编码器的
latent输出上用 K采样器 采样,25 步,CFG 1,euler/simple,denoise 1。 - 用 VAE解码 解码,然后使用 分离图像Alpha,因为 Qwen-Image 2.1 VAE 解码输出 RGBA。
仓库中附带了一个现成的工作流。它使用作者的 ComfyUI-AusBoss 节点(2.5.1 或更新版本)构建,需要 ComfyUI 0.38 或更新版本;卡片中说明,任何等效节点均可。
来自模型卡片:同一组换装在不用与使用该 LoRA 时的并排运行对比。
更多对比
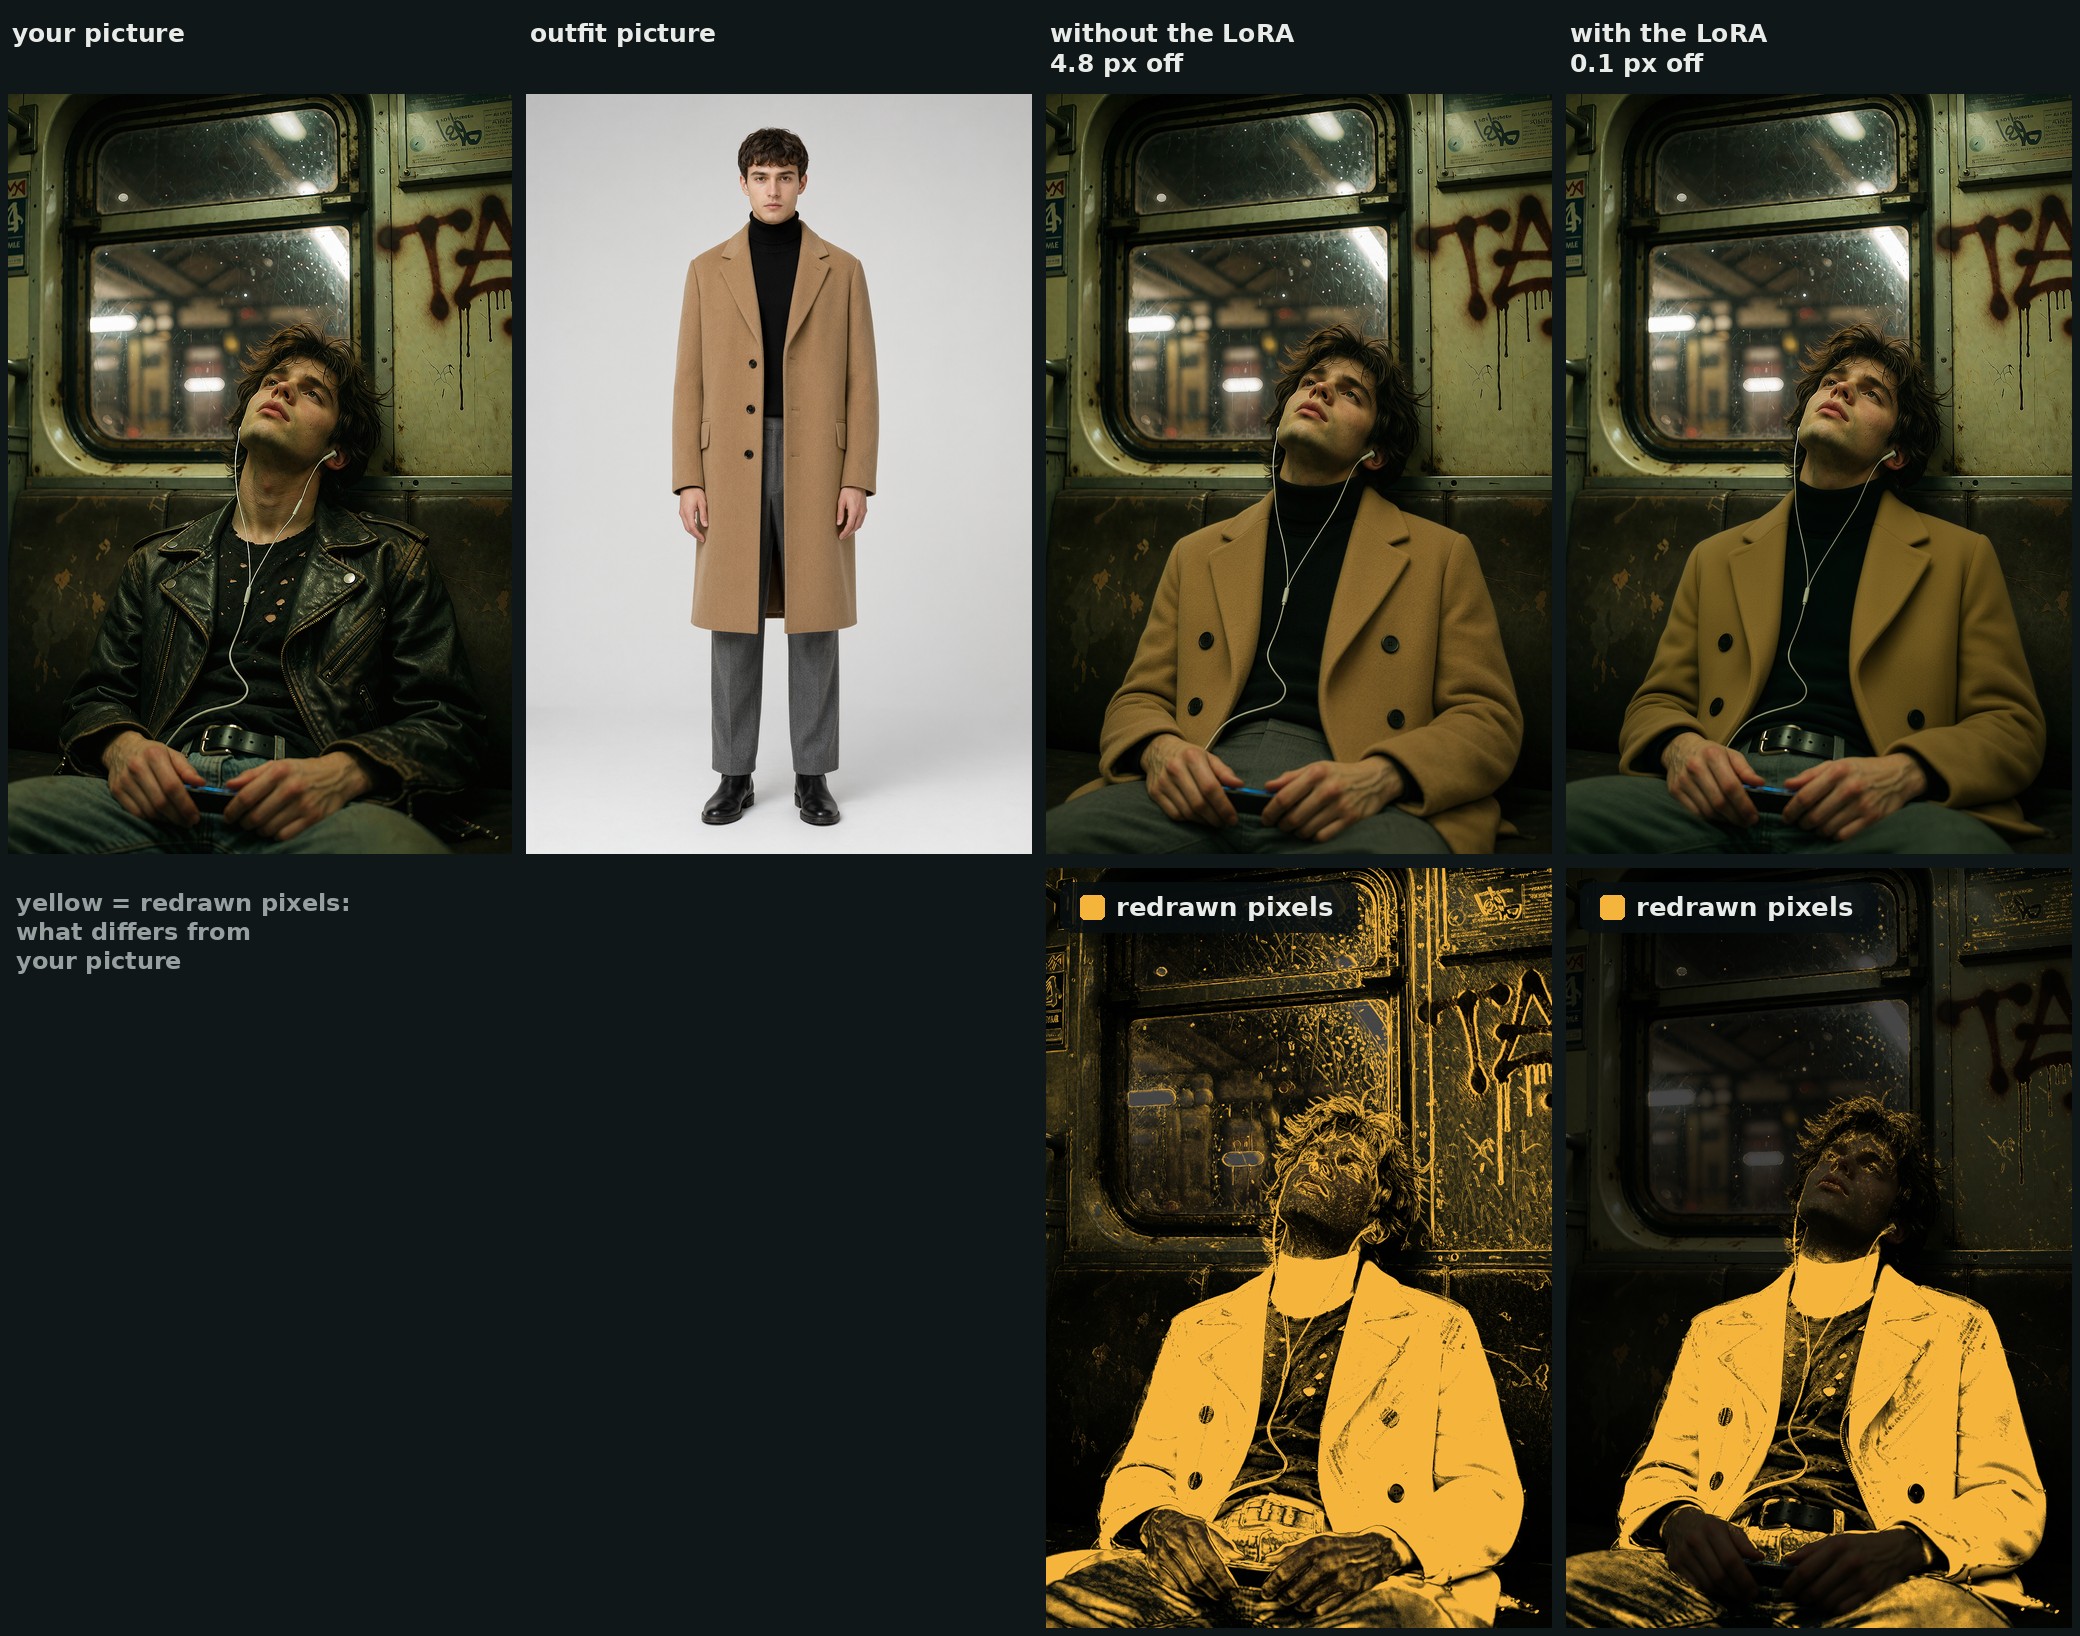
雨中的同一组对比。这个人不在训练集中。
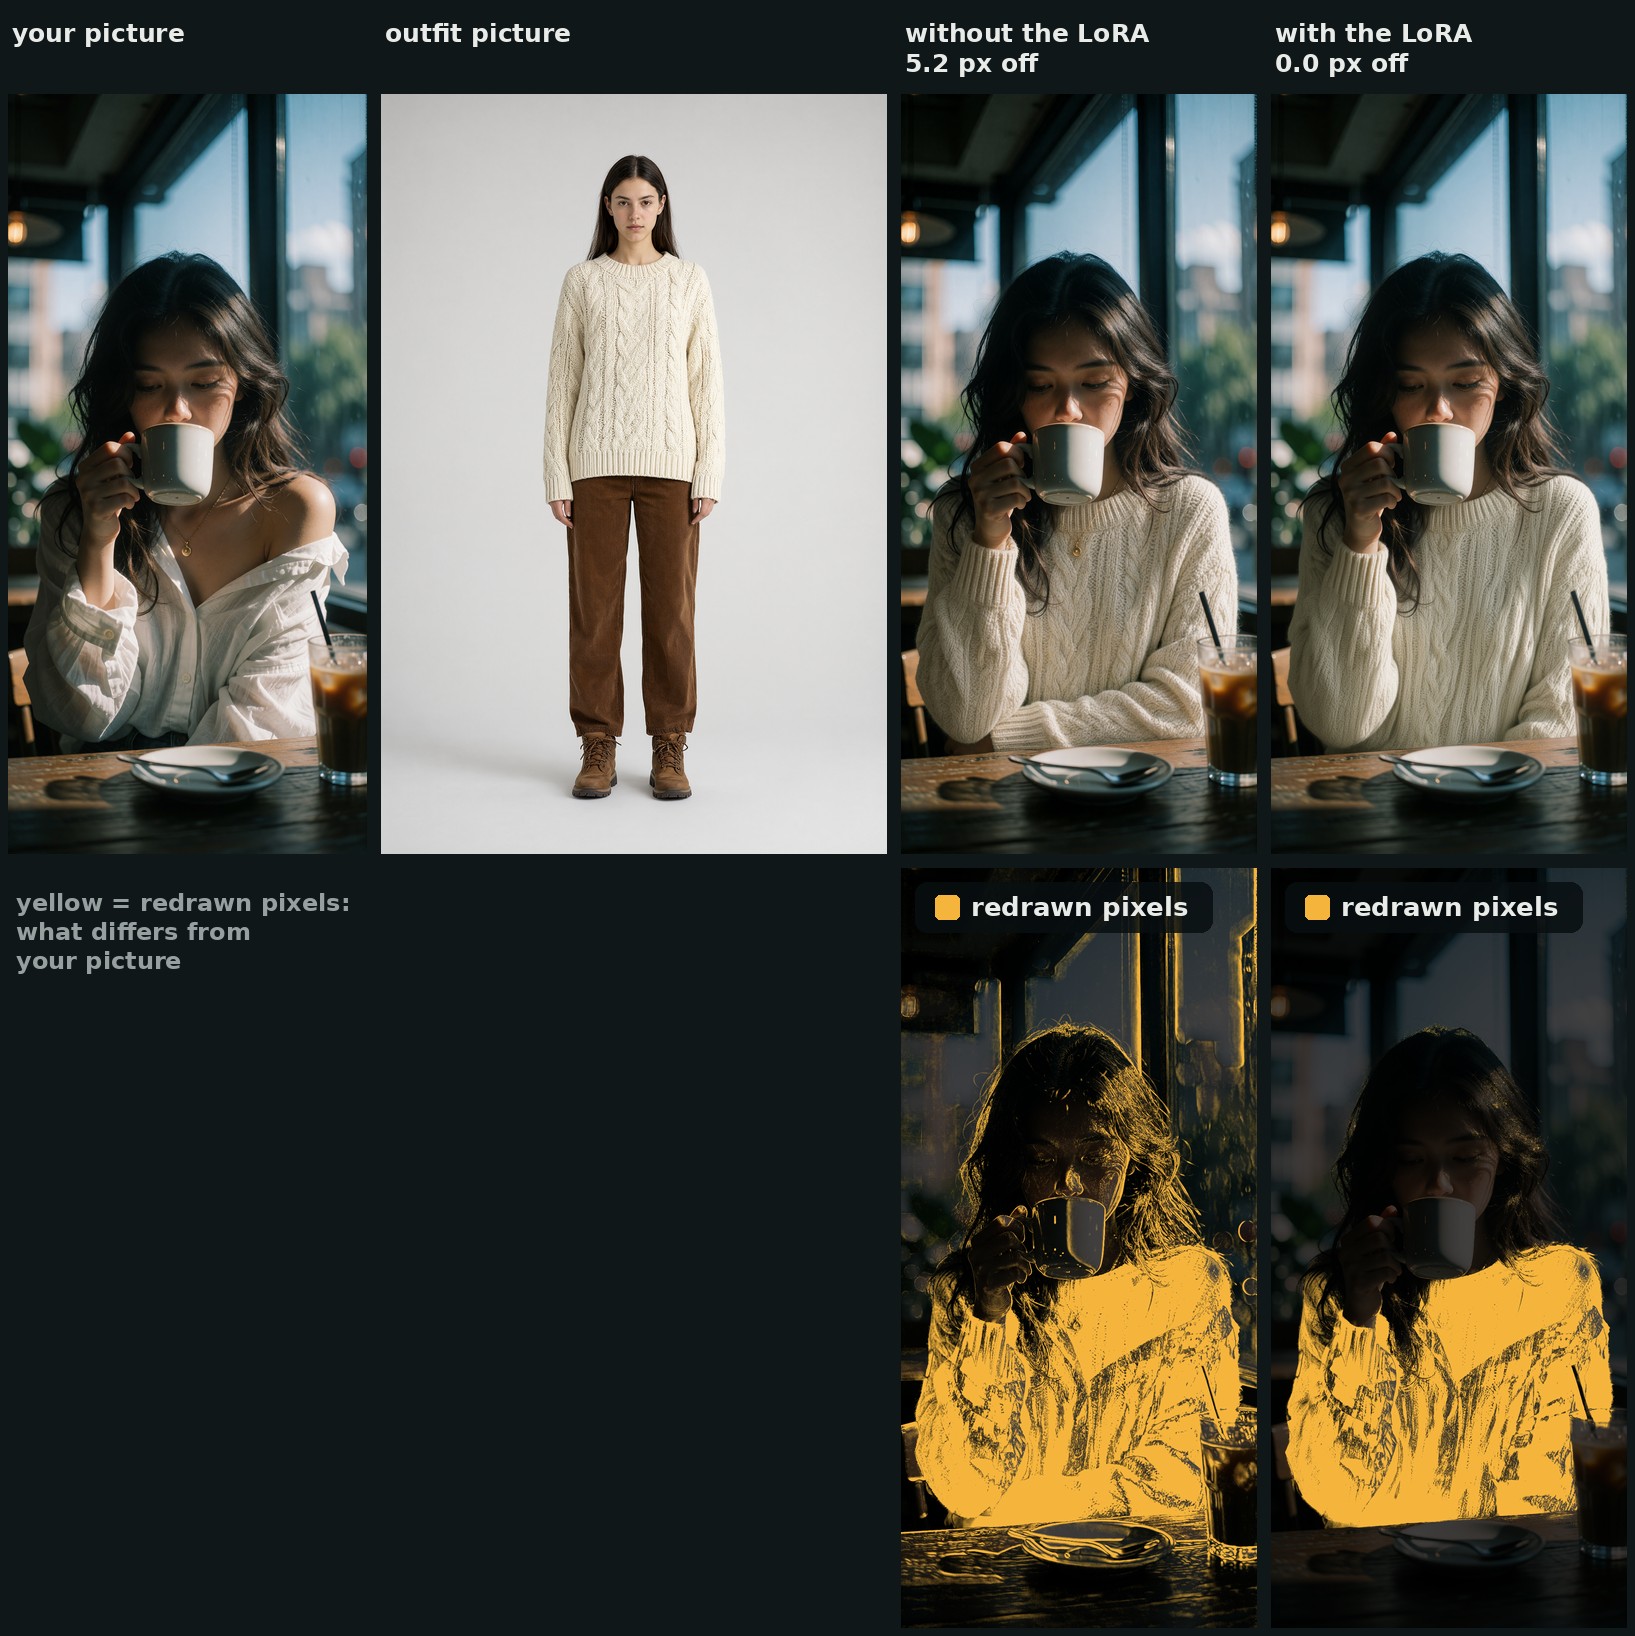
这个人同样不在训练集中。
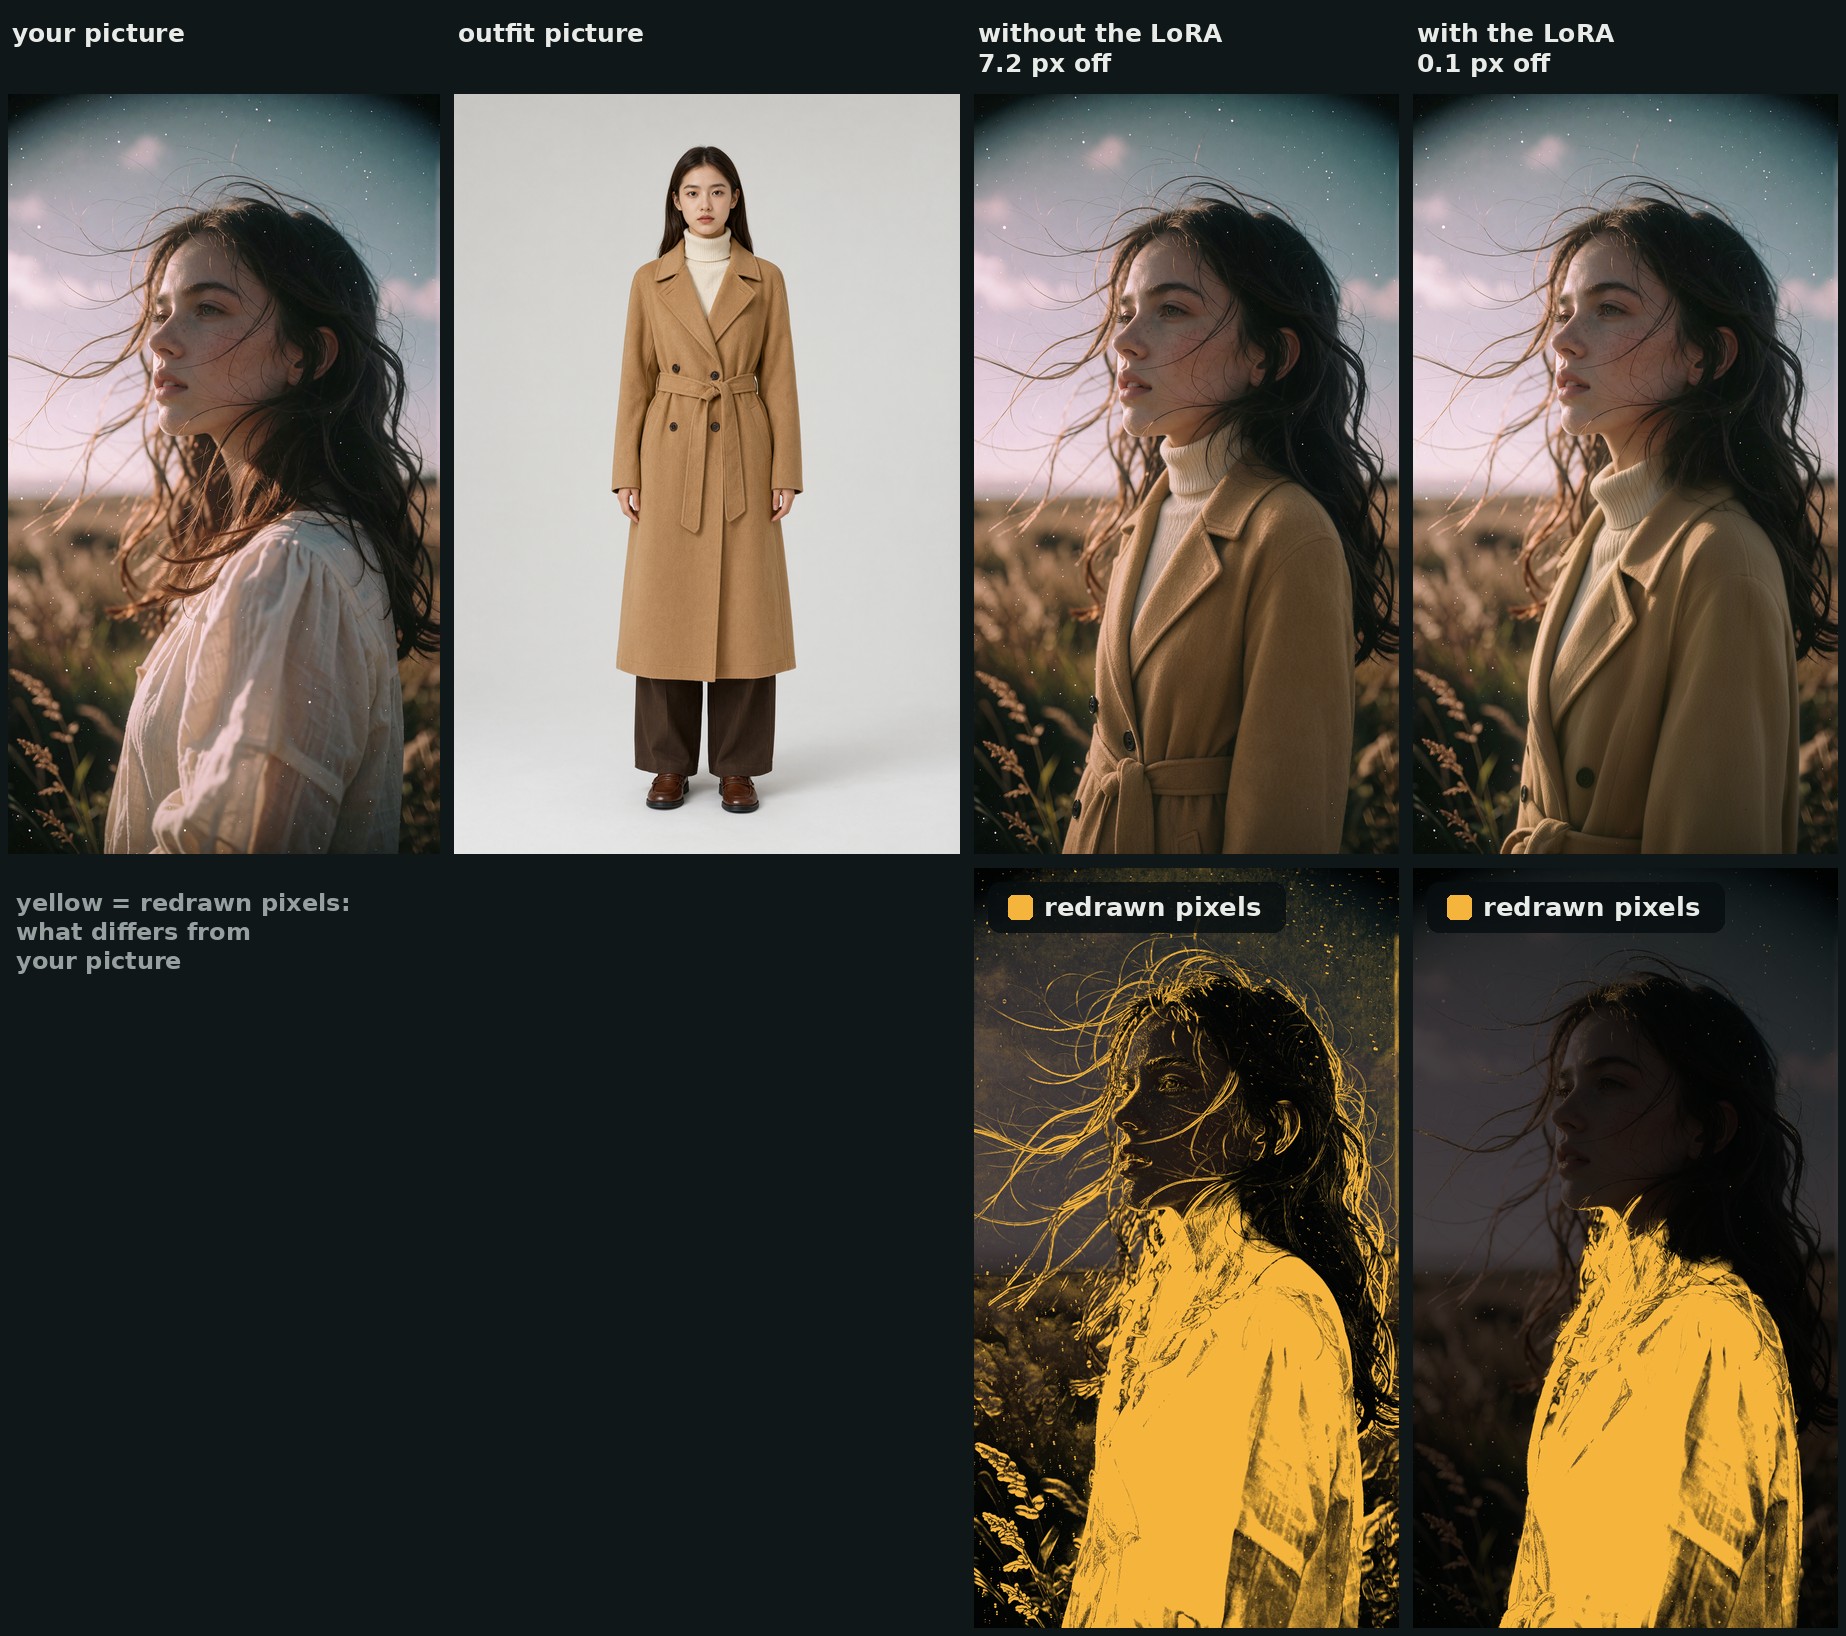
LoRA 从未针对这个人的换装进行训练,而这件外套也不在训练集中。
训练方式
数据集由真实的 Qwen-Image 2.1 换装结果构建,然后经过校正,让每个训练目标都落在其来源图片的画幅上。原始换装结果并不是理想的目标:它带有偏移、被柔化的面部和被重绘的背景,而在它之上训练的 LoRA 会把这些一并学进去。每个结果都以整像素为单位移回人物图片上(绝不重采样),只有衣服取自换装结果。面部、头发、手和背景重新变回人物图片自身的像素。在 66 个训练目标中,40 个来自开启作者更早的 Consistency LoRA 所做的换装,26 个来自普通换装;22 个需要整像素移动,目标中位数有 27% 的像素取自换装结果。
- 66 个训练对,使用 45 个不同人物和 31 套不同服装(穿着照、平铺图、产品图),其中四对留作测试。
- 训练: 使用 ostris/ai-toolkit,在 Comfy-Org INT8 ConvRot 基础模型上设置
arch: qwen_image_2,每个样本两张引用图(人物和服装),caption 的 dropout 为 0。Rank 32,alpha 32,AdamW8bit,lr 1e-4,batch 1,shifttimesteps,共 1,500 步,每 250 步保存一次模型,在一块 RTX PRO 6000 上训练,每步约 4.5 秒。
有一个训练器细节白白浪费了一次训练运行,已记录在仓库的 RESEARCH.md 中。AI-Toolkit 通过缩放和裁剪把训练目标塞进某个尺寸桶,但对引用图片则整张加载并挤压到 32 px 网格上。当图片形状不是桶形状时,两者就不再对齐:在 resolution: 1024 下,1056 x 1888 的图片对会落到 768 x 1344,于是目标损失 2% 的高度,而引用图反而被压缩 2%。第一次运行从 loss 上看训练正常,却产出了一个会把每张图片都拉高 1.6% 的 LoRA。修复出在导出环节而非训练器:把必须对齐的目标和引用图写成同一尺寸,两侧都取 32 的倍数。
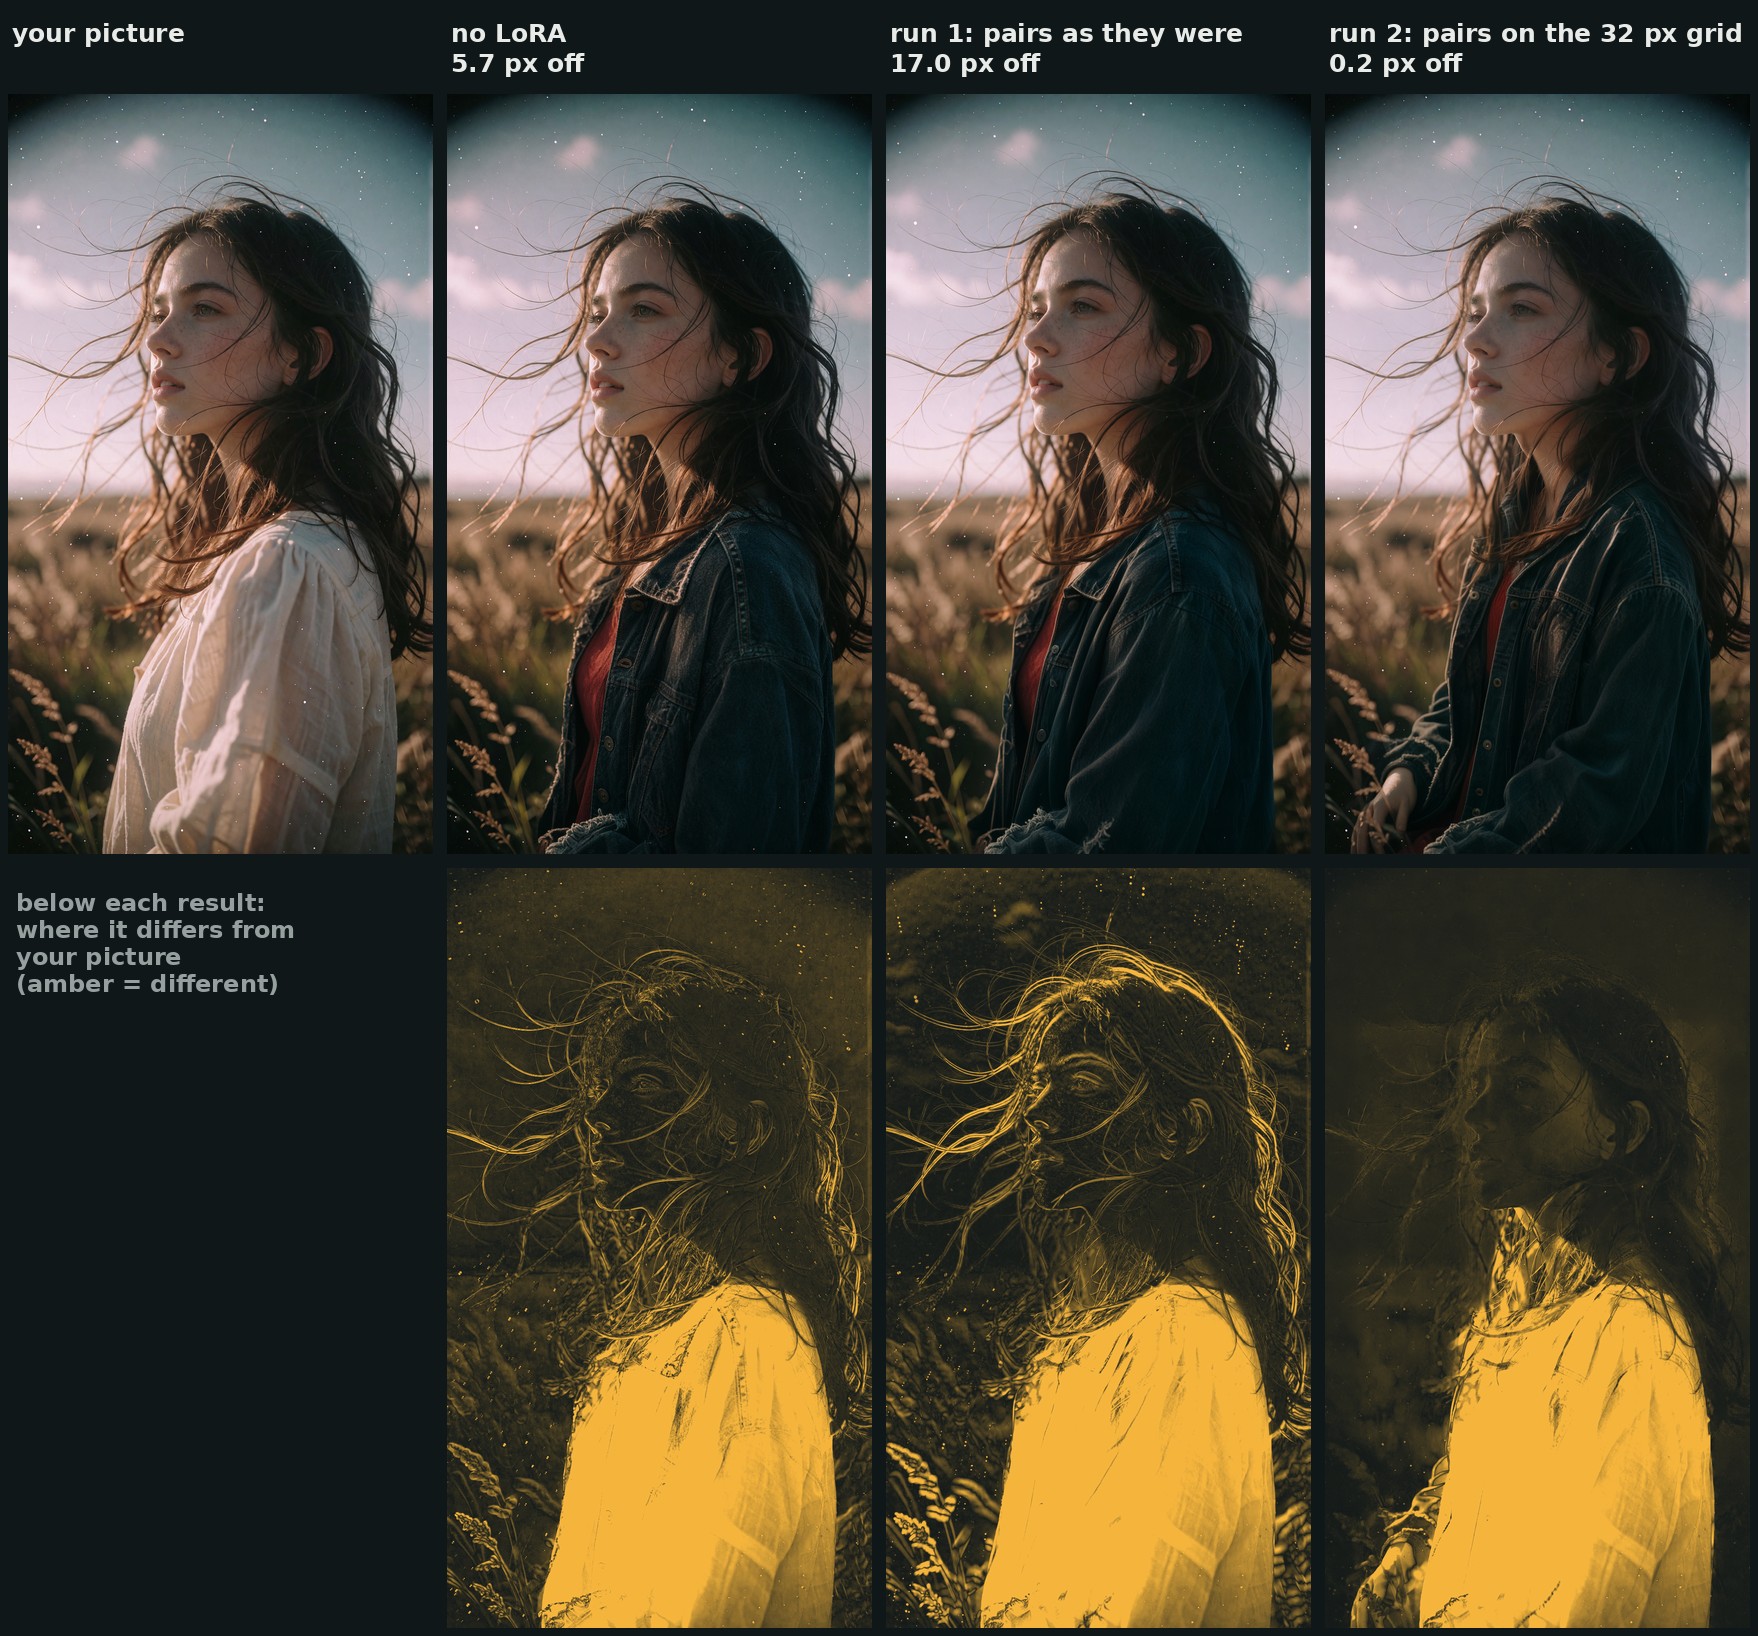
在第 250 步时,第一次运行会拉伸图片,所以一切都与原始图片不同。修复后的运行则不会。
限制
模型卡片直言这次发布的适用范围有多窄:
- 它绘制服装的效果并不比原版 Qwen-Image 2.1 更好。纽扣、腰带和图案仍会按原本的方式呈现,而且原版 Qwen 有时反而能复制更多服装内容:在上面第一组对比中,它连裤子也一并替换了,而这个 LoRA 则保留了原来的牛仔裤和腰带。
- 它会保留原本已有的内容,因此也会保留姿势。如果某套服装需要不同的姿势,它不会帮你换姿势。
- 鞋子是最难处理的部分。即便使用
Replace everything they wear.,在三次测试换装中仍有一次没能换掉鞋子。 - 早期检查点(step 250)在其中一次换装中画出了一只手,而原图中并没有这只手。step 500 到 1,500 的检查点在全部十六次中都未出现这种情况,但总共只检查了十六次。
- 训练分辨率约为 1 MP,测试分辨率约为 2 MP,25 steps,CFG 1。
- 搭配 Viggle Turbo LoRA 在 8 steps 下,它依然能保持画面稳定(五次换装中偏差 0.05 到 0.24 px),不过纯色面料可能会显得有点颗粒感。
- 覆盖在衣服之上的物件可能会随旧服装一起消失,也可能别扭地留在新服装上:夹克上的一根耳机线被移除了,而一条钱包背带搭在新夹克上看起来不对劲。
可用性
- LoRA 权重:ausboss/Qwen-Image-2.1-Outfit-Swap-Consistency-LoRA
- 基础模型重新打包版:Comfy-Org/Qwen-Image-2.1
- 作者的节点包:ausboss/ComfyUI-AusBoss
评论
使用 GitHub 登录后即可参与讨论。