Zen Image Edit:在 ComfyUI 中用 0.8B 编码器运行 Qwen-Image 2.1
Zen Image Edit 让 Qwen-Image 2.1 运行在 Qwen3.5-0.8B 文本编码器加 158M 融合适配器上,将编码器从 17.5 GB 缩减到 1.7 GB,并提供两条 ComfyUI 路径。
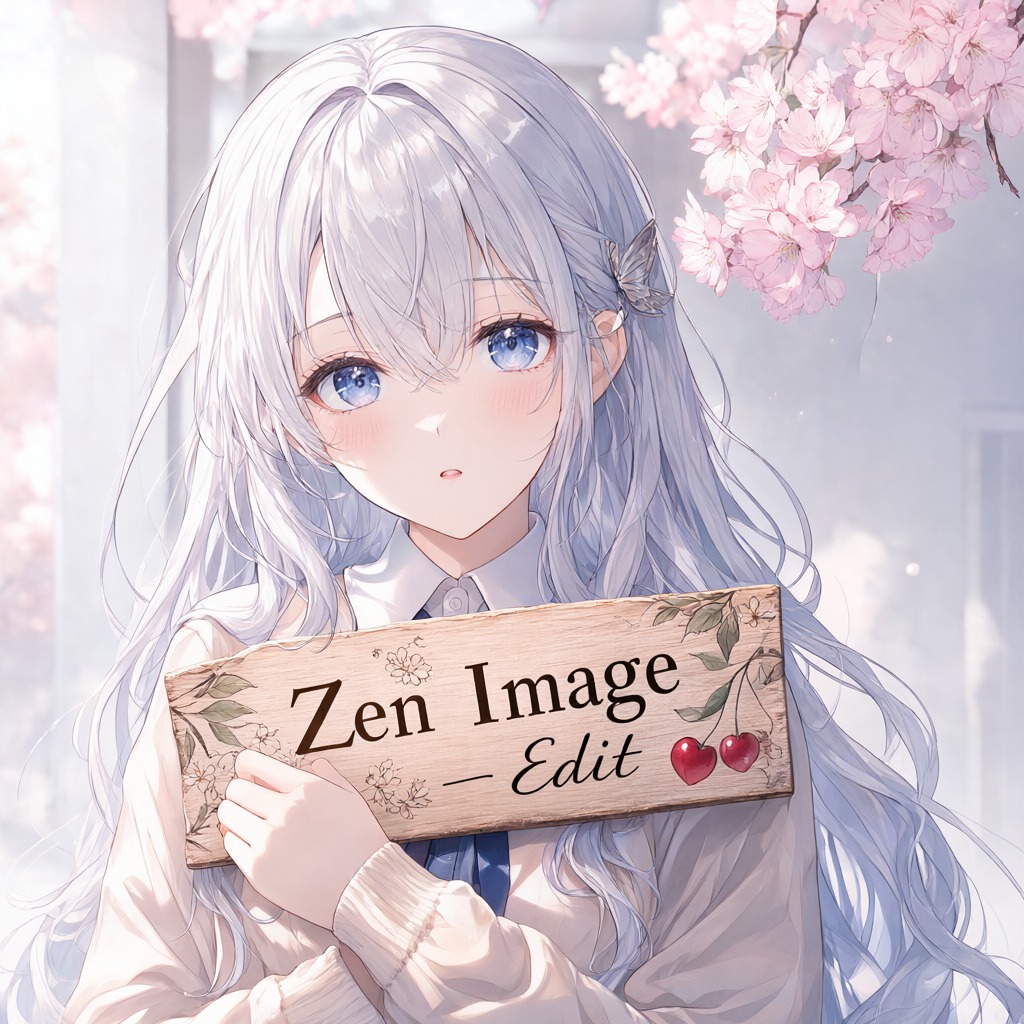
1024 px、30 步的文生图,由该 pipeline 生成。来源:AiArtLab/zen-image-edit。
Zen Image Edit 改变了什么
Qwen-Image 2.1 的条件堆栈正是它难以常驻内存的原因:基础模型的文本编码器是 fp16 下约 17.5 GB 的 Qwen3-VL-8B,还必须与 14.5 GB 的 DiT 并排驻留。Zen Image Edit 用一个小型多模态编码器和一个适配器取而代之,后者模仿大编码器的输出,无论输入是纯文本,还是文本与参考图像一起读取。
| 组件 | Zen Image Edit |
|---|---|
| Transformer | Qwen-Image 2.1 DiT,32 层,fp16 下 14.5 GB,已合并 158M 文本融合适配器 |
| 文本编码器 | Qwen3.5-0.8B,fp16 下 1.7 GB,tokenizer 和 processor 保持不变 |
| 条件保真度 | 相对原生 Qwen3-VL-8B 编码器,文本余弦为 0.95,编辑提示词的视觉位置余弦为 0.97 |
| VAE | 微调的 Qwen-Image 2.1 解码器,16x 空间,fp32 |
| Scheduler | FlowMatchEulerDiscreteScheduler,固定静态 shift 5.0 |
| 峰值显存 | 约 17.5 GB 常驻,使用 enable_model_cpu_offload() 后更低 |
适配器作为文本融合块位于 DiT 内部,因此整个模型就是一个自包含的 Diffusers 文件夹,任何地方都不再需要单独的 17.5 GB 编码器。采样器运行固定静态 shift 5.0,而不是基础模型的动态 shift。
随附的适配器是 v12 修订版。其注意力分支的位置表覆盖 2,304 个槽位,并且它是在真实的 1024 px 编辑几何上微调的,因此长参考序列能保持各自的位置,而不会落入零填充的尾部。这使相对原生编码器的视觉余弦从 0.93 提升到 0.97,而文本仍保持 0.95。
微调的 VAE
随附的解码器并非原版 Qwen-Image 2.1 的解码器。它是在 madebyollin/texture-fix-vae-for-qwen-image-2.1 基础上构建的仅解码器微调版本,训练目标是消除 nearest-exact 上采样锁定进输出步长的 2 px 网格。只有解码器经过训练,共 5,300 步,并增加了一个额外的损失项:重建结果与目标 2x2 子格均值之间的峰峰值差值。被忠实复现的内容对该项贡献为零,因此只有新增的网格会受到惩罚。编码器与原始版本逐位相同,因此 Latent 空间保持不变。
| 解码器 | PSNR | LPIPS | 网格 (/255) |
|---|---|---|---|
| 原始 Qwen-Image 2.1 | 33.073 | 0.05316 | 2.631 |
| texture-fix | 32.840 | 0.05388 | 0.125 |
| 本 VAE | 33.397 | 0.05291 | 0.000 |
在 32 张留出图像上以 512 px 进行重建。模型卡片指出,该网格在 100% 缩放下并不可见,因此它以测量而非肉眼判断为准。
示例
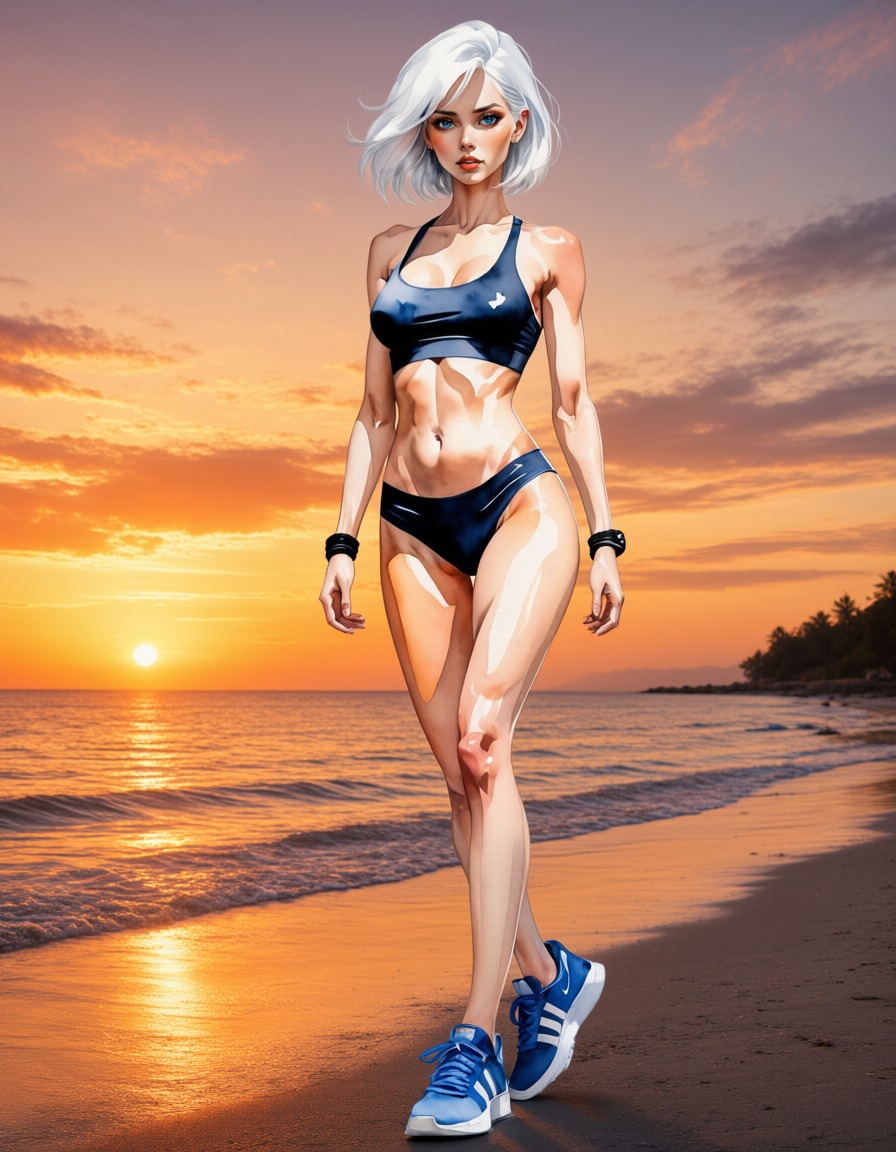
使用一张条件图像进行编辑:背景改变,主体保留。
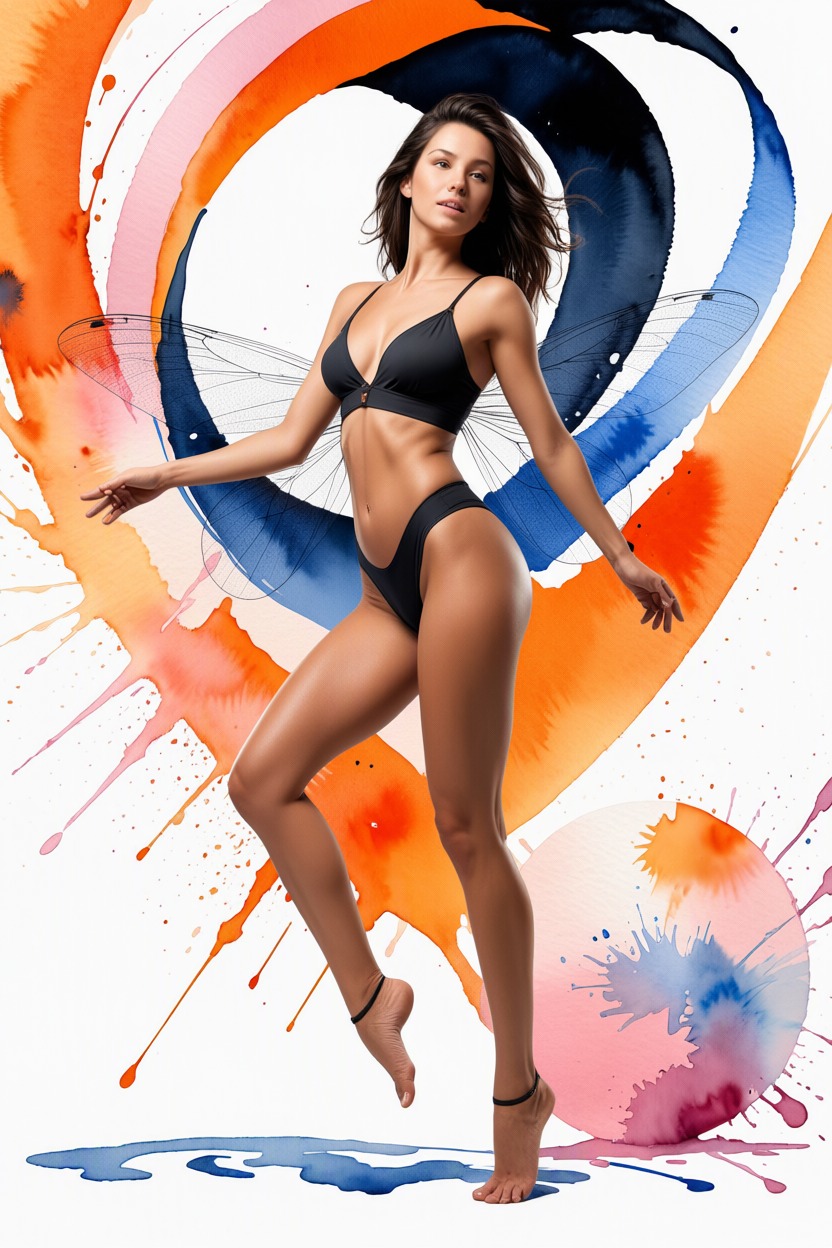 | 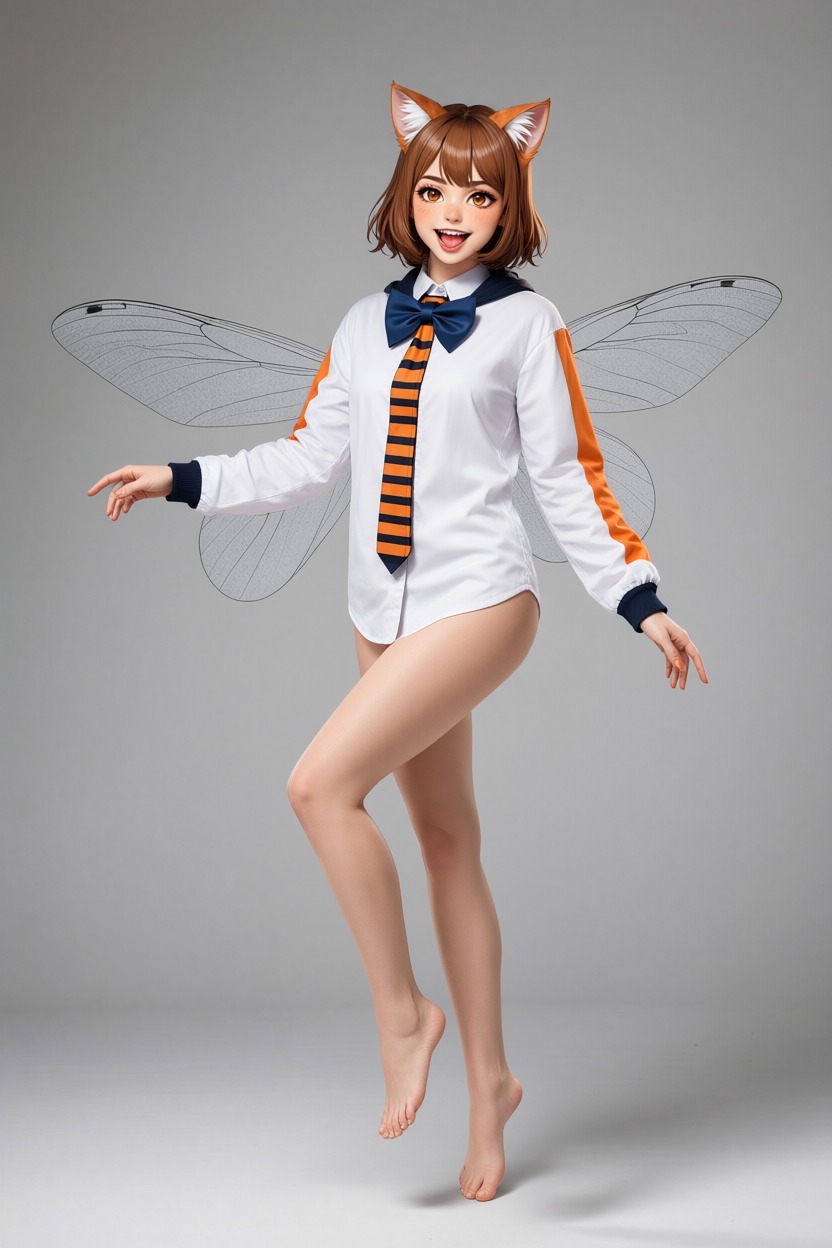 |
|---|---|
两张条件图像:<image1> 保持其姿态、服装和场景 | 身份从 <image2> 复制而来 |
编辑遵循基础模型的约定:第一张图像是被编辑的对象(<image1>),其后所有图像都是引用。模型卡片指出,把引用放在第一位是角色替换“没有发生”的常见原因,因为那样模型会转而编辑引用图像。
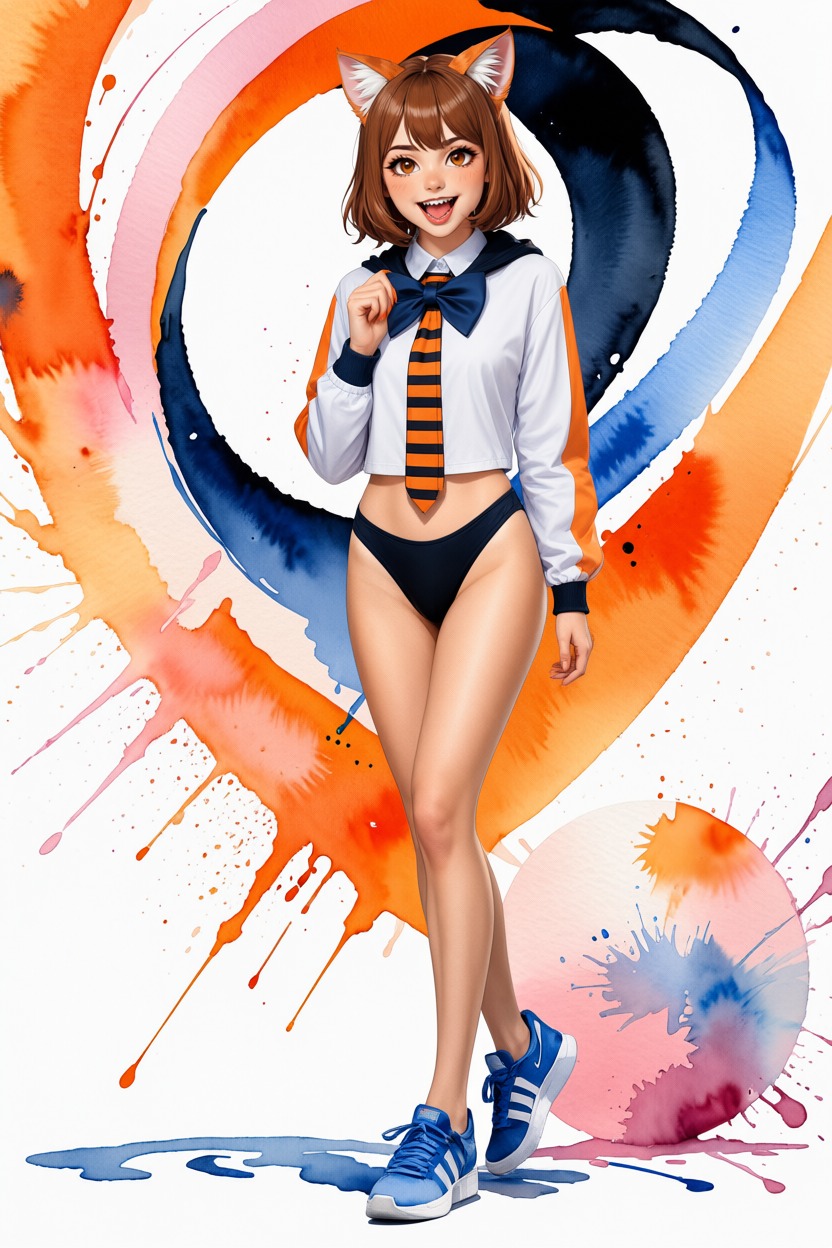
三张条件图像:目标和构图来自 <image1>,人物来自 <image2>,色彩和光照来自 <image3>。
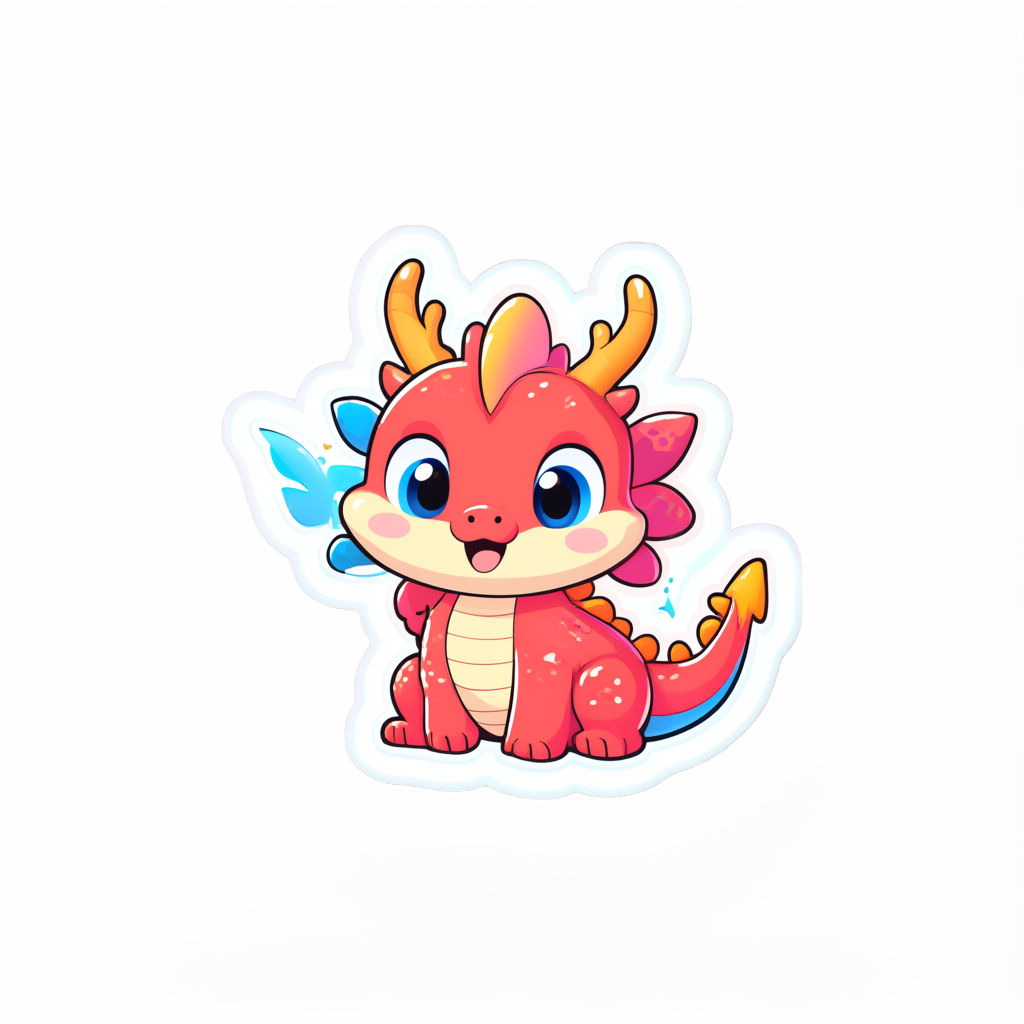
透明(RGBA)生成走的是同一条 pipeline。
在 ComfyUI 中运行
有两条独立的 ComfyUI 路径,两者都不需要 17.5 GB 的编码器。
节点包:recoilme/zen-image-edit-comfyui。 DiT、VAE、采样器和前缀 KV 缓存都保持 ComfyUI 原版(需要支持 Qwen-Image 2.1 的构建版本),该节点只提供小型编码器和适配器:
- 将
adapter_v12.safetensors(0.64 GB)下载到ComfyUI/models/。 - 将
qwen_image_2.1_bf16.safetensors放入models/diffusion_models/,将qwen_image_2.1_vae_bf16.safetensors放入models/vae/,两者均来自 Comfy-Org/Qwen-Image-2.1。 - 获取文本编码器:
hf download Qwen/Qwen3.5-0.8B --local-dir ComfyUI/models/text_encoders/qwen3.5_0.8b。 - 重新启动 ComfyUI。它需要
transformers >= 5.17。
作者报告,与同一文件夹的 Diffusers 构建相比余弦为 1.0000,并且两个示例图都经过了端到端验证。
单文件 checkpoint:T8mars/comfyui-Zen-Image-Edit-T8。 可通过 ComfyUI Manager 安装,这条路径将 DiT、VAE、Zen 编码器、融合适配器和 tokenizer 资产打包进一个 zen_image_edit_qwen21_single.safetensors checkpoint,发布为 t8star/Zen-Image-Edit-Comfy。其加载器返回 MODEL、CLIP 和 VAE,因此无需单独下载,而仅 CLIP 的加载器可与原生 diffusion 和 VAE 加载器配合使用。该转换已在 ComfyUI 0.37.0、24 GB 的 RTX 5090 Laptop 上,对文生图和图像编辑图进行了验证。同一仓库还将 Viggle turbo adapters 重新发布为可在 ComfyUI 内置节点中加载的 LoRA,并附带工作流。
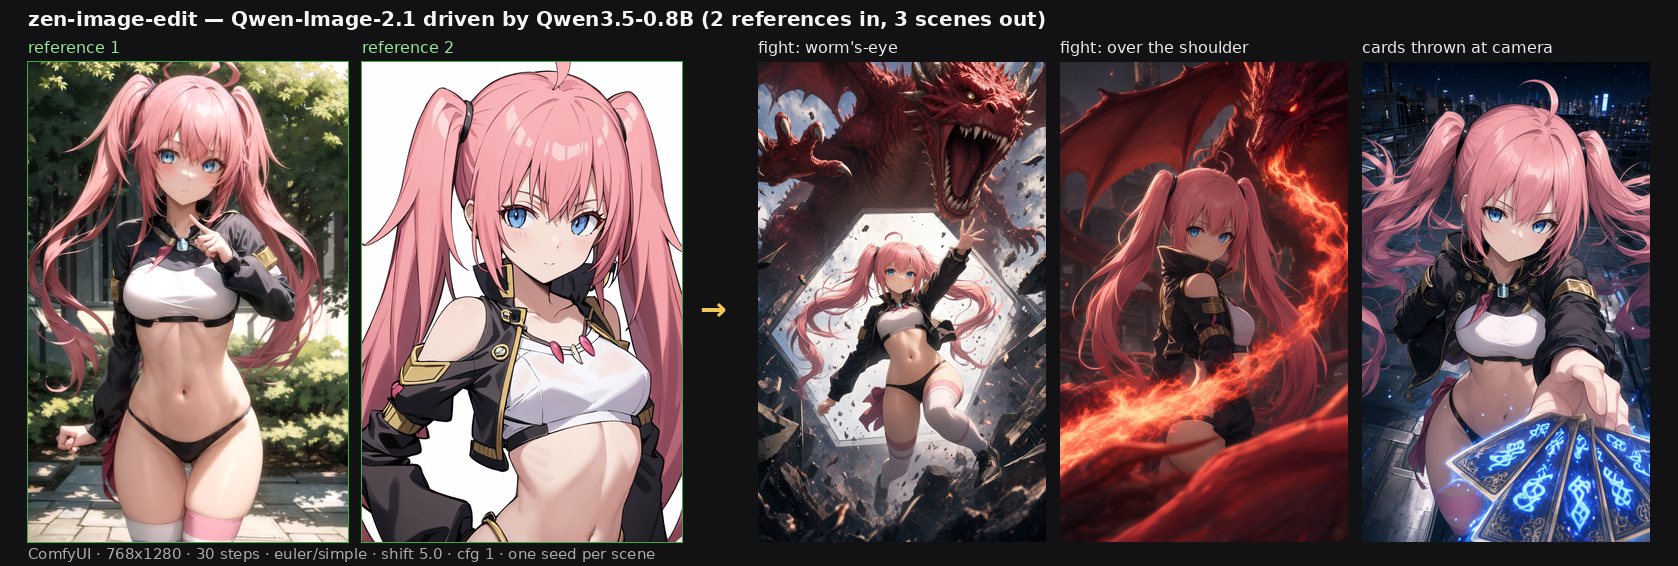
输入两张角色引用,输出三个场景,通过 ComfyUI 节点以 768x1280 生成。来源:recoilme/zen-image-edit-comfyui。
已记录的局限
模型卡片列出了这些短板,而不是留给用户自己去发现:
- 仅限英语。 适配器只在这种语言上训练和测试,其他语言会产生漂移。
- 标牌上的数字。 在尝试的所有种子下,“OPEN 24 HOURS”都会被渲染成“OPEN 26 HOURS”。文字部分没问题。
- 非摄影类引用的迁移保真度低于摄影类引用,因为适配器模仿的是原生编码器,也就继承了它的上限。
- 在 1024 px 下批大小大于 1 时峰值接近 28 GB,因此每次调用一个提示词是安全的做法。
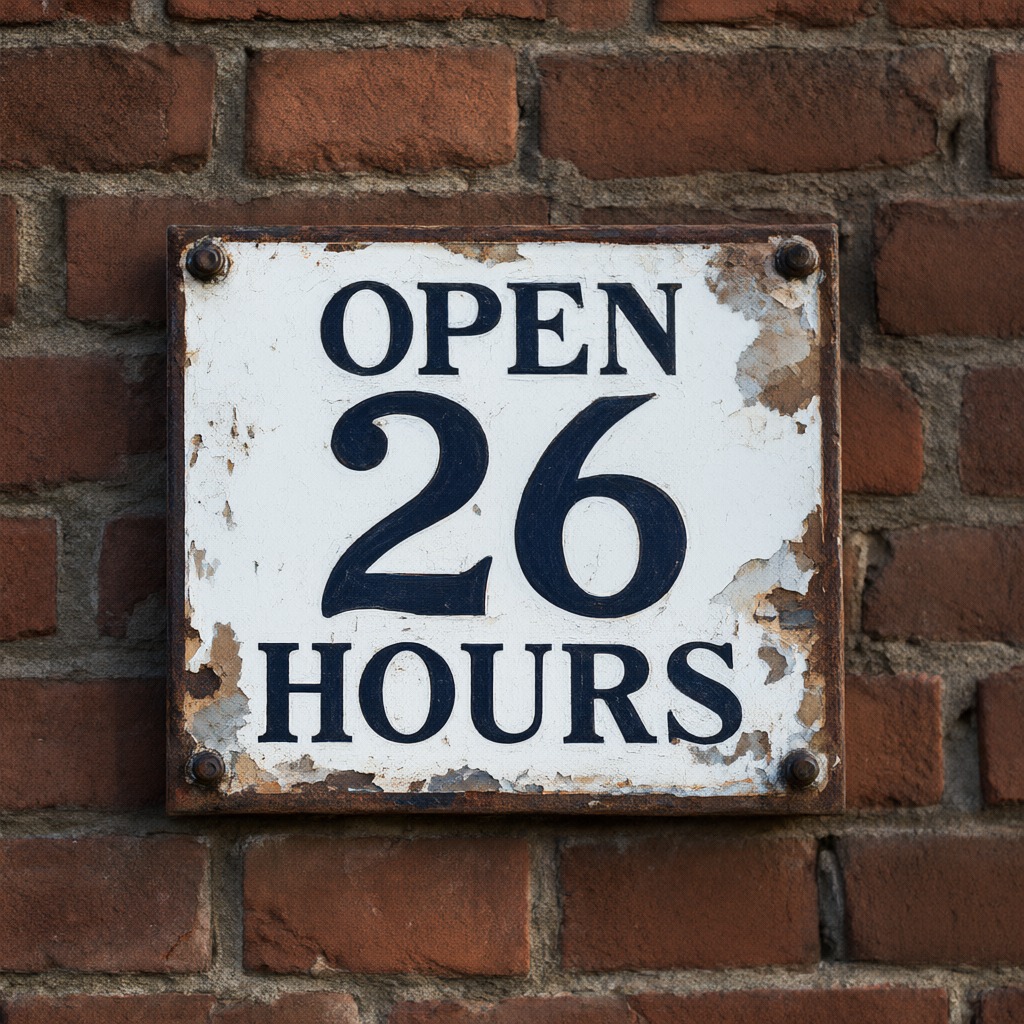
文字渲染正确,标牌上的数字则不正确。来源:AiArtLab/zen-image-edit。
可用性
权重发布为 AiArtLab/zen-image-edit。对于 16 GB 显卡,recoilme/zen-image-edit-gguf 提供了 GGUF Q5_K 构建,可在运行时将 transformer 从 13.55 GiB 降到 4.52 GiB。运行 Diffusers pipeline 需要支持 Qwen-Image-2.1 构建的 diffusers 以及 trust_remote_code=True。
评论
使用 GitHub 登录后即可参与讨论。