Prism:2K 音视频联合生成,训练速度提升 2.5 倍
ComfyUI Wikinews
来自复旦大学、腾讯混元与浙江大学的 Prism 采用动态稀疏注意力训练 2K 音视频联合生成模型,速度比全注意力快 2.5 倍,并已发布预览权重。
Prism 是复旦大学、腾讯混元与浙江大学联合提出的训练框架,用于在 2K 分辨率下原生训练视频与音频联合生成模型。其动态稀疏注意力将训练速度提升至全注意力的 2.5 倍,同时产出质量更高。技术报告、训练与推理代码以及两个预览模型均已公开。
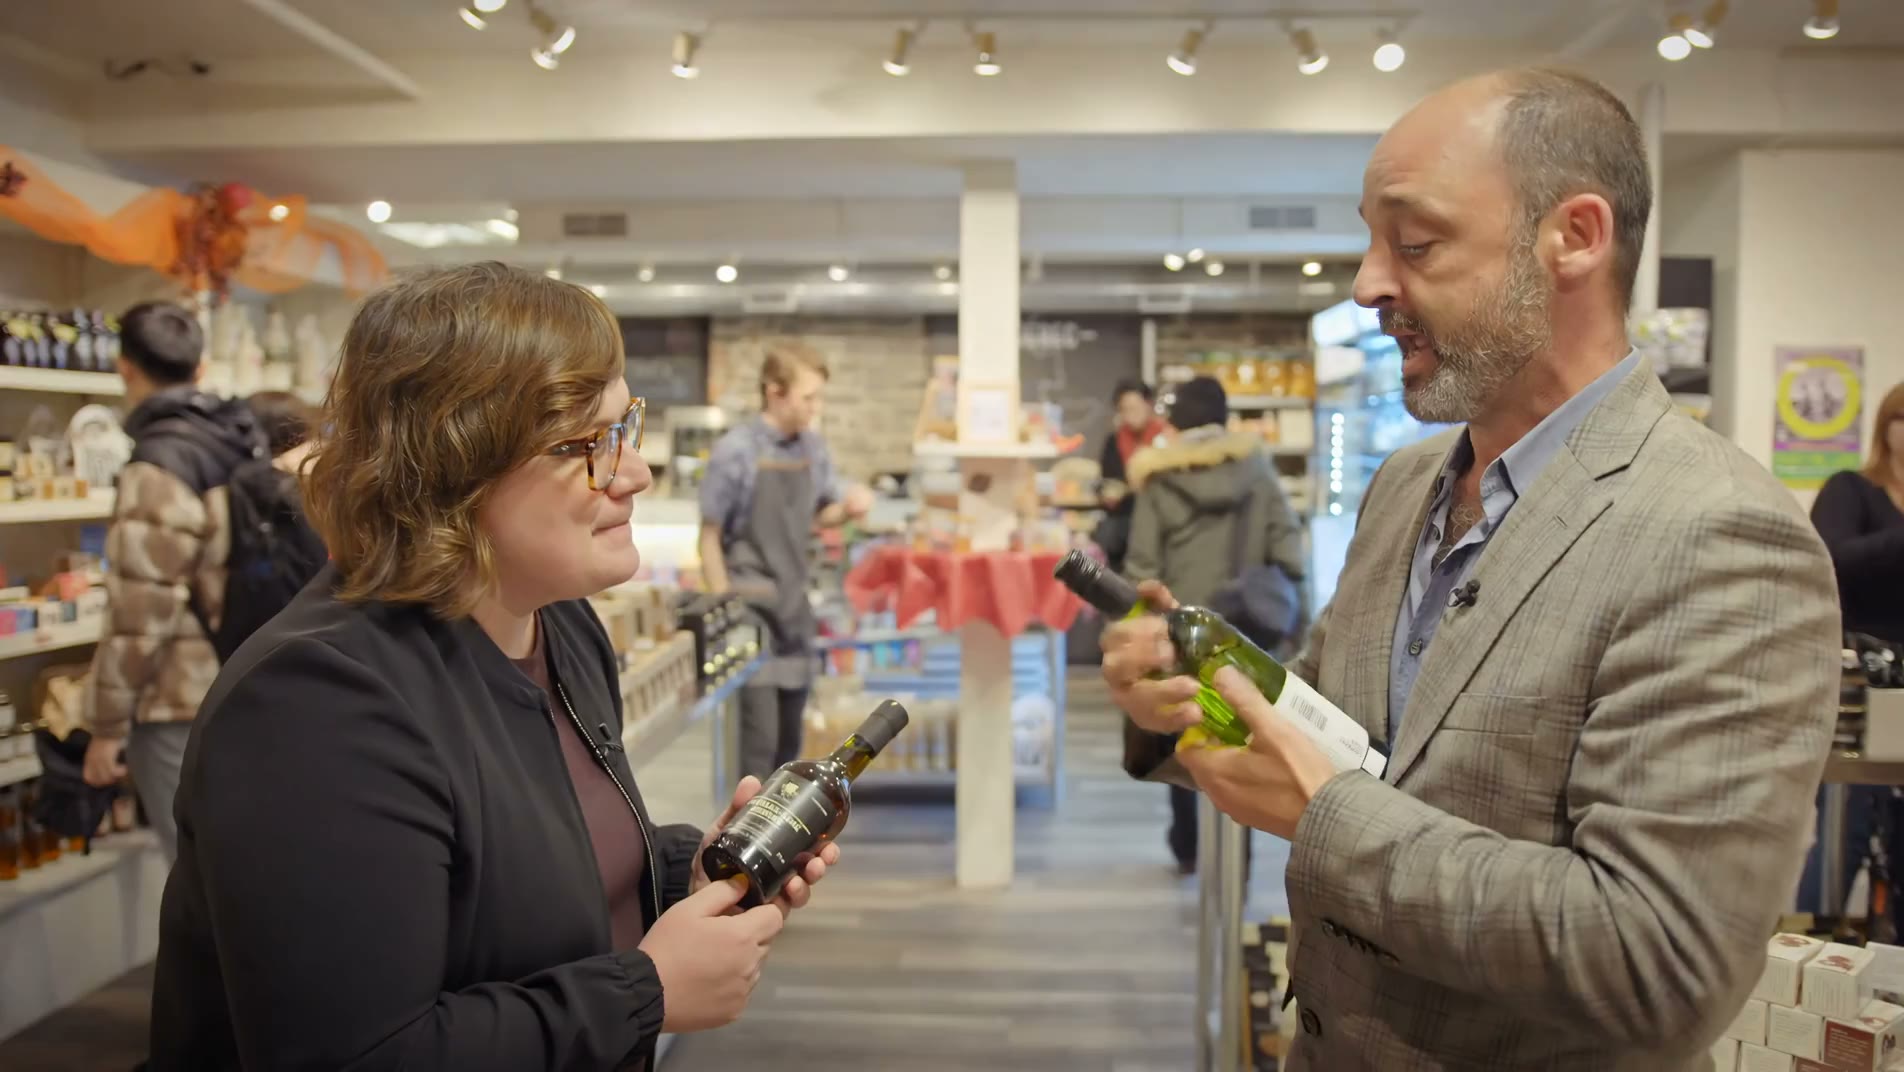
使用已发布预览模型生成的示例。
Prism 的工作原理
原生高分辨率训练是音视频联合模型学习更精细视觉细节和更锐利运动的方式,但全注意力随序列长度呈二次增长,在 2K 下还会把注意力分散到大量冗余 token 上。Prism 保留了分辨率,转而改变注意力机制。
该方法将 token 序列组织为时空宏区域。对每个区域,它通过两个信号估计局部信息结构:
- 沿通道维度的视频特征方差,反映视觉内容在各个方向上的变化快慢。
- 音频到视频交叉注意力产生的特征范数,反映音频对每个视觉区域的影响强度。
这些信号决定每个区域的块形状:在视觉内容变化快或视听耦合强的轴上划分得更细,其他位置划分得更粗。其目标是让块内的 token 保持语义连贯,从而使块级特征同时携带视觉内容与音视频联合交互信息。随后,一种混合块选择策略(top-k 结合 top-p CDF 阈值)为每个 query 设定稀疏度。
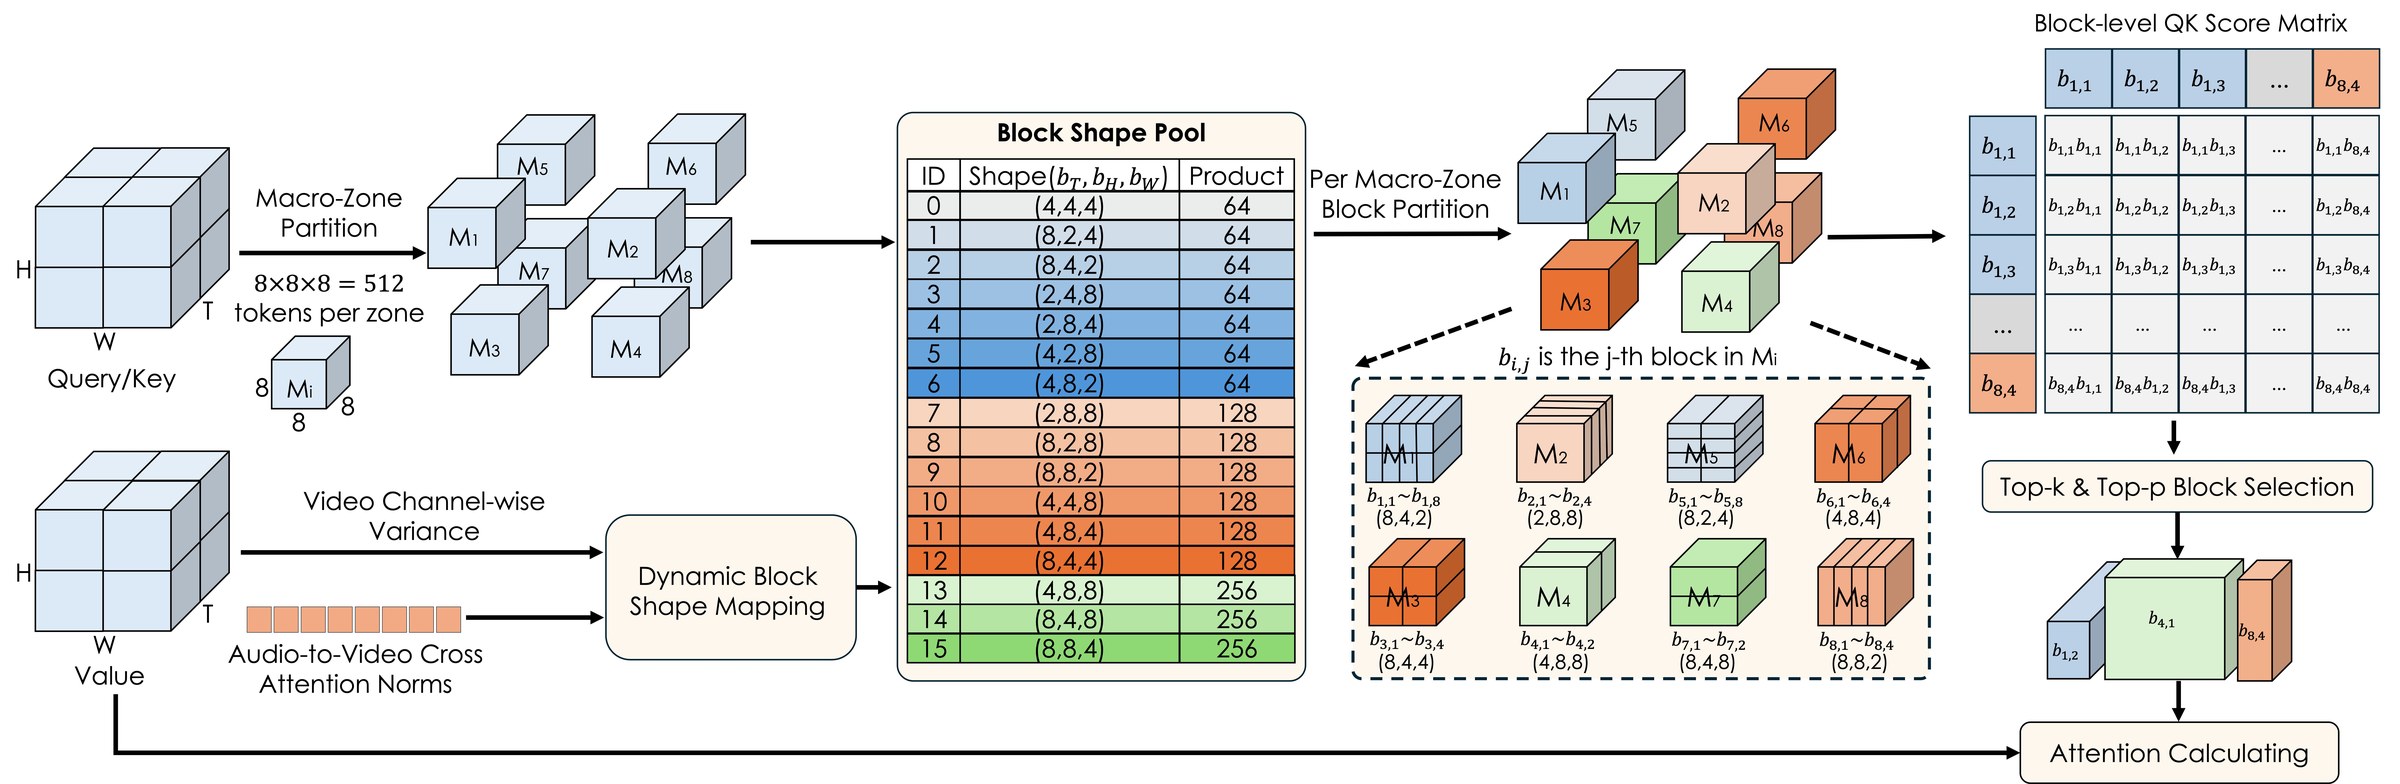
Prism 框架,来自官方模型卡片。
发布内容
该项目交付的是一整套训练与推理方案,而非单个模型:
- 预览模型。
Prism-preview-alpha(稳定版)与Prism-preview-beta(运动)基于 MOVA 架构构建,支持 720p、1080p 和 2K 的原生音视频联合生成。 - 代码。 包含带 Latent 提取与解码的数据预处理、训练、全量微调和推理,以及用于多节点运行的分布式启动脚本。
- 报告。 技术报告已发布在 arXiv 上,模型卡片和仓库中均有链接。
由已发布预览模型生成的样例。
已发布的模型还支持以引用图像为条件,实现图像到音视频的生成:
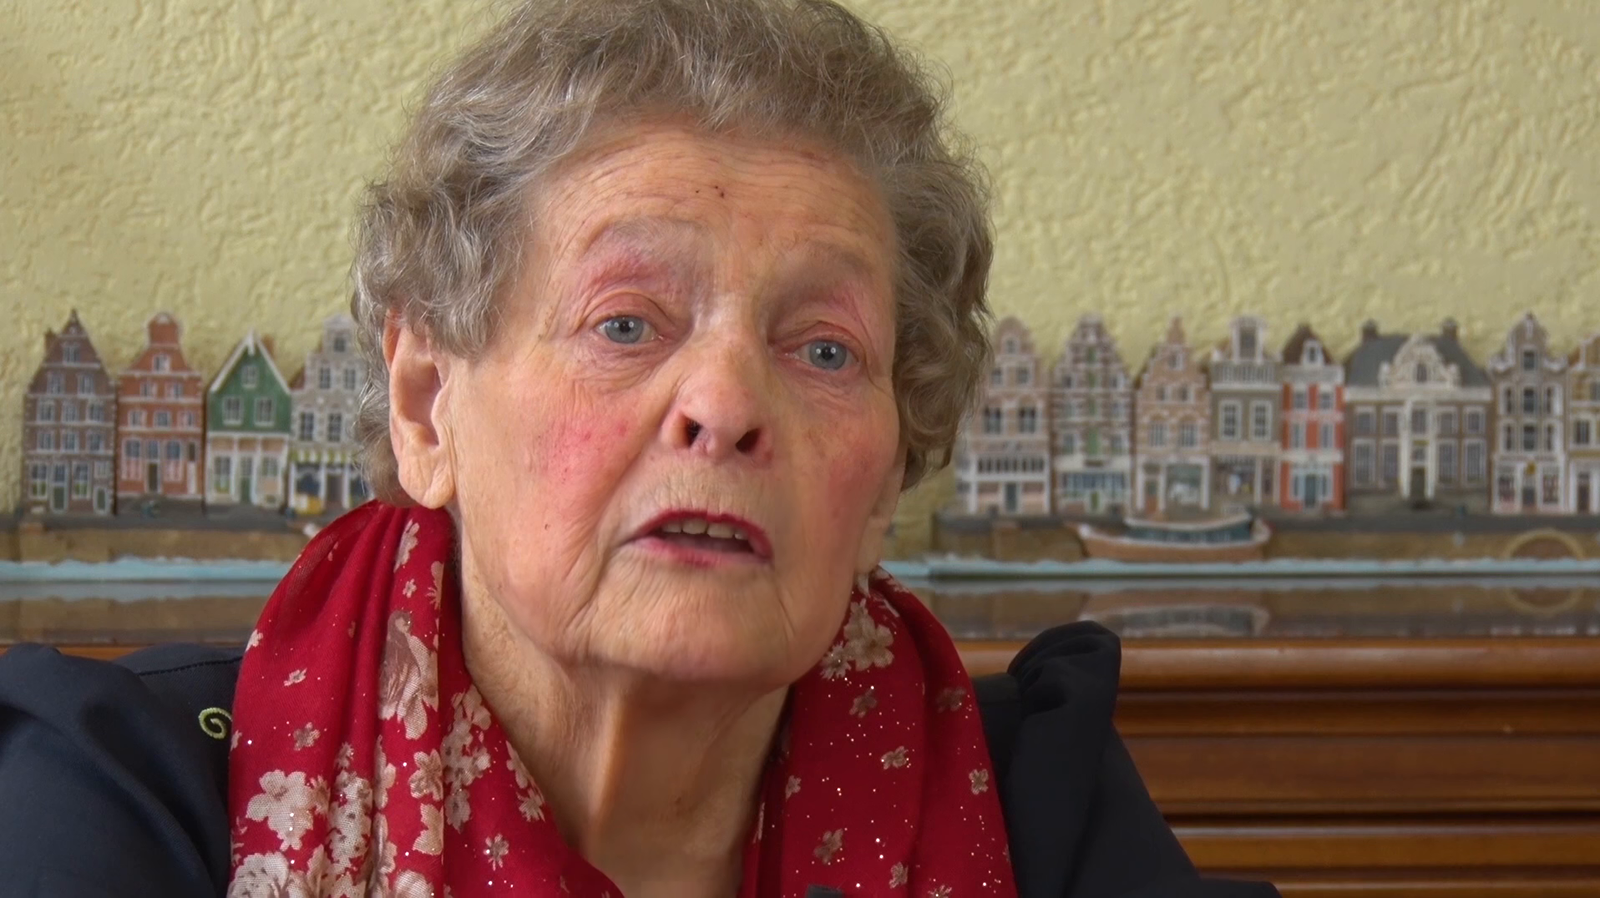 | 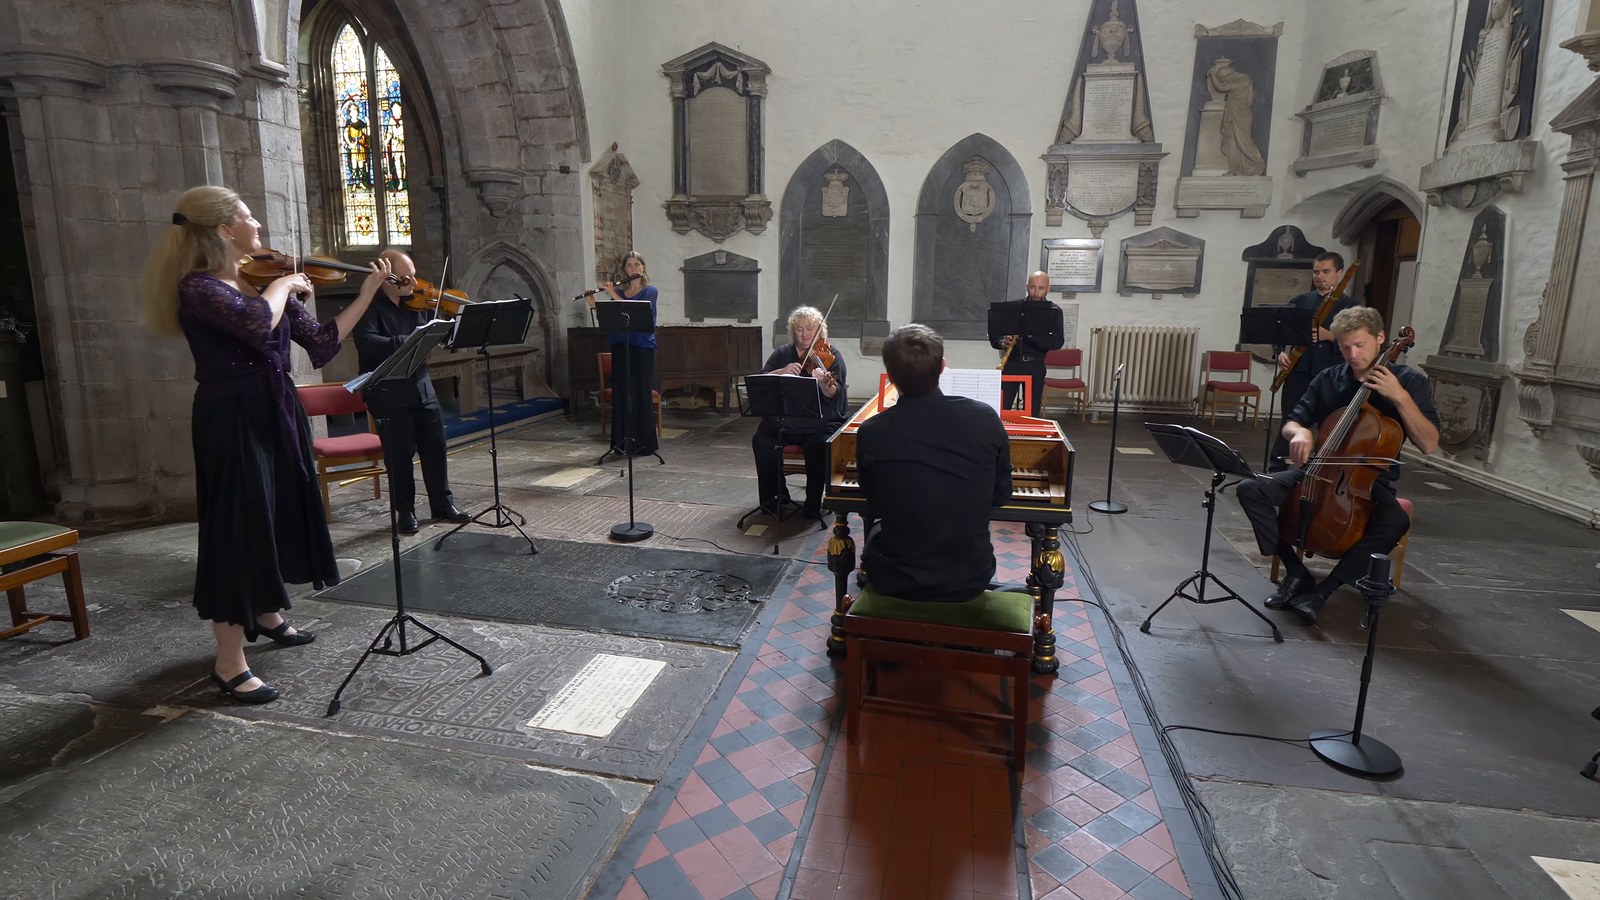 |
|---|---|
| 官方图像到音视频案例输入 | 官方图像到音视频案例输入 |
Prism-pro 模型被列为项目路线图中的剩余项,目前尚未发布。
获取方式
预览权重已发布在 Hugging Face,代码和脚本位于 Tencent-Hunyuan/Prism,报告见 arXiv。目前推理需要通过项目自带的 PyTorch 脚本运行;尚无 ComfyUI 节点或打包好的 ComfyUI 模型,因此要在本地运行,只能直接使用官方仓库。
评论
使用 GitHub 登录后即可参与讨论。