FastH3 Trim:为 8 GB GPU 打造的剪枝版 8 步 MiniMax H3
FastVideo 发布 FastH3 Trim,这是一个移除 8 个块的 42 块剪枝版 MiniMax H3,可在低至 8 GB 的 GPU 内存中运行带音频的 8 步视频生成,并提供 ComfyUI 重打包文件。
Trim 改变了什么
基础 H3 由三个网络组成:一个 Qwen3-VL 文本编码器、一个将视频与音频 latent 一起去噪的 50 块 diffusion transformer,以及两个 VAE。以 BF16 计算是 137.7 GiB,无法装入 32 GB 显卡。FastH3 V2 通过量化把它缩小;Trim 还移除了块。
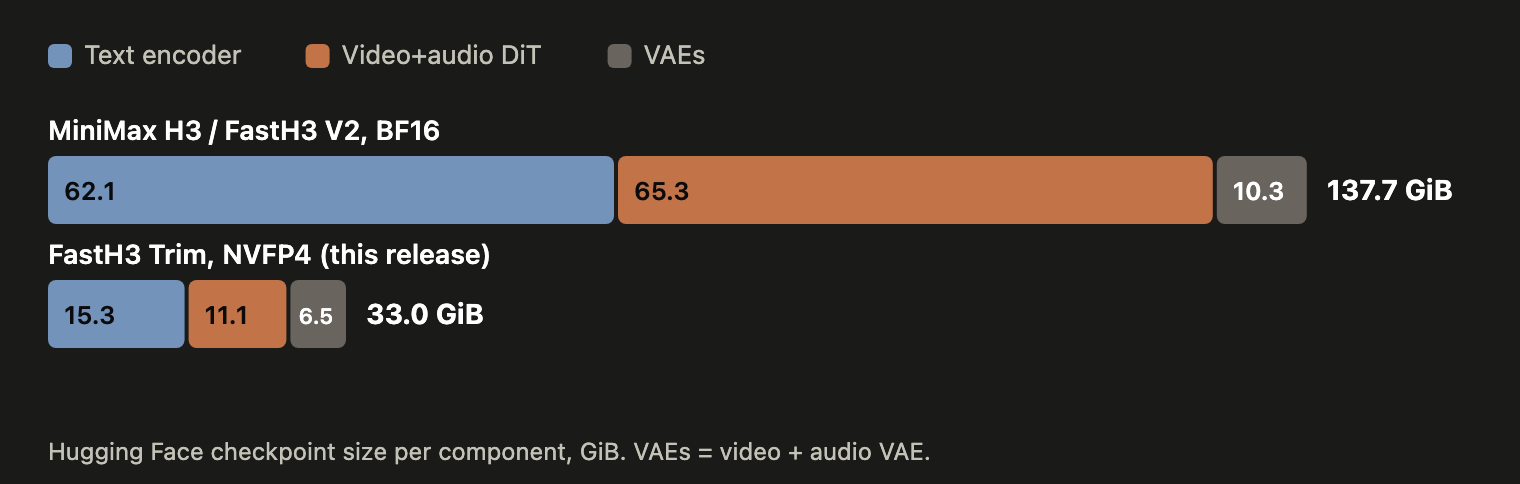
按组件划分的 checkpoint 大小。BF16 H3 为 137.7 GiB;FastH3 Trim NVFP4 版本为 33.0 GiB,其中 transformer 占 11.1 GiB。
- 块剪枝: 团队从基础 H3 中逐个跳过块,并在三种噪波水平下、针对四类示例(运动、语音、音乐、声音事件)记录视频与音频预测的变化幅度,共 600 次测量。每个块按其在任一条件下造成的最大变化排名,因此对视频或音频任一重要的块都会被保留。被移除的八个块全部位于网络的前半部分;第一个和最后一个块对输出的影响最大。
- 时间步条件: H3 通过 AdaLN 投影让每个块都受 diffusion 时间步的条件控制,该投影把 2,688 维的时间 embedding 映射为六个调制向量,而在 50 个块中这些投影以 BF16 存储要占 24 GiB。Trim 将其替换为一个共享的 2,688 到 16 的基向量加上一个小的逐块投影,并以 FP16 存储,因为 BF16 的重建误差约大 1.7 倍。
- 训练: 新的 42 块模型直接使用八步 DMD2 并沿用 FastH3 V2 的目标函数进行训练。基础 H3 同时初始化冻结的 teacher 和可训练的 critic,注意力稀疏度为 80%,采样器步数为 999、874、749、624、500、375、250 和 125。
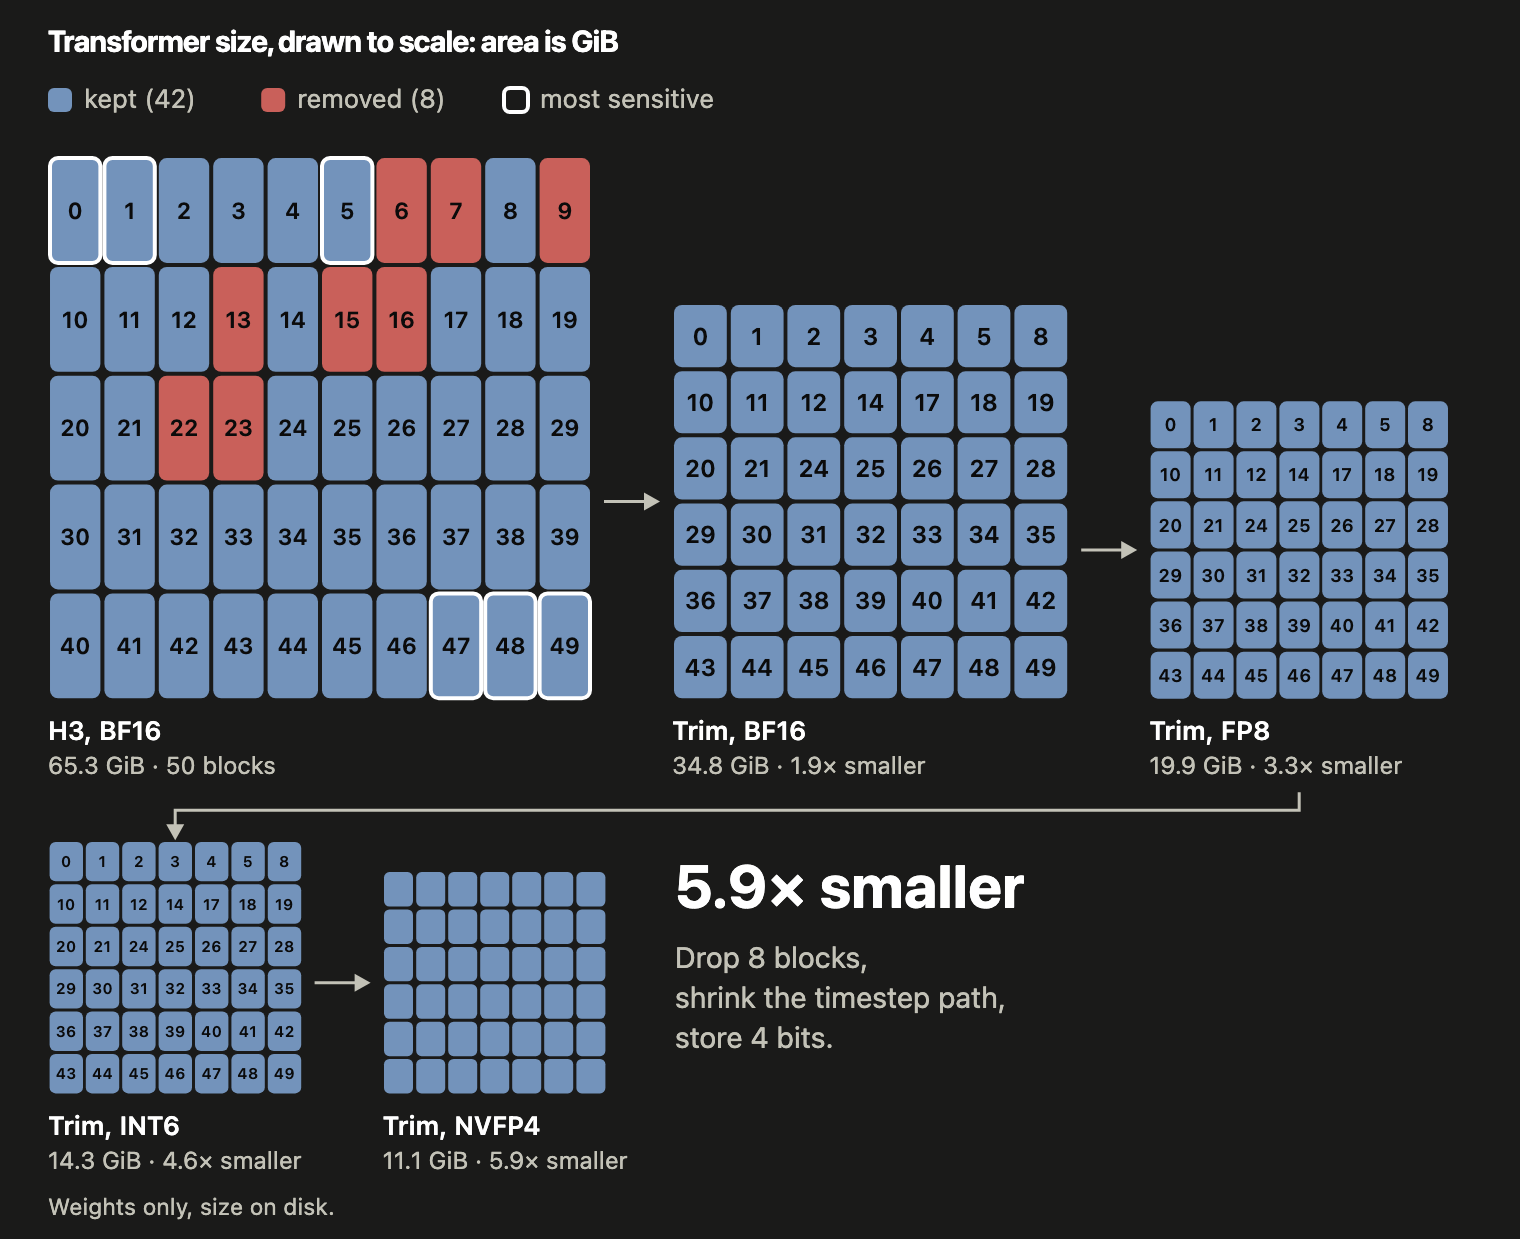
各发布格式下的 FastH3 Trim transformer,按比例绘制:面积代表 checkpoint 大小。
ComfyUI 重打包包含什么
该版本在 FastVideo/FastVideo-FastH3-Trim-Comfy 中为 ComfyUI 重新打包。选择一个 diffusion model 文件以及匹配的文本编码器:
| Diffusion model | 大小 | 适用设备 |
|---|---|---|
fastvideo_fasth3_trim_8step_nvfp4.safetensors | 11.9 GB | NVIDIA Blackwell:RTX 50 系列、RTX PRO 6000、DGX Spark |
fastvideo_fasth3_trim_8step_fp8.safetensors | 19.7 GB | NVIDIA Ada 及更新架构:RTX 40 系列 |
fastvideo_fasth3_trim_8step_int8_convrot.safetensors | 18.9 GB | 任意较新的 NVIDIA GPU;与模板默认值一致 |
fastvideo_fasth3_trim_8step_bf16.safetensors | 37.5 GB | 参考质量,或用于转换为其他格式 |
该仓库还包含 Qwen3-VL 文本编码器(BF16、INT8 ConvRot、NVFP4 AWQ)以及 MiniMax H3 的视频和音频 VAE。每个 NVFP4 层都使用在 1,000 条提示词上校准的激活缩放,Trim 共有 294 个已校准层。
在 ComfyUI 中运行
使用 ComfyUI 自带的 FastVideo FastH3: Text to Video 模板(0.36.0 或更高版本),并在其 UNETLoader 中选择一个 Trim diffusion model。保持模板的采样器设置不变:8 步、res_multistep、simple,以及 MiniMaxH3SigmaShift 节点在视频上设为 10、音频上设为 3。
运行速度如何
来自博客文章:一段 5 秒带音频片段从端到端的秒数,两个提示词各运行两次取中位数:
| 机器 | V2, 480p | Trim, 480p | V2, 768p | Trim, 768p |
|---|---|---|---|---|
| RTX PRO 6000 96 GB | 13.5 | 12.0 | 36.5 | 32.5 |
| RTX 5090 32 GB | 14.8 | 13.4 | 38.6 | 35.4 |
| RTX 4090 24 GB | 54.6 | 43.9 | 154.6 | 132.8 |
| RTX 4090,16 GB 限制 | 79.9 | 72.1 | 153.7 | 139.9 |
| RTX 4090,12 GB 限制 | 91.2 | 74.1 | 170.7 | 147.1 |
| RTX 4090,8 GB 限制 | - | 82.0 | - | - |
| DGX Spark 128 GB 统一内存 | 141.4 | 125.8 | 340.1 | |
| 2x DGX Spark | 87.2 | 78.3 | ||
| Mac,M4 Max 36 GB 统一内存 | 925.2 |
8 GB、12 GB 和 16 GB 三行是同一块 RTX 4090 在限制 GPU 内存后的结果;实际显存更少的显卡会更慢。博客指出,在 4090 上 FP8 路径没有 FP4 tensor core 可用,因此它用一个融合的逐 tensor 内核加输出缩放来绕开较慢的逐 token、逐通道 FP8 matmul,并把 query 和 key 量化为 INT8 以进行分数计算。
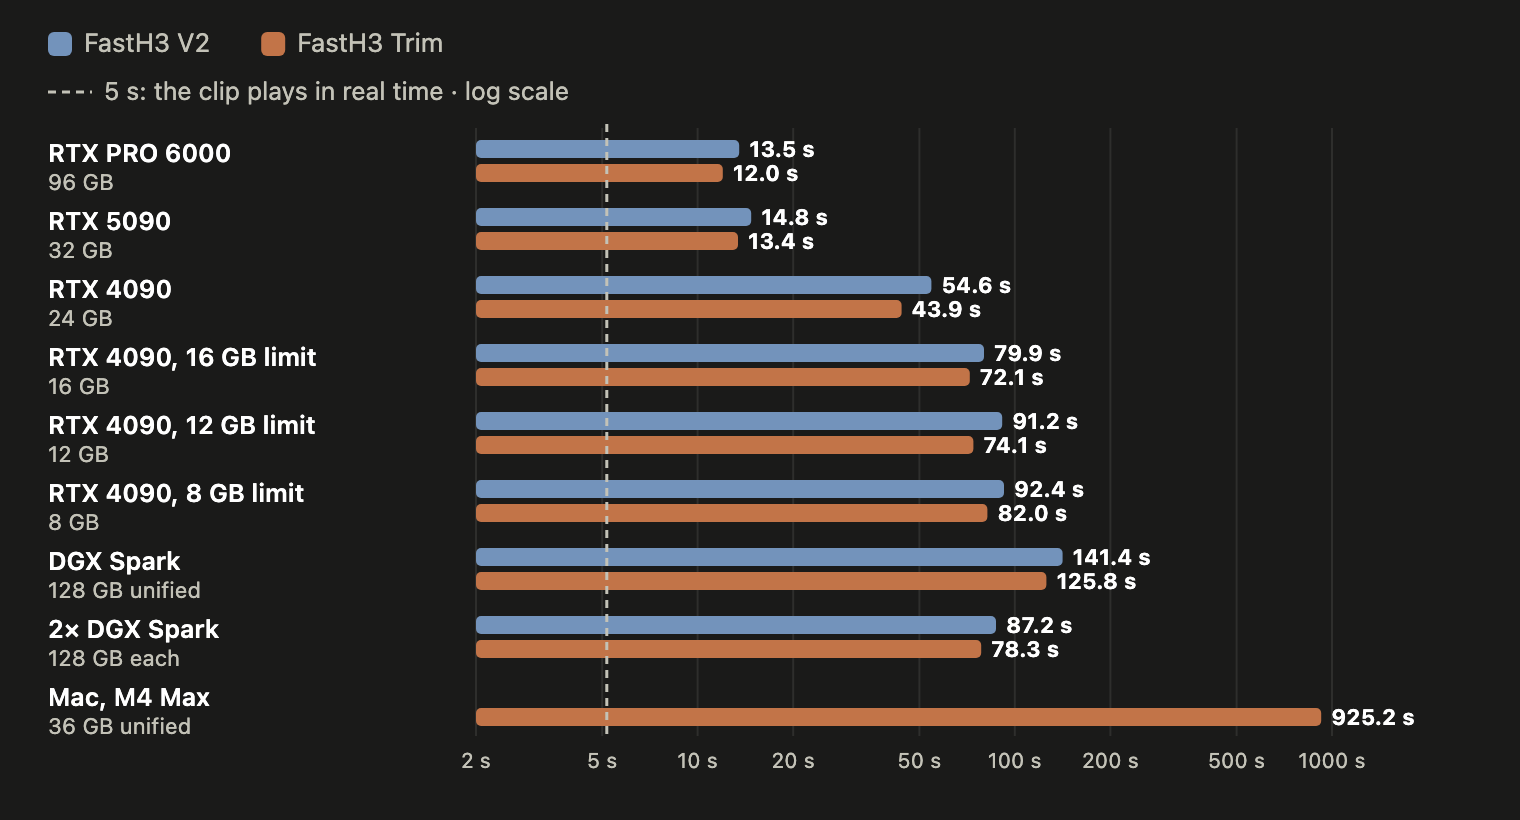
每台机器上 5 秒、832x480 带音频片段的端到端时间。
在 RTX 5090 上使用相同的提示词和种子,先 FastH3 V2 后 FastH3 Trim:
RTX 5090 上的 FastH3 V2。
同一块 RTX 5090、相同提示词和种子下的 FastH3 Trim。
限制
- Trim 被标注为实验性版本,而非质量标杆:博客称移除块会让模型更快更小,但会损失一些质量,并建议在质量最重要时使用 FastH3 V2。
- 8 GB 这一数字是仅在 Trim、NVFP4 下、在内存受限显卡上测得的结果。在测试配置上,V2 无法装入 12 GB。
- Trim 仅存在于八步 FastH3 系列中。它不改变基础 MiniMax H3 模型,后者仍然需要完整的 50 块 transformer。
- ComfyUI 路径依赖于随 ComfyUI 0.36.0 或更高版本一同提供的 FastH3 模板。
获取方式
ComfyUI 重打包: FastVideo/FastVideo-FastH3-Trim-Comfy
源权重: FastVideo/FastVideo-FastH3-Trim-8-Step
博客文章: FastH3 on Consumer Hardware
代码: hao-ai-lab/FastVideo
质量对标版本: FastVideo/FastVideo-FastH3-8-Step-V2
基础模型: MiniMaxAI/MiniMax-H3
评论
使用 GitHub 登录后即可参与讨论。