AcademiaSD LoRAlab:一个启动器集成九款 LoRA 训练器
AcademiaSD LoRAlab Trainer Studio 将 Qwen-Image 2.1、FLUX.2 Klein、Krea 2、Z-Image、MiniMax-H3 等九款 LoRA 训练器整合在一个启动器之后,最低仅需 4 GB 显存。
models/loras 文件夹。
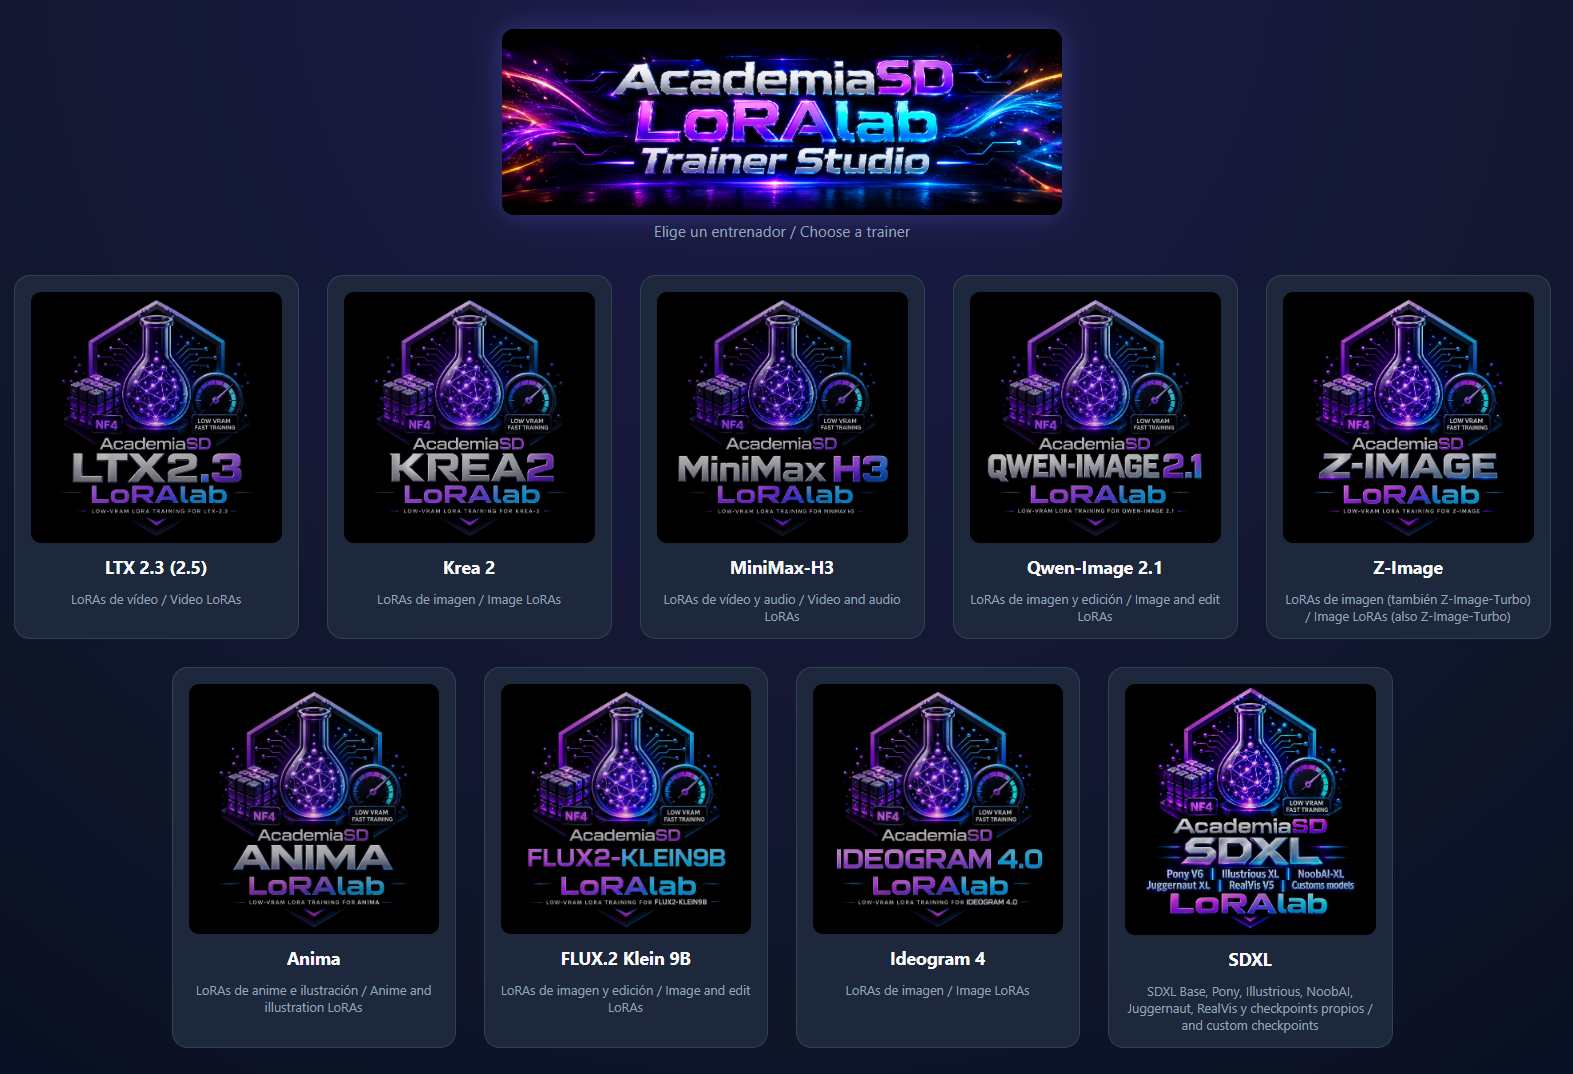
启动器:选择一款训练器即可在浏览器中打开,而模型、项目和设置保持共享。
它能训练什么,需要多少显存
| 训练器 | 可训练内容 | 最低显存 |
|---|---|---|
| Qwen-Image 2.1 | 角色、对象和风格 LoRA,以及编辑 LoRA(之前 → 之后) | 8 GB |
| Krea 2 | 面向 Krea 2 Raw 和 Turbo 的角色、对象和风格 LoRA | 8 GB |
| Z-Image | 面向 Z-Image 和 Z-Image-Turbo 的角色、对象和风格 LoRA | 8 GB |
| Anima | 动漫与插画角色及风格 LoRA | 4 GB(NF4)/ 6 GB(BF16) |
| FLUX.2 Klein 9B | 角色、对象和风格 LoRA,以及编辑 LoRA | 12 GB |
| Ideogram 4 | 角色、对象和风格 LoRA,支持 JSON 标注 | 12 GB |
| SDXL | 适用于 SDXL Base、Pony、Illustrious、NoobAI 及其他 SDXL 模型的 LoRA | 4 GB(NF4)/ 12 GB(BF16) |
| LTX-2.3(以及 LTX-2.5) | 面向 LTX 视频模型的角色和风格 LoRA,可从图像训练 | 12 GB |
| MiniMax-H3 | 从图像、视频片段和音频训练视频 LoRA,另有免训练的 RefMods | 8 GB |
最低门槛是一块计算能力 7.5 或更新的 NVIDIA GPU(RTX 20xx / GTX 16xx 及以上)、CUDA 13 所需的 580 系列或更新驱动,以及 16 GB 系统内存。MiniMax-H3 视频片段训练额外还需要把 ffmpeg 加入 PATH。GTX 10xx 显卡不在支持范围内:CUDA 13 版 PyTorch 从 RTX 20xx 一代起步。
每款训练器共用一套界面
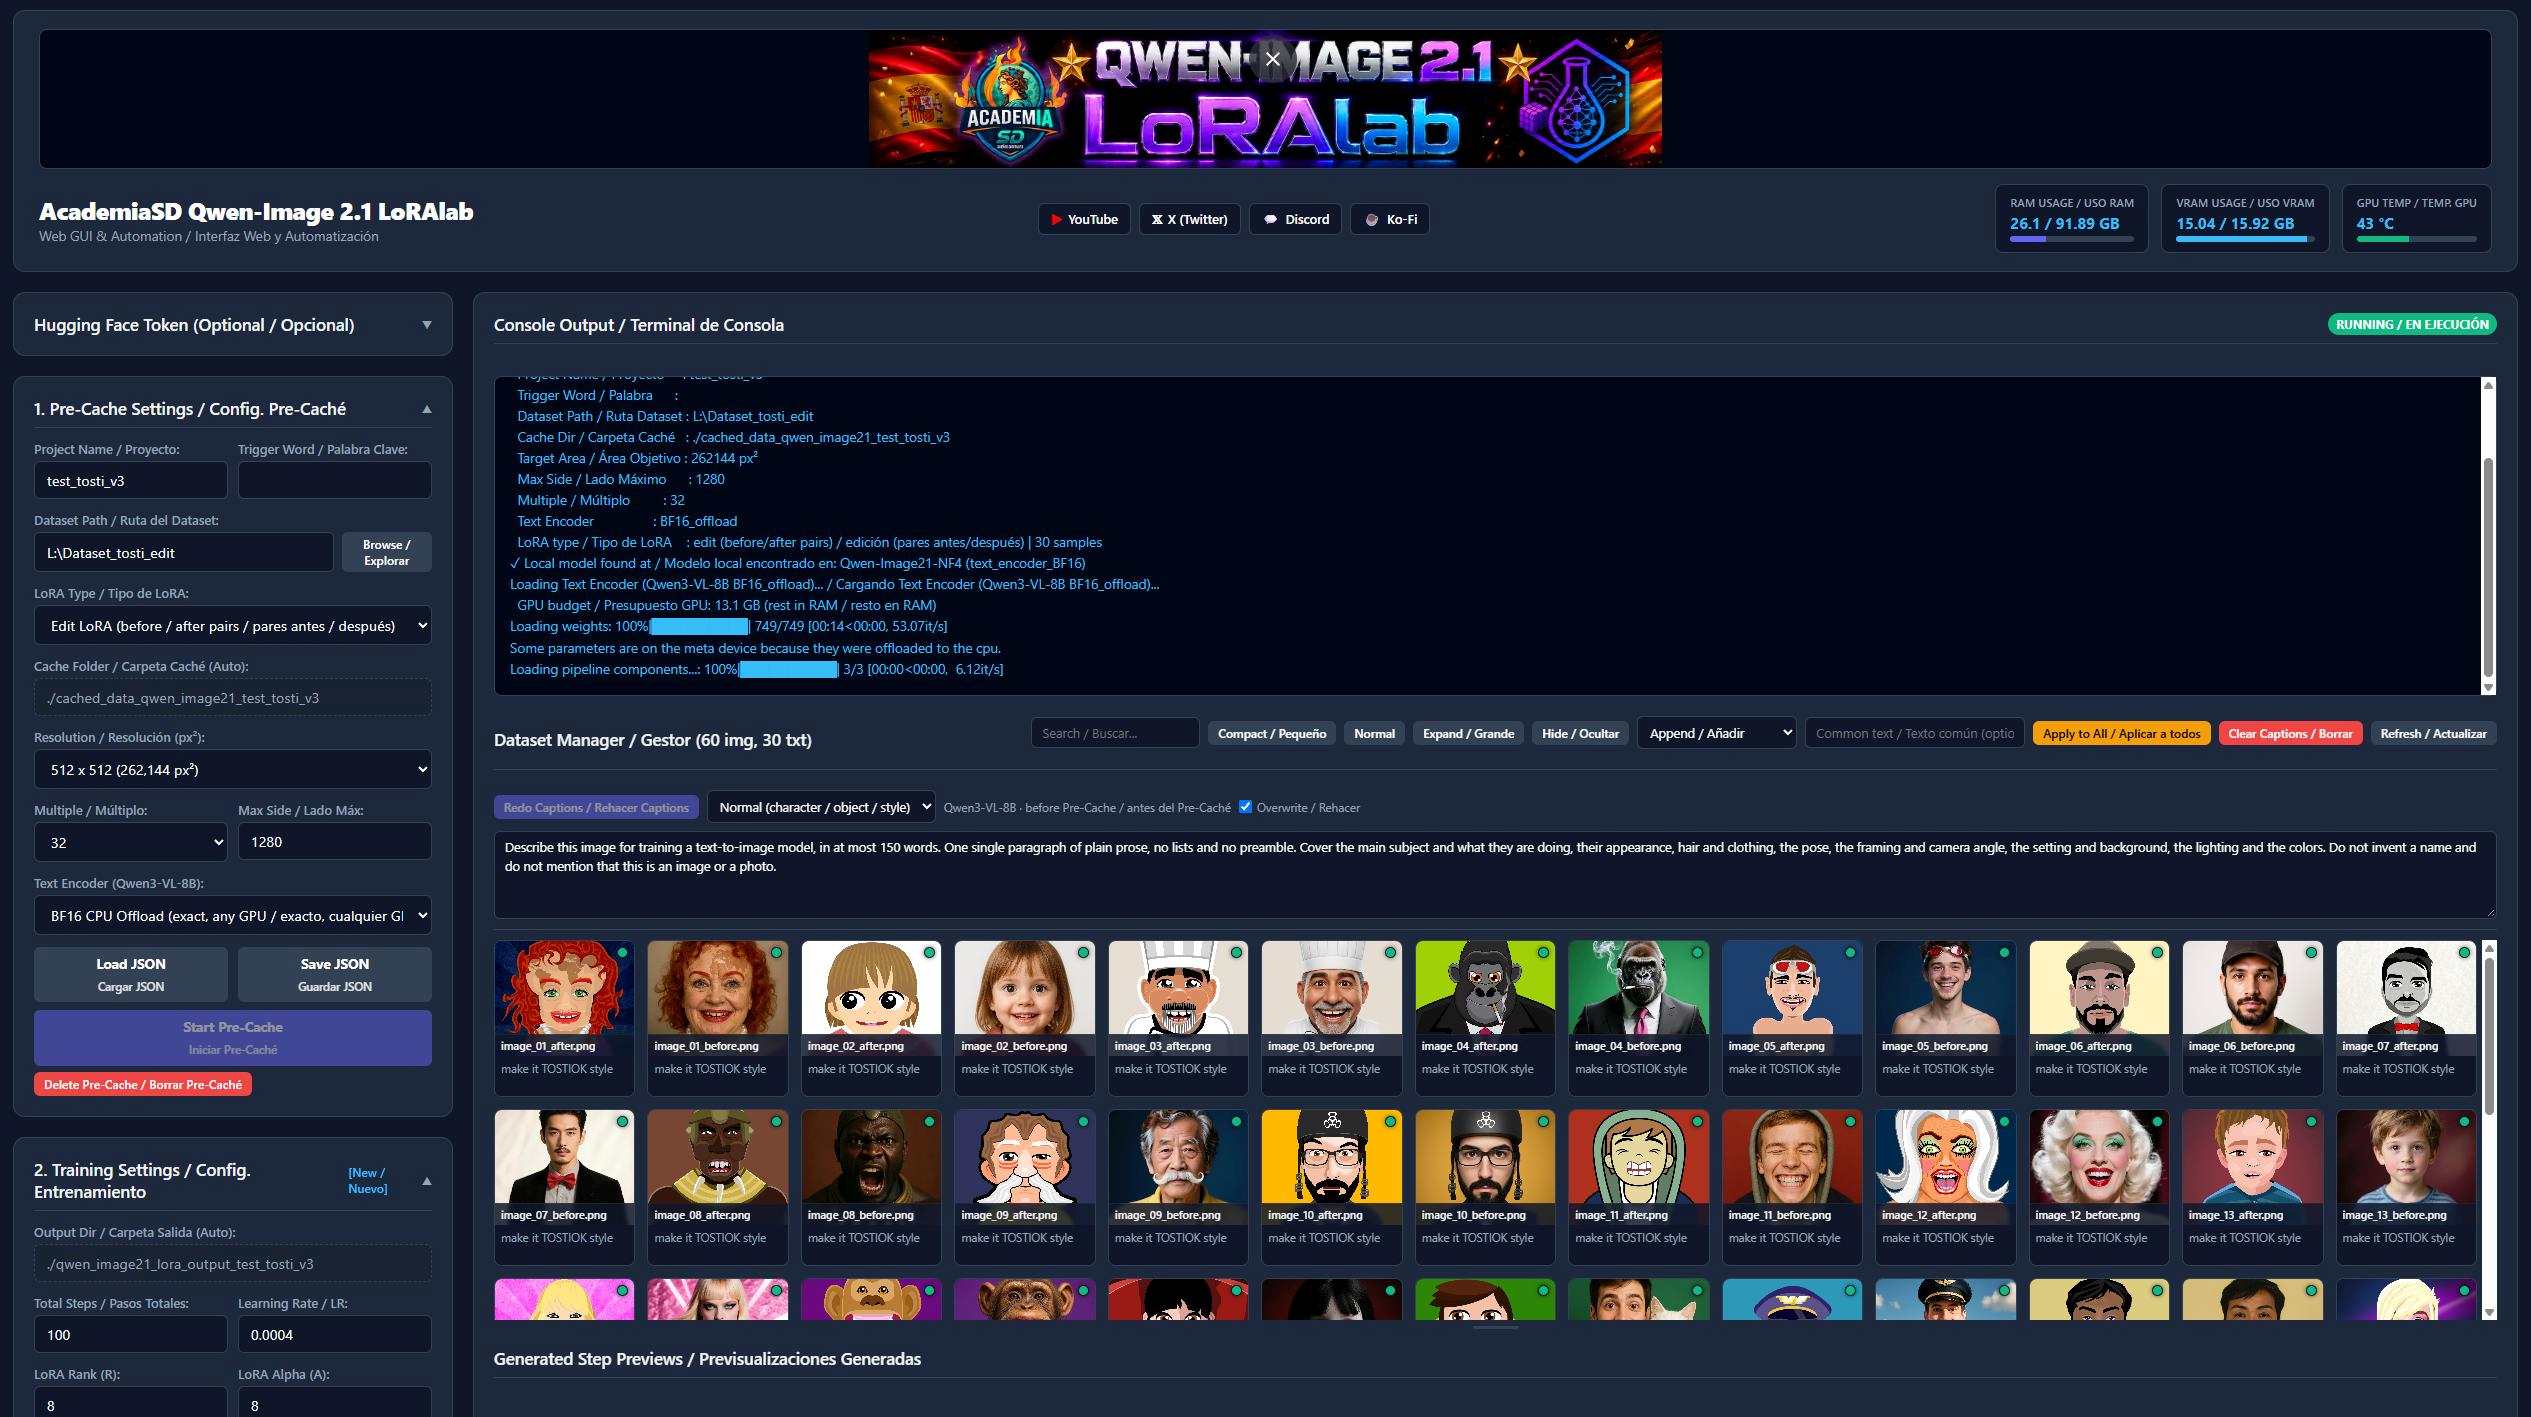
Qwen-Image 2.1 训练器。九款训练器共享相同的面板。
每款训练器都遵循相同的五个步骤:
- 项目与数据集。 为项目命名,可选添加触发词,并指向数据集文件夹。每张图像都需要一个同名的
.txt标注文件,图像可以以文件夹或.zip的形式拖入。 - 标注(可选)。 视觉语言模型会为每张图像生成标注,并把触发词放在最前;提示词可编辑,除非你覆盖,否则已有的标注会保留。
- 预缓存。 文本编码器和 VAE 会按你选择的分辨率运行一次,其输出保存到磁盘。重新运行时未发生变化的图像会被跳过,此后 100% 的 GPU 都投入训练。
- 训练。 设置步数、学习率、rank 和 alpha,然后开始。设置可在运行中修改,并在下一步生效;Stop Training(停止训练)会保存精确的步数,因此即使数天后继续,也不会丢失任何一步。
- 导出。
Send to Models会把 LoRA 复制到 ComfyUI(或 Forge / A1111)的models/loras文件夹,该文件夹会在各训练器之间被记住。步数检查点也可以从浏览器下载,导出的 LoRA 带有 kohya 风格的元数据,Civitai 和各类 LoRA 管理器均可读取。
该工作室也支持从同一网络中的另一台机器使用:启动器带有需要用户名和密码的远程访问模式,因此可以从笔记本上传数据集,并把训练好的 LoRA 下载回来,无需接触训练用的 PC。
训练时获得清晰的预览
其中一些模型速度较慢,采样过程需要有人盯着,而 ComfyUI 针对 Qwen-Image 2.1、Krea 2 和 FLUX.2 的默认 Latent2RGB 预览只是块状色块。README 推荐的组合是 kijai 的 KJNodes 加上 AcademiaSD 放在 ComfyUI/models/vae_approx/ 中的微型自编码器:TAE-Qwen-Image-2.1、TAE-Krea-2 和 TAE_Flux2_AcademiaSD,把它们放进位于模型与采样器之间的 Model Preview Override 节点中。
安装
每个平台一个安装程序,所有训练器共用一个 venv(CUDA 13.0 上的 PyTorch 2.14、来自 GitHub 的 Diffusers、Transformers、PEFT、bitsandbytes 和 Flask):
git clone https://github.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudio.git在 Windows 上双击 Install_LoRAlab-TrainerStudio.bat;在 Linux 上每个 .bat 都有对应的 .sh,启动器会自动选择正确的那个。Install_Triton&SageAtten220.bat 可按需添加 Triton 和 SageAttention 2.2。更新只需运行一次 Update_LoRAlab-TrainerStudio.bat,它会保留模型、数据集、项目和设置。该项目还提供了用于云端训练的 RunPod 模板和 Docker 镜像。
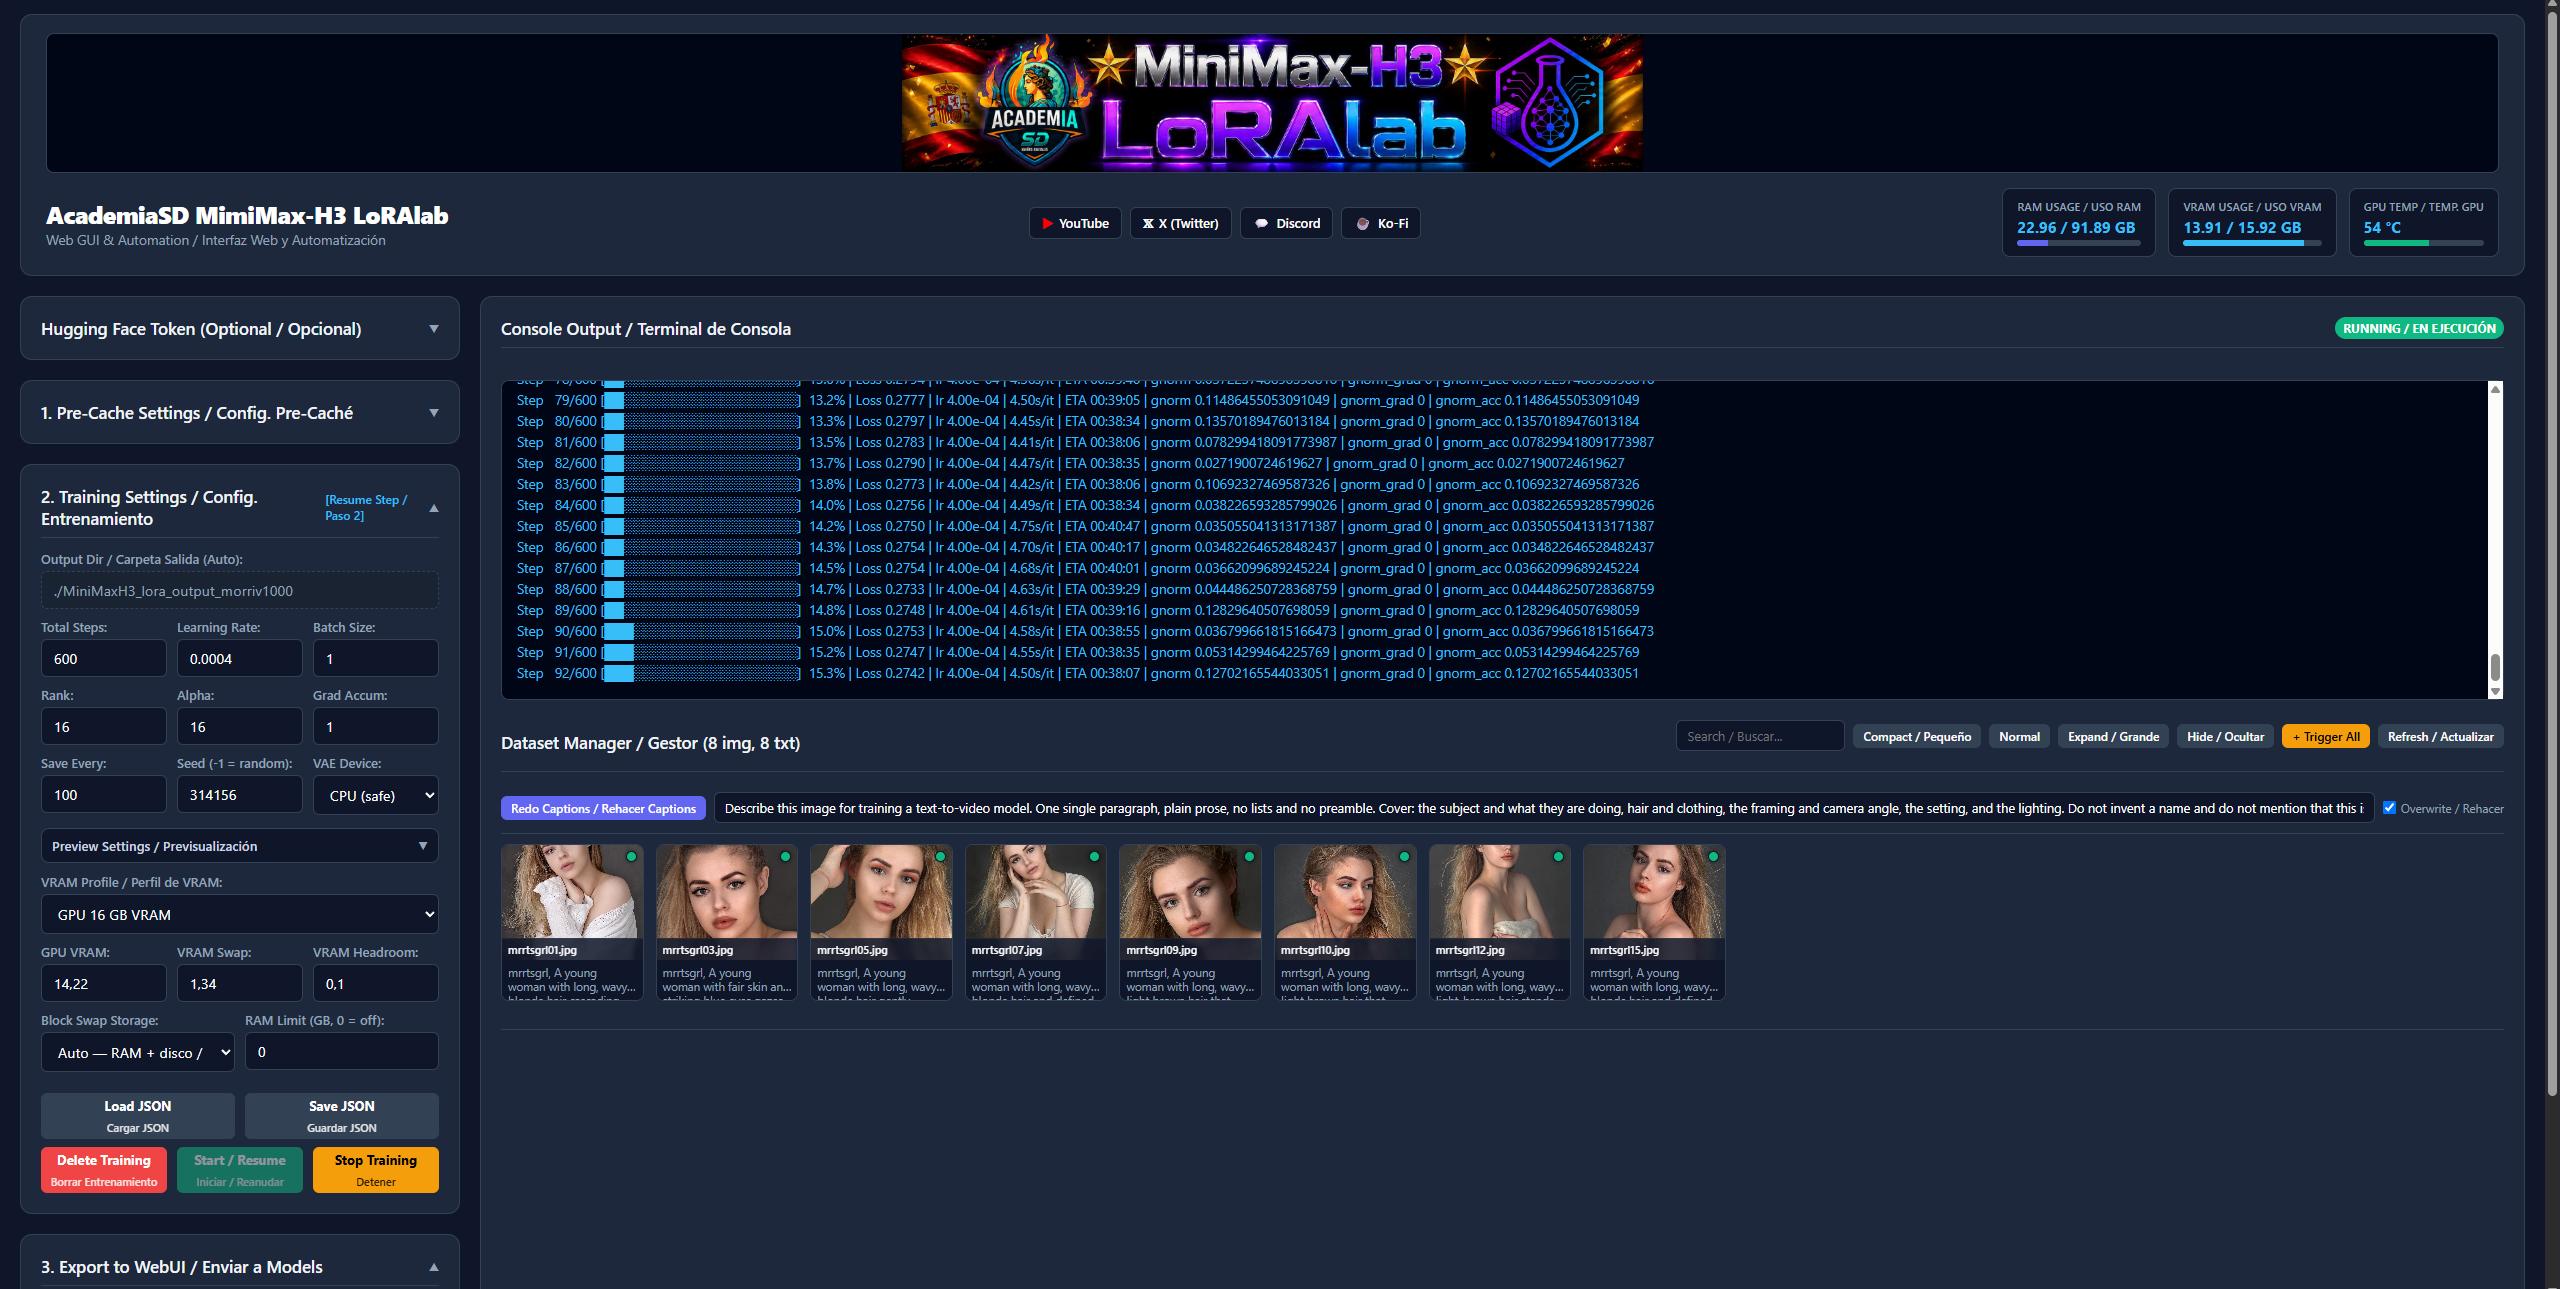
MiniMax-H3 训练器,是该工作室中两款视频训练器之一。
作者将该工作室标记为早期作品:训练器是快速接连加入的,因此默认的训练和预览设置未必适合每一款模型,遇到问题请通过提交 issue 来反馈。
获取方式
AcademiaSD LoRAlab Trainer Studio 位于 github.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudio,并在 Hugging Face 上提供预量化的训练包,例如 AcademiaSD/Qwen-Image-2.1-NF4-for-LoRA-Training。
评论
使用 GitHub 登录后即可参与讨论。