FreeVideo:在 8 GB 显存上运行 MiniMax H3
FlashML 的 FreeVideo 仅需 8 GB 显存即可运行 MiniMax H3,以 ComfyUI 插件和 Windows 启动器形式发布,基于 8 步 VDN-H3 模型并采用 FP8 执行。
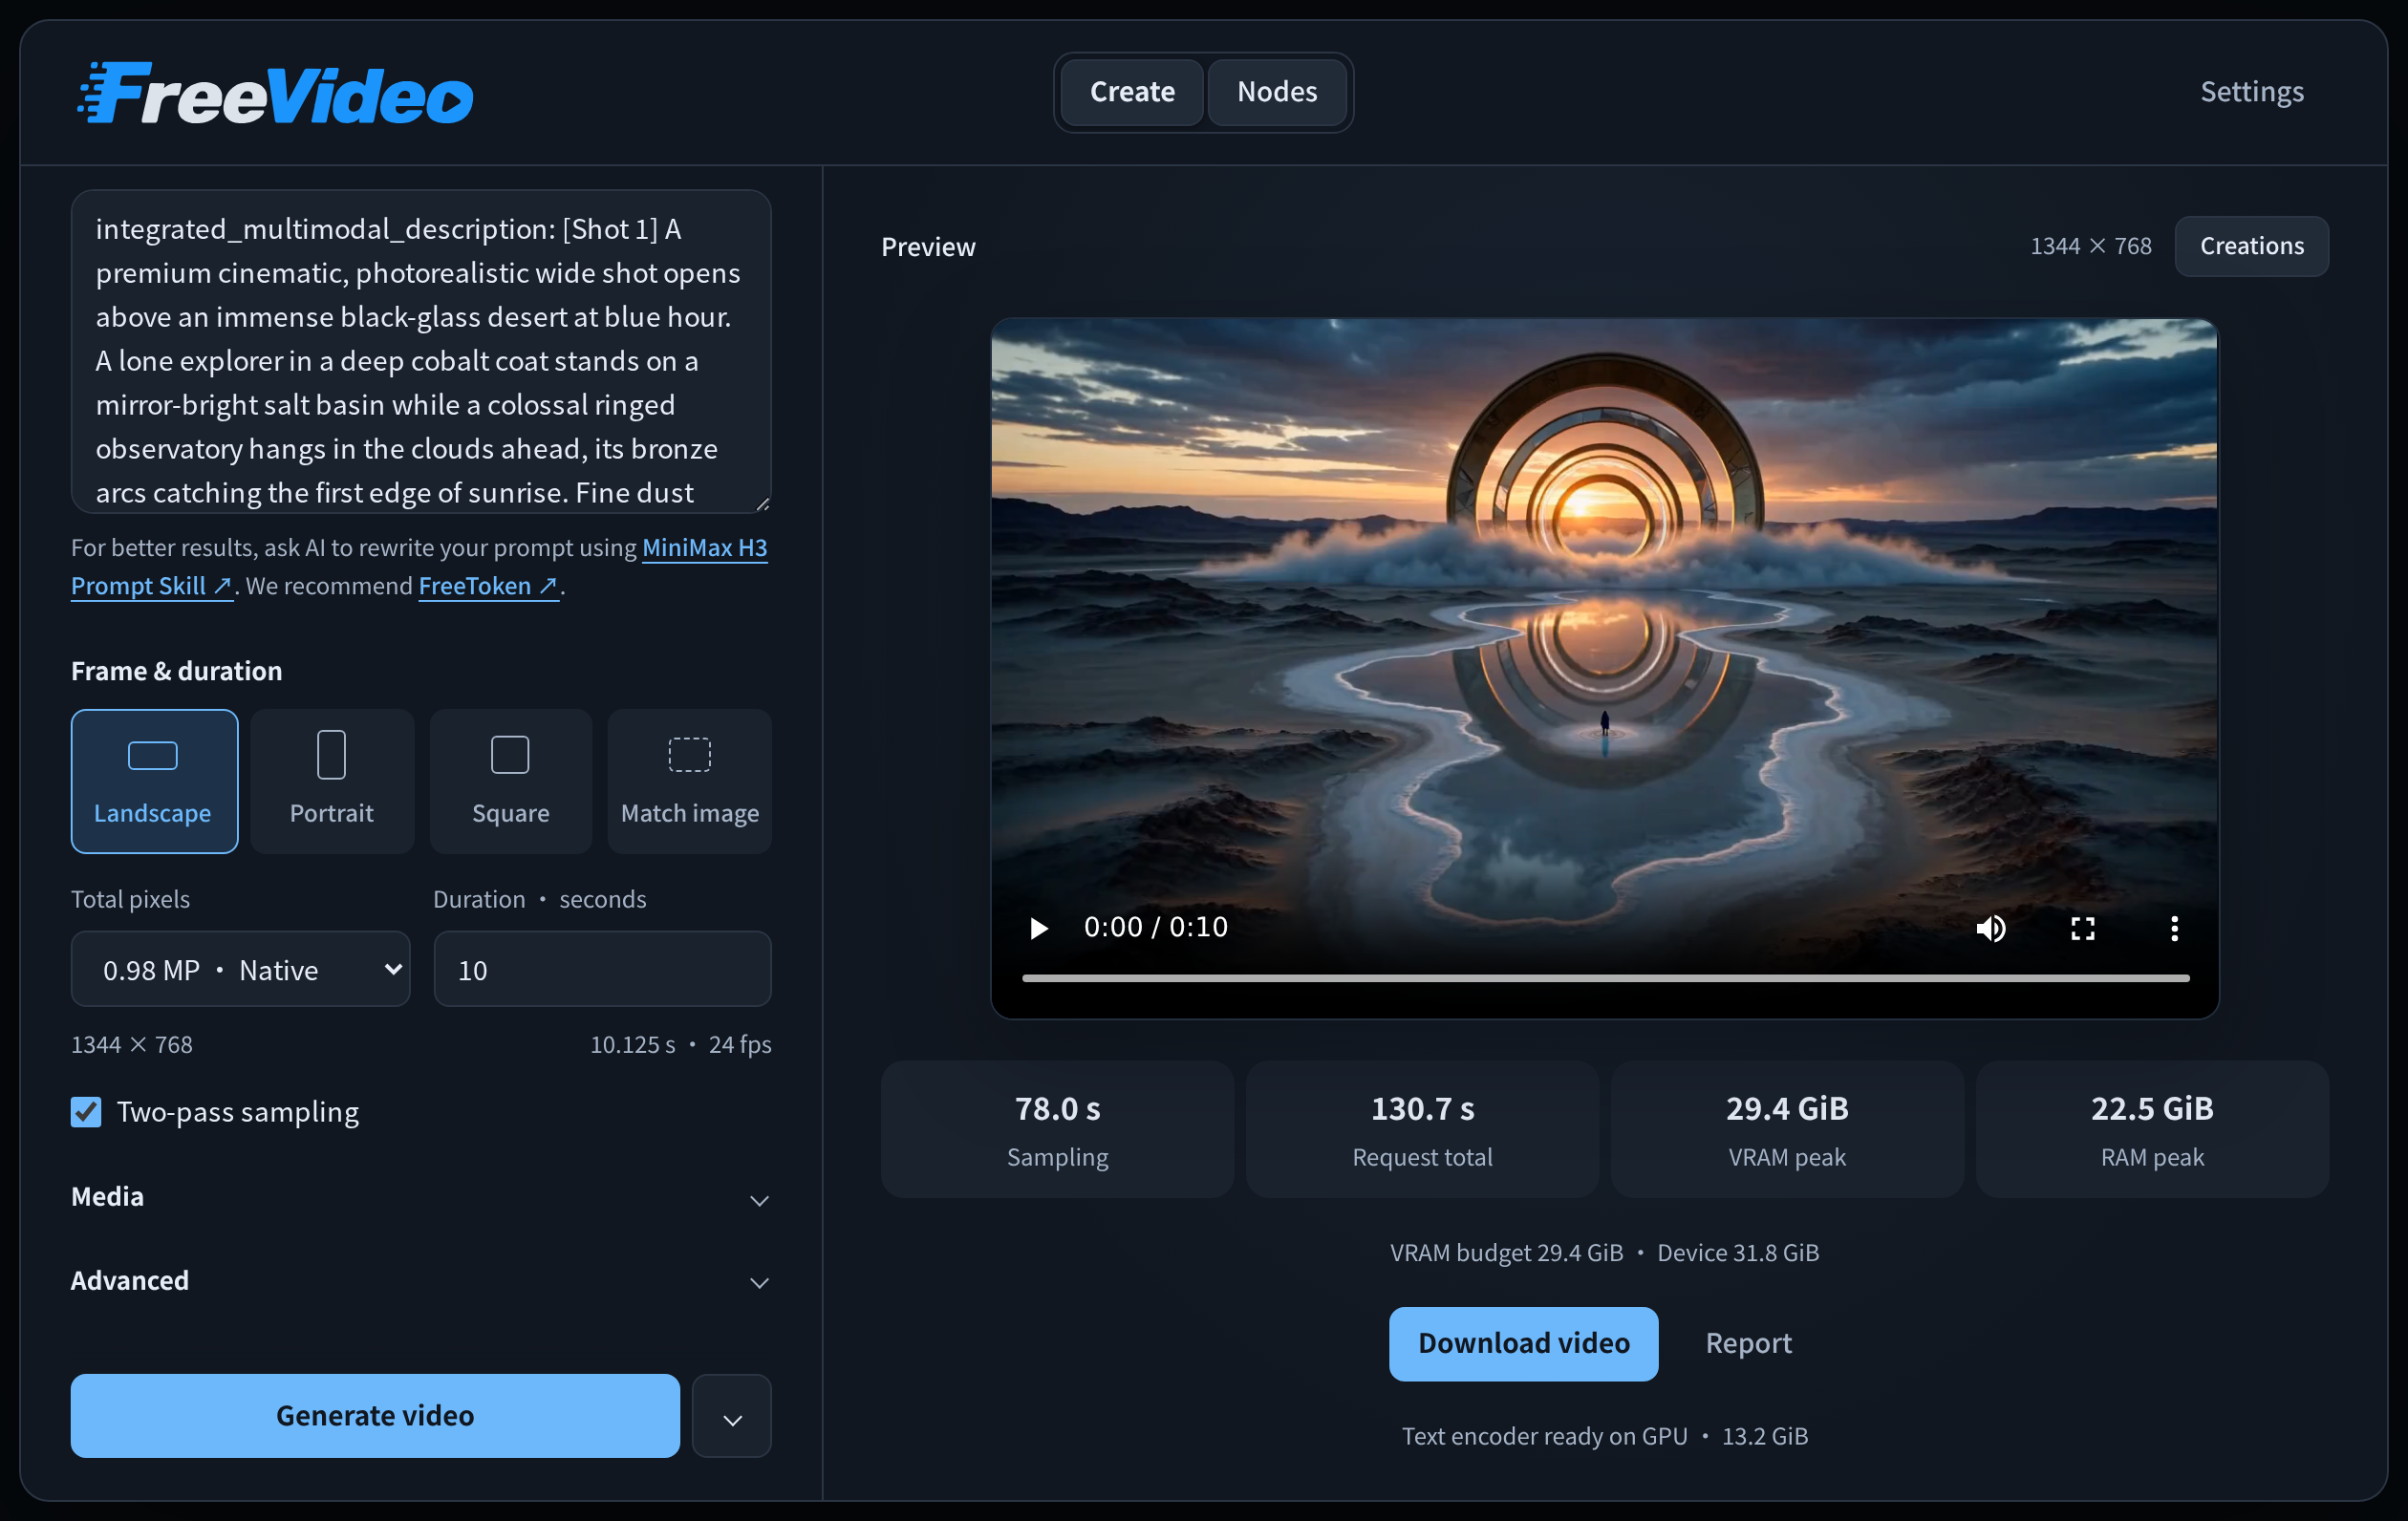
ComfyUI 中的 FreeVideo 工作区。可通过节点视图管理 LoRA 并编辑工作流。
基于 VDN-H3 构建
FreeVideo 并不运行稠密的 H3 transformer。它运行的是 OpenVDN 的 8 步 VDN-H3 checkpoint,也就是 Video DeltaNet 混合注意力改造版本,用线性分支取代 H3 的二次长距离注意力(参见 VDN-H3 相关报道)。FreeVideo 将该模型打包为已备好的 FP8 vdn-minimax-h3-edge 版本,每种格式约 22.9 GB,并在其上叠加一个规划器,用于在运行时决定 H3 的 50 个 transformer 块各自驻留在哪里。
硬件自适应执行
针对每个请求,自适应执行规划器都会测量空闲显存、可用主机内存以及注意力内核的探测结果,然后确定:
- 块驻留:50 个 transformer 块中有多少保留在显存中,多少存放在锁页主机内存中(最高 22 GB),多少在每一步从磁盘读取。
- FP8 GEMM 路径:Blackwell (SM120) 使用逐张量缩放,Ada 和 Hopper 使用逐通道缩放,Ampere 使用 FP8 权重配合 BF16 计算。
- 注意力后端:在 SageAttention 2、PyTorch flash attention、cuDNN、FlashAttention 2 和 FlashAttention 4 中,选择第一个通过设备端探测的后端。
- VAE 解码器放置:在低于 20 GB 的预算下,解码器 36 个块中的一部分保持常驻,其余则以流式方式加载,并按顺序解码各片段。
预算会在每次请求前重新测量,已完成的运行会将其耗时和内存峰值存入 resource-history.sqlite3,当引擎预测某个放置方案至少快 2% 时,便会切换过去。
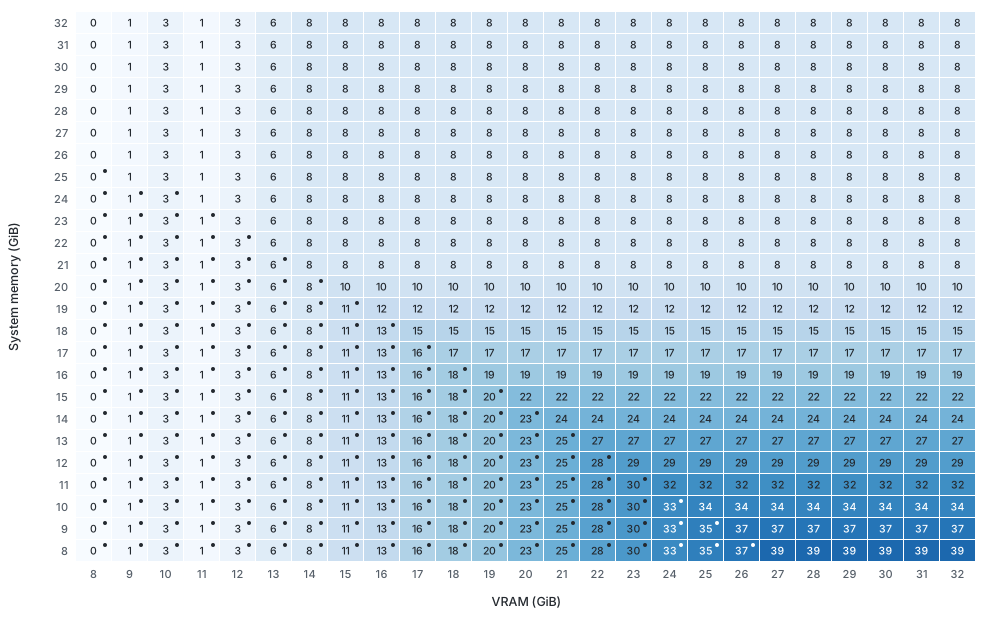 | 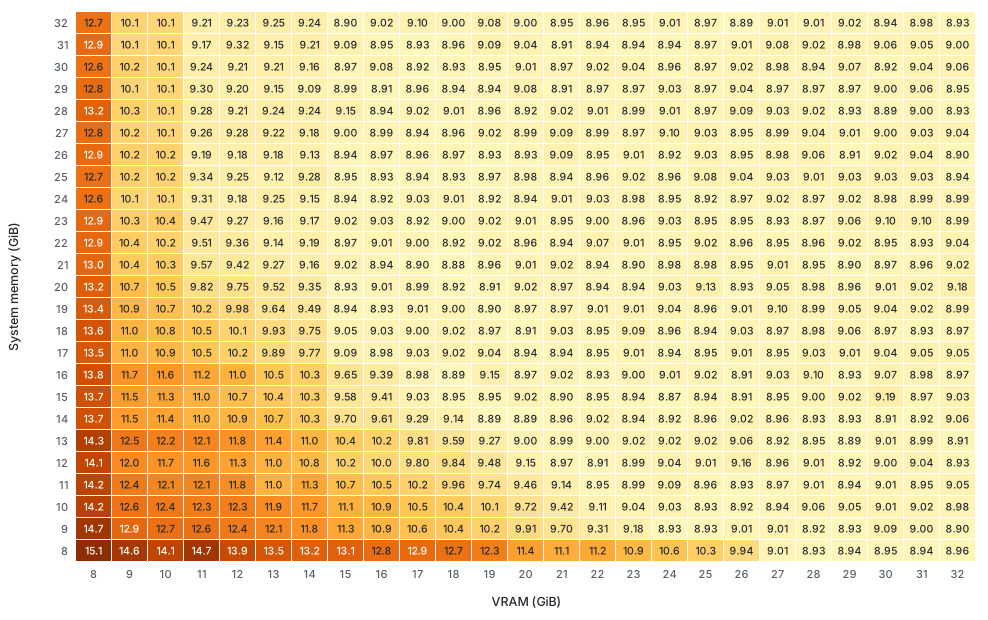 |
|---|---|
| 在每种显存预算下,50 个 transformer 块的驻留位置 | 规划器在每种显存预算下预期的吞吐量 |
它能运行什么
- 从文本提示生成带音频的视频
- 首帧和尾帧条件
- 图像、视频和音频参考
- 在同一工作流中使用社区 MiniMax H3 LoRA
- 在 ComfyUI 工作区中进行两遍采样和批处理生成,并保留历史创作记录
入门
在 Windows 上,从 windows-preview 发布页 下载 FreeVideo.exe 并运行。启动器会安装 ComfyUI、运行时以及与你的 GPU 匹配的模型包,复用现有模型文件夹,并支持从已下载的软件包进行离线安装。
将 FreeVideo 添加到现有 ComfyUI 安装中:
cd ComfyUI/custom_nodes
git clone https://github.com/FlashML-org/FreeVideo.git
重新启动 ComfyUI,打开 工作流 -> 浏览模板 -> FreeVideo -> FreeVideo-All-in-One,然后在 FreeVideo 设置中完成配置。在 Linux 上,该仓库还提供 CLI:
git clone https://github.com/FlashML-org/FreeVideo.git && cd FreeVideo
./setup.sh
./freevideo generate --prompt-file prompt.txt --out video.mp4
内置的示例工作流就是模板浏览器中显示的那个:
可用性
FreeVideo 位于 github.com/FlashML-org/FreeVideo,备好的 FP8 权重来自 OpenVDN/vdn-minimax-h3-edge,启动器会根据检测到的架构自动下载它们。
评论
使用 GitHub 登录后即可参与讨论。