UltraTex:ComfyUI 中的 2K 多视角扩散 3D 纹理生成
吉林大学与 VAST 的 UltraTex 借助背景 token 丢弃和块稀疏注意力,以 2048x2048 分辨率为 3D 网格生成纹理,并附带 ComfyUI 节点包。
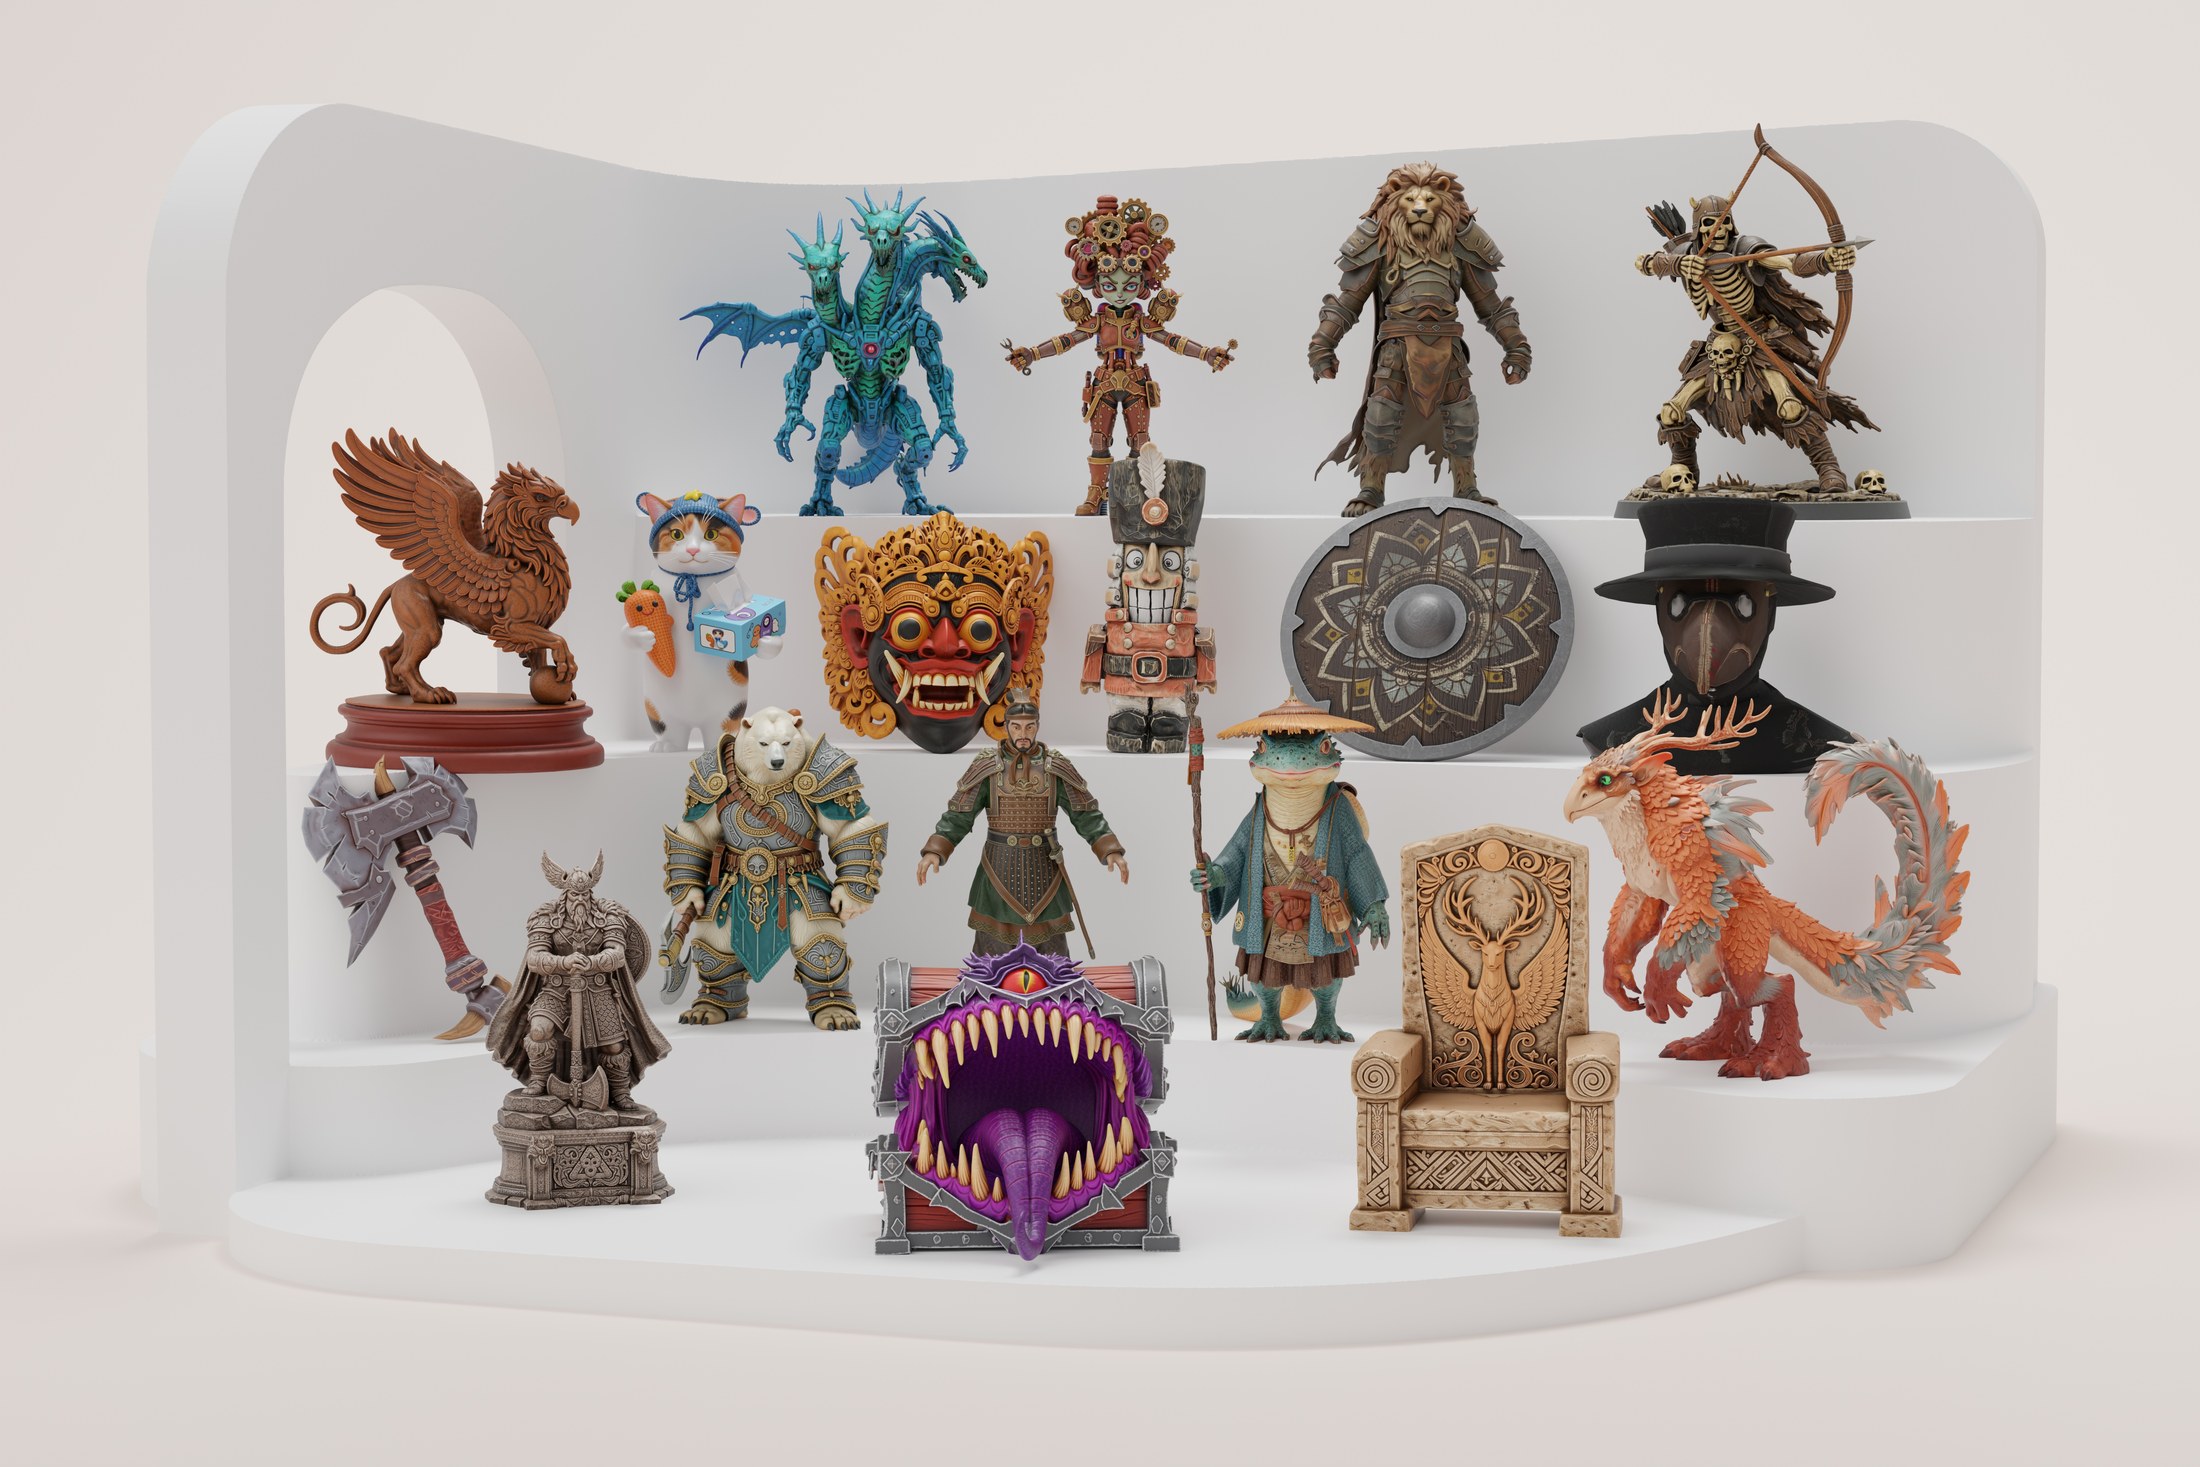
由 UltraTex 根据未贴图的网格和一张参考图像生成的带纹理资产。
UltraTex 能做什么
只需给 UltraTex 一个未贴图的网格和一张参考图像,它就会生成六张 2048² 纹理视图(正面、左面、背面、右面、顶面、底面),然后将其烘焙成网格上的 UV 纹理。这篇论文的核心观点是:2K 分辨率下的密度大部分都是浪费的。
以对象为中心的多视角渲染有两个冗余来源:不携带任何有用纹理信息的背景像素,以及前景 token 之间稀疏的交互。UltraTex 同时解决这两个问题:
- Background Token Dropping (BTD):在进入 DiT 主干之前丢弃背景 token,但保留原始 RoPE 索引,使空间坐标和多视角几何先验在剪枝后依然有效。
- Block-Sparse Attention (BSA):对剩余的前景序列应用 top-k 稀疏注意力,而不是密集注意力。
- Foreground-Aware VAE Decoding:用符合分布的规范背景替换未去噪的背景 Latent,并对解码器进行轻量微调,从而让 2K 重建不出现剪枝本会引入的伪影。
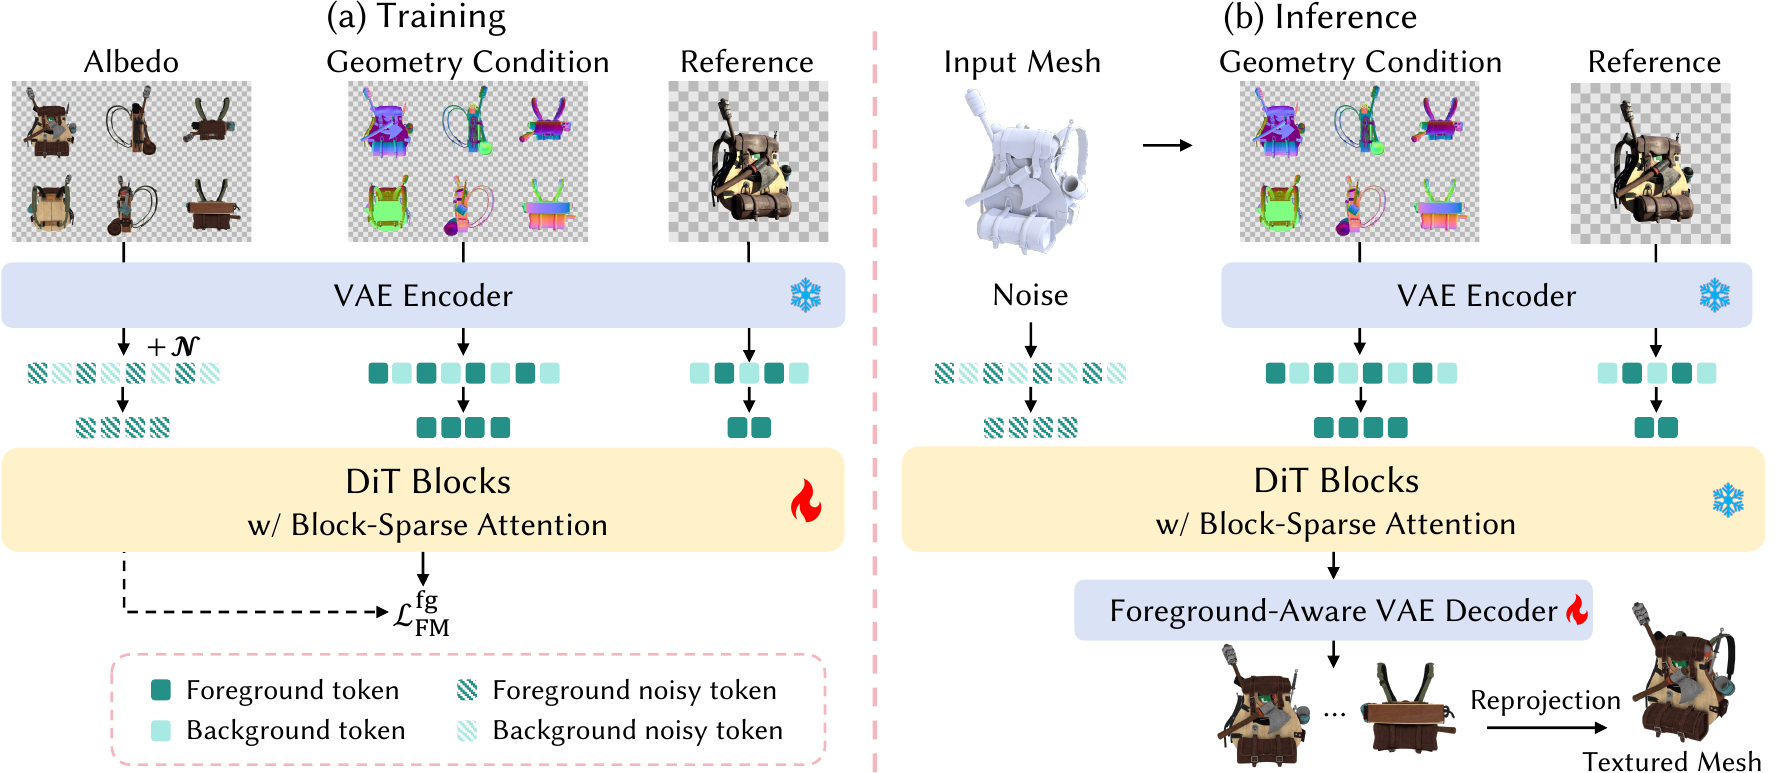
UltraTex 流程:背景 token 丢弃、块稀疏注意力以及前景感知解码器。
主干网络为 FLUX.1-dev 和 FLUX.2-Klein(4B 和 9B),因此这个纹理生成器继承的是通用图像模型的提示词与图像条件能力,而不是一个专门构建的纹理网络。
速度从何而来
在 G-buffer TexVerse 数据集的常见样本上,已发布的实现报告称,在相同的 2K 输出分辨率下,相较密集基线可获得 20.6 倍到 91.1 倍的训练加速,以及 22.3 倍到 74.6 倍的端到端推理加速。
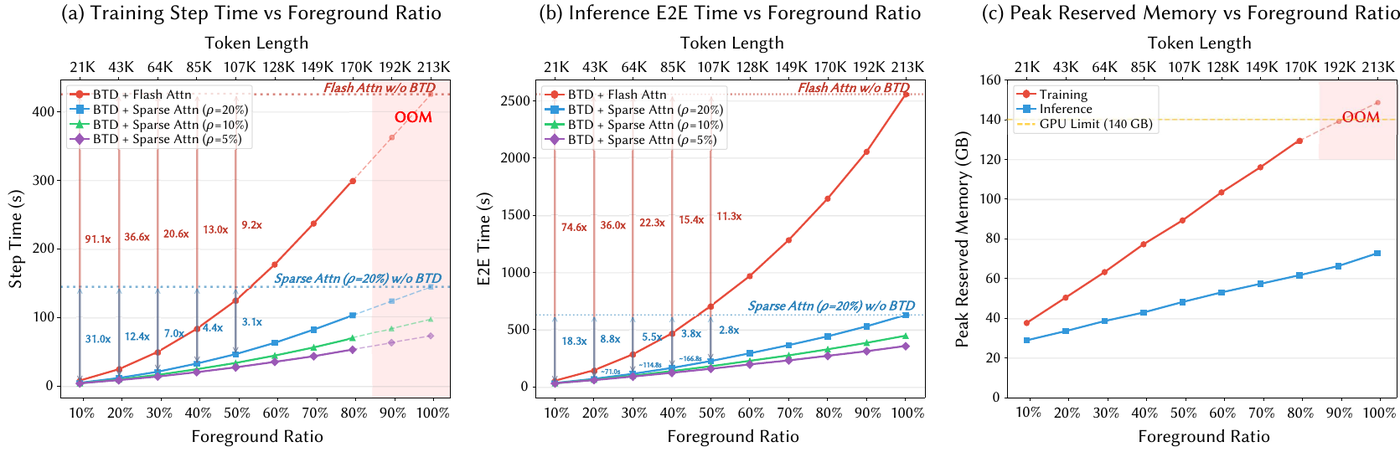
相较密集 2K 基线的训练与推理加速,来自项目主页。
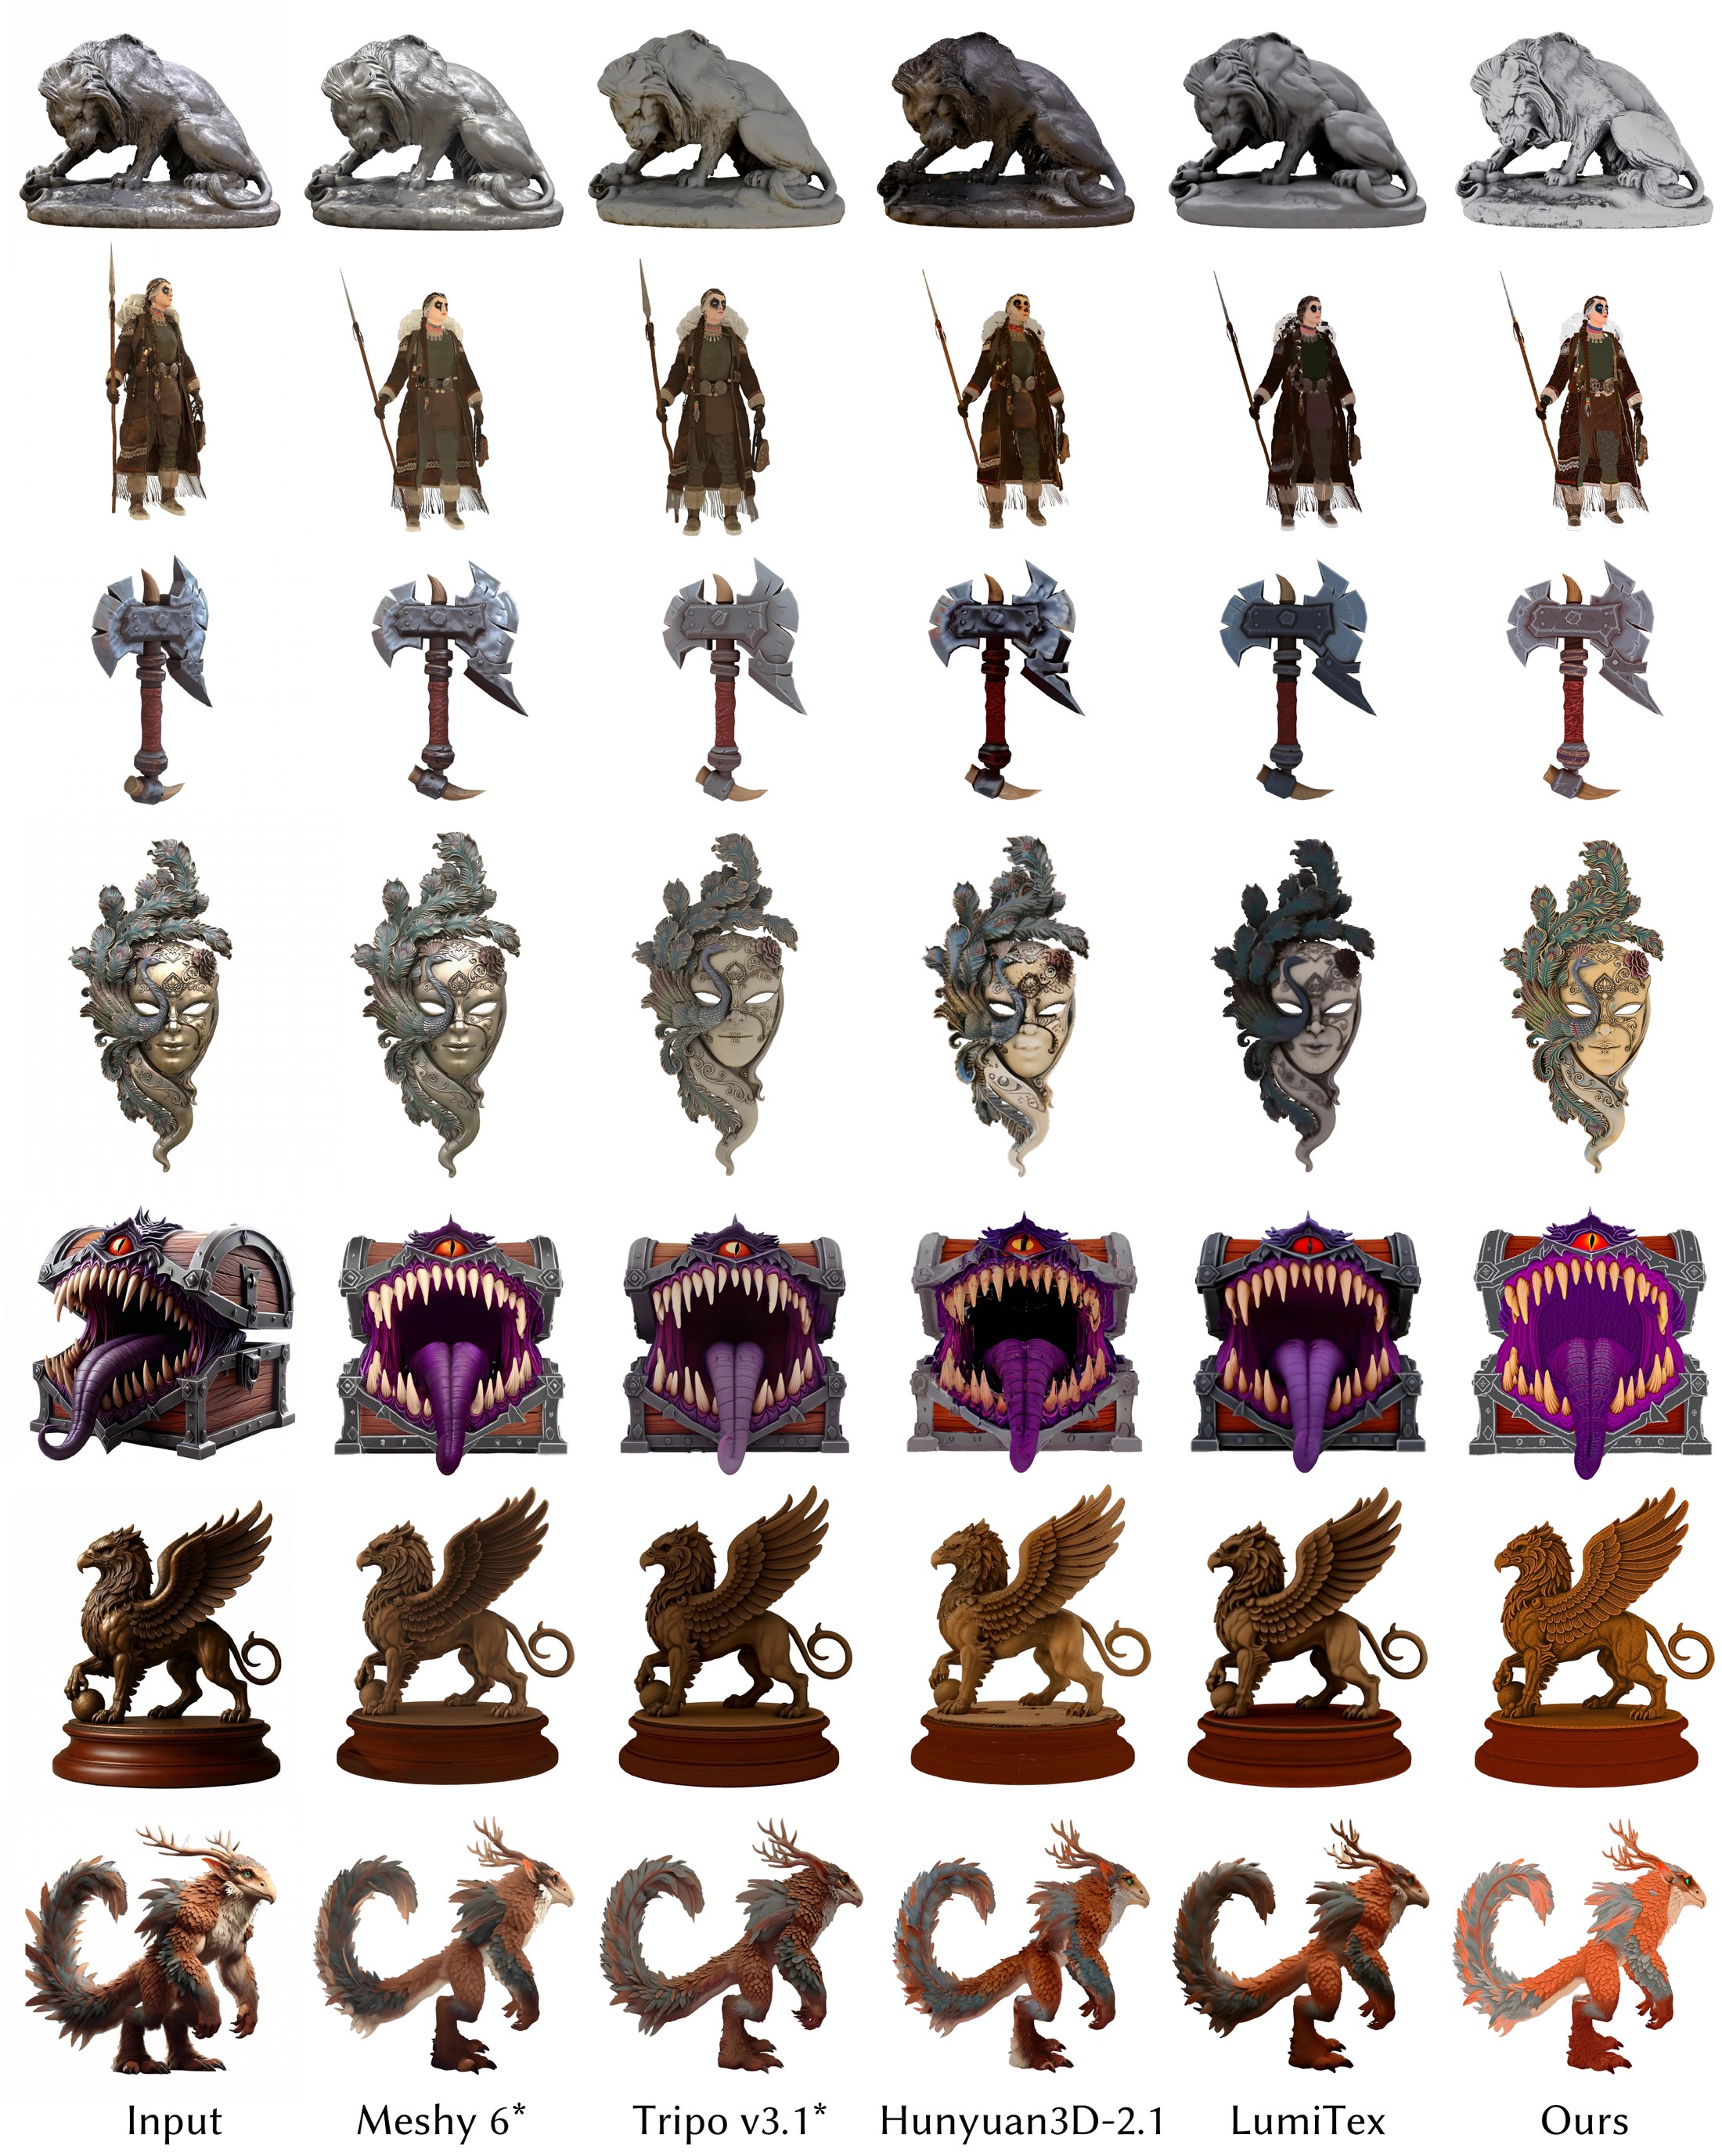
论文中的定性纹理结果。
发布了哪些内容
- 代码与权重。 训练与推理代码位于 UltraTex 仓库,模型权重发布于 ModelScope。
- 数据集。 G-buffer TexVerse 数据集位于 Hugging Face。
- 论文。 SIGGRAPH Asia 2026,可参见 arXiv 2609.23169,结果与视频见项目主页。
在 ComfyUI 中运行 UltraTex
社区节点包 visualbruno/ComfyUI-UltraTex 将整个流程封装为 ComfyUI 节点:UltraTex Load LoRA、UltraTex Foreground VAE Decoder、UltraTex Prep (mesh + reference)、UltraTex Sampler 和 UltraTex Bake Texture。Load LoRA 之所以存在,是因为原生的 Load LoRA 节点无法读取这些模型(FLUX.2 使用 PEFT 的 lora_A.default 键,FLUX.1 使用 UNO 的 processor.*_lora 键),而 Bake Texture 会把生成的视图反向投影为 UV 纹理,并返回一个可直接连接到 Preview 3D 的 GLB。
扩散模型、VAE 和文本编码器均使用 ComfyUI 原生加载器加载,因此 fp8 和 GGUF 权重以及 ComfyUI 的内存卸载机制都可以生效。Prep 提供 GPU UV 展开(comfy_gpu,50 万面约 6 秒)或 CPU xatlas 路径(同一网格约 4.6 分钟)。
该节点包附带四个示例工作流:
另外两个是 1024px 的 PBR 和 FLUX.1-dev。
可用性
官方仓库提供带 Triton 稀疏注意力内核的 PyTorch 训练与推理代码,权重托管在 ModelScope 上。ComfyUI 方案是上面提到的第三方节点包,而非 Comfy-Org 的官方发布,因此安装它意味着添加自定义节点,并从 ModelScope 拉取 UltraTex LoRA 和前景解码器。
评论
使用 GitHub 登录后即可参与讨论。