DMAD:面向 ComfyUI 的 4 步 MiniMax H3 音视频 LoRA
字节跳动与德州农工大学发布 DMAD,这是一种 rank-128 LoRA,可将 MiniMax H3 压缩至四步,实现音频与视频联合生成,并提供 Kijai 的 ComfyUI 转换版本。
 |  |
|---|---|
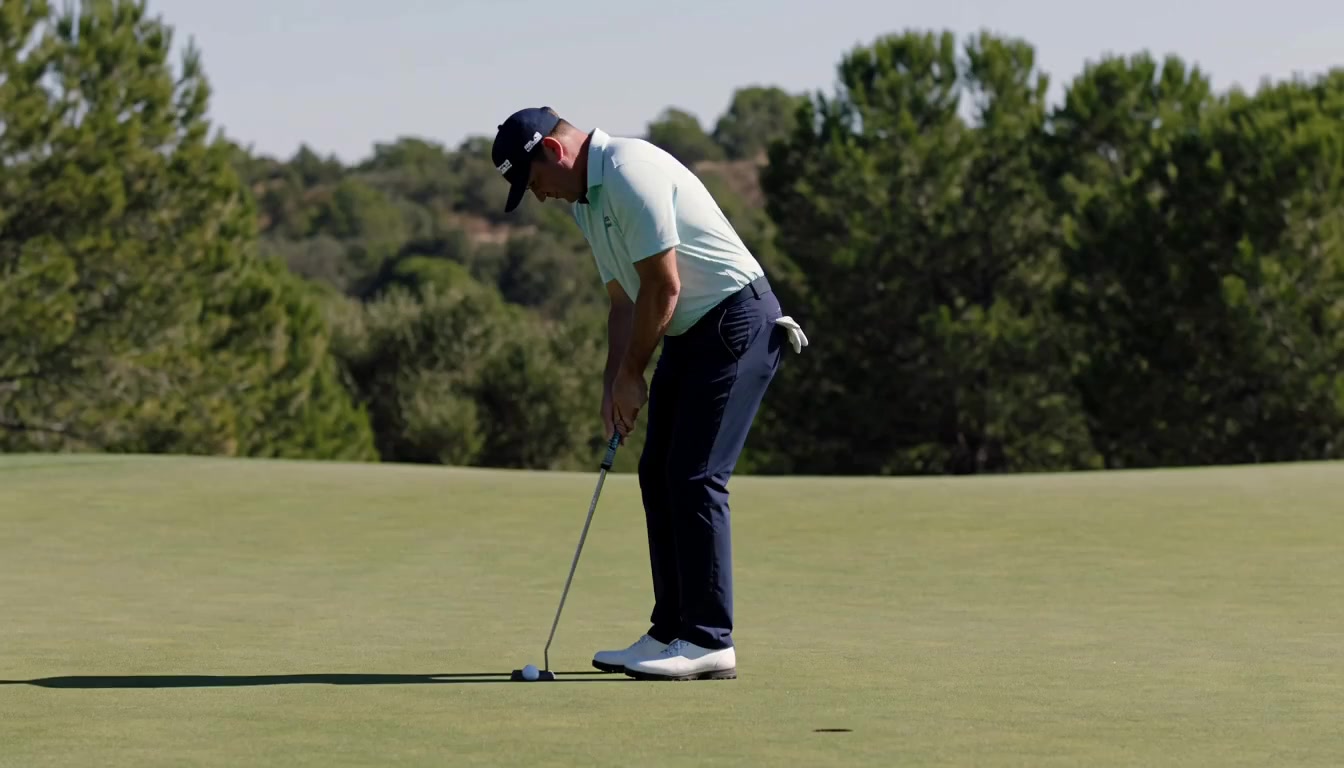
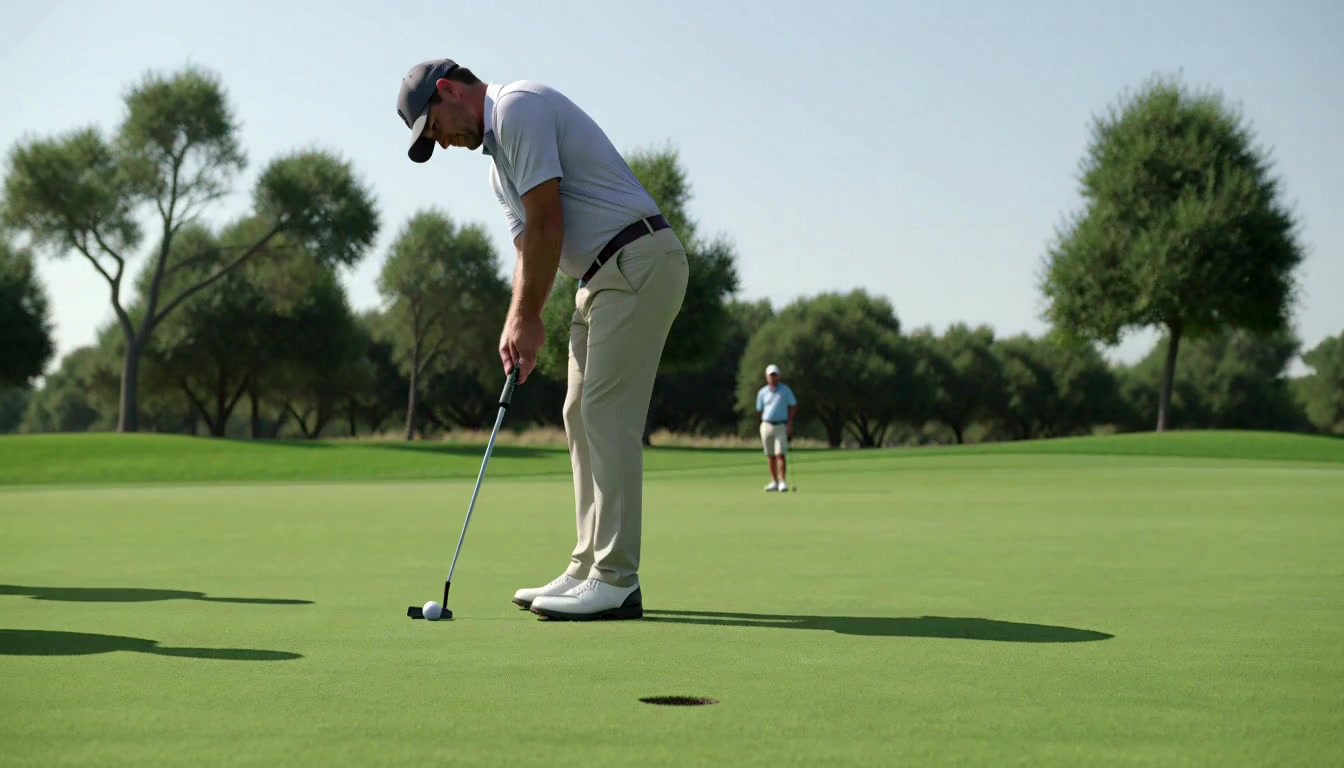
| 50 步的 MiniMax H3 teacher | 同一提示词在 4 步 DMAD student 下的结果 |
来自项目页面 MiniMax H3 对比网格的对应帧。student 在保持构图与主体的同时,只需四次模型评估,而非五十次。
DMAD 改变了什么
扩散模型的少步蒸馏通常遵循 DMD:用 teacher 与 student 分数之间的差值来训练 student,这意味着还要维护第二个扩散模型去拟合 student 不断演化的分布,并在内存和算力上付出代价。DMAD 去掉了这个辅助模型。
该方法把分布匹配重新表述为分类。两个判别器头共享同一个骨干网络,训练目标是将真实样本与 teacher 样本和 student 样本区分开。随后对判别器 logits 施加线性损失,直接训练 student,无需任何分数拟合。论文证明,在判别器最优点处,这些损失能够还原 DMD 所依赖的分布匹配梯度,依据的是将判别器 logits 与对数密度比联系起来的恒等式。
第二个组件是基于 gap 的重加权,用于决定 teacher 对每个噪波层级的监督强度。它读取真实数据头在真实样本与 teacher 样本之间的经验 logit gap,并据此自适应调整权重,而不是使用固定调度。
发布了什么
本次发布的是该方法在 MiniMax H3 上的部分。两个 rank-128 LoRA 挂在 H3 文生音视频 transformer 上,各约 1.4 GB。
| 文件 | 描述 |
|---|---|
minimax_h3/dmad_minimax_h3_4step_lora_critic.safetensors | 论文所用的模型:主训练运行到第 800 次迭代时 student 的 EMA |
minimax_h3/dmad_minimax_h3_4step_full_critic.safetensors | 一种变体,其 critic 骨干网络完全训练,而非冻结在 LoRA 之下;卡片报告了更高的 AVGen-Bench 分数 |
两个适配器在全部 50 个 transformer 块和 2 个 token-refiner 块的注意力投影与两个前馈层上都使用 rank 128 与 alpha 128,共 312 个模块,采用 Diffusers 键布局(<module>.lora.down.weight、<module>.lora.up.weight)。safetensors 元数据记录了 rank、alpha 与融合规则。
推理为四步文生音视频,视频的时间偏移为 12、音频为 2,不使用无分类器引导,因为 MiniMax H3 本身已经过引导蒸馏。默认输出为 1344x768、124 帧(24 fps 下约 5.2 秒),带 32 kHz 立体声音频,这正是 student 训练时所使用的设置。
结果
论文在三个骨干网络上报告了该方法。本次发布只公开 MiniMax H3 的 student;SDXL、EDM 与 Wan2.1 的数据来自论文自身的实验运行。
| 骨干网络 | 设置 | 分数 |
|---|---|---|
| SDXL | 4 步,COCO-10K | 14.47 FID |
| Wan2.1-T2V-14B | 4 步 | 85.15 VBench 总分 |
| MiniMax-H3-33B | 4 步,音视频联合 | 79.1% 整体人类偏好优于 DMD2,84.6% 优于 rCM(不含平局) |
摘要还报告了在 ImageNet-64x64 上使用投影判别器的单步生成达到 1.04 FID,并指出少步 student 在这些指标上优于所对比的少步方法以及多步 teacher。
在 ComfyUI 中运行
官方发布面向 Diffusers 而非节点:inference.py 使用 student 训练时所遵循的重加噪步骤规则进行采样,run_diffusers_pipeline.py 则将它们接入官方的 MiniMaxH3ModularPipeline。基础模型是 33B 的 H3 transformer 加上其 Qwen3-VL-32B 文本编码器,组件总计约 170 GB,参考实现建议使用一块 80 GB GPU,并在空闲时进行 CPU offload。
对于 ComfyUI 来说,这些适配器在转换之后就是普通 LoRA。Kijai 发布了一个降秩转换版本 minimax_h3_DMAD_4step_full_lora_avg_rank_39_bf16.safetensors,位于 Kijai/MiniMax-H3-experimental,因此可通过标准 H3 LoRA 路径加载,无需自定义节点。原始 diffusers 文件的社区转换版本也在流传,但同样需要注意:两个模型文件与采样器设置必须与卡片一致。
一只站在冲浪板上的水獭,由 4 步 MiniMax H3 student 生成。视频与音频来自同一次四步推理。完整演示合集见 YouTube。
 |  |
|---|---|
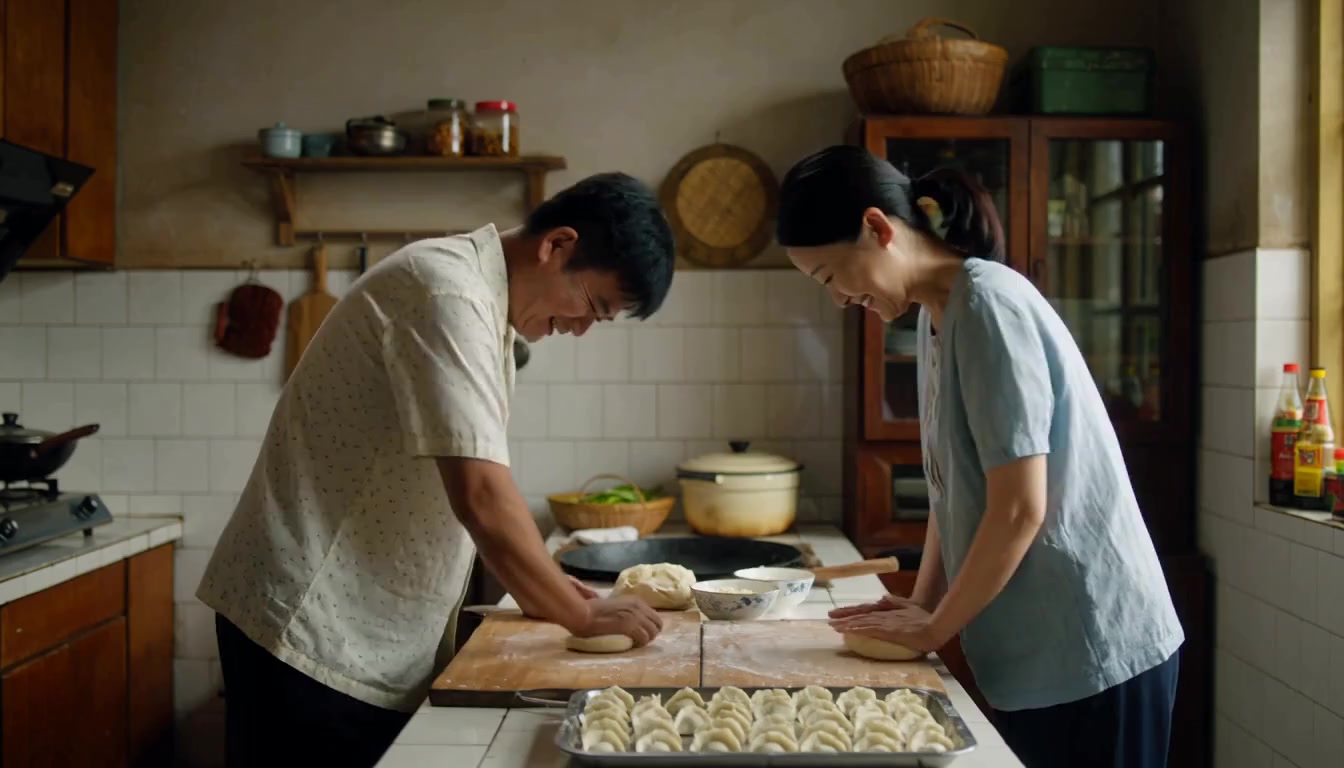
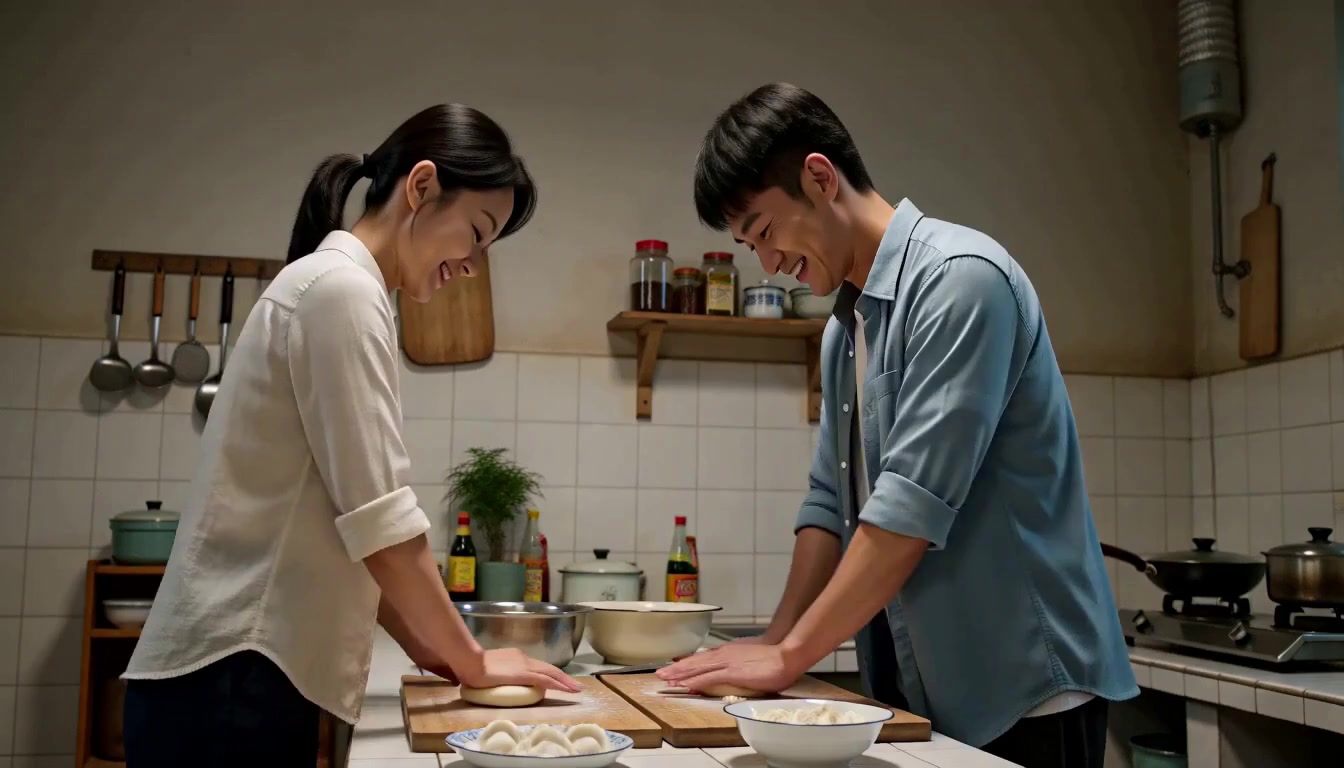
| teacher,50 步 | DMAD student,4 步 |
项目页面 MiniMax H3 网格中的第二组对应画面。
局限
- 已发布的 student 针对 1344x768、124 帧、32 kHz 立体声音频进行训练,卡片将其作为操作点呈现,而非众多设置中的一种。
- H3 的偏好数据排除了平局,且对比中混入了本次发布并未提供的方法,因此 SDXL 与 Wan2.1 的正面对比数据来自论文的实验运行,而非公开文件。
- 由于发布中没有官方节点或工作流 JSON,ComfyUI 支持依赖社区转换版本,而其降秩方式与键布局并非论文所评估的对象。
- 完整的 H3 堆栈体积庞大(33B transformer 加 32B 文本编码器),因此四步减少的是采样成本,而非容纳模型所需的内存。
可用性
项目页面: yzmblog.github.io/projects/DMAD
论文: arXiv 2610.02188
代码: Yzmblog/DMAD
权重: ZhengmingYu/DMAD
演示视频: YouTube
ComfyUI 转换: Kijai/MiniMax-H3-experimental
基础模型: MiniMaxAI/MiniMax-H3
评论
使用 GitHub 登录后即可参与讨论。