Viggle Turbo v0.3:在 ComfyUI 中以 6 步和 9 步运行 Qwen-Image 2.1
Viggle 对 Qwen-Image 2.1 的 v0.3 蒸馏新增 9 步模式,并随附官方 ComfyUI 节点、工作流,以及用于 6 步生成与编辑的合并单文件权重。
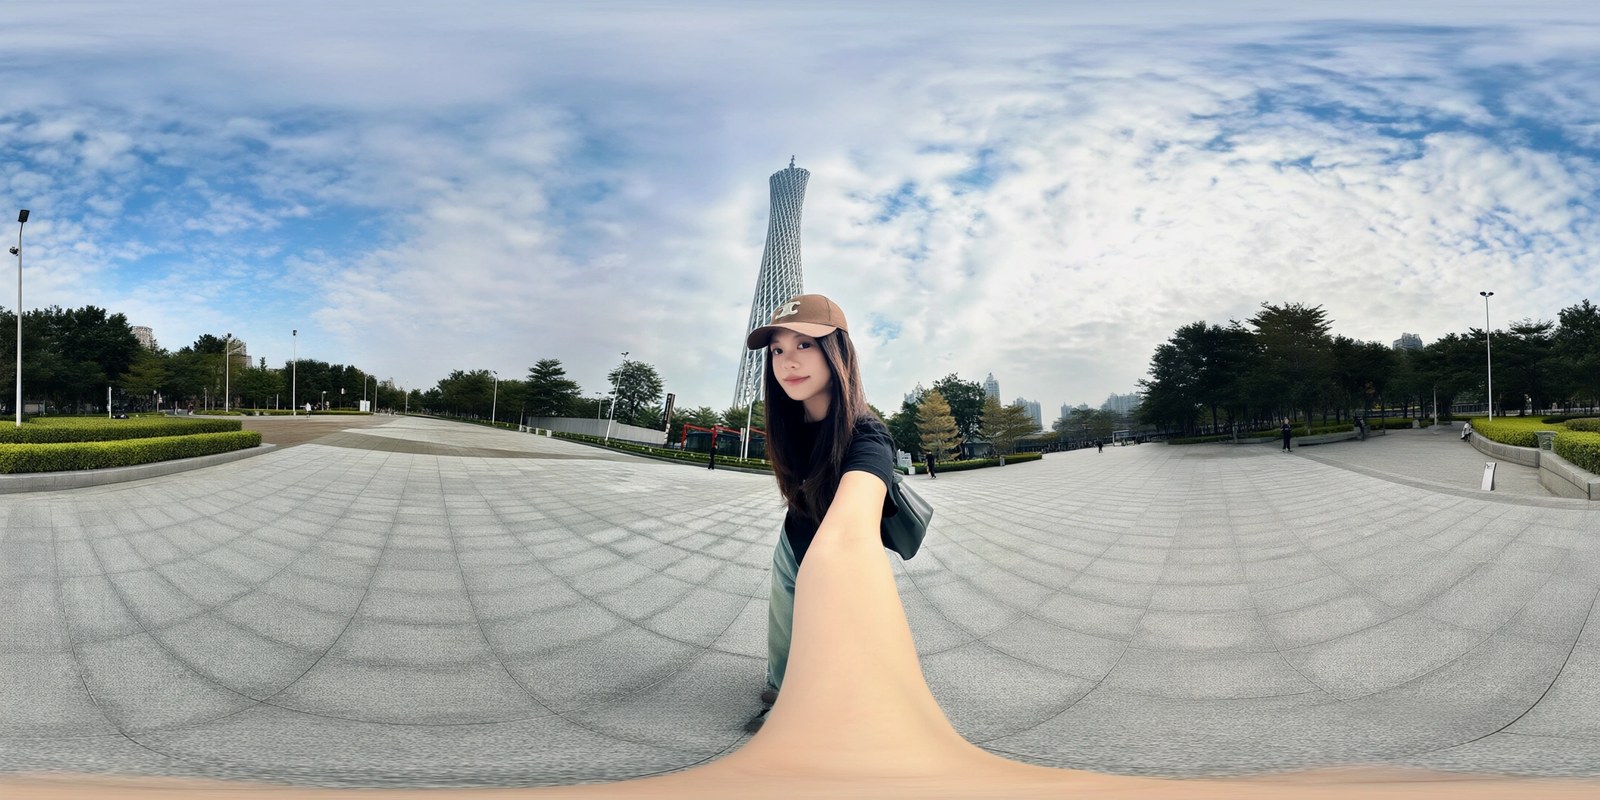
由一张透视照片构建的 360 度等距柱状全景图,由 v0.3 以 9 步在 2176x1088 下生成。来源:Viggle 演示 Space 的对比标签页。
v0.3 有哪些变化
蒸馏本身没有变化:在 Qwen-Image 2.1 基础 transformer 上使用 rank 256 的 LoRA,按固定的 sigma 调度采样,true_cfg_scale=1.0 且不使用负面提示词。v0.3 调整的是平衡点,而不是方法。
- 6 步,重新调校。 与 v0.2.1 相比,结果颗粒感更少,平坦表面更干净,细纹理略微柔和了一些。Viggle 明确说明这不是严格意义上的升级:如果你更喜欢 v0.2.1 更清晰锐利的观感,那个适配器仍保留在仓库中。
- 全新的 9 步模式。 先执行七个 turbo 步,然后关闭 LoRA,由未经修改的基础模型完成最后两步。细节更精细,小号渲染文字正确的概率更高。耗时约为 6 步的 1.4 到 1.5 倍,仍比 40 步基础模型快约 3.5 倍。
- 明确的上限。 Viggle 表示 6 步已接近该学生模型所能达到的水平:自 v0.2.1 以来发现的每一项提升都是以牺牲某些东西换来的,更锐利伴随更多颗粒感,颗粒感更少伴随更柔和的观感。超过这一点,质量只能靠增加步数来换取,而这正是 9 步模式所做的。
9 步模式
9 步路径不只是更长的调度。pipeline 会一次性计算文本和引用的 K/V 并复用;7 个 turbo 步会填充该缓存,因此第一个基础模型步必须重新计算它,之后 LoRA 才会被禁用、基础模型接管。在 diffusers 中,这意味着一个 step 回调和一个包裹 transformer 前向传播的 wrapper,两者都在模型卡中展示:
SIGMAS_9 = [1.0, 0.9583, 0.9167, 0.875, 0.75, 0.5, 0.25, 1 / 6, 1 / 12]6 步调度保留了低噪声节点 0.875, 0.75, 0.5, 0.25,仅在高噪声端增加步数:5 步为 [1, 0.875, 0.75, 0.5, 0.25],7 步为 [1, 0.9583, 0.9167, 0.875, 0.75, 0.5, 0.25]。改为移动低噪声节点会使结果更柔和,而只传入一个普通步数、不提供 sigma 列表则行不通。
9 步目前仅在 diffusers 和演示 Space 中运行。ComfyUI 工作流实现的是 6 步调度。
官方 ComfyUI 支持
这是 v0.2 所不具备的部分。该版本现在在模型仓库的 comfyui/ 文件夹中提供了 ComfyUI 移植,并针对原生支持 Qwen-Image 2.1 的 ComfyUI 0.37.0 进行了测试:
viggle_turbo.py新增两个节点。把它复制到ComfyUI/custom_nodes/并重新启动。Viggle Turbo Sigmas提供带有 pipeline 分辨率相关 shift 的 6 步调度,需配合 euler 和BasicGuider使用,而不是 K 采样器的调度器,同时不使用 CFG 和负面提示词。Viggle Turbo LoRA (unmerged)在运行时以 diffusers 的方式应用适配器。原生的 LoRA 加载器会把它合并进权重,Viggle 测得这会在 bf16 下丢失该适配器约 30% 的更新量,并在 int8 下引入噪声。未合并节点每步会多花 10% 到 25% 的时间。- 适用于文生图和编辑的工作流,以及针对合并单文件权重和 GGUF 的变体。
在 int8 默认设置、启用 r128 LoRA 和提示词增强器的情况下,这些工作流在 1248x832 下的显存峰值约为 26 GB。模型卡还提到,该 ComfyUI 移植主要是借助 AI 编程助手编写的,因此存在粗糙之处在所难免,欢迎提交修复。
合并单文件 transformer
如果你完全不想加载 LoRA,v0.3 也提供了基础 transformer,其中 rank 256 适配器已以 fp32 合并并完成一次量化。这些文件放入 models/diffusion_models/;GGUF 版本需要 ComfyUI-GGUF,而每条路径仍然需要来自自定义节点的 Viggle Turbo Sigmas。这种方式仅支持 6 步模式。
| 格式 | 大小 | ComfyUI 加载器 | LPIPS v0.3 | LPIPS v0.2.1 |
|---|---|---|---|---|
| GGUF Q8_0 | 7.7 GB | UNet加载器(GGUF) | 0.051 | 0.054 |
| int8,Comfy-Org convrot 方案 | 7.3 GB | UNet加载器 | 0.057 | 0.060 |
| GGUF Q6_K | 6.0 GB | UNet加载器(GGUF) | 0.055 | 0.067 |
| fp8 e4m3fn,仅权重 | 7.3 GB | UNet加载器 | 0.068 | 0.070 |
| GGUF Q5_K_M | 5.1 GB | UNet加载器(GGUF) | 0.076 | 0.083 |
| GGUF Q4_K_M | 4.3 GB | UNet加载器(GGUF) | 0.100 | 0.118 |
| int8 加 r128 LoRA(LoRA 工作流) | 8.0 GB | UNet加载器 | 0.041 | 0.044 |
LPIPS 是 Viggle 以 diffusers 运行 rank 256 LoRA 为基准测得的平均 VGG 距离,基于 96 个留出请求,提示词、输入、种子和噪声均相同;数值越低表示越接近。作为量级参考,在未加载 LoRA 时,ComfyUI 与 diffusers 之间的差异约为 0.03 到 0.04。
合并权重与 LoRA 路径接近,但并不完全相同。在那 96 个请求中,约 8 个请求上合并的 int8 或 Q8_0 版本会落在不同的构图或服装上,而 LoRA 工作流为 3 到 5 个。Q4_K_M 的偏移明显更大,为 96 个中的 23 到 29 个,Viggle 仅在没有更大的模型能装进内存时才推荐它。
40 步基础模型对比 6 步与 9 步
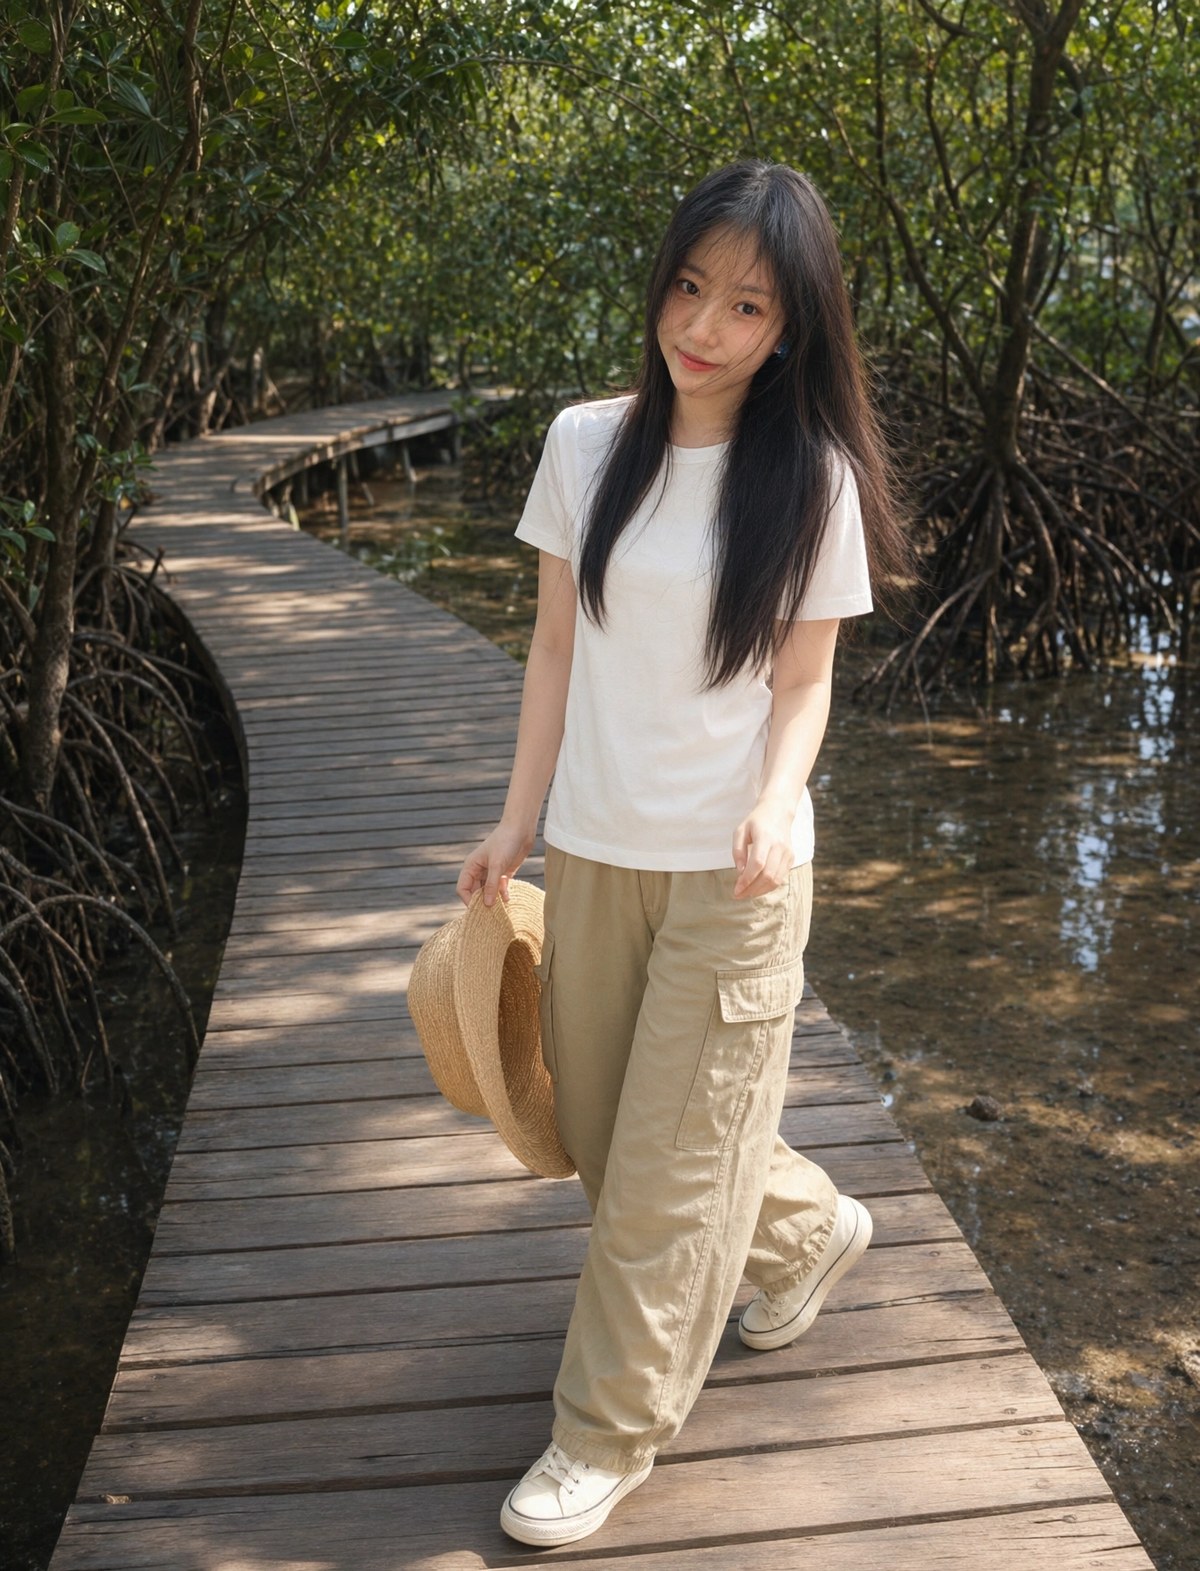
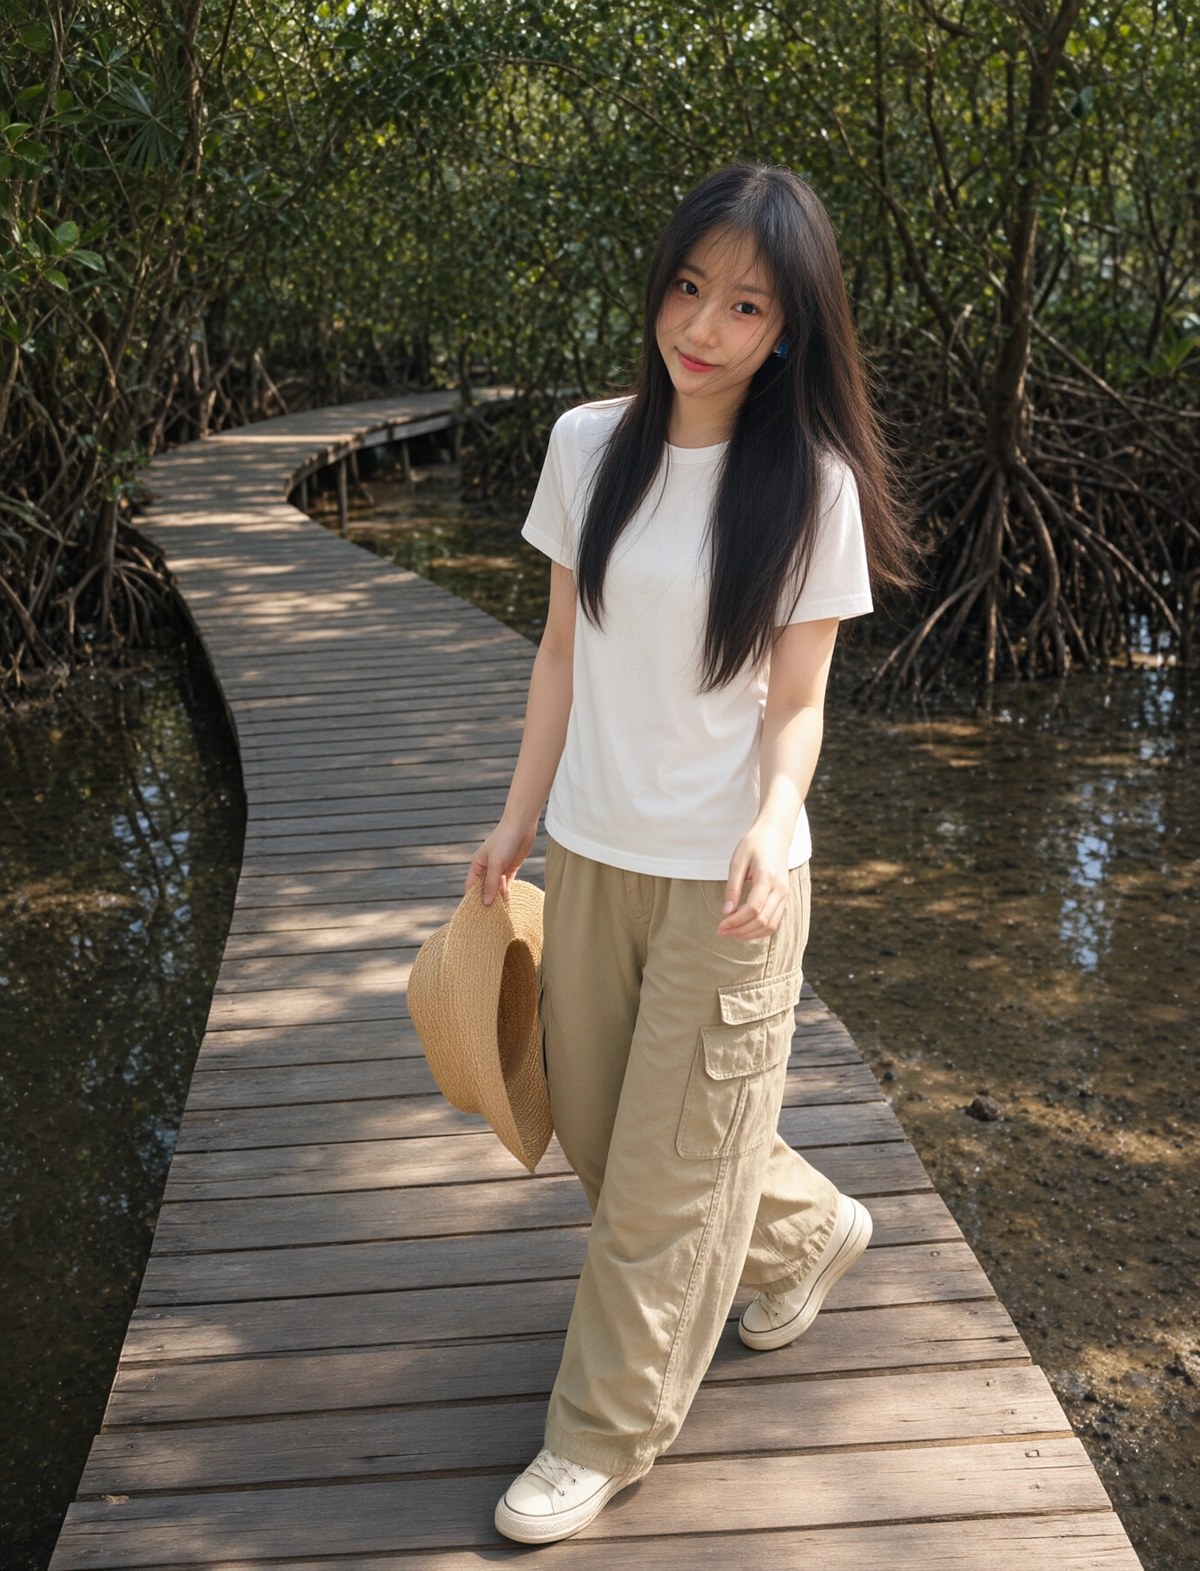
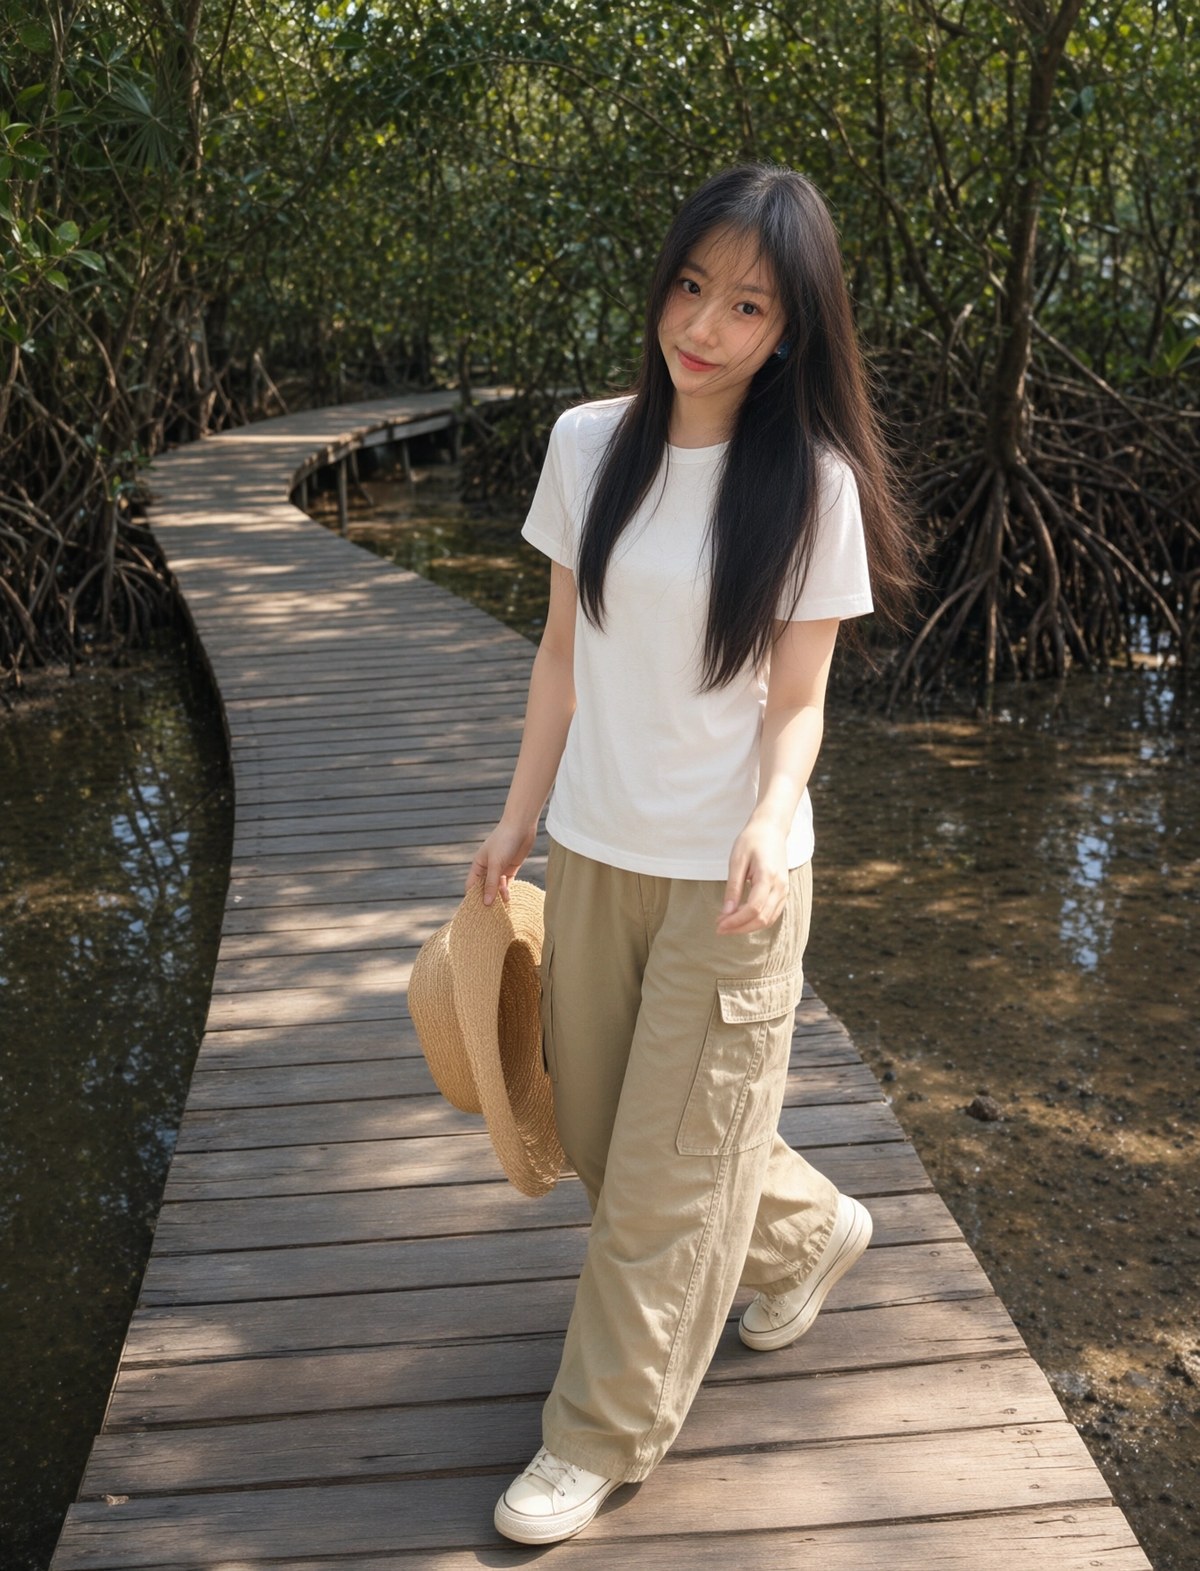
以下示例来自 Viggle 自家演示 Space 的对比标签页。每一列都使用相同的提示词、输入、种子和噪声。
 |  |  |
|---|---|---|
| 基础模型,40 步 | v0.3,6 步 | v0.3,9 步 |
一个角色引用被带入红树林栈道场景,尺寸 1344x1760。6 步结果是两个 turbo 列中最干净的;9 步找回了一部分细纹理。
9 步模式针对的是 6 步学生模型仍落后于基础模型的两个方面:密集的渲染文字和细小细节。一张 1536x2720 的竖直应用截图,包含大量小号界面文字,是一个合理的压力测试,对比标签页中就运行了这样一个测试。
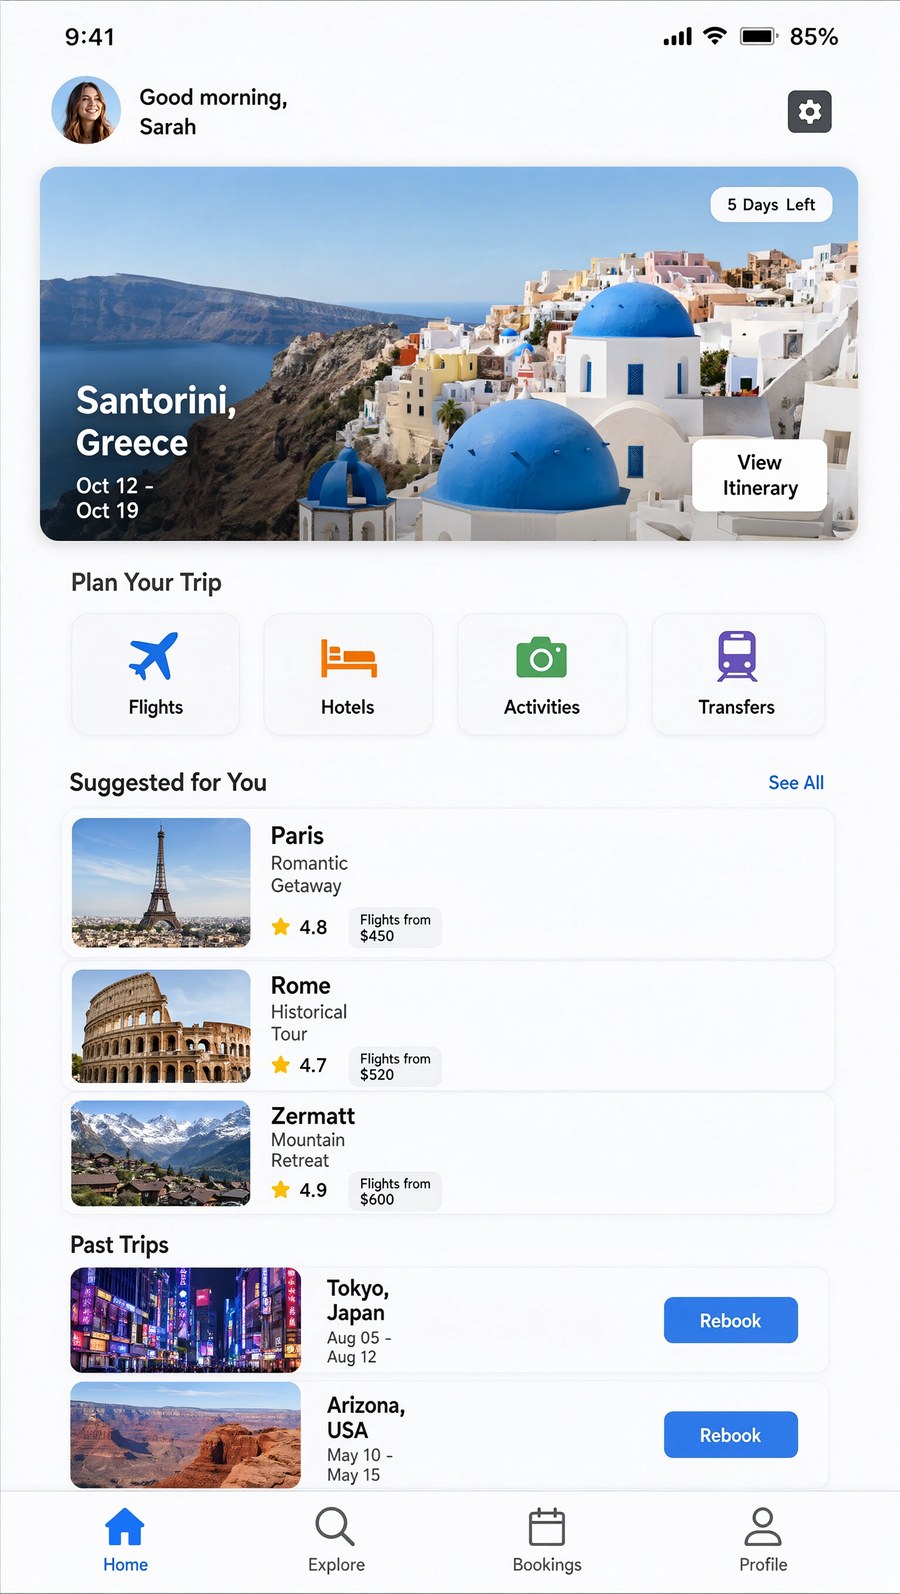 | 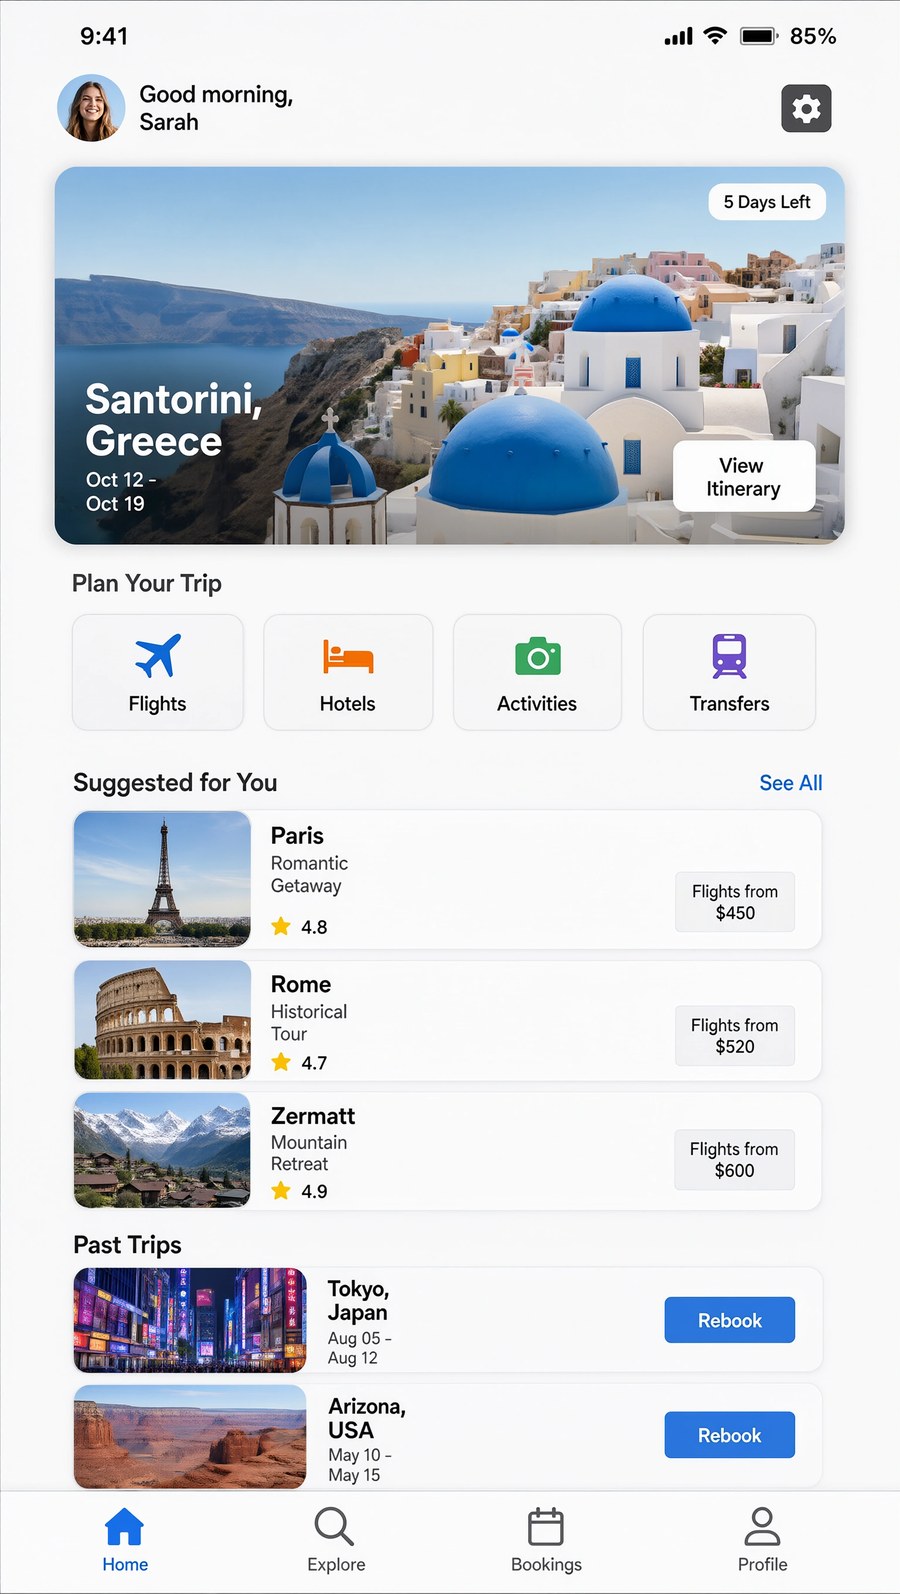 |
|---|---|
| 基础模型,40 步 | v0.3,9 步 |
该蒸馏在 diffusers 中还支持最多 3 张引用图像,下面的六人合影测试了这条路径:六个身份、一个提示词、一个酒吧内景。
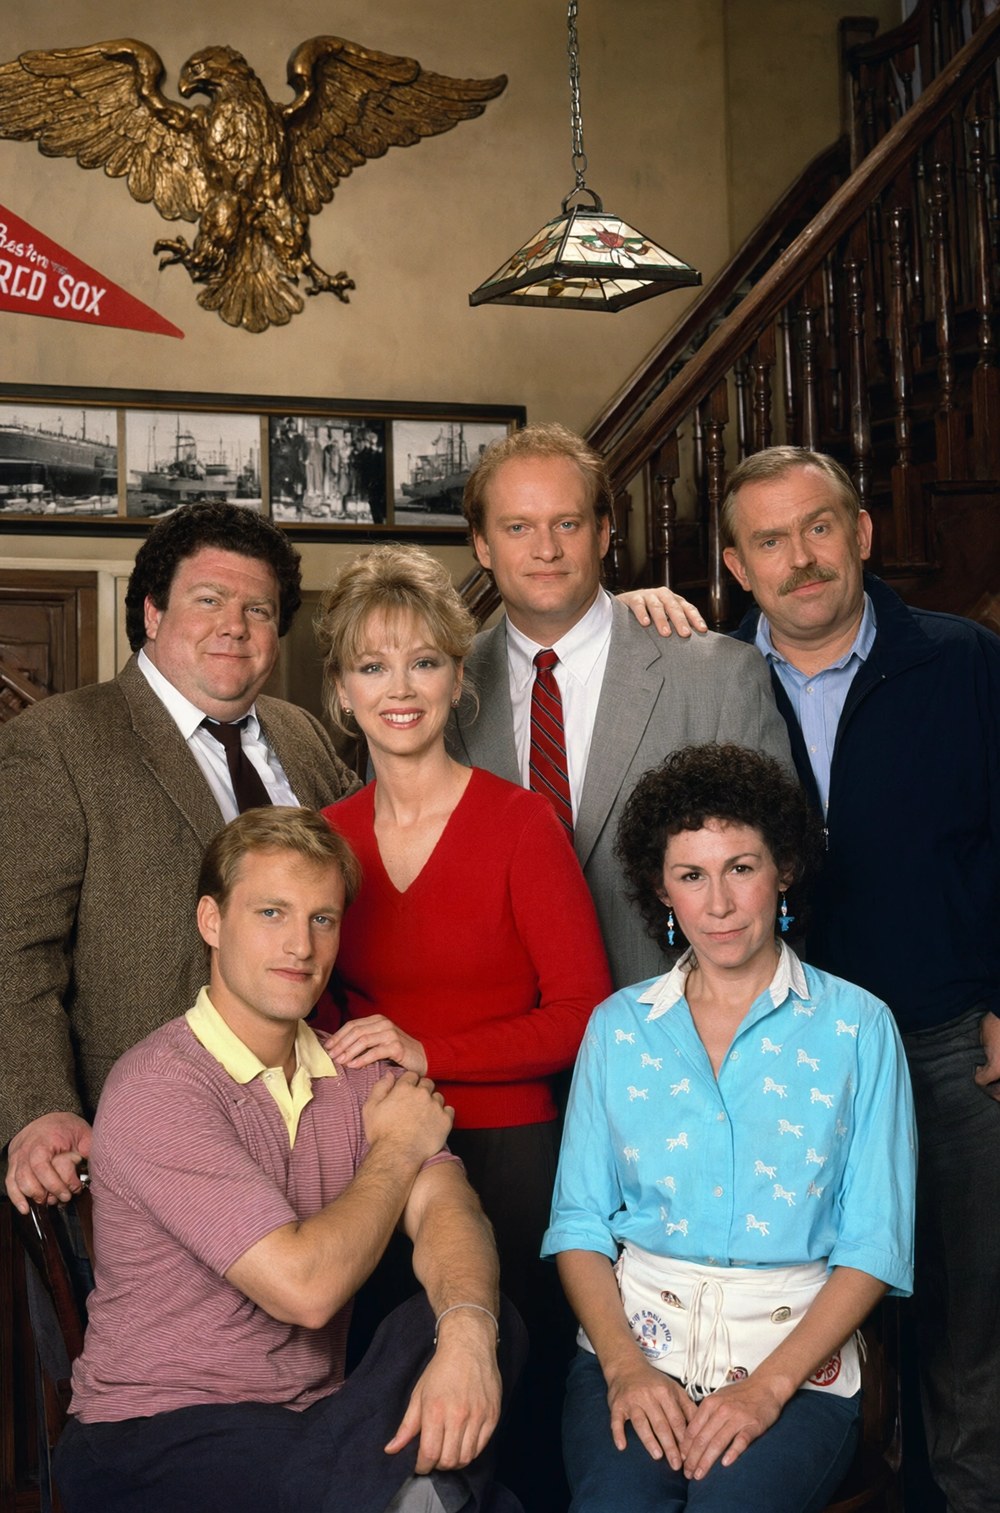 | 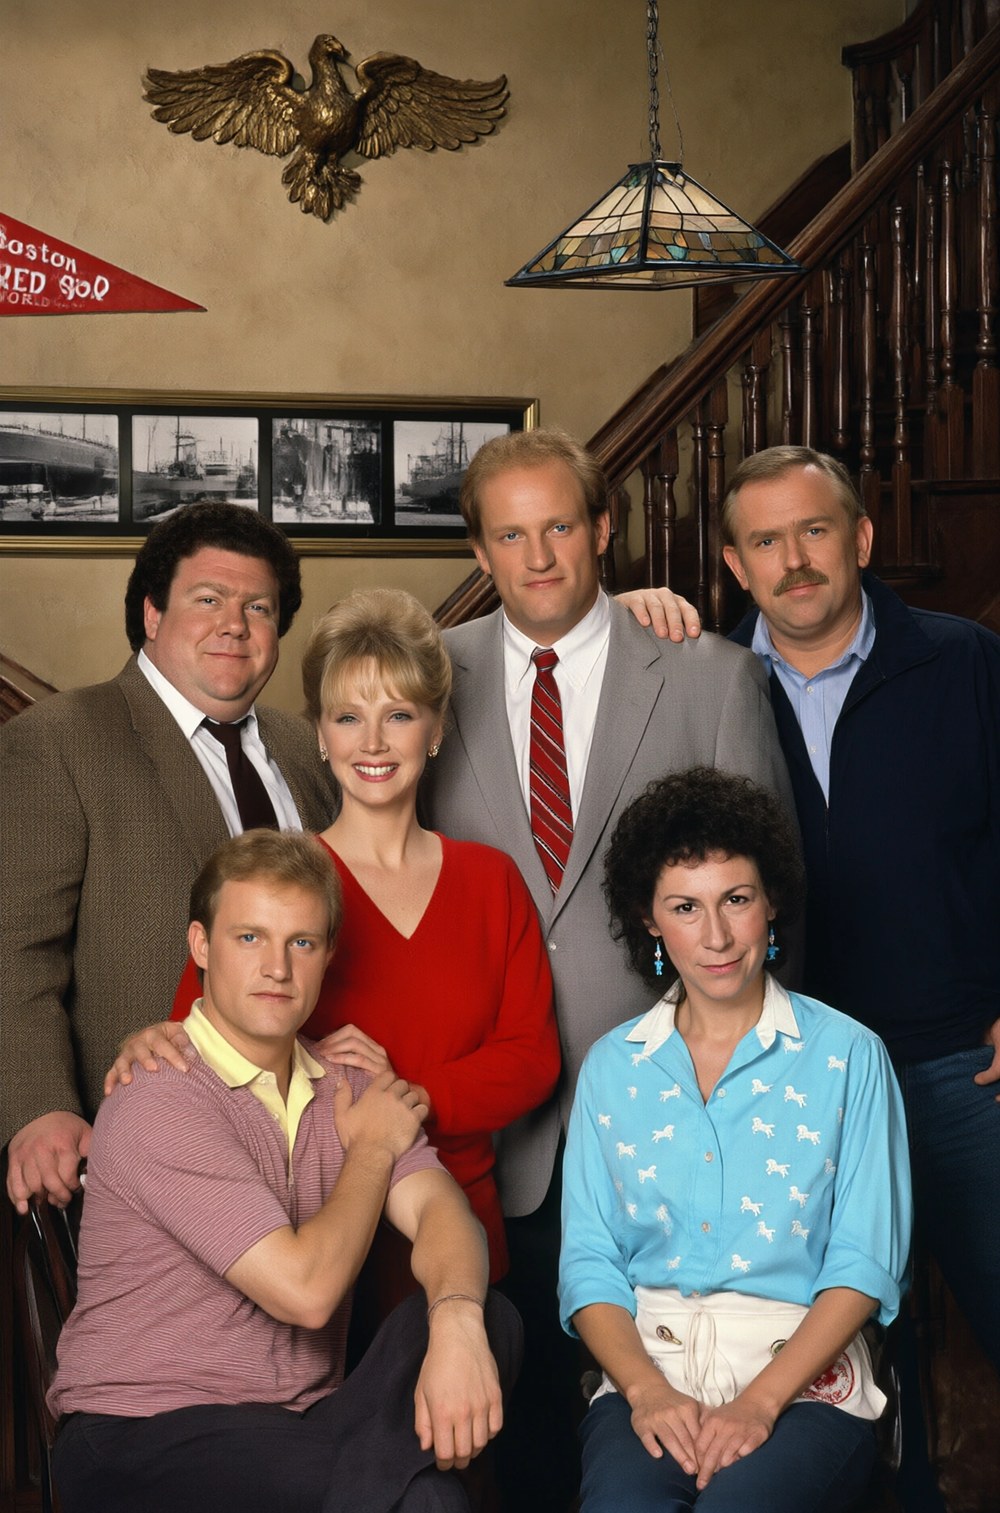 |
|---|---|
| 基础模型,40 步 | v0.3,6 步 |
速度
同样的对比,每张图像的秒数如演示 Space 中所报告:
| 场景 | 分辨率 | 基础模型,40 步 | v0.3,6 步 | v0.3,9 步 |
|---|---|---|---|---|
| 基于引用的肖像 | 1344x1760 | 14.0 s | 2.9 s | 4.0 s |
| 六引用合影 | 1248x1888 | 25.8 s | 5.9 s | 8.8 s |
| 密集应用截图 | 1536x2720 | 26.9 s | 4.9 s | 6.8 s |
| 360 度全景 | 2176x1088 | 14.3 s | 2.9 s | 4.1 s |
它仍然做不到的事情
模型卡对剩余差距的描述异常直接。复杂编辑仍然是学生模型落后的地方:多引用构图、换脸和保持身份的指令可能会产生重复或重影的人物以及身份漂移。小号或长篇渲染文字比基础模型更容易出错,9 步有所帮助但并未解决该问题。颜色饱和度会低几个百分点。2K 输出、RGBA 输出、蒙版引导编辑以及引用超过 3 个的编辑仅在对比标签页中通过肉眼检查,未声称任何基准测试结果。
评论
使用 GitHub 登录后即可参与讨论。