LongLive-Plug:NVIDIA 为 H3 和 Wan 蒸馏少步 LoRA
NVIDIA 的 LongLive-Plug 为每个主干模型一次性蒸馏少步、CFG 和长上下文 LoRA,并在 54 个下游模型中复用,提供 MiniMax H3 和 Wan 的权重。
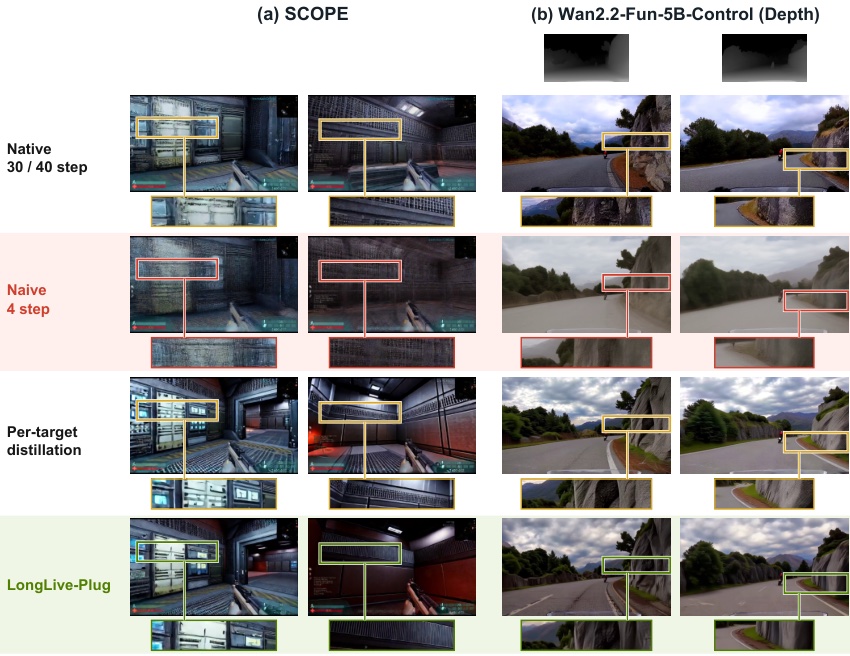
来自论文图 3 的匹配帧。朴素四步采样(第二列)使画面模糊;迁移的适配器(第四列)在四步下仍保持良好。方框标注了各种方法间相同的坐标。
一次蒸馏,多个下游模型
构建专用视频模型时,通常最后会有一个蒸馏阶段,用于减少采样步数或让长时间 rollout 保持一致。这个阶段通常对每个模型重复进行:收集任务数据、运行教师模型、再次优化。基于相同主干微调的深度条件 Wan 和机器人世界模型各自为其少步 LoRA 付出了代价。
LongLive-Plug 将这项工作拆分为三种能力,每个主干系列蒸馏一次,然后作为普通 LoRA 迁移过去:
- 少步 LoRA:更少的采样步数,使用分布匹配和 CFG 引导的教师模型训练。
- CFG LoRA:将无分类器引导折叠为单次条件前向传播。
- 长上下文 LoRA:修正因果自回归 rollout 中的误差累积。
这些适配器设计为能够承受下游模型所做的更改。添加条件分支或扩展输出通道不会使它们失效,因此同一组文件可以附加到完整微调、任务 LoRA 和带有额外控制模块的模型上。
CFG 权重的作用类似旋钮
引导通常每步需付出两次代价:一次条件传播,一次无条件传播。CFG LoRA 去掉了第二次传播,并且由于引导被蒸馏到适配器中,LoRA 权重本身成为了引导控制器,即使该适配器是在一个固定缩放值下训练的。提高它可以增强提示属性,而无需重新运行无条件分支。
重要的细节是,缩放整个耦合的 LoRA 并不会产生相同的效果:它会同时改变更新和步数并降低输出质量。这就是为什么少步和 CFG 适配器是分开的文件,也是为什么它们要分别加权。论文推荐的比例是少步 : CFG = 1 : 0.5,模型卡也重申这些数字是适配器权重,而不是模型原生的 CFG 缩放值。
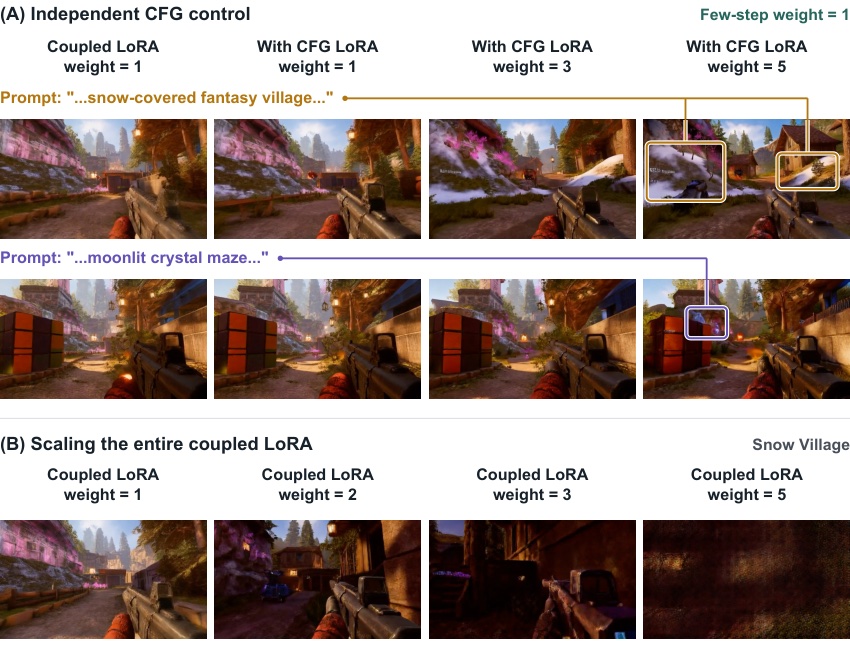
论文图 5。仅缩放耦合 LoRA 几乎无法响应提示;添加单独加权的 CFG LoRA 会增强方框中的属性,而耦合 LoRA 保持固定。
发布内容
Hugging Face 集合包含六个适配器,每个主干一个少步文件和一个 CFG 文件。
| 基础模型 | 少步适配器 | CFG 适配器 | 说明 |
|---|---|---|---|
| MiniMax H3 | LongLive-Plug-MiniMax-H3-few-step (2.6 GB) | LongLive-Plug-MiniMax-H3-cfg (2.6 GB) | PEFT 格式。模型卡称目前应分别使用两者,暂不推荐组合使用 |
| Wan2.1-T2V-14B | LongLive-Plug-Wan2.1-T2V-14B-few-step (1.2 GB) | LongLive-Plug-Wan2.1-T2V-14B-cfg | 随 PEFT 导出附带一个 generator_lora_lightx2v.safetensors |
| Wan2.2-TI2V-5B | LongLive-Plug-Wan2.2-TI2V-5B-few-step (1.3 GB) | LongLive-Plug-Wan2.2-TI2V-5B-cfg | PEFT adapter_model.safetensors |
Wan2.1-14B 少步文件是能直接用于现有 Wan 工作流的那个:它以 lightx2v 命名导出,ComfyUI 的 Wan LoRA 加载器已经能够读取,因此它会像任何其他 Wan 加速 LoRA 一样放入 ComfyUI/models/loras/。MiniMax H3 适配器是 PEFT 导出,需要转换后 ComfyUI 才能加载;Kijai 已在 Kijai/MiniMax-H3-experimental 发布了转换后的 bf16 版本,命名为 minimax_h3_ELM_longlive_plug_4step_lora_bf16.safetensors(1.96 GB)。
覆盖范围和成本
论文验证了在三个主干系列的 54 个下游模型(Wan2.1-14B 上 24 个,Wan2.2-TI2V-5B 上 24 个,MiniMax H3 上六个)和八个任务分类(世界建模、机器人、结构条件生成、相机和轨迹控制、视频编辑与修复、主体与化身生成、音频与 RGBA 生成,以及风格适配)上的免训练部署。相对于原生 20 到 50 步的调度,附加基础蒸馏的适配器可实现四步、无 CFG 推理,去噪步数减少 5 到 12.5 倍。
成本论据是论文的另一半。基础蒸馏大约需要 80 H100 GPU 小时(32 个 GPU 上 700 次迭代,约 2.5 小时)。而单独蒸馏四个下游任务则额外需要 83.9(深度)、150.0(世界建模)、86.8(姿态)和 56.1(机器人)GPU 小时,总计约 456.8。复用基础适配器仍保持在固定的约 80 GPU 小时,且无需收集特定任务的数据。
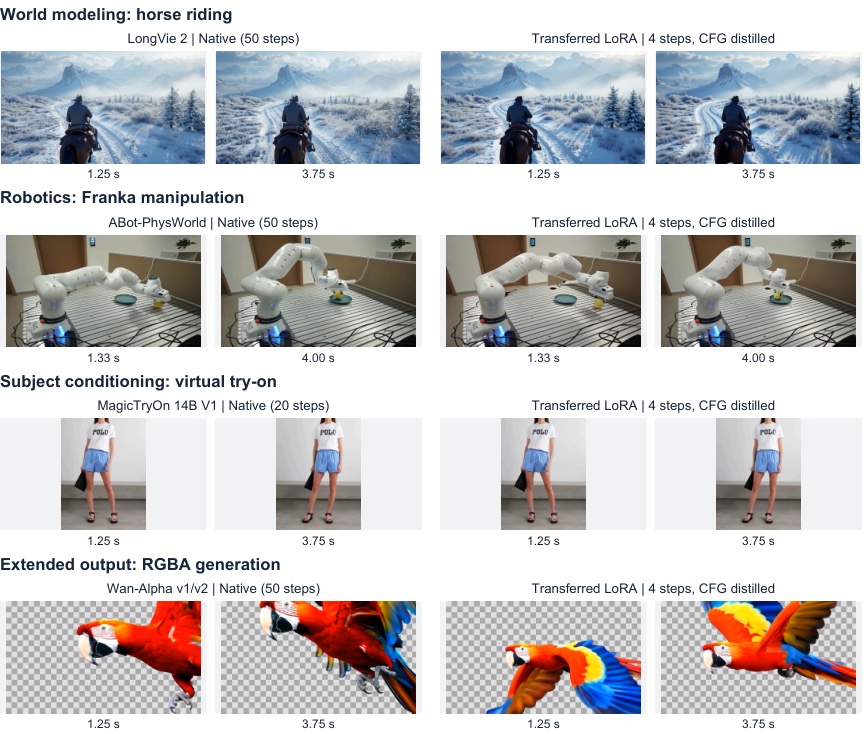
论文图 9:LongVie 2、ABot-PhysWorld、MagicTryOn 和 Wan-Alpha,涵盖世界建模、机器人、主体条件生成和 RGBA 输出,每个都将两帧原生画面与四步迁移后相同时间戳的画面进行比较。
MiniMax H3
发布中 H3 部分是最窄的。54 个验证模型中只有六个是 H3,论文声明其十项 H3 对比是单种子案例,没有重复运行的置信区间;原生默认值是一个引用操作点而非真实标准;静态帧不能评估音频质量或同步性。示例显示四步 H3 比朴素四步 Euler 采样更好地保持了角色轮廓,但外观仍可能与未蒸馏的多步结果不同。
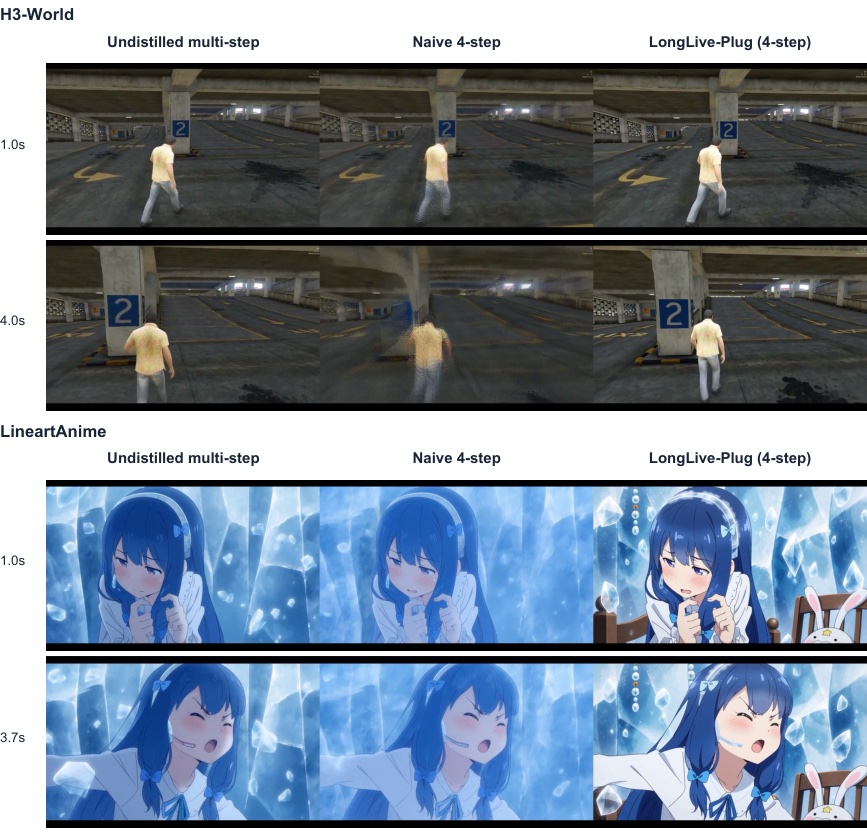
论文图 11:H3-World 在前向动作条件下和 LineartAnime,比较未蒸馏的多步推理、朴素四步采样,以及使用 LongLive-Plug 的四步推理。
局限
- 迁移思想在其蒸馏所针对的主干上有效。Wan2.1、Wan2.2 和 MiniMax H3 各自有独立的适配器集,论文并未声明跨系列复用。
- H3 的效果是在十个单种子案例上测量的,没有置信区间,音频轨道不属于评估的一部分。
- 对于 MiniMax H3,目前应一次一个地使用两个适配器,因此少步速度和 CFG 控制在那里暂时还无法组合。
- 引导控制是权重旋钮,而不是新的采样器:要同时获得两者,必须分别加载并加权少步和 CFG 文件。
获取方式
项目页面: nvlabs.github.io/LongLive/LongLive-Plug
论文: arXiv 2609.38154
演示视频: YouTube
权重: Efficient-Large-Model/longlive-plug
H3 少步适配器的 ComfyUI 转换版: Kijai/MiniMax-H3-experimental
评论
使用 GitHub 登录后即可参与讨论。